Обновить
64K+

Облачные вычисления *

Концепция общего доступа к ресурсам

44,15
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

От FaaS к PaaS: почему я построил собственный оркестратор вместо Kubernetes
Уровень сложностиСредний
Время на прочтение23 мин
Охват и читатели8.6K

Раньше я уже рассказывал на Хабре об Inquir Compute, который тогда был платформой для запуска serverless-функций. С тех пор проект вырос в PaaS с поддержкой контейнерных приложений, баз данных, фоновых задач и собственной системой управления вычислительными ресурсами.

Вместо Kubernetes или Nomad я решил развивать собственный оркестратор с allocation plane, планировщиком и вычислительными раннерами на containerd. Главная причина не в желании переписать существующие инструменты, а в возможности объединить долгоживущие приложения и serverless-функции в одну ресурсную модель, напрямую связанную с жизненным циклом сервисов и тарификацией платформы.

Расскажу, как развивалась архитектура Inquir Compute, почему я считаю собственный оркестратор правильным выбором для этого проекта, какие задачи удалось решить и над чем ещё предстоит работать.

Читать далее

Новости

Что бэкапить в ИИ-приложении: модель, документы, индексы или историю диалогов?

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели6.5K

Привет, Хабр! На связи Михаил Витко, менеджер PaaS-продуктов Рег.облака. Представим ситуацию. После восстановления ИИ-помощник принимает запросы и отвечает без ошибок. Но на вопрос о сроке возврата товара называет 14 дней вместо 30: база уже знает о новой редакции регламента, а поиск работает по старому индексу. Проверка доступности сервиса такую поломку не обнаружит.

В статье подробно разберем, как резервировать RAG-помощника по корпоративным документам и восстанавливать его части в согласованном состоянии. Тема обширная, поэтому мы разделили материал на две части. В первой поговорим о том, какие данные нужно сохранять, что можно пересоздать после сбоя и как организовать резервное копирование в S3, PostgreSQL и Kubernetes. А во второй обсудим, как восстановить приложение без рассогласования данных и проверить, что оно корректно работает после сбоя. 

Читать далее

Вычисления, хранение, масштабируемость: погружение в архитектуру гиперконвергентной дата-платформы

Время на прочтение10 мин
Охват и читатели5.6K

Привет, Хабр. Меня зовут Павел Кутаков. Я главный архитектор VK Data Platform, VK Tech.

Более 10 лет подход с разделением compute- и storage-слоев де-факто считается стандартом, следование которому позволяет максимально эффективно использовать доступные ресурсы. Но на практике подобный подход применим не всегда — например, по нашему мнению, он не всегда оптимален для построения платформ данных. Именно поэтому при разработке VK Data Platform мы реализовали единую гиперконвергентную архитектуру. 

В статье расскажу, почему мы выбрали такой подход, как обеспечиваем гибкость решения и с помощью каких практик гарантируем безопасность и отказоустойчивость.

Читать далее

Когда Docker Compose уже мало, а Kubernetes еще слишком много: знакомство с Uncloud. Часть 2

Время на прочтение11 мин
Охват и читатели11K

В первой части мы разобрали, как устроен Uncloud и из каких компонентов складывается его кластерная модель. А теперь возьмем эту архитектуру и посмотрим, как она ведёт себя в реальной эксплуатации. 

Мы уже умеем объединять несколько Docker-хостов, запускать на них сервисы, связывать контейнеры через общую сеть, находить их по именам и публиковать приложение, насколько этого достаточно для работы в продуктиве.

В этом материале рассмотрим, как Uncloud обновляет сервисы и проверяет новые контейнеры, доставляет Docker-образы, управляет размещением workload, что происходит со stateful-приложениями, как передаются чувствительные данные и как мы можем отслеживать состояние кластера. Также разберём ограничения этой модели —  в большей степени они определяют, для каких задач Uncloud действительно подходит, а где уже стоит смотреть в сторону иных решений.

Читать далее

Бэкап был, восстановить негде: что показала осень 2026 и как устроен теплый резерв

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели5.2K

Октябрьская авария проверила планы восстановления у клиентов пострадавших дата-центров. Среди компаний, которые обратились к нам в эти дни, у одних плана не было, у других копии лежали рядом с рабочими серверами. Эта статья для собственников, которым важна непрерывная работа бизнеса, но которые не готовы погружаться в технические детали. Разберу базовые вещи, без которых не принять решение о резерве: почему запасной дата-центр того же провайдера не всегда спасает, чем теплый резерв отличается от бэкапа и какие семь вопросов задать ИТ-отделу. Настройку резерва потом возьмут на себя ИТ-специалисты.

Читать далее

Аварийное восстановление мультикластерного Kubernetes с Linkerd и HAZL

Время на прочтение13 мин
Охват и читатели7.4K

Высокая доступность приложений помогает выполнять договорные обязательства и соответствовать ожиданиям пользователей. Для этого многие платформенные команды развёртывают кластеры Kubernetes в локальных и облачных окружениях, распределяя их между зонами доступности, регионами и даже провайдерами. Сбой возможен на любом уровне этой инфраструктуры, поэтому нужно заранее проверить, как сервисная сетка поведёт себя при масштабной аварии. Команда VK Tech перевела статью о том, как протестировать аварийное восстановление мультикластерной конфигурации Linkerd и подготовить сервисную сетку к таким сбоям.

Статья адресована организациям, которые уже используют или планируют использовать сервисную сетку в мультикластерной конфигурации. Если вы только знакомитесь с этим подходом, начните с руководства по поддержке мультикластерности в Linkerd, изучите преимущества и недостатки мультикластерного Kubernetes и разберитесь в трёх типах мультикластерных архитектур, которые поддерживает Linkerd. Другие полезные материалы перечислены в конце статьи.

Авторы моделируют реалистичную мультикластерную конфигурацию с открытой версией Linkerd и Buoyant Enterprise for Linkerd (BEL) и разбирают сценарии аварийного восстановления сервисной сетки. Они показывают, от чего зависит восстановление, как воспроизвести сбои в своих кластерах и какие действия помогут устранить выявленные проблемы. Даже если вы не будете запускать демонстрационную конфигурацию самостоятельно, метрики и результаты экспериментов помогут повысить устойчивость сетки и разобраться в роли Buoyant High Availability Zonal Load Balancing (HAZL) — механизма балансировки нагрузки с учётом зон доступности.

Читать далее

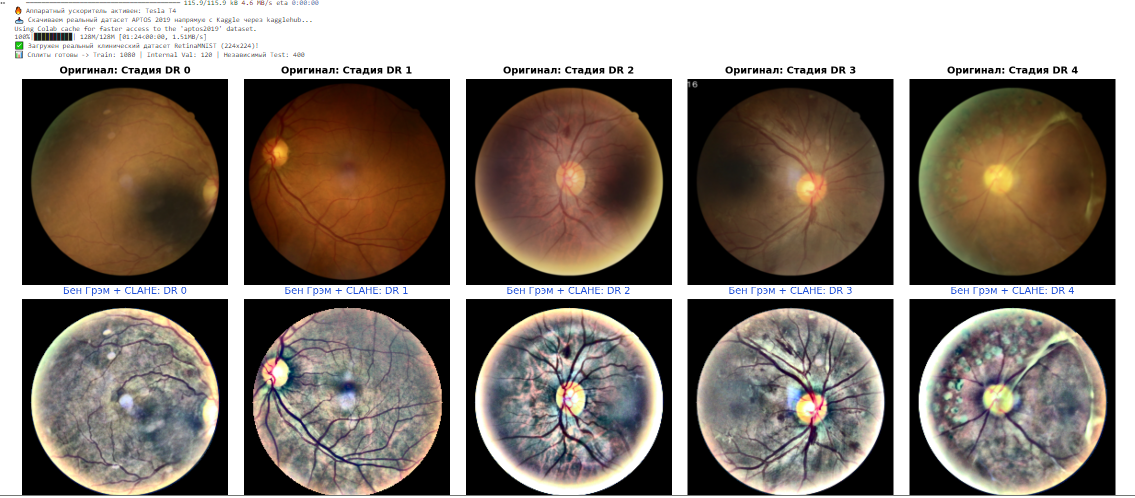
Как я собрал модель для определения стадии диабетической ретинопатии на бесплатном Colab

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели7.4K

Предыстория

Я собрал двухпоточную модель: она смотрит на снимок глазного дна и одновременно получает клинические показатели пациента. На отложенном тесте первый запуск дал QWK 0.834. Потом я стал разбираться, за счёт чего, и оказалось, что клинические признаки в моих данных содержат ответ. Я поставил три контрольных эксперимента, в том числе обучил отдельную модель только по снимкам. У неё QWK 0.713. Ниже весь пайплайн и способы, которыми такая утечка находится.

Читать далее

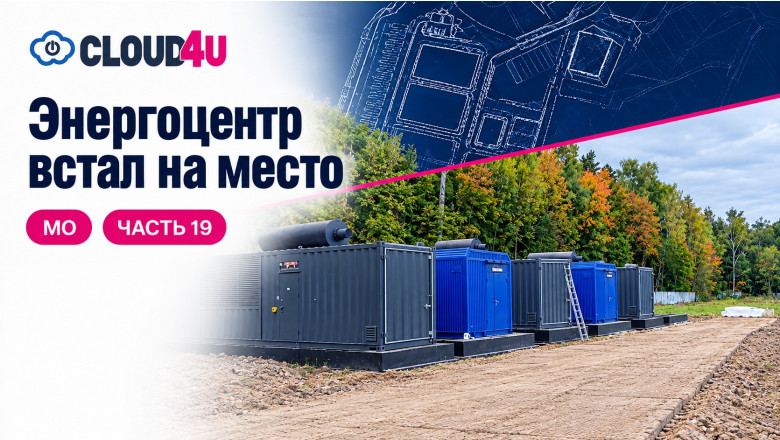
ЦОД в Марфино. Часть 19: энергоцентр и решение, которое нас выручило

Время на прочтение4 мин
Охват и читатели7.8K

Пустыми фундаменты энергоцентра простояли недолго: в сентябре на них появились установки. Также в этом выпуске раскрываем решение, которое нас выручило.

Читать далее

Когда Docker Compose уже мало, а Kubernetes еще слишком много: знакомство с Uncloud. Часть 1

Время на прочтение15 мин
Охват и читатели15K

Disclaimer: статья проверена по документации и репозиторию Uncloud для стабильной версии v0.20.0. Проект активно развивается, поэтому отдельные CLI-команды и Compose-возможности могут меняться между релизами.

Как всегда, всё начинается со специфического запроса от Заказчика: «Мы хотим забыть Kubernetes как страшный сон и вернуться к Docker Compose!».

На этом месте, наверное, многие DevOps-инженеры с пониманием улыбнутся. 

Но после ещё было: «Только, пожалуйста, сделайте так, чтобы было возможно масштабирование. И ещё бесшовное обновление приложений! Но чтобы остался Docker Compose».

В этот момент становится понятно, что задача перестает быть тривиальной.

А если оставить Docker Compose, но добавить к нему часть возможностей, ради которых в подобных сценариях начинают рассматривать Kubernetes? Оказывается, можно. Есть целый класс промежуточных решений: Docker Swarm, Nomad, Kamal, различные PaaS-инструменты, собственные deployment-скрипты. И еще — Uncloud.

Читать далее

7 шагов для подготовки инфраструктуры к высоким нагрузкам, атакам и сбоям

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели2.6K

Подробный чек-лист, чтобы проверить, готова ли ваша инфраструктура к форс-мажорам.

Когда ИТ-инфраструктура даёт сбой, последствия ощущает весь бизнес: клиенты не могут оплатить заказ или воспользоваться услугой, сотрудники — получить доступ к рабочим системам. Причиной может стать высокая нагрузка, кибератака или отказ оборудования. 

Меня зовут Никита Демянчук, я руковожу группой технического взаимодействия с клиентами EdgeCenter. В этой статье разберу семь шагов, которые помогут проверить готовность инфраструктуры: найти слабые места, выбрать подходящие меры защиты и подготовиться к восстановлению после сбоя.

Читать далее

Баг в 0,001% запросов: как Cloudflare ловил пустые ответы MySQL из-за общего кэша

Время на прочтение7 мин
Охват и читатели8.8K

Инженеры Cloudflare рассказывают, как искали баг в Hyperdrive, пулере соединений для MySQL: примерно один запрос из 100 000 возвращал пустой ответ там, где данные точно были. Трассы не ловились, сеть была ни при чём. Причиной оказалась ошибка в самом Hyperdrive: он кэшировал байты в формате Worker, а соседний узел с общим кэшем ждал формат Hyperdrive. Расхождение вскрылось из-за различий в возможностях протокола MySQL (драйвер mysql2 не поддерживает CLIENT_DEPRECATE_EOF). Заодно две истории про кодировки: согласование устаревшего utf8 вместо utf8mb4 и сброс соединения, возвращающий кодировку сервера по умолчанию.

Читать далее

Как Cloudflare отодвинул закупку железа на 8 месяцев: сэмплирование, агрегации и zstd в конвейере данных

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.6K

Команда Data в Cloudflare рассказывает, как держит под контролем конвейер данных, через который идёт около двух миллиардов событий в секунду, пока трафик растёт экспоненциально, а железо линейно. Пять шагов за пять лет: разбор монолитной схемы (−35–40% трафика), замена LZ4 на zstd (−40% сжатого трафика), поздняя репликация вместо двойной записи (−36 ГБ/с), двойное сэмплирование (−25 ГБ/с, 2 ПБ в сутки) и агрегации по всему конвейеру (−80% на HTTP-наборе). С графиками и цифрами по каждому шагу.

Читать далее

Ловушка дешевого GPU: почему цена за час ничего не говорит о реальных затратах на ИИ‑проект

Время на прочтение8 мин
Охват и читатели7.5K

Почасовой тариф на GPU давно стал главным аргументом при выборе облачной площадки. Открываешь таблицу, находишь минимальную ставку, запрашиваешь коммерческое предложение. Логика понятная: дешевле час — дешевле проект.

На практике бюджет ИИ-проекта определяют не тарифы. Его определяют простои, скорость хранилища и сети, время инженеров на настройку и отладку. Проект, который начинался как выгодный по прайс-листу, уходит в перерасход, и заметно это становится только к середине работ.

Привет, Хабр! Меня зовут Миша Воронин, я менеджер продукта GPUaaS в K2 Cloud. С статье расскажу почему дешёвая аренда GPU даёт обратный эффект и какие вопросы задать поставщику до подписания договора, чтобы не считать деньги дважды. А также как выбрать площадку, на которой проект быстрее и надёжнее даст результат.

Читать далее

Ближайшие события

ИИ-гид по обществознанию

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели8.5K

В 2026/27 учебном году школы переходят на единые учебники по обществознанию, а ответ на уроке оценивают «по учебнику», а не «по здравому смыслу». Я собрал прототип чат-бота, который ищет ответы в текстах учебников 9 и 10 классов и указывает страницу: pymupdf4llm, FAISS, multilingual-e5-large и Qwen2.5-3B на бесплатной видеокарте T4.

Читать далее

PaaS‑платформы для простого деплоя и хостинга приложений

Время на прочтение10 мин
Охват и читатели8.1K

В 2026 Claude может помочь легко развернуть проект на VPS‑сервер — решить проблему «Первого дня». Но для решения проблем дальнейшей эксплуатации «второго дня» всё равно либо придётся разбираться в DevOps, администрировании и поддержании инфраструктуры, либо сразу использовать управляемые сервисы.

В статье я покажу, чем хостинг в PaaS‑платформах отличается от VPS и IaaS. И в каком случае, что лучше выбрать.

Читать далее

Что делать, если доступ к Claude пропал, а на нем уже завязан рабочий процесс?

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели15K

Привет, Хабр! На связи команда Рег.облака. С начала октября у российских пользователей Claude снова начали блокироваться аккаунты. Для тех, кто пользуется моделью время от времени через браузер, потеря доступа неприятна, но не катастрофична. Гораздо сложнее ситуация у команд, которые уже встроили Claude в рабочие процессы. Например, подключили через API к внутреннему боту, coding-agent, RAG или автоматической обработке документов.

В таком случае внезапно пропадает уже не просто доступ к чату. Перестает работать кусок системы, который мог месяцами спокойно жить в проде. И тут выясняется, насколько глубоко конкретная модель успела встроиться в код и есть ли вообще запасной вариант.

Мы решили посмотреть на эту историю именно с этой стороны: что происходит, когда один зарубежный сервис становится слишком важной частью рабочего процесса, и как заранее подготовить переход к работе через API, чтобы перенос настроек и контекста не превратился в отдельный проект на несколько недель. А заодно покажем, как мы решаем эту задачу в ИИ-платформе Рег.облака, где несколько моделей доступны через единый API.

Читать далее

как OpenAI, Anthropic, Google и xAI борются за модели, облака и разработчиков

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели7.6K

OpenAI, Anthropic, Google и xAI уже конкурируют не только качеством моделей. Настоящая борьба идёт за вычислительные мощности, собственные чипы, присутствие в облаках, цену API и экосистемы, в которых остаются разработчики.

В этой статье разберём, кто из них сильнее по каждому из этих направлений, почему конкуренты одновременно становятся партнёрами и поставщиками друг для друга, и почему в 2026 году преимущество всё чаще определяется не очередным релизом модели, а инфраструктурой, которую невозможно быстро скопировать.

Читать далее

MWS Cloud Platform глазами новичка: что здесь есть и как все устроено

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели8.2K

Облачные платформы, как правило, выглядят одинаково пугающе: открываешь консоль, а там десятки сервисов, виртуальные сети, Kubernetes, базы данных, IAM, какие-то шлюзы… Вообще непонятно, что там делать, — прямо как при первом заходе в «Битрикс».

Мне по долгу службы выпала возможность поработать через MWS Cloud Platform, и я решил изучить ее как нормальный человек (а не от корки до корки по документации): поставить конкретную задачу и пройти весь путь самому. Сегодня миссия простая: взять готовую LLM в облаке, развернуть ее и начать отправлять ей реальные запросы со своего компьютера.

Если вам нужна LLM как часть своего инструмента, а не как очередной чат-бот, приложение, рабочий скрипт или AI-агент, ее нужно где-то запускать и как-то подключать. GPT Model Hub как раз позволяет взять готовую модель и получить к ней API, не разворачивая всю инфраструктуру самостоятельно.

Поэтому в этом обзоре пройдем путь от первого входа в аккаунт до рабочего Qwen: подключим биллинг, создадим деплоймент, получим API-ключ и заведем модель в VS Code. Этим материалом я запускаю цикл обзоров на большой продукт MWS Cloud Platform.

Поехали!

Читать далее

На чём стоят армянские ИИ-фабрики: энергия и три вектора

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели6K

15 сентября Армения на десять дней осталась без российского газа — и пережила это на иранском бартере. Именно на этой энергосистеме работают обе ИИ-фабрики из первой части: фундамент — российская труба 1988 года, иранский обмен 3 кВт·ч за кубометр и советский реактор, который продлевает Росатом. Арифметика внутри: заявленные планы фабрик съедают почти треть генерации целой страны. Плюс структура киловатта по Армстату, три вектора фактами без выводов и решатель для CTO — на что смотреть до аренды армянских мощностей.

Погрузиться в анализ

Где бесплатно дают доступ к Claude, GPT и другим топовым моделям: 6 сервисов без карты

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели14K

Шесть сервисов, где можно бесплатно получить доступ к Claude, GPT и другим топовым ИИ-моделям без привязки банковской карты. Проверил стартовые кредиты, реальные лимиты, доступные модели и ограничения: от $20 до $100 стартовых кредитов, а в отдельных сервисах — до сотен тысяч токенов и кредитов

Читать далее
1
23 ...