Обновить
64K+

Data Engineering *

Обсуждаем вопросы сбора и подготовки данных

36,86
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

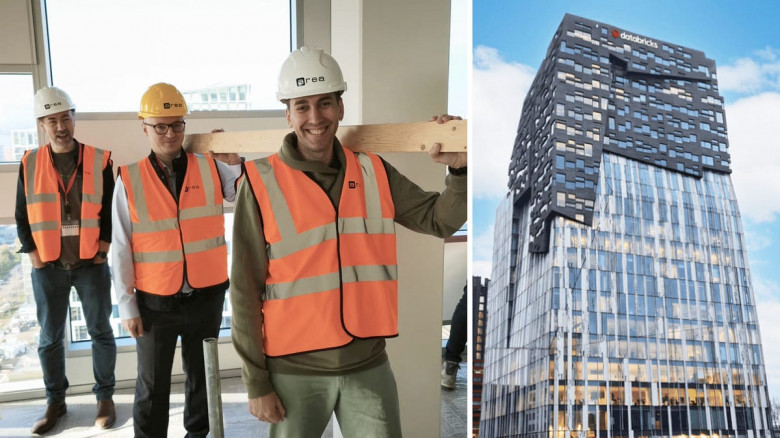
Как выглядит новый офис Databricks в Амстердаме: фоторепортаж 2026

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели11K

Побывал на открытии нового офиса Databricks в Амстердаме, что интересного и необычного в нём и какие преимущества даёт статус Databricks MVP при посещении. Небольшой фоторепортаж.

Читать далее

От DWH на Greenplum к Data Lakehouse: опыт миграции дата-платформы от Лемана Тех

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели6.3K

Когда команды конкурируют за ресурсы Greenplum, а масштабирование упирается в закупку оборудования, начинаешь искать другую архитектуру. Я Артемий Наумов, инженер данных в Лемана Тех. Расскажу, как мы переносим сборку витрин на Data Lakehouse, сохраняем привычную работу с SQL и Airflow и сокращаем путь изменений до production с недели до нескольких часов.

Читать далее

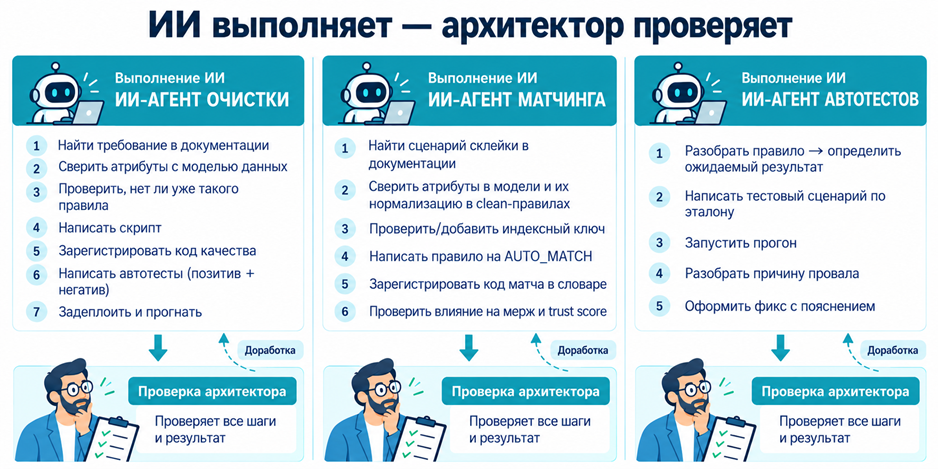
Вайбкодим конфигурацию MDM, а ядро — нет: три ИИ‑агента, 100+ правил и подогнанные автотесты

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели8.7K

Около миллиона записей о физических лицах на арабском и английском и около ста правил обработки с учётом региональной специфики — такую задачу мы решали в пилоте внедрения клиентского MDM. Мы — команда Data Sapience, разработчика Data Ocean Governance MDM.

Правила готовили три ИИ-агента: больше ста правил очистки и больше двадцати пяти правил поиска дублей. Простое правило занимало около 10 минут, сложное — до часа, на каждое уходило от одной до трёх итераций. Пилот сдали. Но по дороге агент автотестов начал подгонять результаты под желаемые, и всплыло это только на очередной проверке.

Агенты меняли только конфигурацию, то есть прикладные правила. Ядро платформы оставалось неизменным. Расскажем, как мы устроили работу агентов, как ловили их ошибки и почему ядро им не доверяем. Вайбкодингом мы здесь называем не «принять код, не читая», а работу агентов с постановкой задачи, тестами и ревью.

Разницу между НСИ, RDM и MDM мы разбирали в статье «Reference Data Management по-русски: что мы называем НСИ и почему это не всегда RDM». Здесь — только о том, как менять конфигурацию MDM с помощью ИИ.

Читать далее

Когда Hadoop начал тормозить бизнес: как мы перестроили платформу данных в Lenta Tech

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели5.2K

Привет, Хабр! На связи Владимир Бибичев, инженер больших данных, и Илья Кисляков, старший инженер больших данных Lenta Tech. Мы занимаемся развитием и сопровождением корпоративной платформы больших данных.

На старой платформе Hadoop ETL-процессы могли часами ждать свободных ресурсов, аналитики не успевали выполнять запросы, а бизнес — вовремя получать данные. С ростом нагрузки ситуация становилась всё сложнее, и в какой-то момент мы поняли: простым расширением кластера проблему не решить.

Пришлось серьезно пересмотреть подход к работе с платформой данных. Что именно мы изменили, с какими трудностями столкнулись и к каким результатам пришли — рассказываем в статье.

Читать далее

Есть ли в лотерее комбинации, которые редко выиграют?

Уровень сложностиСредний
Время на прочтение20 мин
Охват и читатели9.3K

У меня есть хороший знакомый, который уже много лет играет в EuroJackpot. У него есть любимая комбинация чисел и он ставит всегда только её, тираж за тиражом, год за годом.

И однажды случилось то, чего боится каждый такой игрок: он пропустил тираж и именно в этот раз выпала комбинация в которой четыре числа из пяти совпадали с его любимыми. Не джекпот, но вполне ощутимый выигрыш, который он не получил, потому что как раз в тот раз не играл.

Я был уверен, что после этого он сменит комбинацию. Ведь она «уже отстрелялась» и шанс, что четыре её числа снова совпадут с выигрышными, совсем мал. Но он ничего не поменял и до сих пор играет теми же числами.

Правильно ли он сделал?

Как устроена Data Platform в Атоме

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели5.4K

Привет, Хабр!

Меня зовут Александр Ершов, в Атоме я отвечаю за направление данных. В этой статье расскажу, как мы с командой строили дата-платформу с нуля: какую архитектуру выбрали и почему остановились именно на этом стеке.

Если попытаться сформулировать определение что такое дата-платформа, то будет выглядеть так. Дата-платформа - это комплекс технологий, который объединяет разрозненные данные компании, обеспечивает их качество и делает их доступными для анализа. Она помогает бизнесу отслеживать ключевые показатели, находить причины их изменений и принимать решения на основе данных.

Стек, на котором все работает: Flink, Spark, Airflow, S3(managed), Iceberg, Paimon, Nessie, ClickHouse(managed), PostgreSQL(managed), FastAPI, OPA/OPAL, OpenMetadata, Trino. Инфраструктура живет в Яндекс Облаке, поэтому часть решений — managed. Сервисы в K8s, используем Terraform/Terragrunt, частично Ansible, Helm чарты, k8s операторы для Flink и Vault.

Читать далее

ETL на базе Apache Spark. Конфигурации преобразования в формате YAML. Сборка решения из «кубиков»

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели5.3K

В данной статье описываются технологии, использованные для построения полнофункционального ETL на базе Apache Spark. Статья планируется как первая в цикле статей о решении бизнес проблем с помощью созданного ETL с использованием существующих Open-Source решений.

Читать далее

Антипаттерны проектирования БД: как нормализовать таблицу и потерять данные, не удалив ни одного значения

Уровень сложностиСредний
Время на прочтение24 мин
Охват и читатели4.8K

Мы в Modus делаем ETL и BI, и видим чужие базы данных изнутри: на каждом внедрении, на техническом консультировании, на разборах кейсов и на каждой миграции. Навидались всякого. Но одна ошибка попадается так часто и прячется так ловко, что заслуживает отдельного разбора… и почётного звания антипаттерна. Начинаем цикл статей, посвящённых антипаттернам проектирования баз данных именно с неё.

Представьте: миграция позади. Заказы, товары и склады на месте. Число строк сошлось, проверки горят зелёным, можно закрывать задачу. Но только никто — ни аналитик, ни разработчик, ни самый хитрый SQL-запрос, — уже не скажет, с какого склада уехал конкретный товар.

Не удалено ни одного значения. А данные протеряны.

Это сбой миграции? Ошибка в запросе? Нет!

Это ошибка проектирования, которая очень похожа на безобидную нормализацию. Давайте разберём, откуда она берётся, почему стандартные проверки её не видят и почему исправить её задним числом уже нельзя. Не «дорого и сложно», а вообще невозможно математически.

А в конце — задачка для тех, кто (как и мы когда-то) уверен, что опыт и знания надёжно ограждают его от таких новичковых ошибок.

Читать далее

Оптимизация расхода ферромарганца в ДСП-3 с помощью Catboost

Уровень сложностиСложный
Время на прочтение11 мин
Охват и читатели5.3K

Привет, это Рамиль Максютов со второй частью цикла про плавки в ДСП-3. Первая часть тут: https://habr.com/ru/articles/1105616/
В этой статье на данных из первой части учим CatBoost предсказывать минимальную дозу ферромарганца для выплавки отливки из стали 35Л в дуговой сталеплавильной печи с основной футеровкой.

Читать далее

Apache Iceberg: как устроен табличный формат для озера данных

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели6.6K

Интересно наблюдать за тем, как порой разные подходы и парадигмы обмениваются своими лучшими качествами в процессе развития. Одно из таких событий в области хранения и обработки данных — противостояние и сближение DWH и Data Lake.

Как известно, DWH (Data Warehouse или хранилище данных) появился раньше, чем Data Lake (озеро данных). С ростом количества данных появилась необходимость создания и развития новой парадигмы, которая в будущем привела к созданию озера данных. С течением времени классический DWH никуда не пропал — он просто твёрдо занял свою нишу.

Читать далее

Дедлайн для апрува: как научить ASR не ломаться при смене языков

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели5.7K

В реальной жизни люди иногда говорят на смеси языков, например — русского и английского, а порой и переключаются между разными языками во время диалога. Особенно это характерно для международных компаний, у которых сотрудники, клиенты и партнёры могут быть из разных стран. Для систем преобразования речи в текст (ASR) переключение между языками представляет сложность. Они определяют язык диалога по первым репликам и фиксируют его кодовое обозначение, а при смене языка начинают вести себя непредсказуемо. Одни модели заменяют иностранные слова латиницей, другие — подбирают похожие по звучанию (но неверные по смыслу) слова из русского языка, третьи — просто игнорируют нераспознанные фрагменты.

Существенных успехов в решении этой проблемы добились специалисты по обработке аудиоданных из лаборатории искусственного интеллекта российской ИТ-компании «Криптонит». Они разработали методику дообучения моделей транскрибирования речи, устойчивую к переключению языка собеседников. Она позволяет добавить поддержку смены языка (code-switch) в Whisper, GigaAM и другие модели ASR.

Эта разработка может применяться в любых системах обработки речи. Например, для транскрибации совещаний, обработки диалогов технической поддержки, в универсальных приложениях для голосового ввода, для анализа больших массивов речевых аудиоданных, словом — везде, где требуется качественное распознавание аудиозаписей на смеси языков.

Читать далее

Данные для бэктеста на Мосбирже: свой сборщик bid/ask на Python, архивы биржи и DMA

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели5.7K

В БКС есть направление прямого доступа к бирже: мы подключаем алготрейдеров к шлюзам Московской биржи, помогаем с роботами, данными и инфраструктурой. Один из частых вопросов клиентов – где взять историю bid/ask для бэктеста. Этот текст – развернутый ответ: что есть в брокерском API, что продает биржа и когда нужен поток с биржи напрямую. С кодом сборщика и свечей. Статью подготовил Руслан Гнатовский, руководитель направления DMA.

Бэктест на минутных свечах отвечает на вопрос «была ли идея», но не на вопрос «заработал бы на ней робот». Свеча не знает, по какой цене на самом деле можно было войти, кто был инициатором сделок, сколько объема стояло на нужной цен и сколько заявок было перед нами.

Порядок цифр на фьючерсе на доллар (Si): шаг цены 1 пункт, это 1 рубль на контракт. Робот, который входит и выходит по рынку, покупает по ask, продает по bid и на каждом круге отдает спред. Спред 1 пункт, 100 кругов в день по 10 контрактов – 1 000 рублей в день, около 20 000 в месяц, которых нет в бэктесте по цене закрытия свечи.

Ниже три пути получить котировки: записать самому через брокерский API, купить архив у биржи и/или взять поток напрямую с биржи через DMA.

Читать далее

Синтетические плавки в ДСП-3: как сгенерировать данные и не обмануть себя

Уровень сложностиСложный
Время на прочтение21 мин
Охват и читатели8.1K

Привет, Хабр! Эта история началась с того, что меня позвали пообщаться на тему работы в металлургическую компанию. Спросили коротко: «Готов?». Я оценил свои силы, масштаб задачи и ответил прямо — готов зайти сразу на позицию Head of AI, чтобы выстроить процесс от и до.

И тут начался классический корпоративный футбол. Несмотря на предметный разговор, мне начали делать голову из-за отсутствия профильной вышки по программированию. Для суровой индустрии диплом оказался важнее реального опыта и понимания процессов. Поняв, что стандартным путем эту бюрократию не пробить, я решил пойти напролом: за пару недель собрать работающее MVP, показать товар лицом и жестко выделиться на фоне остальных кандидатов с «правильными» дипломами.

Спойлер: красивого хэппи-энда не будет. Моё MVP до высшего руководства так и не донесли, а меня в итоге просто развернули на пороге. Но не пропадать же добру? Проект получился слишком интересным, чтобы просто похоронить его на жестком диске.

Эта статья посвящена исключительно генератору. Мы разберем, как он устроен «под капотом», какие неочевидные ошибки я в нем допустил, и как проверить, что синтетика не врет сама себе. Обучение CatBoost и создание работающего микросервиса-советника мы оставим для второй части.

Статья написана так, чтобы репозиторий вам не понадобился: весь код приведен прямо здесь, в том порядке, в котором его удобно читать и воспроизводить. Если вы захотите пропустить теоретические объяснения, в конце каждого раздела есть готовый рабочий фрагмент кода, который можно скопировать и запустить у себя.

Читать далее

Ближайшие события

Не клади все данные в одно облако

Время на прочтение9 мин
Охват и читатели7K

При выборе облака для размещения сервисов и приложений обычно изучают доступную информацию о том, как устроена инфраструктура провайдера. Дублированные вводы питания и сеть, дизель-генераторы, SLA с множеством девяток, надёжные СХД, сертификаты Uptime Institute – всё это успокаивает при оценке рисков.

Это впечатление во многом справедливо: облачные провайдеры обычно уделяют много внимания надёжности ЦОДов. Но надёжность площадки и сохранность данных клиента – не одно и то же. В облаке ответственность разделена: провайдер отвечает за доступность платформы, а защита приложений и аварийное восстановление (DR) остаются за клиентом. Риски при этом те же, что на собственной площадке: отказы оборудования, вредоносное ПО, ошибки администраторов. Компенсация по публичному SLA провайдера, как правило, ограничена стоимостью услуги и не покрывает потери от простоя сервиса и утраты данных.


Резервное копирование средствами провайдера защищает от многих проблем, но не от всех: копии хранятся в том же облаке, что и основные данные, и могут оказаться с ними в одном домене отказа. Домен отказа – это набор ресурсов, которые выходят из строя одновременно из-за одного события. В облаке таким доменом может оказаться не стойка и не машинный зал, а целый ЦОД, облако провайдера или один клиентский аккаунт. Если основные данные и копии находятся в одном домене отказа, одно событие затрагивает их одновременно.
Читать далее

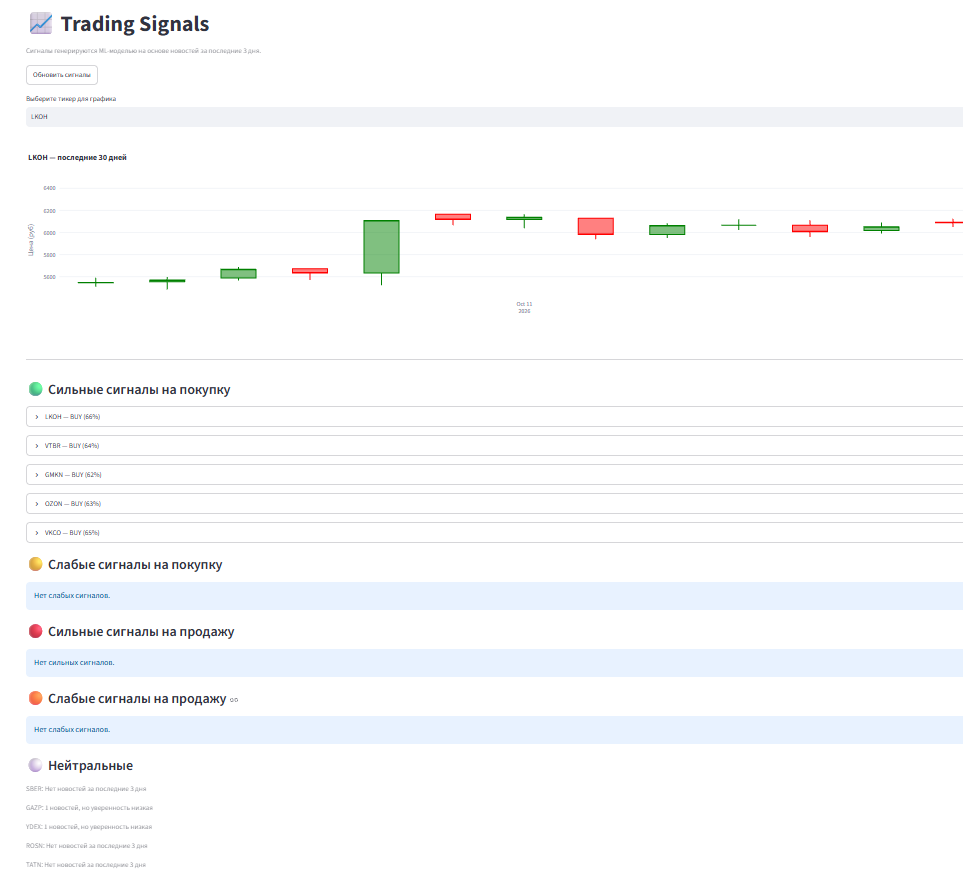
Как я скрестил RAG, LLM и RandomForest: архитектура торгового сигнала с доказательствами

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели6.2K

В первой части я рассказывал, как собрал RAG-систему с LangGraph-агентом на локальных LLM. Она умела искать новости, отвечать на вопросы и извлекать сущности. Но для трейдинга этого мало — нужно не просто читать, а предсказывать.

В этой статье я расскажу, как превратил новостной скрапер в ML-пайплайн, который генерирует торговые сигналы (BUY/SELL/NEUTRAL) с доказательствами. Мы пройдём путь от привязки новостей к тикерам до Explainable UI, разберём грабли на малых данных и заглянем в архитектурное будущее проекта.

Стек: Scikit-learn, Plotly, FastAPI, Streamlit, PostgreSQL, Ollama.

Читать далее

Как я парсил казахстанские госсайты через COM

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели4.6K

Отдел аналитики FMCG-производителя каждый неделю человек открывал stat.gov.kz, качал пачку Excel-таблиц, потом шёл на сайт Нацбанка за курсами, потом на KASE, потом за мировыми ценами на сахар и какао к FAO.

И мне сказали "Автоматизируй"

Читать далее

От вопроса к данным за пять минут: как мы встроили корпоративные данные в ИИ‑платформу

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели6K

Бесконечные запросы на выгрузку данных, ожидание нужных отчетов, жаркие споры вокруг инициатив на планерках, не подкрепленных цифрами, — это признаки дефицита данных у менеджеров. Мы столкнулись с этой проблемой и благодаря современным технологиям смогли решить ее. Результаты меня впечатлили и порадовали.

Читать далее

Единое окно инженера данных: как мы построили веб-среду разработки для 12 000 потоков данных

Время на прочтение5 мин
Охват и читатели5.3K

Привет, Хабр! Меня зовут Никита Калганов, я ведущий системный инженер данных в X5 Tech. Мы с командой проектируем и развиваем высоконагруженную систему потоков данных и поддерживаем её в условиях постоянного роста, как по числу потоков, так и по количеству команд, которые с ней работают.

В нашей системе обработки данных живёт больше двенадцати тысяч потоков данных, и их число растёт в среднем на несколько десятков в день. Всё нормально работает, но мы решили сделать её ещё лучше. В этой статье расскажу, как мы построили единое окно инженера данных, сделали собственный DDL-мигратор с поддержкой зависимостей и при этом сохранили то, что уже работает.

Читать далее

Семь проверок перед тем, как нести руководителю вывод от ИИ

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели5.9K

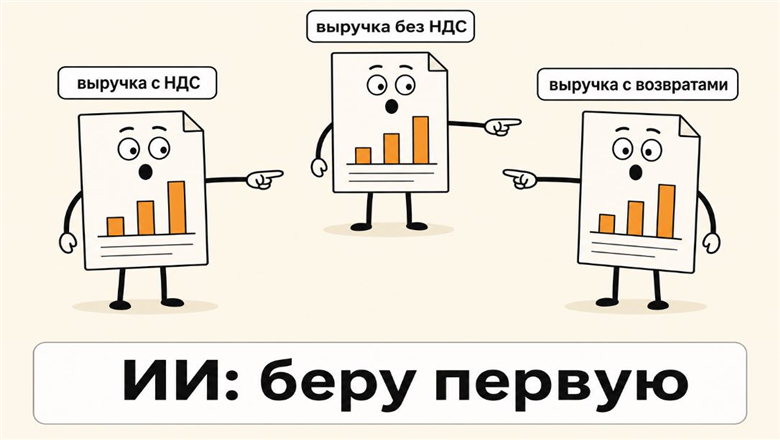
Руководитель спрашивает, почему просела выручка в регионе. ИИ через минуту отвечает связным текстом, с цифрами и объяснением. Ещё через час финансовый директор уточняет, включён ли в цифру НДС и из какой она таблицы, и ответа ни у кого нет.

Мы в GlowByte внедряем BI и пилотируем GenBI-решения на данных клиентов, поэтому постоянно видим такие уверенные ответы без источника.

Ниже семь проверок, которые стоит пройти до того, как цифра от ИИ уйдёт наверх, и отдельно о том, где они не спасают. Большинство пунктов аналитик знает и без нас. Раньше их за него делало совещание, где два человека приносили разные цифры. Теперь цифру озвучивает система, и спорить с ней некому.

Чек-лист целиком стоит в конце статьи, его можно скопировать.

Читать далее

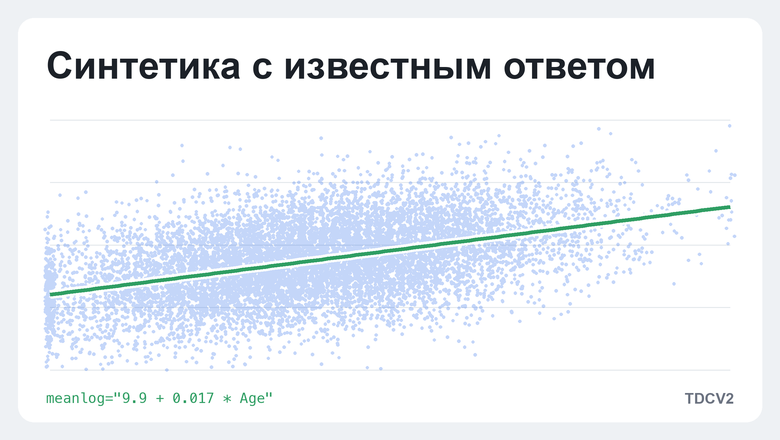
Данные без противоречий: синтетика с известным ответом

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели8.1K

Статья пригодится тем, кто готовит синтетические данные для обучения моделей, проверяет методы анализа или пишет пайплайн, который должен переживать неполные и грязные данные. И тем, кто учит статистику или машинное обучение и хочет показать студентам явление, а не рассказать о нём.

Читать далее
1
23 ...