Обновить
256K+

DevOps *

Методология разработки программного обеспечения

380,93
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

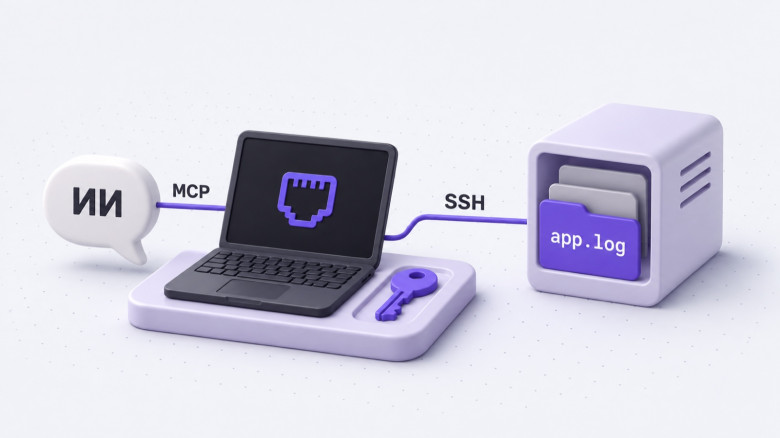
Как дать ИИ доступ к серверным логам по SSH и не давать доступ к SSH ключу

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели5.1K

«Посмотри последние двадцать строк лога checkout» — для дежурного это просьба на минуту. С ИИ-ассистентом возникает встречный вопрос: какие права я ему для этого выдам? По соседству с нужным файлом лежит журнал HTTP-запросов, а моим SSH-ключом можно читать оба. Передавать ассистенту ключ ради одного tail я бы не стал.

Покажу на тестовом примере, как я открываю ассистенту один журнал по SSH. У доступа будет простой критерий проверки: последние строки app.log читаются, а соседний access.log остаётся недоступен даже тогда, когда ассистент знает его имя.

Читать далее

Кит уплыл в мир агентов: что на самом деле поменялось в Docker после «Run on trust»

Время чтения5 мин
Охват и читатели7.7K

Даже Docker, который казался вечным фундаментом под любым проектом, меняется вслед за AI. 19 ноября компания сменила кита и слоган, а первый экран docker.com теперь целиком про агентов. При этом половина продуктов с меткой New вышла ещё летом. Давайте посмотрим, что на самом деле поменялось, что можно поставить себе бесплатно и куда плывёт кит.

Читать далее

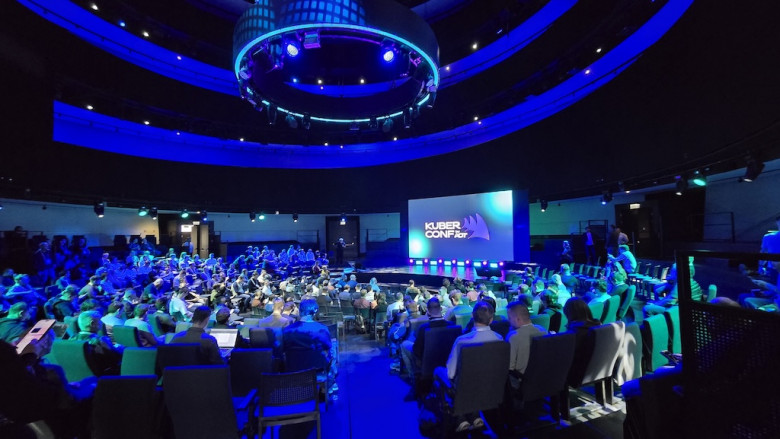
Kuber Conf 2026: Kubernetes, AI‑SRE и State of Cloud Native Russia

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели6.9K

Привет, Хабр! Меня зовут Сергей Киселев, я председатель программного комитета Kuber Conf и член Экспертного совета АОТ. Уже в этот понедельник, 23 ноября, конференция пройдет во второй раз — в Москве, на площадке Connect. Регистрация откроется в 10:00, а в 11:00 мы стартуем главный доклад конференции: Экспертный совет АОТ поделится взглядом на то, что станет с индустрией облачно-ориентированных технологий в 2027 году.

Первая Kuber Conf от АОТ прошла в декабре прошлого года и собрала больше 550 человек. Я там был, и это выглядело как большой митап по технологиям. Эту ламповость мы бережно сохранили. Конференция по-прежнему некоммерческая, программу собирали практикующие инженеры, а в гостиной АОТ весь день будут сменять друг друга эксперты совета. Вечер закончится афтепати с несерьезным круглым столом про то, уволит ли нас всех ИИ.

О чем будем говорить:

Kubernetes: как уронить весь парк кластеров одной строчкой, мультитенантность через проекты, bare metal и GPU через DRA. Плюс круглый стол о том, не проблема ли, что Kubernetes победил.

AI-SRE: LLM-диагностика инцидентов, агент с доступом к управлению кластером и AI-чат, который видит все ваши системы.

State of Cloud Native Russia 2026: Экспертный совет АОТ разберет исследование и покажет, что отличает сильные команды, когда стек у всех одинаковый. А в гостиной и в кулуарах эти выводы можно будет почеленджить лично.

Под катом программа по трекам, круглые столы и ссылки. Полное расписание и регистрация на сайте конференции.

Подробности

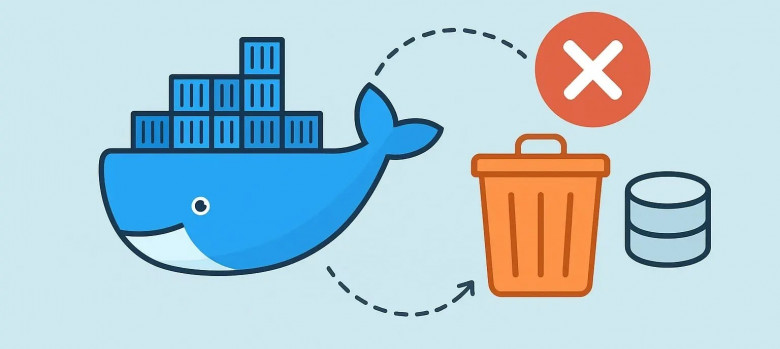
docker compose --remove-orphans удалил мне базы данных: как работает имя проекта в Compose

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели4.2K

Разнёс infra и app по двум compose-файлам в одной папке, запустил docker compose -f app.yml down --remove-orphans и потерял MongoDB, Redis, RabbitMQ и nginx. Причина в том, что имя проекта Compose берёт из папки, а не из файла. Разбираю, как Compose находит «сирот», почему уцелели тома и как развести проекты, не потеряв данные при переименовании.

Читать далее

Ненастоящий деплой, или как подложить свинью разработчикам

Уровень сложностиСредний
Время чтения4 мин
Охват и читатели6.3K

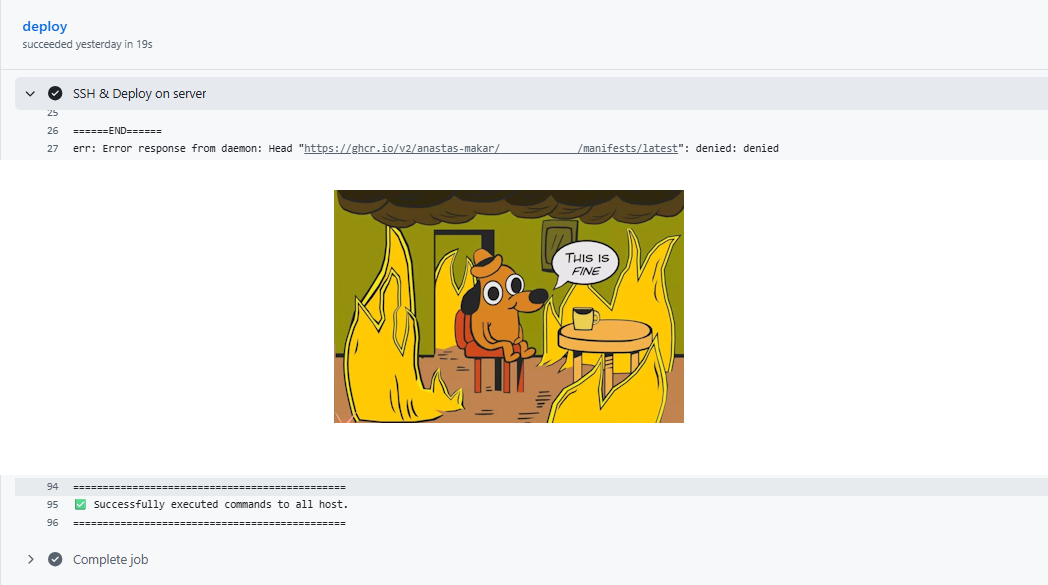
Представьте: деплой прошёл, пайплайн зелёный. Контейнер остановился и запустился заново — это видно в логах. Но на проде изменений нет. В такой ситуации вопросы задают разработчику. Особенно неприятно, если он как раз ловит плавающий баг.

Но иногда дело не в баге. Код мог вообще не попасть на сервер.

Для простоты рассмотрен односерверный деплой через Docker Compose, без blue-green и без гарантии работы без перерыва. Здесь интересен не образцовый способ выкладки, а конкретная ошибка обработки статуса команд.

Читать далее

Круг второй: шесть попыток, один ключ

Уровень сложностиСложный
Время чтения12 мин
Охват и читатели6.7K

Учим Zabbix не забывать историю метрик Docker Swarm. Круг второй — вскрытие базы данных Zabbix, шесть попыток заставить систему принять стабильный ключ и разгадка того, как это сработало. Внутри — логика работы шаблона и заголовок X-PortainerAgent-Target, который спас ситуацию.

Погрузиться в ад...

Docs-as-code на максималках. Часть 5: На пути к вайбаналитингу

Время чтения7 мин
Охват и читатели6.3K

Цикл "Docs-as-code на максималках":

1. Фундамент: архитектура и видение проекта
2. Публикация: пайплайн Markdown → Confluence
3. Рабочее место: Obsidian как IDE для аналитика
4. Правила игры: Workflow и обратная совместимость
5. AI-агент: На пути к вайбаналитингу ← вы здесь

Последняя статья цикла. У нас есть CI-движок, допиленный Obsidian и выстроенный процесс. Попробуем сделать то, без чего не обходится ни один проект в 2k26м - создадим AI-агента на базе подготовленного ранее фундамента. Разберем, как использовать его по максимуму, чтобы не получить "еще один чат с MCP".

Читать далее

Docs-as-code на максималках. Часть 4: Workflow и обратная совместимость

Время чтения6 мин
Охват и читатели6K

Цикл "Docs-as-code на максималках"

1. Фундамент: Архитектура и видение проекта
2. Публикация: Пайплайн Markdown → Confluence
3. Рабочее место: Obsidian как IDE для аналитика
4. Правила игры: Workflow и обратная совместимость ← вы здесь
5. AI-агент: На пути к вайбаналитингу

У нас уже есть движок публикации и настроенный GUI-редактор. Теперь обсудим рабочий флоу аналитика в новом окружении и как организовать переезд из Confluence, никого и ничего не поломав.

Читать далее

Docs-as-code на максималках. Часть 3: Obsidian как IDE для аналитика

Время чтения7 мин
Охват и читатели5.6K

Цикл "Docs-as-code на максималках"

1. Фундамент: Архитектура и видение проекта
2. Публикация: Пайплайн Markdown → Confluence
3. Рабочее место: Obsidian как IDE для аналитика ← вы здесь
4. Правила игры: Workflow и обратная совместимость
5. AI-агент: На пути к вайбаналитингу

Движок публикации у нас уже есть. Но пока аналитик пишет спеки в сыром Markdown, удобства работы у него не прибавится. Попробуем исправить это: выберем и затюним редактор под наши нужды.

Читать далее

Docs-as-code на максималках. Часть 2: Пайплайн Markdown → Confluence

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели5.4K

Цикл "Docs-as-code на максималках"

1. Фундамент: Архитектура и видение проекта
2. Публикация: Пайплайн Markdown → Confluence ← вы здесь
3. Рабочее место: Obsidian как IDE для аналитика
4. Правила игры: Workflow и обратная совместимость
5. AI-агент: На пути к вайбаналитингу

В прошлой части мы договорились о распределении ответственности: Git - мастер-система для хранения документации, Confluence - витрина для чтения. Теперь собираем движок, который перенесет md-файлы в страницы Confluence.

Читать далее

Docs-as-code на максималках. Часть 1: Архитектура и видение проекта

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели5.6K

Цикл "Docs-as-code на максималках"

1. Фундамент: Архитектура и видение проекта ← вы здесь
2. Публикация: Пайплайн Markdown → Confluence
3. Рабочее место: Obsidian как IDE для аналитика
4. Правила игры: Workflow и обратная совместимость
5. AI-агент: На пути к вайбаналитингу

Это первая статья из цикла "Docs-as-code на максималках". В цикле я по шагам разбираю, как мы за два года перевели работу системных аналитиков с классического Confluence на "гибкий docs-as-code" и собрали вокруг этого целый конвейер с AI-агентом.

Читать далее

YAML валиден. А приложение не стартует

Уровень сложностиСложный
Время чтения1 мин
Охват и читатели6.2K

YAML валиден. А приложение не стартует

Линтеры и стандартные проверки могут сказать, что с Helm-чартом всё в порядке. Но этого не всегда достаточно, чтобы понять, как конфигурация поведёт себя после деплоя

💡На DevOops 2026 Михаил Харчук, руководитель направления DevOps, показал, где заканчивается линтинг и начинается эксплуатационная валидация

Читать далее

Переход Kubernetes на cgroup v2: что нужно знать

Время чтения12 мин
Охват и читатели9K

В Linux cgroups (контрольные группы) — это механизм ядра для управления системными ресурсами. Kubernetes использует cgroups, чтобы выделять контейнерам CPU и память, обеспечивать стабильную работу приложений и не допускать их взаимного влияния. С выходом Kubernetes v1.31 поддержка управления cgroup v1 перешла в режим сопровождения. Поддержка управления cgroup v2 стабильна с Kubernetes v1.25.

По сравнению с cgroup v1 версия cgroup v2 предлагает единую иерархию, более согласованный интерфейс и более надёжную основу для изоляции ресурсов и современных функций управления ими.

Команда VK Tech перевела статью о том, зачем Kubernetes переходит на cgroup v2, что меняется в управлении ресурсами и как подготовить узлы к миграции.

Читать далее

Ближайшие события

Вебинар. Миграция на свой Exchange-сервер: перенос писем, календарей и настройка почтовой инфраструктуры

Время чтения1 мин
Охват и читатели6.8K

Многие относятся к переезду на Exchange как к рутинной задаче: «зальем ящики через PST, поменяем MX-запись и пойдем пить кофе». На практике же именно в этот момент ломаются действующие календари, письма с нового сервера начинают падать в спам у контрагентов, а в ящиках пользователей появляются дубли. Чтобы переезд не превратился в аврал с жалобами от сотрудников и руководства, нужно заранее знать, где именно инфраструктура может дать сбой.

Читать далее

Как собрать полный стек защиты данных при резервировании инфраструктуры? Расскажем на вебинаре

Время чтения1 мин
Охват и читатели6.9K

Одного резервного копирования может быть недостаточно. Что происходит при недоступности ЦОД? Как сочетаются Multi-AZ, аварийное восстановление (DRaaS) и резервное копирование (BaaS)? И как сократить время простоя и снизить потери при сбоях? Разберем это на вебинаре.

Ждем ИТ-директоров, архитекторов инфраструктуры, CISO, DevOps-инженеров и всех, кто отвечает за непрерывность работы сервисов.

📅 Когда? 26 ноября в 11:00 мск.
📍 Где? Онлайн. Зарегистрируйтесь, чтобы задать вопросы спикерам в прямом эфире.

👉 Зарегистрироваться на вебинар

Подробнее о том, что расскажем и покажем

Является ли eBPF лучшим выбором для решения задач контроля целостности

Уровень сложностиСложный
Время чтения30 мин
Охват и читатели9.6K

Привет, Хабр! На связи Даниэль из InfoWatch, разработчик решений класса информационной безопасности. В предыдущей статье мы рассматривали задачу контроля целостности в среде Linux с помощью системного интерфейса fanotify. Поговорили о том, решает ли fanotify проблемы более старого инструмента — inotify.

Часть существенных недостатков менее совершенного механизма inotify была закрыта более продвинутым fanotify, однако и он, в свою очередь, не является «серебряной пулей» в теме решения задач мониторинга файлов. Заключительная часть статьи указывала на ряд недочётов, которые злоумышленник может использовать в ходе запутывания следов.

В рамках этой статьи хотелось бы поговорить о ещё более сложном инструменте ядра Linux — eBPF.

Введение

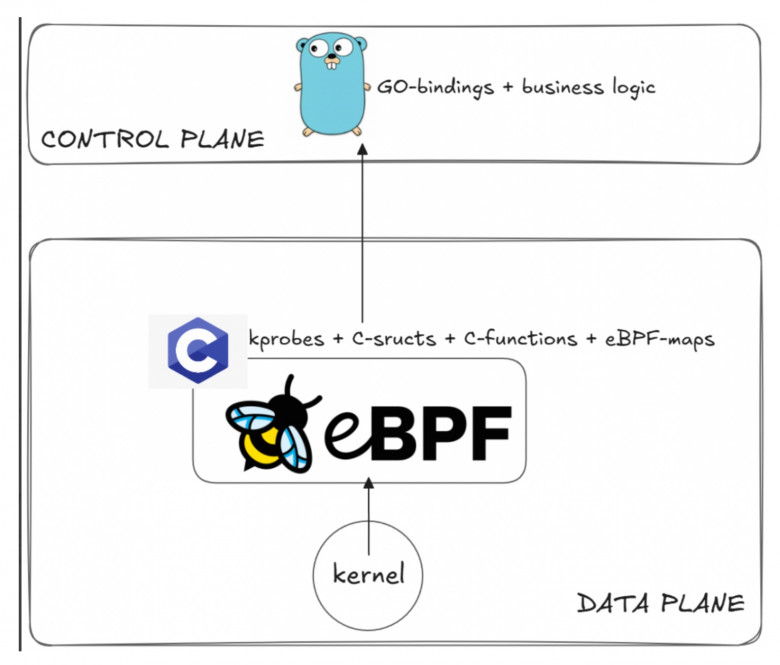
Начнём с краткой сводки. eBPF представляет собой технологию ядра Linux, позволяющую выполнять пользовательский безопасный код внутри пространства ядра ОС без изменения исходного кода ядра и без перезагрузки системы. Почему «безопасный»? Откуда такая уверенность в том, что горе-программист не загрузит в ядро косячный код? Перед загрузкой программ идёт стадия верификации. Верификатор eBPF — это встроенный в ядро Linux защитный модуль, который проверяет каждый байткод перед его запуском. Он гарантирует, что программа безопасна, не уронит систему, не зависнет в бесконечном цикле и не получит доступ к чужой памяти

Читать далее

AI ускоряет написание кода. Почему это не гарантирует ускорения доставки?

Уровень сложностиСредний
Время чтения19 мин
Охват и читатели6.5K

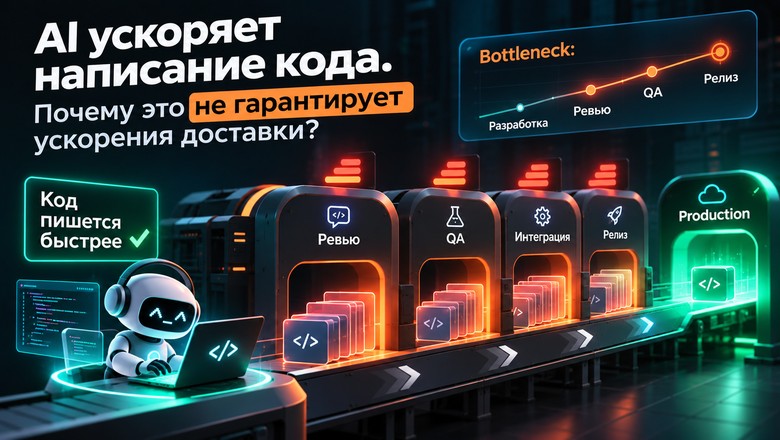
Как AI меняет экономику Software Development Lifecycle, почему ограничения перемещаются между этапами разработки и какой может стать архитектура Software Delivery к 2030 году.

Введение. Мы ускоряем не ту часть системы?

Последние пятнадцать лет индустрия последовательно оптимизировала разработку: Agile, автотесты, Continuous Integration и Continuous Delivery, DevOps, маленькие релизы, выкатки по несколько раз в день. За всем этим стояла одна задача — сократить путь от идеи до её реализации в production.

Потом появились AI-инструменты. GitHub Copilot, Cursor, Claude Code и другие изменили стоимость самого первого шага: разработчик теперь может делегировать модели функцию, тест, документацию, рефакторинг, а иногда и целую задачу.

И здесь возникает вопрос, который, на мой взгляд, заслуживает большего внимания, чем получает. Что произойдёт, если мы существенно ускорим создание изменений, а их проверку, интеграцию и доставку оставим практически неизменными? На первый взгляд ответ очевиден: будем быстрее выпускать функциональность. С точки зрения системной инженерии всё сложнее. Ускорение отдельного этапа не гарантирует роста пропускной способности всей системы — иногда оно просто увеличивает нагрузку на следующий этап.

Поэтому я предлагаю смотреть на AI не только как на инструмент продуктивности разработчика, но и как на фактор, который заставляет переосмыслить архитектуру всего SDLC. Это не значит, что существующий CI/CD устарел. Наоборот, его принципы становятся важнее. Но способы организации проверок, управления рисками и доставки изменений, похоже, придётся менять.

1. AI действительно ускоряет разработку?

Вокруг AI-assisted development много маркетинга, а эмпирика заметно менее однозначна.

В 2023 году исследователи GitHub и Microsoft провели контролируемый эксперимент с Copilot: участникам нужно было реализовать HTTP-сервер на JavaScript. Группа с Copilot справилась в среднем на 55,8% быстрее контрольной. Но стоит помнить детали: участвовали 95 разработчиков, набранных на Upwork, задание завершили 35, а сравнивали время среди завершивших. Это результат конкретного эксперимента с задачей с нуля, а не оценка любой инженерной работы.

В 2025 году METR пошла другим путём: 16 опытных open-source разработчиков, 246 реальных задач в проектах, которые они хорошо знали. Результат оказался противоположным — с разрешённым AI задачи занимали в среднем на 19% больше времени. Самое интересное, что участники до эксперимента ожидали ускорения, а после него продолжали считать, что AI помог им работать быстрее.

В феврале 2026 года METR опубликовала продолжение на выборке побольше. Новые наблюдения указывали на возможное ускорение, но из-за смещения выборки — часть разработчиков отказывалась делать задачи без AI — и изменившегося поведения участников авторы не смогли надёжно оценит

Читать далее

Но мы же не меняли код! Откуда взялась новая уязвимость?

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели7.1K

Представьте: в пятницу я заканчиваю работу над новой версией программы. Проверки пройдены, до понедельника код точно никто не тронет. Но в понедельник я открываю отчет и вижу новое предупреждение об уязвимости. Появляется вопрос: чем таким небезопасным программа занималась на выходных?

Читать далее

Ubuntu 26.10 после релиза: известные проблемы и рекомендации

Время чтения7 мин
Охват и читатели6.4K

Новые возможности — это здорово, но промежуточный релиз — ещё и проверка того, насколько ваша инфраструктура готова к переменам. Ниже — карта того, где в 26.10 уже расставлены предупреждающие знаки, а где можно смело двигаться дальше.

Читать далее

Что почистить в Claude Code после того, как вас забанили

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели6.2K

Разбираю структуру файлов Claude Code: что хранится в ~/.claude.json (userID, machineID, oauthAccount), где лежат токены доступа и резервные копии. Скрипты для Linux, macOS и Windows закрывают процессы, удаляют конфигурацию и учётные данные перед использованием другого аккаунта. Передачу идентификаторов с запросами не проверял — только хранение на диске.

Читать далее
1
23 ...