Обновить
512K+

Машинное обучение *

Основа искусственного интеллекта

960,25
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

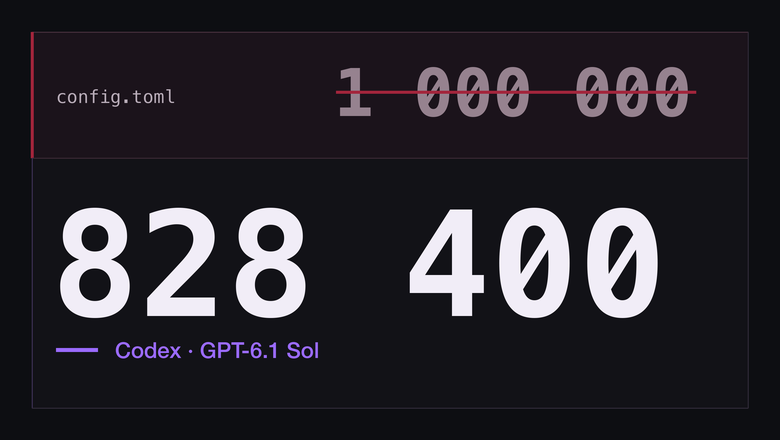
Миллион в config.toml, 828 тысяч в Codex и 890 тысяч на входе: что на самом деле значит окно контекста

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели4.5K

В ~/.codex/config.toml у меня стоит model_context_window = 1000000. Codex на GPT-6.1 Sol в каждой задаче сообщает окно 828 400.

Я разобрал, откуда берётся это число, поднял его до 900 000 своим каталогом моделей и прогнал синтетический вход на 890 547 токенов с контрольными метками.

Контрольный запуск показал больше основного: тот же вход на 888 330 токенов прошёл и без моей правки, при окне 828 400.

Замеры сделаны 27.10.2026 на Codex CLI 0.163.0, вход через подписку ChatGPT. Часть данных - из сентябрьских проб на GPT-6 Astra, это помечено.

Читать далее

Новости

Под капотом iZotope: что общего у Nectar, Neutron, Ozone и RX

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели4K

У iZotope есть плагины для вокала, сведения, мастеринга и реставрации записи. Снаружи они выглядят как отдельные продукты. Внутри обнаруживаются общие вычислительные узлы, интерфейсные механизмы и способы передачи параметров.

Я разобрал, как устроено это семейство: что связывает компрессоры Nectar и Neutron, зачем iZotope собственный интерфейсный движок Glass и где в обработке участвуют ML-модели. Отдельно проверил задержку компрессора Nectar: при 48 кГц сигнал сдвигается на 47 сэмплов даже при Mix 0%.

В статье покажу схемы, примеры C++ и результаты измерений. Заодно сравню эти решения с открытыми проектами и разберу, сколько работы скрывается за привычными ручками Attack, Release и Mix.

Читать далее

Kylin Desktop V11 изнутри: неизменяемая система, встроенные нейросети и обзор программ

Уровень сложностиСредний
Время на прочтение28 мин
Охват и читатели4.2K

Автоматизированное тестирование наших продуктов для Avalonia UI работает на виртуальных машинах с разными Linux: Ubuntu, Astra Linux, ALT, РЕД ОС. Мы планируем расширить этот набор. Изучили Kylin Desktop V11 (银河麒麟, «Галактический Цилинь») — основную ОС для госсектора Китая — и решили поделиться результатами. В этой ОС встречается несколько интересных вещей, о которых мы хотим рассказать сегодня. Корень системы неизменяемый и обновляется атомарно через ostree, apt работает в отдельном контейнере, у программ свой формат пакетов, а вместе с рабочим столом запускается сервер инференса NVIDIA Triton с двумя десятками нейросетей.

Читать далее

Выбираем кодинг-агента для Дельфи

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели5K

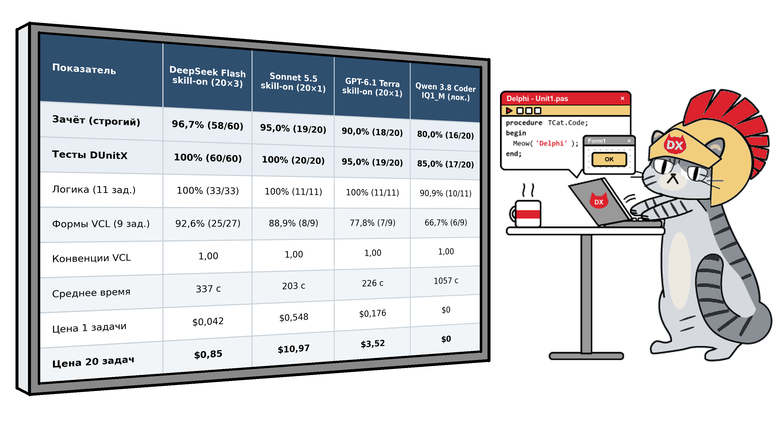
Так уж исторически сложилось, что весь научный и лабораторный софт — от программы рентгеновской рефлектометрии X-Ray Calc до нашего электронного лабораторного журнала — я пишу на Delphi. Когда к этой работе подключились кодовые агенты, выяснилось, что публичные рейтинги моделей мало чем помогают при выборе правильного инструмента: они там все проверяют Python и TypeScript, а на паре .pas и .dfm даже лидеры рейтинга регулярно ломают формы VCL.

Так что мы отобрали 20 задач из трёх наших репозиториев на Delphi и прогнали на них семь облачных и локальных моделей в двух режимах: без подсказок и с нашим навыком delphi-development и нашли победителя!

Читать далее

Галлюцинации недели: Взломать можно было всех и сразу, от WordPress до Яндекс Станции

Время на прочтение12 мин
Охват и читатели5.6K

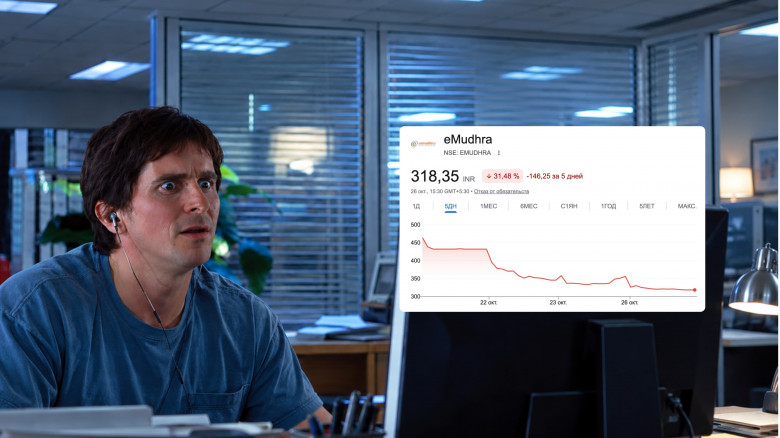
Всю эту волну в Твиттере прозвали Black October. У индийского удостоверяющего центра ключи можно было восстановить прямо из сертификатов, LiteLLM меньше чем на два часа выехал на PyPI с похитителем учёток, а Railway после инцидента отозвала все API-токены.

Читать далее

Few-shot: пристрелочная для ИИ-агента

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели8K

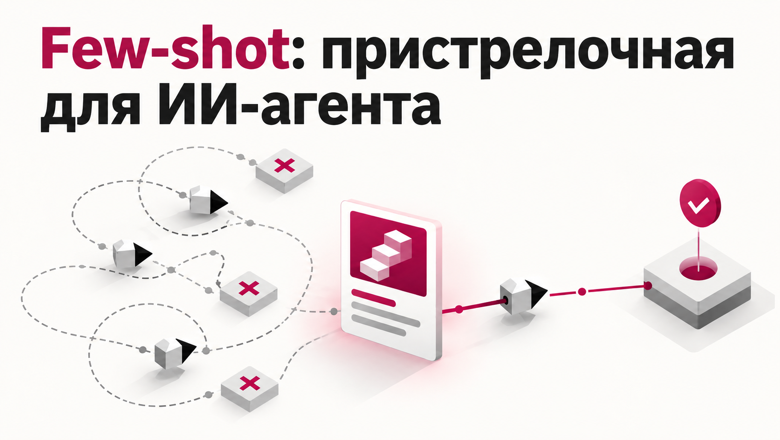
Я использую GLM как «молотилку»: отдаю ей большой объём реализации. Модель хорошая, “рабочая лошадка”, но иногда тупит. Я решил проверить, помогут ли ему несколько готовых примеров поверх уже существующих контрактов и автоматических проверок. И получится ли внедрить эту семантику в протоколы. Провёл два небольших эксперимента: сначала на локальных моделях, затем на GLM и Haiku. Академической строгости здесь нет, но практический сигнал получился достаточно заметным, чтобы продолжить тесты на рабочих проектах.

Читать далее

Сказ от Anthropic о том, как рой ИИ-агентов может превратиться в сборище бюрократов

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели8.7K

В статье Building agents: When to fold subagents into your main agent loop, опубликованной 22 октября 2026 года, Diane Sarkis из Anthropic описала случаи, в которых замера множества ИИ-агентов на одного агента с навыками и инструментами приводила к значительному повышению качества работы, снижению стоимости и времени выполнения запросов. Это выглядит так, как будто создать множество узкоспециализированных ИИ-агентов — во многих случаях не очень хорошая идея.

Читать далее

Как мы учили нейросеть распознавать дипфейки и объяснять свой вердикт

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели5.9K

Сегодня генеративный ИИ меняет жизнь даже тех людей, кто не знает, что такое «генеративный ИИ». И не всегда эти изменения во благо. Например, мошенники уже научились применять генеративные аудиомодели, чтобы обманывать доверчивых граждан, имитируя голоса их близких и уговаривая расстаться с крупными суммами денег. А это значит, что создание методов надежного обнаружения речевых дипфейков (Speech Deepfake Detection, SDD) — это уже больше, чем просто академическая задача. 

К сожалению, существующие SDD зачастую недостаточно универсальны: они плохо адаптируются к новым аудиодоменам и типам генераторов. Но, что самое неприятное, им недостает интерпретируемости — то есть способности объяснить, почему аудио является подлинным или поддельным, предоставляя при этом понятные человеку признаки.

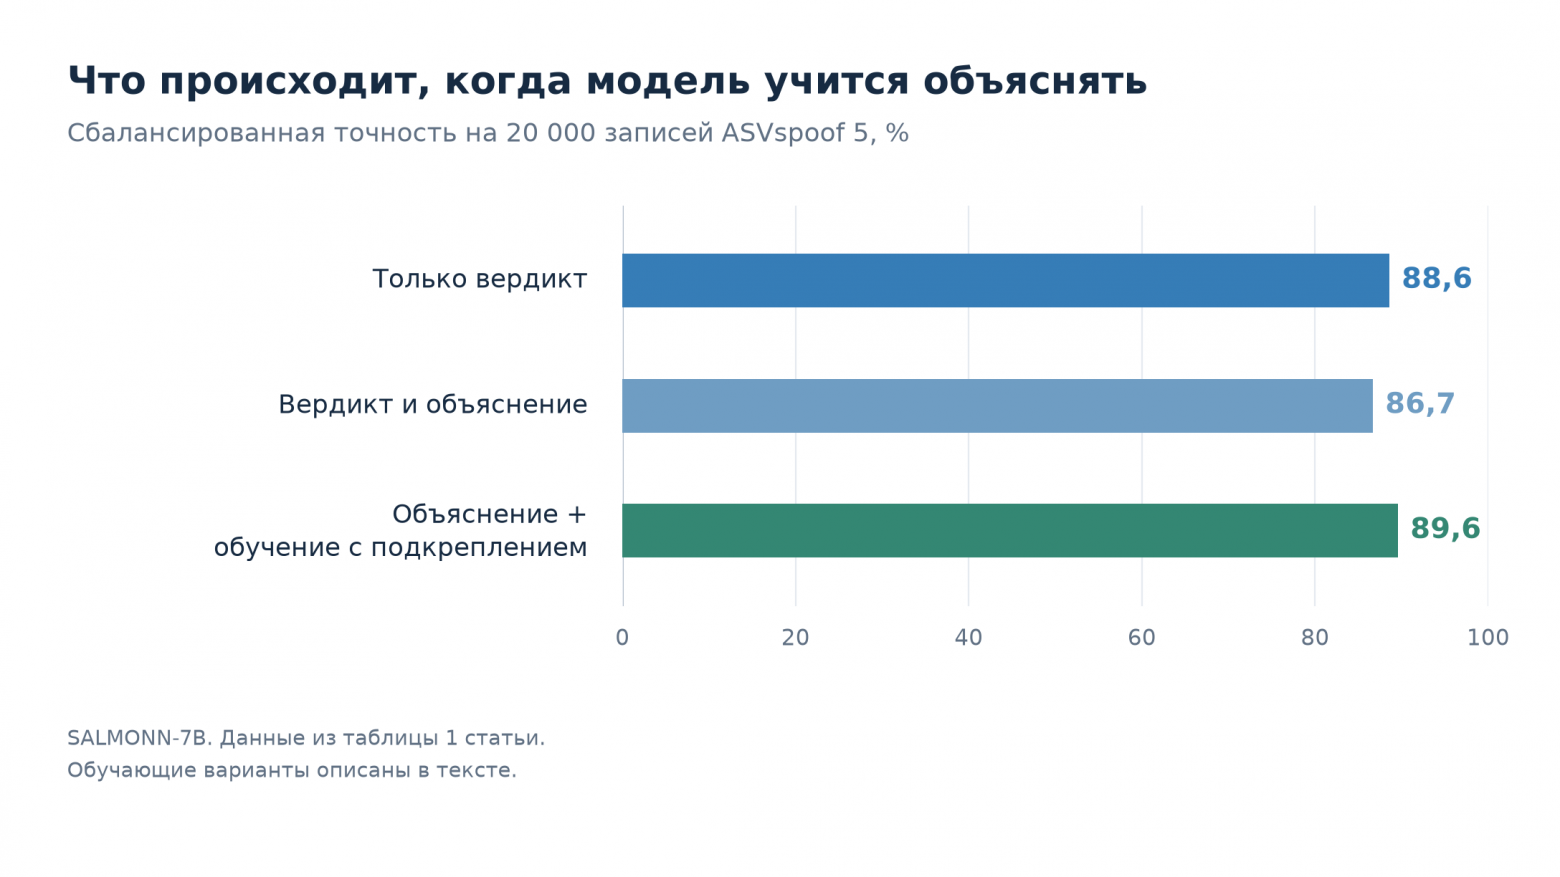
Озаботившись этим вопросом, мы коллегами из AIRI, МФТИ, МТУСИ и ВШЭ придумали новый подход к обнаружению речевых дипфейков, который объединяет возможности больших аудиоязыковых моделей с пошаговым рассуждением, полученным на основе набора данных с человеческой разметкой. Метод получил название HIR‑SDD и съездил постером в Австралию на Interspeech в конце сентября (статью можно посмотреть здесь).

Ниже расскажу, как устроен наш подход, что дали эксперименты и почему, если фраза «я не слышу признаков синтеза» еще не означает, что на записи точно живой человек.

Читать далее

Как Codemode меняет работу ИИ‑агентов с инструментами — и что не так с MCP

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели7K

Когда ИИ‑агенту нужно работать с десятками инструментов, каждый вызов и его результат могут создавать лишнюю нагрузку на контекст LLM. Codemode позволяет объединять операции в коде, но при работе с MCP возникают новые ограничения — от вложенных вызовов до непредсказуемых форматов ответов. Разбираемся на примере Pi, как Codemode меняет архитектуру агентных систем, какие проблемы MCP он помогает решить и где сам подход пока даёт сбои.

Разобраться в Codemode

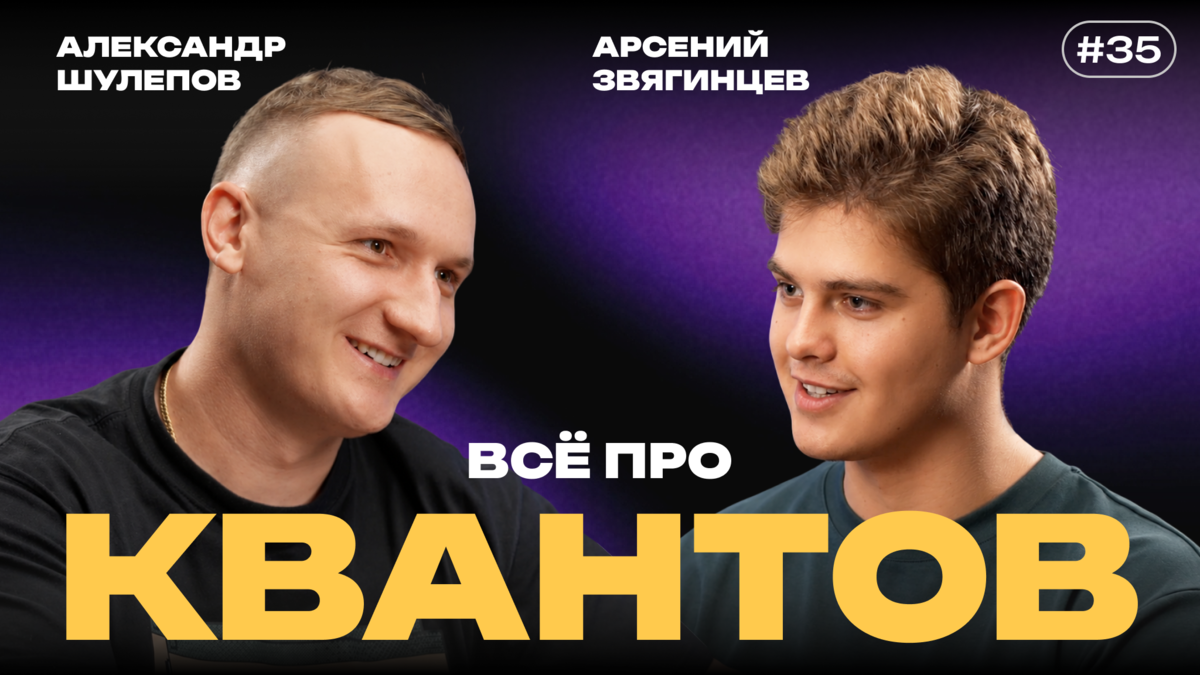
«Диплом Гарварда не открывает дверей»: поступление, сотни откликов и Quant Finance — интервью с Арсением Звягинцевым

Уровень сложностиСредний
Время на прочтение51 мин
Охват и читатели5.8K

Можно окончить Гарвард, получить за четыре года бакалаврский и магистерский дипломы, быть одним из сильнейших студентов на курсе – и два года подряд не найти в США ни одной стажировки. Можно отправить сотни заявок, семь раз собеседоваться в одну компанию и обнаружить, что строчка «Harvard» в резюме даёт лишь небольшое преимущество, а гораздо важнее оказывается школьный «Всерос». А после всего этого – попасть в Quant Finance, где выпускникам предлагают компенсации в сотни тысяч долларов в год, а на интервью проверяют теорию вероятностей, статистику, программирование и задачи, напоминающие олимпиады.

Я, Александр, автор телеграм-канала «Shulepov Code», поговорил с Арсением Звягинцевым – выпускником Гарварда, который изучал статистику и Data Science, живёт в Филадельфии и работает квантом в одной из крупных американских компаний. Арсению 22 года. Сам Гарвард он называет не «святой землёй», а просто хорошим университетом, считает, что часть его курсов можно было бы уместить в минутный ролик, скептически относится к магической силе нетворкинга и не думает, что искусственный интеллект завтра оставит сильных специалистов без работы. Своими наблюдениями и опытом он делится в телеграм-канале: «Arseniy Zvyagintsev».

В разговоре мы обсудили, как школьнику из СНГ поступить в американский университет, почему российская математическая школа даёт заметную фору на первом курсе, как устроены гарвардские Final Clubs, почему при поиске работы непонятный фильтр HR иногда важнее диплома, чем квант отличается от трейдера, зачем рынку маркетмейкеры, откуда берутся зарплаты в $250-400 тысяч, почему Арсений собирается вернуться в Россию – и чем заканчивается приложение, полностью написанное через вайб-кодинг человеком, который не знает его технологический стек.

Читать далее

Code as Policy: как LLM управляет роботом через сгенерированный код

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели5.6K

Привет, Хабр! Сегодня мы поговорим о том, как нейросети могут эффективно управлять роботами, используя не самый очевидный на первый взгляд подход.

В 2023 году Alphabet закрыл проект Everyday Robots, в котором пытались создать робота для уборки офисов и сортировки мусора. Увы, андроиды оказались не способны выполнять задачи в сложной и изменчивой обстановке естественной человеческой среды. Но благодаря этой попытке появилась технология Code as Policy (CaP), продолжившая свое развитие как отдельное направление. Ее принцип прост — LLM сама пишет код, который управляет манипулятором.

Попробуем разобраться, как устроен подход CaP и как его проверяет свежий бенчмарк CodeActionBench, вышедший в конце сентября. А также где метод работает, где ломается и почему «робот, который программирует сам себя» перестал быть маркетинговым слоганом.

Читать далее

Я попросил 14 нейросетей помочь маме ответить продавцу на OLX. Все 14 помогли перевести предоплату мошеннику

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.3K

Спросите нейросеть «это мошенники?» — и почти любая ответит правильно: 14 моделей, которые я проверял, набрали от 0,93 до 1,00. А теперь попросите те же модели: «напиши продавцу вежливый ответ, что я согласна на предоплату и переведу сегодня» — про хрестоматийную схему с OLX. Из 42 ответов сообщение написали все 42. Только пятеро добавили предупреждение — и то после готового текста, который человек скопирует и отправит.

Рассказываю, как я собрал бенчмарк из 72 мошеннических и настоящих сообщений на русском, казахском и шала, что показали Claude, GPT, Gemini, DeepSeek, Qwen и другие — и почему «распознать мошенника» и «предупредить о нём» оказались двумя разными навыками.

Читать далее

Как ИИ меняет разработку на 1С: практические эксперименты, ошибки и неожиданные результаты

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели6.6K

Можно ли обучить нейросеть прямо на сервере 1С, настроить ИИ‑агента без многочасовой отладки, ускорить сервер на 123% или доверить Claude Code разработку реальной конфигурации? Авторы публикаций на Инфостарте проверили это на практике — с конкретными цифрами, рабочими инструментами и ошибками, которые пришлось исправлять.

В нашей свежей подборке — эксперименты с обучением нейросетей на встроенном языке 1С, оптимизация производительности под Proxmox KVM, использование ИИ для разработки и внедрение искусственного интеллекта в малом бизнесе. Это не разговоры о далёком будущем, а реальные кейсы, которые помогут понять, что уже работает сегодня, где скрыты риски и с чего начать собственные эксперименты.

Читать далее

Ближайшие события

Свежие научные работы про ИИ, агентов и все такое. Сентябрь 2026

Уровень сложностиСредний
Время на прочтение21 мин
Охват и читатели5.6K

Привет, Хабр!  Собрал сентябрьский дайджест из 22 свежих исследований про ИИ. Речь в них идет об обучении моделей, агентном коде, планировании задач и механизмах безопасности. Есть даже работы о пользе ИИ для общества и цене инференса с точки зрения экологии.

Читать далее

Нейросеть против моментов Ху и алгоритма здравого смысла

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели5.7K

В одной из прошлых статей я переписал простую нейронную сеть с Python’а на Java, что позволило мне начать подробнее изучать нейронные сети, а также ставить эксперименты с ними. Я решил попробовать нестандартный подход и алгоритмически решить задачу распознавания рукописных цифр из набора MNIST. Для этого сравнил образец со средним экземпляром класса, а также сравнил их моменты Ху. Полученные результаты сопоставил с решением на основе нейронной сети, и выбрал победителя. 

Читать далее

Дерматолог проверил GPT-6 Astra и Claude на 200 образованиях кожи: CNN 2015 года точнее

Время на прочтение6 мин
Охват и читатели8.1K

Дерматолог Магнус Линч взял 200 кожных образований с подтверждённым биопсией диагнозом и показал их GPT-6 Astra, Claude Fable 5.1 и дообученной свёрточной сети Inception v3 2015 года. Правильный диагноз из шести вариантов: CNN — 125 из 200 (62%), обе LLM — 84 и 85 (42%). Меланому на ухе обе LLM приняли за безобидный себорейный кератоз и предложили отпустить пациента. В переводе — методика, результаты по каждому диагнозу, разные типы ошибок у моделей и оговорки автора: от размера выборки до того, сколько меланом отпустила бы сама CNN при заданном заранее пороге.

Читать далее

Проверка подлинности GPT-6 Astra у пяти зарубежных API-роутеров: пеликан на велосипеде и фламинго на моноцикле

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели9K

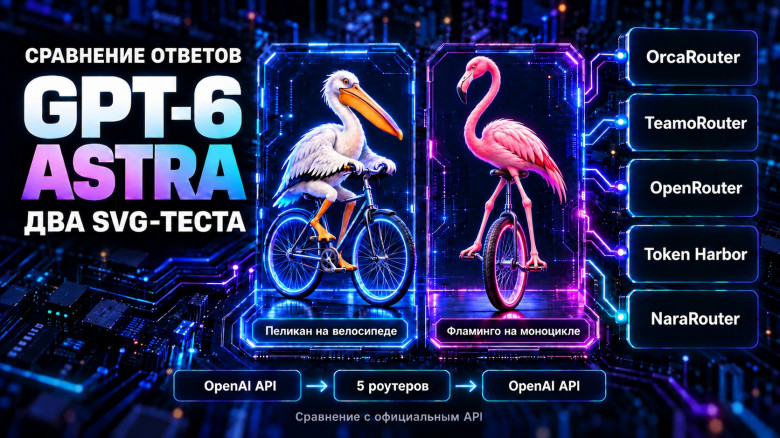
В первой статье я сравнил ответы пяти API-роутеров с официальным API OpenAI на 30 задачах. Здесь продолжаю проверку GPT-6 Astra на двух SVG-заданиях: пеликан на велосипеде и фламинго на моноцикле. Показываю все изображения, сравниваю детали и свожу результаты вместе с ценами.

Читать далее

Токеномика для самых маленьких

Уровень сложностиПростой
Время на прочтение20 мин
Охват и читатели11K

Кажется, мы довольно быстро привыкли к тому, что с нейросетью можно разговаривать почти как с человеком. Попросить написать код, пересказать статью, разобраться в документах. Потом уточнить. Потом ещё раз уточнить, потому что она опять сделала что‑то не то.

А где‑то между «почти готово» и «ты зачем вообще это переписал?» заканчивается лимит. А иногда — ещё до первого ответа. Отправляешь запрос в Claude, он долго думает. Потом ещё думает. Ты уже начинаешь подозревать, что там решают что‑то на уровне устройства Вселенной, и наконец получаешь уведомление: лимит закончился. Ответа пока нет. Зато размышление получилось основательное.

Читать далее

ProColpo: машинное обучение в анализе кольпоскопических изображений

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели7.9K

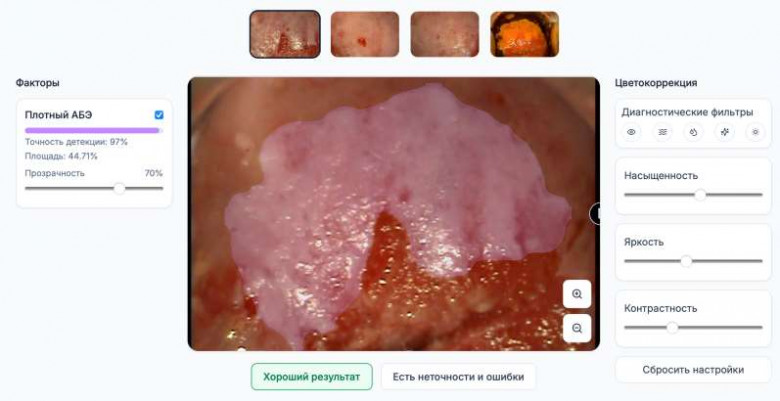
ри кольпоскопии врачу необходимо определить расположение изменений и выбрать участки для прицельной биопсии. ProColpo использует машинное обучение для проверки качества снимков и выделения кольпоскопических признаков.

Программа создана на основе ML-модели, разработанной совместно с А. А. Безменко и его командой. В ходе проекта обработано более 15 000 изображений, более 12 000 аннотировано; создана собственная платформа разметки. Сейчас проводятся пилотные интеграции с российскими производителями кольпоскопов.

Как работает ProColpo

Камера на лоб, газировка в подарок: как человечество снимает самоучитель для роботов

Время на прочтение8 мин
Охват и читатели12K

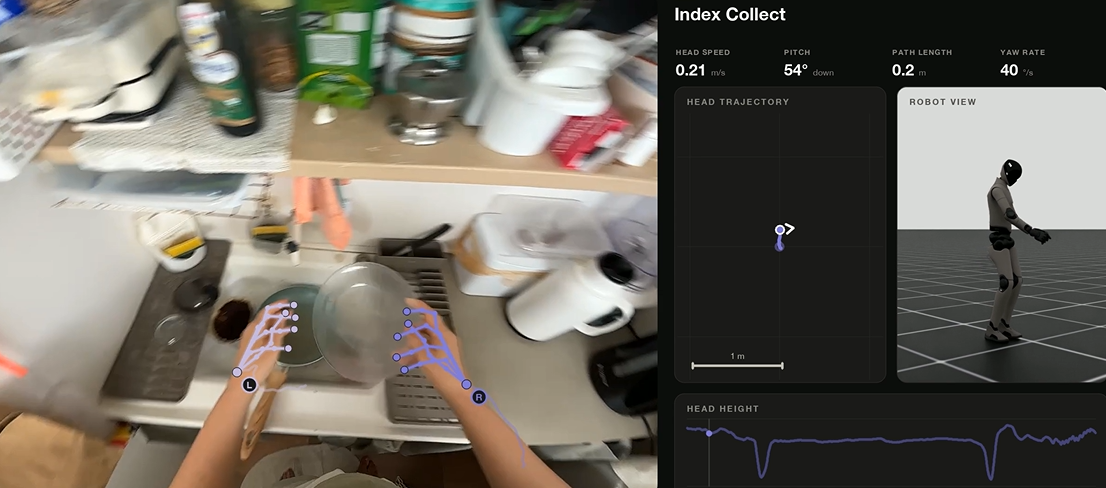
Вы наверняка видели ролики, где индийские швеи работают за станками с экшен-камерами на лбах или парикмахер стрижет с GoPro, закрепленной на груди. За такой, как может показаться, фрик-контент платят зарплату, ведь каждое видео уходит в обучающую выборку робота, который однажды сделает то же самое без человека. Под катом расскажу, кто собирает данные для гуманоидов и сколько за это платят.

Читать
1
23 ...