Обновить
512K+

Python *

Высокоуровневый язык программирования

336,91
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Cимбиоз цифр и искусства (часть 2)
Время на прочтение6 мин
Охват и читатели1.3K

В продолжении поста о создании алгоритма распознавания картин художников, хочу поделиться одной мыслью. Искусственный Интеллект как я его всегда представлял, являлся неким разумом, рациональной машиной по разрешению заданных вопросов и задач, заданных человеком. Будь то скрипт с исходными данными, или же голосовой помощник, он готов дешифровать и анализировать входящую информацию и выдавать ответ, даже если он в принципе неверный. Просто статистически данный ответ являлся наиболее верным за определённый отрезок времени (массив данных). Т.е. в большинстве алгоритмов главенствует системный подход к обработке данных (по аналогии, по логике, по большинству совпадений и т.д.). Как-бы я обрадовался если увидел где-нибудь "нелогичный" нерациональный ИИ-помощник, который выдавал странный, но главное правильный вариант из множества возможных, так сказать, попадал бы в "яблочко". К примеру, хотел бы я посмотреть вечером фильм,но, и чтобы этот фильм мне точно понравился бы. Задаю вопрос онлайн-помощнику, и что он выдаёт? Он выдаёт то, что смотрели и лайкали множество людей до этого, или он выдаёт высокорейтинговое кино определённого жанра, который я задал, но не имеющего ничего общего с тем, что мне действительно по душе. Я, конечно, знаю, какие фильмы мне пришлись "по душе". Лезу в поисковик, и набираю фильм наподобие... или фильмы похожие на... после чего вижу три-четыре портала с бесконечными списками фильмов. Вхожу и обнаруживаю, что эти фильмы, во первых далеки друг от друга по своей сути, и во вторых они может мне и понравились бы мне, но с совсем другой стороны, как будто я увидел их случайно щёлкая пультом ТВ и решил остановиться на них.

Далее: Тест модели распознавания искусства

Нахождение длительности временных интервалов в Python

Время на прочтение6 мин
Охват и читатели89K
Python-программисту, при работе со значениями, представляющими дату и время, часто нужно вычислять длительность временных интервалов. Из этого материала вы узнаете о том, как находить разницу между двумя временными метками, выраженную в часах, минутах и секундах.


А именно, здесь мы коснёмся следующих вопросов:

  • Как пользоваться Python-модулем datetime для работы с датой и временем.
  • Что собой представляют объекты timedelta и что они могут дать программисту.
  • Как вычислять продолжительность временных интервалов, выражая результат в разных единицах измерения.
Читать дальше →

Максимально просто о распознавании речи при помощи NeMo

Время на прочтение10 мин
Охват и читатели25K

На сегодня существует большое количество алгоритмов машинного обучения для обработки различного типа данных, таких как табличные данные, изображения, текст, аудио файлы. Как раз о последнем типе пойдёт речь в данной работе, потому как аудио файлы являются одной из распространенных форм хранения данных в организациях, тщательный анализ которых может являться ключевым фактором к развитию не только коммерческих продуктов, но и опенсорсных решений. В то же время именно методы работы со звуком менее всего популярны, особенно в русскоязычном сегменте, но об этом далее.

Читать далее

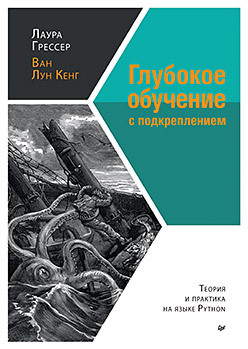
Книга «Глубокое обучение с подкреплением: теория и практика на языке Python»

Время на прочтение9 мин
Охват и читатели7.8K
image Привет, Хаброжители! Глубокое обучение с подкреплением (глубокое RL) сочетает в себе два подхода к машинному обучению. В ходе такого обучения виртуальные агенты учатся решать последовательные задачи о принятии решений. За последнее десятилетие было много неординарных достижений в этой области — от однопользовательских и многопользовательских игр, таких как го и видеоигры Atari и Dota 2, до робототехники. Эта книга — введение в глубокое обучение с подкреплением, уникально комбинирующее теорию и практику. Авторы начинают повествование с базовых сведений, затем подробно объясняют теорию алгоритмов глубокого RL, демонстрируют их реализации на примере программной библиотеки SLM Lab и напоследок описывают практические аспекты использования глубокого RL. Руководство идеально подойдет как для студентов, изучающих компьютерные науки, так и для разработчиков программного обеспечения, которые знакомы с основными принципами машинного обучения и знают Python.
Читать дальше →

5% из 666 репозиториев Python содержат ошибки из-за запятых (в том числе Tensorflow, PyTorch, Sentry и V8)

Время на прочтение3 мин
Охват и читатели6K
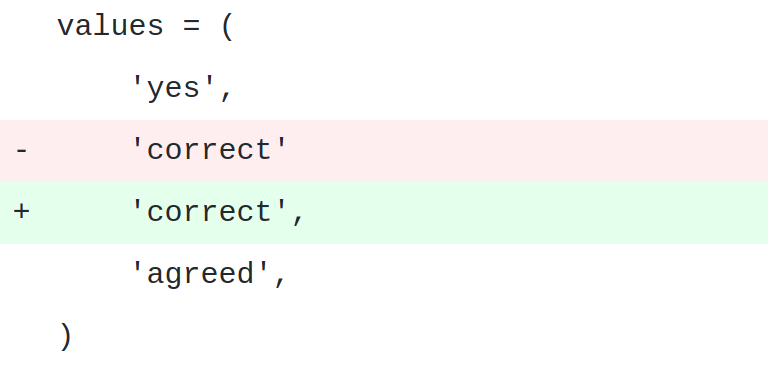
Мы выяснили, что в 5% из 666 исследованных нами репозиториев Python с открытым исходным кодом на GitHub есть три бага, вызванных ошибочным использованием запятых.

Слишком мало запятых


Случайно пропущенная запятая в строке списка/кортежа/множества, приводящая к ненужной конкатенации строк.

Читать дальше →

RuCLIP tiny — быстрее, чем вы думаете

Время на прочтение2 мин
Охват и читатели5.1K

Совсем недавно компания Сбер представила ряд, адаптированных под русский язык, моделей машинного обучения под названием RuCLIP. Суть их работы заключается в возможности сравнения схожести текстового описания и изображения. Рассматривая результаты тестирования, мы заметили, что их модели довольно большие (150+ миллионов параметров) и при этом занимают довольно много места, связи с чем решили сделать свою маленькую, быструю и масштабируемую версию под названием RuCLIP tiny.

Читать далее

Как выглядит рельеф Марса? Выясняем с помощью Python

Время на прочтение9 мин
Охват и читатели8.1K

К старту флагманского курса по Data Science делимся визуализациями марсианского ландшафта на основе изображений, полученных благодаря беспилотным полётам над поверхностью планеты. За подробностями приглашаем под кат.

Читать далее

О хороших практиках построения инфраструктуры ML-моделей

Время на прочтение14 мин
Охват и читатели7K
Не все дата-сайентисты умеют хорошо писать код. Их этому не учили. Также их не учили писать веб-сервисы, и они могут забывать, что код должен быть проверен. Дата-сайентисты — не разработчики, от них ждут высоких метрик и решения поставленных задач, а не умения писать модульные тесты и следить за кодом. По крайней мере, им это не прививают. Не говоря уже о том, что они не работают с Kubernetes и не пишут для него Helm charts.

Но нам с командой дата-сайентистов пришлось это все освоить и запустить. Меня зовут Дмитрий Аникин, в «Лаборатории Касперского» я занимаюсь оптимизацией внутренних бизнес-процессов со стороны Data Science. Хочу рассказать, какие проблемы у нас возникали на пути нашей модели — от простого артефакта до самостоятельного сервиса — и как мы их решили, освоив все несвойственные дата-сайентистам процессы. Как справедливо замечено в нашем самопредставлении, именно в таких моментах — весь драйв!


Всю эту историю расскажу на примере живого проекта MDR (Kaspersky Managed Detection and Response).
Читать дальше →

Proof Of Concept на Python или как портировать С/С++

Время на прочтение6 мин
Охват и читатели8.8K

Язык программирования Python существует уже 31 год. Это полностью объектно-ориентированный язык. За все время существования на нем стало возможно применять разные парадигмы. Сейчас этот язык может поддерживать:

- объектно ориентированную парадигму
- структурное программрование
- обобщенное программирование
- функциональное программирование
- метапрограммирование
- контрактное и логическое программирование

Список уже достаточно внушителен, но язык можно продолжать развивать за счет дополнительных плагинов и библиотек.

Помимо всех этих возможностей из-за простого синтаксиса язык стал самым распространенным для прототипирования различных функций больших и маленьких проектов. Некоторые области Computer Science вообще изначально используют этот язык, потому что он максимально прост и не обязательно долго листать документацию, чтобы понять, как создать простейшее приложение. На Python написано большое количество библиотек, которые могут решать различные задачи: от 3D моделирования до сетевого взаимодействия. Причем использовать язык можно не только на уровне абстракций, которые применяют языки высокого уровня, но также можно выполнять и более низкоуровневые задачи.

Статья будет содержать 3 части, в ходе которых мы будем иссследовать возможность портирования C/C++ кода для различных ОС. В этой статье посмотрим, насколько эффективно можно реализовать возможность работы с оперативной памятью и получением данных от системы.

Читать далее

Логирование в объектах Python. Путь перфекциониста

Время на прочтение3 мин
Охват и читатели16K

Логировать лучше, чем не логировать. Чем больше разбираешься в чужом и своём коде, тем больше убеждаешься в справедливости этих слов. В Python есть прекрасный модуль logging: настолько удобный и гибкий, насколько вряд ли когда-нибудь понадобится. Мы не будем обсуждать, как его настроить, благо инструкций для этого хватает. Считаем, что всё уже настроено и надо просто добавить логгер в наши классы, чтобы использовать его внутри объектов.

Читать далее

5 советов по использованию декораторов в Python

Время на прочтение5 мин
Охват и читатели15K

Advanced советы по использованию декораторов в python. Будет полезно, как для новчиков, так и для самых продвинутых пользователей.

Читать далее

Python и Samila. Делаем красиво

Время на прочтение3 мин
Охват и читатели11K

Как при помощи языка программирования Пайтон и библиотеки Samila создавать красивые изображения, даже с минимальными усилиями.

Читать далее

Градиентный бустинг с CATBOOST (часть 3/3)

Время на прочтение8 мин
Охват и читатели34K

В предыдущих частях мы рассматривали задачу бинарной классификации. Если классов более чем два, то используется MultiClassification, параметру loss_function будет присвоено значение MultiClass. Мы можем запустить обучение на нашем наборе данных, но мы получим те же самые результаты, а обучение будет идти несколько дольше:

Читать далее

Ближайшие события

Прогнозируем реальные вероятности

Время на прочтение4 мин
Охват и читатели13K

Может ли ваша модель прогнозировать реальные вероятности? На самом деле абсолютно точно это не может делать ни одна. Мы можем максимально приблизиться к реальным показателям, но для этого модель должна быть откалибрована. То есть скорректирована так, чтобы полученные показатели распределения вероятностей были как можно ближе к реальным.

Читать далее

Хватит терять клиентов! Или как разработчику тестировать сайт, на примере PVS-Studio. Часть 1

Время на прочтение15 мин
Охват и читатели9.1K

Сайт с багами – горе для бизнеса. Всего одна 404-я или 500-я ошибка может лишить вашу компанию солидной суммы денег и хорошей репутации. Но есть способ избежать этого: тестировать сайт. О том, как это сделать, расскажет данная статья. Прочитав её, вы узнаете, как тестировать код на Django, создать своего пользователя-тестировщика и много чего еще. Добро пожаловать под кат.

Читать далее

Ещё один пример генеративных изображений

Время на прочтение7 мин
Охват и читатели3.8K

Все любят генеративное искусство и всё что с ним связано (вот оно слева направо, в конце есть прикольные ссылочки).

Мне тоже было интересно копнуть в эту сторону, и недавно мне попал в руки сайт, который генерирует изображения по фразе. Также на сайте было сказано, что исходники закрыты, но есть пример подобной генерации на Python. Так как я питонист и интересна тема, то решил разобраться в работе алгоритма.

Читать далее

Программа для автоматического изменения размера изображения с сохранением пропорции сторон на Python

Время на прочтение8 мин
Охват и читатели11K

Иногда необходимо изменить размер изображения с сохранением пропорции сторон. Особенно, когда это очень большое количество файлов. Это приложение позволяет изменить размер изображения, сохранить его в нужную папку, а также инвертировать цвет (подходит для редактирования осциллограмм) и переименовать файл. Возможно, для существуют уже какие-то программы, но была необходимость сделать это самому. Поделюсь кодом с вами, возможно кому-то потребуется (Код программы в конце статьи).

Читать далее

Делаем многоуровневого бота для ВК с Long Poll VK API, Python, MySQL и решаем вопрос многопоточности c помощью threading

Время на прочтение9 мин
Охват и читатели17K

Создание ботов - довольно заезжанная тема, но все уроки, статьи и различного рода документация дают информацию только о том, как построить одноуровневого бота без возможности создания древа из различных всплывающих меню (клавиатур).
А это нужно для создания:

— Сложных ботов с несколькими уровнями "глубины" (различные меню/клавиатуры)
— Ботов, созданных одновременно для групповых чатов и для лички сообщества
— Ботов, с повторяющимися ключевыми командами в различных меню, которые необходимо разделять

В этой статье будет рассказано как реализовать многоуровневого бота с использованием Python 3, MySQL, VK Bots Long Poll API и библиотеки threading, чтобы каждый пользователь бота сохранял своё положение в меню и мог, вернувшись обратно, стартовать с той же позиции в любое время.

Читать далее

Парсинг Pubmed на противораковые натуральные вещества

Время на прочтение5 мин
Охват и читатели2.6K

В этой статье будет расчет натуральных веществ распарсенных с базы биомедицинских публикаций Pubmed.

Для этого будет подключены библиотеки BioPython.

Читать далее

Как с помощью трансферного обучения обнаружить вулканы на Гавайях

Время на прочтение7 мин
Охват и читатели2K

Data Science — это не только данные о клиентах. К старту нашего флагманского курса рассмотрим пример геопространственной семантической сегментации, где с помощью данных цифровой модели рельефа отобразим шлаковые конусы на Гавайях.

Читать далее