


Развертывание интерактивных визуализаций данных в реальном времени на Flask и Bokeh
Сегодня, в преддверии старта нового потока курса «Python для веб-разработки», делимся с вами полезным переводом статьи о небольшой интерактивной визуализации, для исследований данных о фильмах. Автор использует не только Flask и Bokeh, но и задействуя бесплатную облачную платформу баз данных easybase.io. Все подробности и демонстрации вы найдёте под катом.

25 лучших репозиториев GitHub для разработчиков Python

Определение токсичных комментариев на русском языке
Сегодня социальные сети превратились в одну из главных коммуникационных платформ как в онлайне, так и реальной жизни. Свобода выражения разных точек зрения, в том числе токсичных, агрессивных и оскорбительных комментариев может иметь долговременные негативные последствия для мнений людей и социальной сплочённости. Поэтому одной из важнейших задач современного общества является разработка средств автоматического определения токсичной информации в интернете для уменьшения негативных последствий.
В этой статье описывается решение этой задачи для русского языка. В качестве источника данных мы использовали анонимно опубликованный на Kaggle набор данных, дополнительно проверив качество аннотации. Для создания классифицирующей модели мы сделали тонкую настройку двух версий Multilingual Universal Sentence Encoder, Bidirectional Encoder Representations from Transformers и ruBERT. Настроенная модель ruBERT показала F1 = 92,20 %, это был лучший результат классификации. Мы выложили в открытый доступ обученные модели и примеры кода.

Прототип на «коленке»: cоздание приложения для мониторинга датчиков сердечного ритма в спортивном зале
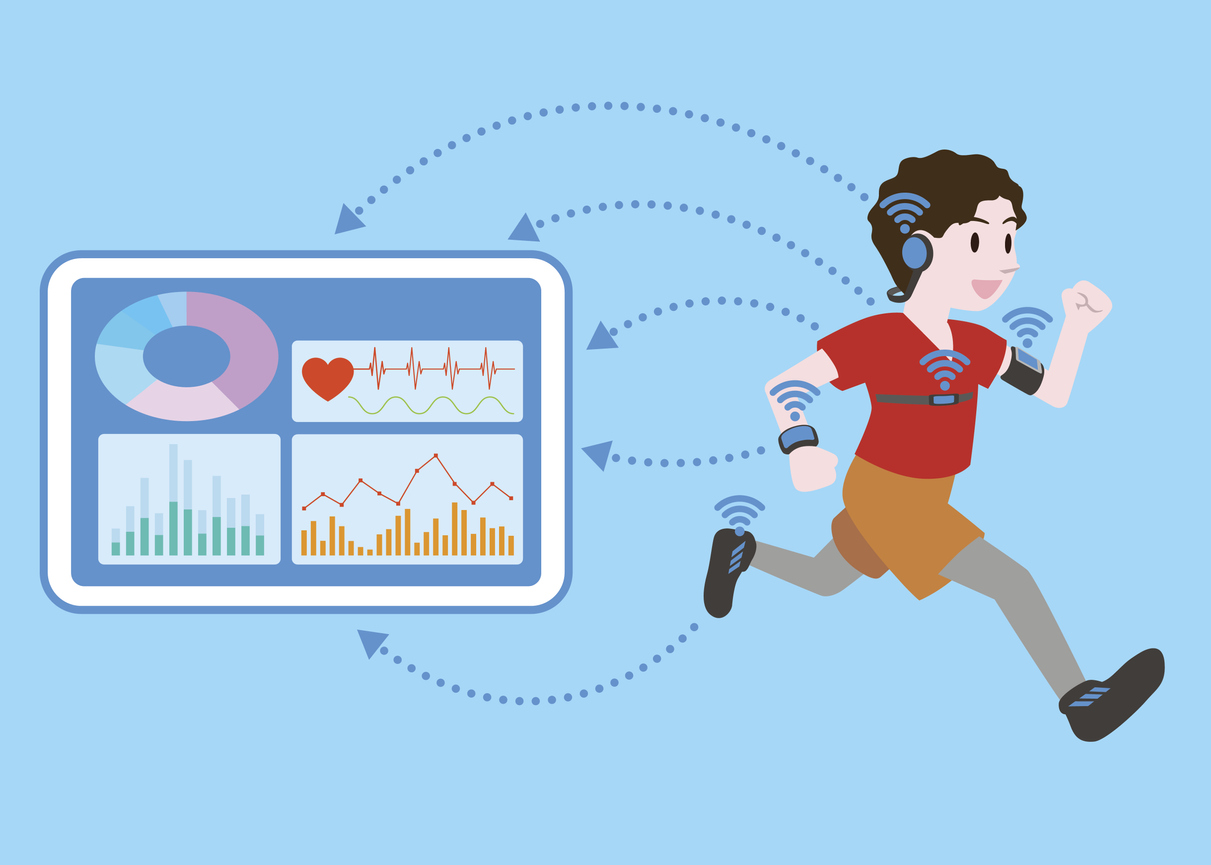
Однажды за утренним кофе обсуждали с приятелем современные технологии Интернета вещей и разговорились на предмет реализации системы мониторинга фитнес-оборудования в спортивном клубе. Приятель искал способ реализации своей идеи с нулевой стартовой стоимостью, а мне интересно было сделать что-то полезное и устроить себе очередную проверку знаний и творческих способностей.
В результате решили для начала создать, как говорится, «на коленке», прототип устройства, собирающего данные с пульсометров – датчиков сердечного ритма. По результатам работы я решил написать статью для обмена опытом с сообществом читателей, а еще для повышения собственного уровня в практике написания статей. В этой статье мы проследуем поэтапно от идеи до прототипа программы.

Подборка статей о машинном обучении: кейсы, гайды и исследования за октябрь 2020
В октябре традиционно в центре внимания вновь GPT-3. С моделью от OpenAI связано сразу несколько новостей — хорошая и не очень.
Как искусственный интеллект борется с вредителями


Вскрытие покажет: Решаем лёгкий crackme и пишем генератор ключа
На просторах сети найден был наш подопытный. Это сrackme. Естественно, что необходимо изучить его. Для вскрытия нам понадобиться:
- Немного языка Assembler
- Логика вместе с отладчиком (IDA PRO)
Лекарство изготовим

Побег из песочницы с Python
Вчера прошел отборочный тур Nuit du Hack CTF 2013. Как обычно, в нескольких заметках я расскажу об интересных заданиях и/или решениях этого CTF. Если хотите узнать больше, мой товарищ по команде w4kfu также должен в скором времени опубликовать заметки в своем блоге.

Шаблонные функции в Python, которые могут выполняться синхронно и асинхронно

Сейчас практически каждый разработчик знаком с понятием «асинхронность» в программировании. В эру, когда информационные продукты настолько востребованы, что вынуждены обрабатывать одновременно огромное количество запросов и также параллельно взаимодействовать с большим набором других сервисов — без асинхронного программирования — никуда. Потребность оказалась такой большой, что был даже создан отдельный язык, главной фишкой которого (помимо минималистичности) является очень оптимизированная и удобная работа с параллельным/конкурентным кодом, а именно Golang. Несмотря на то, что статья совершенно не про него, я буду часто делать сравнения и ссылаться. Но вот в Python, про который и пойдёт речь в этой статье — есть некоторые проблемы, которые я опишу и предложу решение одной из них. Если заинтересовала эта тема — прошу под кат.

Файловый менеджер на питоне в 430 строк для начинающих и чайников
Я захотел обобщить свои знания питона и решил написать файловый менеджер для пк.

Импорт библиотек:
import tkinter
import os
import subprocess
from tkinter import messagebox
from tkinter import simpledialog

aio api crawler
Стресс-тестер для соревнований по программированию
Во-первых, не бойтесь названия «стресс-тестер». Это просто модный термин для написанного мной служебного инструмента для соревнований по программированию. Вместо того чтобы просто дать вам код, я расскажу о стратегии и плане, которые у меня были, когда я писал этот инструмент.
Ближайшие события

Настройка синхронизации google calendar с web приложением
Пример кода приведен на языке программирования Python.

Ловля цен. Практическое руководство в море закупок

Начнем с самого простого способа – попробуем ловить рыбу руками. Открываем базу товаров с закупок и начинаем искать похожий товар. Высока вероятность, что к вечеру мы так ничего и не поймаем.
Попробуем как-то отфильтровать базу товаров с закупок. Каждому товару в закупках присваивается код ОКПД2. Общероссийский классификатор продукции по видам экономической деятельности это код, который содержит информацию о товаре.
Например:

Теперь у нас есть удочка, стало немного лучше, но почему-то рыба не желает вешаться на крючок.

Нарисовать холдинг, посчитать доли КИК — networkx,netwulf,webweb

Необходимый инструмент для каждого дата-сайентиста

Давайте посмотрим правде в глаза: обучение модели машинного обучения отнимает много времени, даже с учетом развития вычислительной техники за последние несколько лет. Даже самые тривиальные модели имеют более миллиона параметров. В масштабе крупнее у моделей бывает более миллиарда параметров — у GPT-3 их более 175 миллиардов! и обучение этих моделей занимает дни, а то и недели. Как дата-сайентисты мы хотели бы следить за метриками модели, чтобы знать, работает ли она, как мы того ожидаем. Но нет смысла сидеть рядом с компьютером, часами отслеживая показатели. Хорошо было бы получить все эти данные на телефон.
Эту задачу можно решить с помощью TensorDash — инструмента удаленного мониторинга ваших моделей машинного обучения с открытым исходным кодом, о котором и пойдет речь дальше. Под катом примеры применения TensorDash с TensorFlow, Keras, PyTorch и Fast.ai.

Пишем бот для пазл игры на Python
Реализуем и сравниваем оптимизаторы моделей в глубоком обучении
Реализуем и сравниваем 4 популярных оптимизатора обучения нейронных сетей: оптимизатор импульса, среднеквадратичное распространение, мини-пакетный градиентный спуск и адаптивную оценку момента. Репозиторий, много кода на Python и его вывод, визуализации и формулы — всё это под катом.
AutoVIML: Автоматизированное машинное обучение

Перевод статьи подготовлен специально для студентов курса «Промышленный ML на больших данных»
Машинное обучение обладает преимуществом обучения алгоритмов, которые автоматически улучшаются, используя полученный опыт. Существует N различных алгоритмов и методов машинного обучения, и вам, как правило, нужно попробовать множество из них, чтобы найти лучшую модель прогнозирования для вашего датасета - ту, которая будет иметь наивысшую точность.
Большинство методов машинного обучения, таких как регрессионные методы, классификация и другие модели, есть в Sklearn, но, чтобы выбрать, какой метод лучше всего подходит в нашем конкретном случае, нужно опробовать все эти модели вместе с настройкой гиперпараметров и найти наиболее эффективную модель. Вся эта работа отнимает много сил и времени, объем которых можно уменьшить с помощью пакета AutoVIML в Python.