Обновить
512K+

Python *

Высокоуровневый язык программирования

535,89
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Четыре способа получить аудио вк или «это не баг, а фича»

Время на прочтение132 мин
Охват и читатели80K

Всем привет! Сегодня я расскажу вам о моем опыте с ВК, найденных багах, об отношении к пользователям и, собственно, как получить аудиозаписи вк, пользуясь "не багами а фичами", как меня заверяли сотрудники данной корпорации. Итак, приступим!

Читать далее

OpenCV в Python. Часть 1

Время на прочтение4 мин
Охват и читатели344K

Привет, Хабр! Запускаю цикл статей по библиотеке OpenCV в Python. Кому интересно, добро пожаловать под кат!


my_logo

Читать дальше

Как читать файлы конфигурации в тестах с Selenium на Python

Время на прочтение10 мин
Охват и читатели8.2K
Привет, хабр. В преддверии старта курса «Python QA Engineer» подготовили для вас еще один интересный перевод.


Руководство, описанное в этой статье, поможет вам в тестировании веб-интерфейсов. Мы создадим простое надежное решение для тестирования веб-интерфейса с помощью Python, pytest и Selenium WebDriver. Мы рассмотрим стратегии построения хороших тестов и паттерны написания правильных автоматизированных тестов. Конечно же, разработанный проект по тестированию сможет послужить хорошей основой для создания собственных тест-кейсов.
Читать дальше →

HDTree: настраиваемое дерево решений на Python

Время на прочтение17 мин
Охват и читатели13K

Представляем настраиваемую и интерактивную структуру дерева решений, написанную на Python. Эта реализация подходит для извлечение знаний из данных, проверки интуитивного представления, улучшения понимание внутренней работы деревьев решений, а также изучение альтернативных причинно-следственных связей в отношении вашей проблемы обучения. Она может использоваться в качестве части более сложных алгоритмов, визуализации и отчётов, для любых исследовательских целей, а также как доступная платформа, чтобы легко проверить ваши идеи алгоритмов дерева решений.
Добро пожаловать под кат!

Pikabu-dataset

Время на прочтение6 мин
Охват и читатели7.9K
Предлагается взглянуть на dataset постов с pikabu.ru c точки зрения датастатистики. Сам датасет в составе 450к штук собран лучшими круглосуточными парсерами, обработан отдушками, убирающими дубликаты статей, а также нашпигован дополнительными столбцами, смысл наличия которых доступен только посвященным. Здесь не столько интересен сам датасет, сколько подход к анализу подобных сайтов. В последующих постах попробуем применить элементы из maсhine learning для анализа.


Читать дальше →

Система отложенного исполнения на RabbitMQ

Время на прочтение5 мин
Охват и читатели13K

Всем привет!

Меня зовут Никита, и я курирую разработку нескольких проектов в ДомКлик. Сегодня я хочу продолжить тему «веселых картинок» в мире RabbitMQ. В своей статье Алексей Казаков рассматривал такой мощный инструмент, как отложенные очереди, и разные реализации стратегии Retry. А сегодня мы поговорим, как использовать RabbitMQ для планирования периодических задач.
Читать дальше →

Преступления на почве расизма в США: статистический анализ

Время на прочтение16 мин
Охват и читатели13K
После моей недавней статьи (части 1, 2, 3) о криминале и полицейской стрельбе в США и их связи с расовой принадлежностью я решил продолжить эту тему и в таком же ключе проанализировать другие открытые данные — благо, таких еще достаточно благодаря программе криминальной отчетности ФБР.

Сегодня будем исследовать данные по преступлениям, совершенным на почве нетерпимости. Сначала посмотрим на всю статистику целиком, а затем подробно рассмотрим именно расовую нетерпимость и конкретно преступления, совершаемые белыми и черными на почве вражды к белым и черным.
Читать дальше →

Как за два месяца пройти путь от начинающего питониста до сертифицированного TensorFlow-разработчика

Время на прочтение11 мин
Охват и читатели30K
Я всё ещё помню тот день, когда сдал выпускную работу в университет. Я тогда вздохнул с облегчением, так как это означало окончание бакалавриата. Но мной скоро овладела скука. Делать было нечего, мир был охвачен пандемией. Мне очень хотелось найти новое занятие, которое избавило бы меня от безделья.


В этом материале я хочу рассказать о том, как скука от самоизоляции помогла мне стать сертифицированным TensorFlow-разработчиком менее чем за два месяца. И это — несмотря на то, что на Python я раньше не программировал. Здесь я, кроме того, дам список ссылок на материалы, которые я использовал, осваивая новую для себя сферу знаний и готовясь к сертификации.
Читать дальше →

Как писать музыку на Python — помогут три тематические библиотеки (для специалистов разного уровня)

Время на прочтение3 мин
Охват и читатели22K
Продолжаем тему музыкального программирования — ранее мы говорили о языках Csound, SuperCollider и Pure Data, а сегодня рассказываем Python и библиотеках FoxDot, Pippi и Music-Code.

Напишем и поймем Decision Tree на Python с нуля! Часть 2. Основы Python, необходимые для генерации Decision Tree

Время на прочтение8 мин
Охват и читатели4.5K
Привет, Хабр! Представляю вашему вниманию перевод статьи "Pythonで0からディシジョンツリーを作って理解する (2. Pythonプログラム基礎編)".

Данная статья — вторая в серии. Первую вы можете найти здесь.

2.1 Комментарии обозначаются # или ''' (три одинарные кавычки)


# Комментарий
a = 1 # Комментарий 

''' Это тоже комментарий
b = c
c = d
'''

2.2 Использование динамической типизации (тип определяется автоматически)


# динамическая типизация переменных
# = копирование значения справа налево
i = 1 #  целое число (int)
f = 2.1 # число с плавающей запятой (float)
s = "a" # строковый тип (string)
b = True # логический тип (boolean)
l = [0,1,2] # массив,список (array) 
t = (0,1,2) # кортеж (tuple)
d = {"a":0, "b":1} # словарь, ассоциативный массив

print(i,f,s,b,l,t,d)
# 1 2.1 a True [0, 1, 2] (0, 1, 2) {'a': 0, 'b': 1}

# Когда хотим определить тип, используем type
print(type(i)) # Вывод <class 'int'>

# Переменная не сохраняет, а содержит фактическое значение
# Это, своего рода, переменная-ссылка, указывающая на местоположение значения
# Можно получить идентификатор актуального значения через id
print(id(l)) # 00000000000000 (меняется от исполнения к исполнениюц)
l2 = l # Приведу в пример копию массива, где ссылаюсь на 2 его элемента, а фактический массив - 1. 
print(id(l2)) # 00000000000000 (то же значение, что у вышеуказанного id(l))
# Поскольку существует только один фактический массив, кажется, что он был добавлен в массив l, даже если вы добавили элемент со ссылкой на l2.
l2.append(1)
Читать дальше →

Анализируем причинно-следственные связи метрик ВКонтакте

Время на прочтение8 мин
Охват и читатели6.7K
Всем привет, меня зовут Анвер, я работаю в команде Core ML ВКонтакте. Одна из наших задач — создавать и улучшать алгоритмы ранжирования для ленты новостей. В этой статье расскажу о том, как можно применять для этого причинно-следственный анализ — чтобы в результате сделать сервис интереснее для пользователей. Поговорим про преимущества такого подхода по сравнению с корреляционным анализом, и я предложу модификации существующих алгоритмов.


Читать дальше →

Распознавание текста на картинке с помощью tesseract на Kotlin

Время на прочтение7 мин
Охват и читатели18K

Ни для кого не секрет, что Python прочно занял первенство в ML и Data Science. А что если посмотреть на другие языки и платформы? Насколько в них удобно делать аналогичные решения?


К примеру, распознавание текста на картинке.

Читать дальше →

Разработка python module, чтобы продакшн радовал

Время на прочтение9 мин
Охват и читатели9K
Всем привет! Я представляю команду разработчиков некоммерческой организации CyberDuckNinja. Мы создаём и поддерживаем целое семейство продуктов, которые позволяют облегчить разработку backend-приложений и сервисов машинного обучения.

Сегодня хотелось бы затронуть тему интеграции Python в C++.


Все началось со звонка друга в два часа ночи, который пожаловался: «У нас под нагрузкой ложится продакшн ...» В разговоре выяснилось, что код продакшена написан с использованием ipyparallel (пакет Python, который позволяет производить параллельные и распределённые вычисления) для обсчета модели и получения результатов в режиме онлайн. Мы решили разобраться в архитектуре ipyparallel и провести профайлинг под нагрузкой.
Читать дальше →

Ближайшие события

Black [O]lives Matter: раса, криминал и огонь на поражение в США. Часть 3

Время на прочтение25 мин
Охват и читатели18K

Продолжаем наше исследование, посвященное ситуации в США со стрельбой полицейских и уровнем преступности среди представителей белой и черной (афроамериканской) рас. Напомню, что в первой части я рассказал о предпосылках исследования, его целях и принятых оговорках / допущениях; а во второй части была демонстрация анализа взаимосвязи между расовой принадлежностью, преступностью и гибелью от рук служб правопорядка. В этот раз посмотрим на географическое распределение анализируемых данных по штатам США.

Читать далее

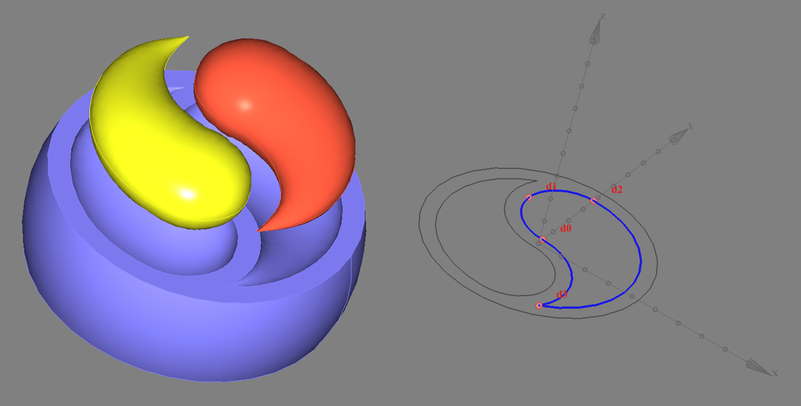
OpenCASCADE и Невидимое солнце Дао

Время на прочтение17 мин
Охват и читатели14K

Тот лучший путник, что следов не оставляет
Тот лучший лидер, что без речи вдохновляет
План совершенен, если плана вовсе нет
И если мудрый двери закрывает,
Вам никогда не разгадать секрет

Великая книга Дао - Стих 27 ( Перевод Ю. Полежаевой)

Привет, Хабр! Хочу сегодня пригласить в увлекательное 3D-путешествие. Мне нравится 3D. Я пробовал работать в разных программах, но меня не покидало чувство, что мне чего-то не хватает. Даже если пользоваться встроенным скриптингом.

Поэтому я постепенно пришел к идее, что для реализации моих безумных творческих идей, наверное лучше подойдут CAD-системы. Вот там есть где разгуляться 3D-фантазии. Мощные алгоритмы создания поверхностей пересечений, проекций, аппроксимаций. Это как раз то, что нужно. Вообще, мне кажется, что разработчики промышленных геометрических CAD-ядер относятся к остальному 3D миру по принципу "Солдат ребенка не обидит".

Конечно, в своих поисках я не мог пройти мимо открытого CAD-ядра OpenCascade. Эта библиотека предоставляет уникальную возможность ближе познакомится с принципами внутреннего устройства современных CAD-систем. Вдвойне приятно, что это можно сделать на дружелюбном языке Python.

От одной мысли о всех этих чудесах, мое сердце начинает биться сильнее. Как поется в одной песне - я приятную дрожь ощущаю с головы до ног. Тех у кого в этот вечер похожее настроение - прошу под кат. Будем рисовать Инь и Янь в объеме.

Читать далее

Подборка статей о машинном обучении: кейсы, гайды и исследования за август 2020

Время на прочтение4 мин
Охват и читатели5.2K


Продолжаем собирать для вас материалы из области ML. Как и всегда предпочтение отдаем проектам, которые содержат ссылки на непустые репозитории, или предоставляют высокоуровневые API.
Читать дальше →

Мониторинг микросервисов Flask с помощью Prometheus

Время на прочтение4 мин
Охват и читатели23K

RED метрики для flask приложения без усилий.
Как добавить метрики который давно просят DevOps/SRE за пару строчек кода.

Читать далее и далее

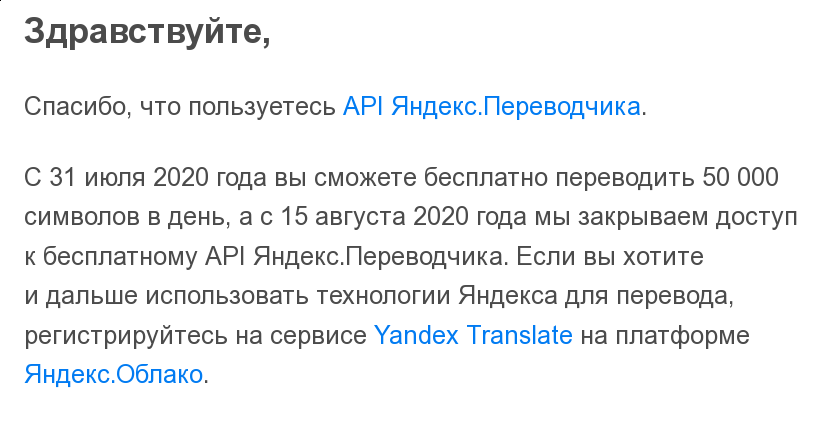
Автоматический переводчик на Python+GTK3. Альтернатива Яндексу

Время на прочтение1 мин
Охват и читатели30K
Ну вот и пришел долгожданный конец халяве(статья).


Честно говоря, было немного обидно. Вот чего им не хватает!

Я, разумеется, начал искать выход для себя и друзей. И нашел.
Читать дальше →

Определение положения и скорости тележки мостового крана с помощью цифровой камеры и OpenCV

Время на прочтение2 мин
Охват и читатели7K


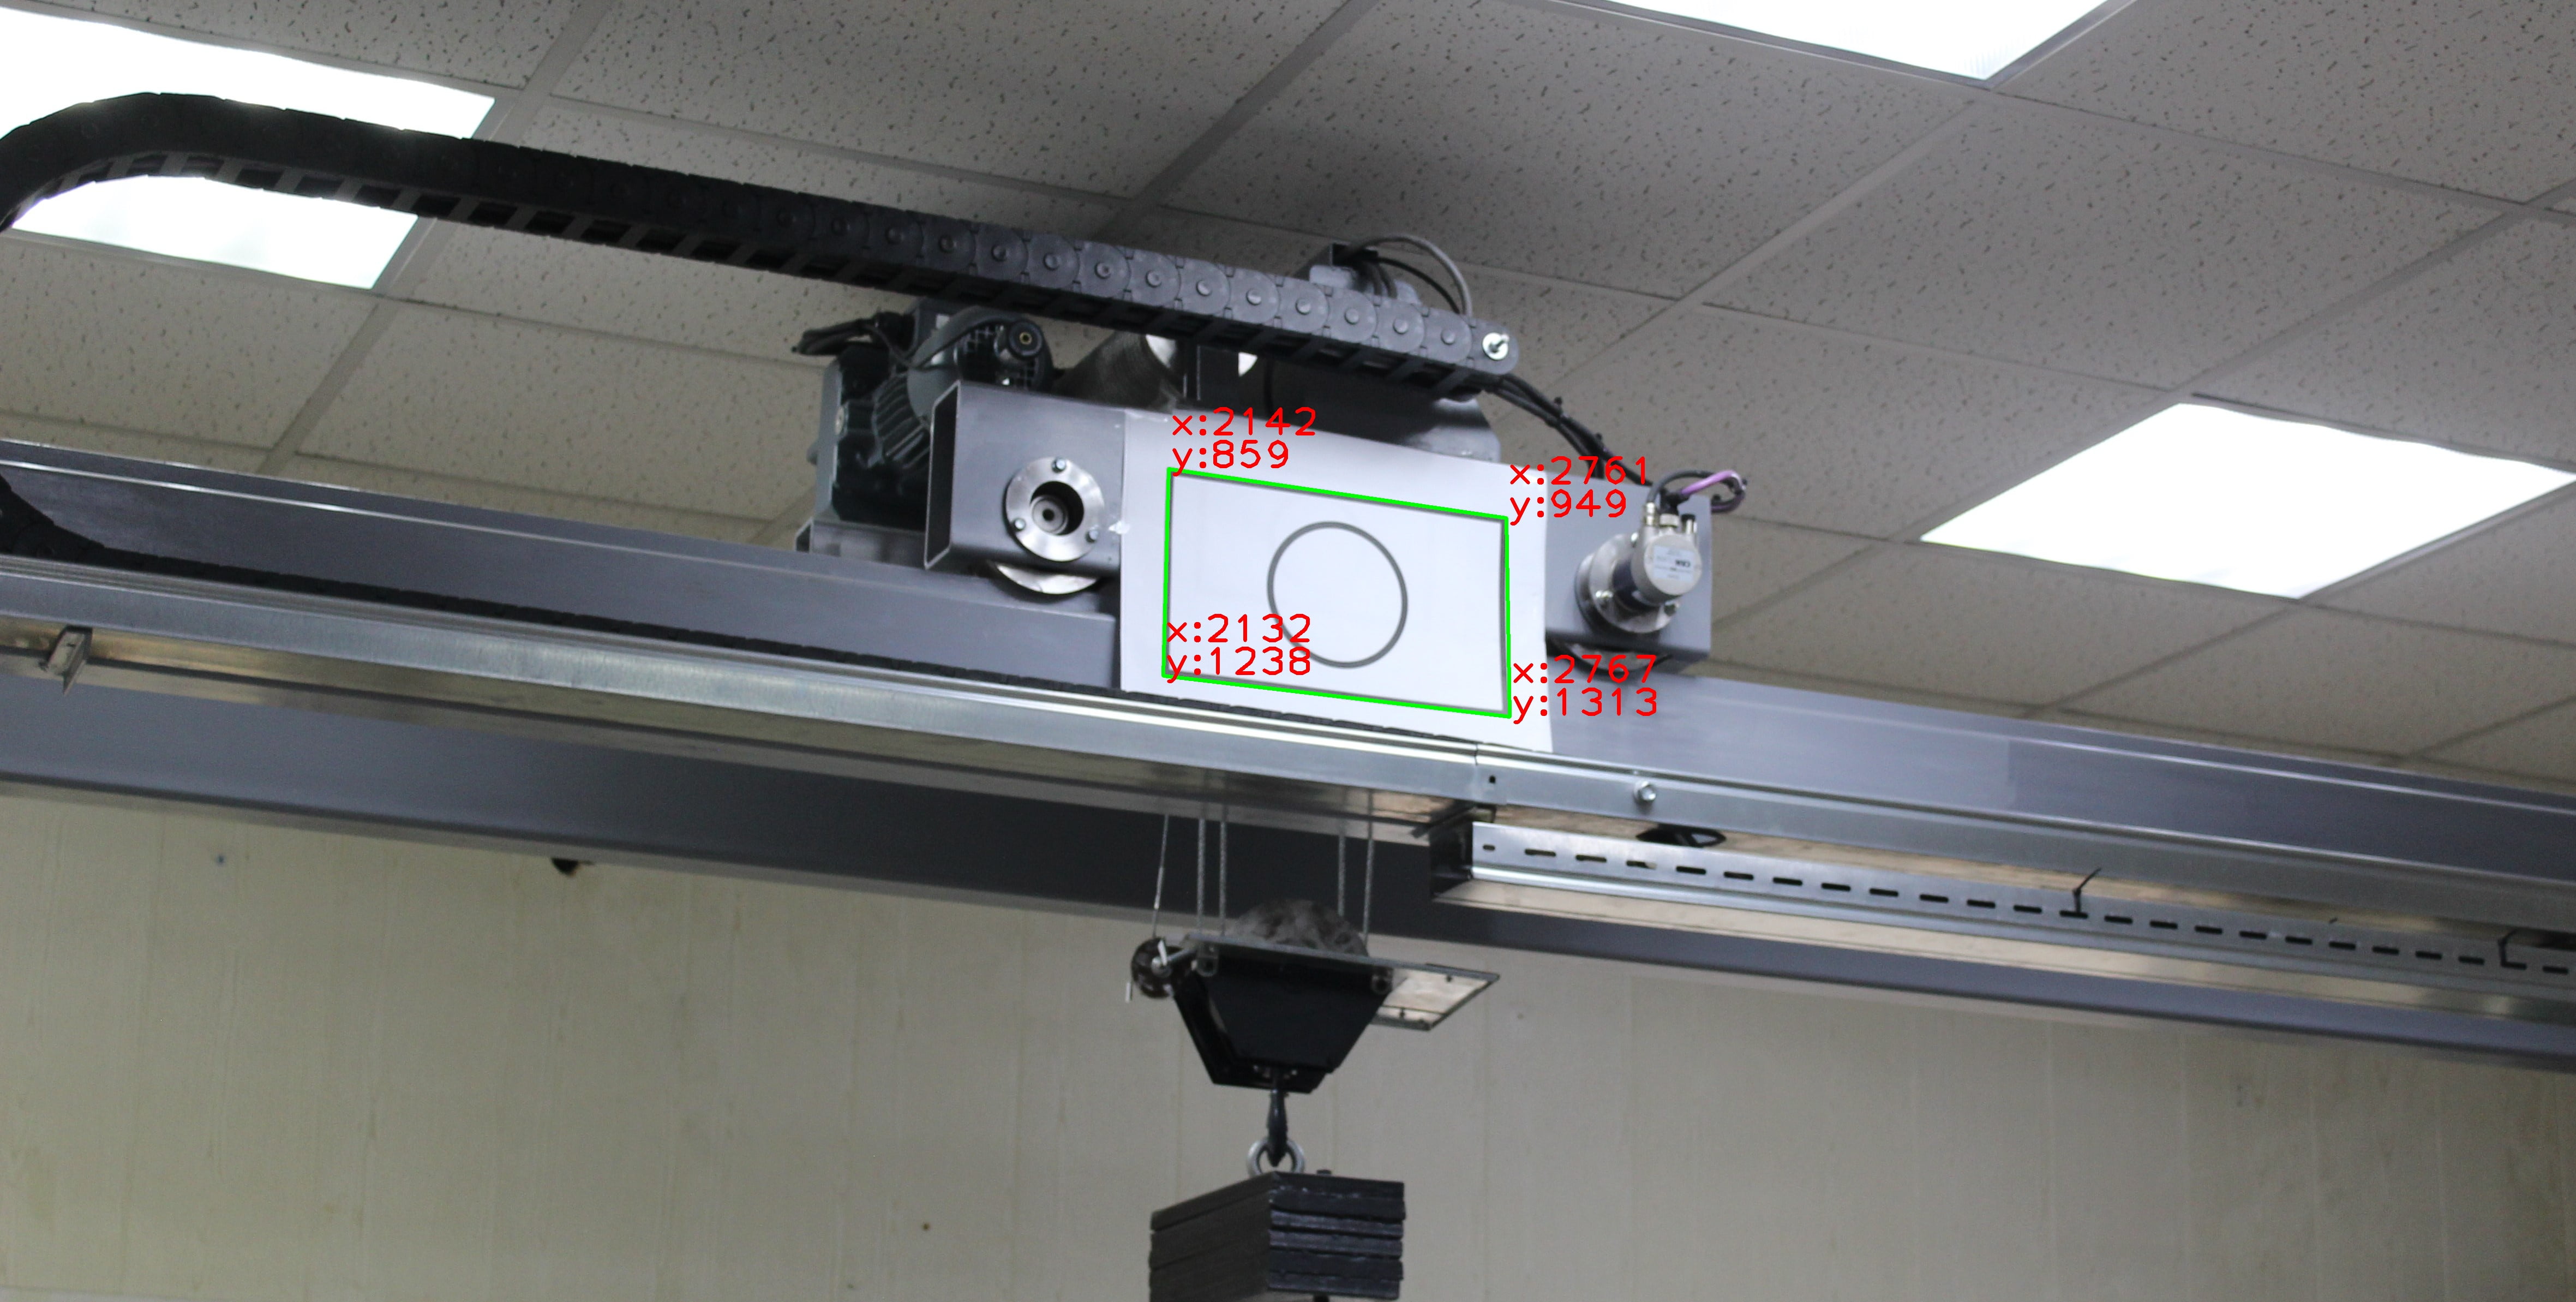
В компьютерном зрении существует метод измерения расстояния до объекта без использования датчиков глубинны и стереокамер. В данной работе метод используется для определения положения и скорости тележки мостового крана.

Благодаря тому, что тележка оснащена энкодерами, я смогу показать, насколько точно работает данный метод, основанный на подобие треугольников. В статье показано как измерить дистанцию с помощью одной камеры, и как это можно использовать в практических задачах.

Тема посвящена моей дипломной работе в магистратуре, которую я писал два года назад.
Читать дальше →

Заметки Дата Сайентиста: на что обратить внимание при выборе модели машинного обучения — персональный топ-10

Время на прочтение7 мин
Охват и читатели15K

Мы снова в эфире и продолжаем цикл заметок Дата Сайентиста и сегодня представляю мой абсолютно субъективный чек-лист по выбору модели машинного обучения.

Это топ-10 свойств задачи и просто пунктов (без порядка в них), с точки зрения которых я начинаю выбор модели и вообще моделирование задачи по анализу данных.

Совсем не обязательно, что у вас он будет таким же — здесь все субъективно, но делюсь опытом из жизни.
Читать дальше →