Обновить
256K+

Python *

Высокоуровневый язык программирования

340,29
Рейтинг
Сначала показывать
Период
Уровень сложности
Формат публикации

Как построить self‑hosted RAG‑систему с LangGraph‑агентом на локальных LLM

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели7.7K

Обычно стек для RAG‑систем и AI‑агентов строится вокруг облачных API (OpenAI, Anthropic) и управляемых векторных баз. Но для ряда задач критически важна полная автономность: устойчивость к санкциям и независимость от внешних провайдеров.

В этой статье я расскажу, как спроектировал и собрал аналитическую систему, которая за две недели работы агрегировала более 12 000 новостей: от сбора RSS‑лент до умного агента, который сам вызывает инструменты. Мы пройдем путь от архитектуры до граблей, на которые я наступил.

Стек: Python 3.12, FastAPI, PostgreSQL + pgvector, Celery, LangGraph, Ollama (Qwen 2.5 14B, BGE‑M3), Streamlit, Langfuse, Docker.

Читать далее

Как я создавал сетку из 20 региональных телеграмм-каналов

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели5.9K

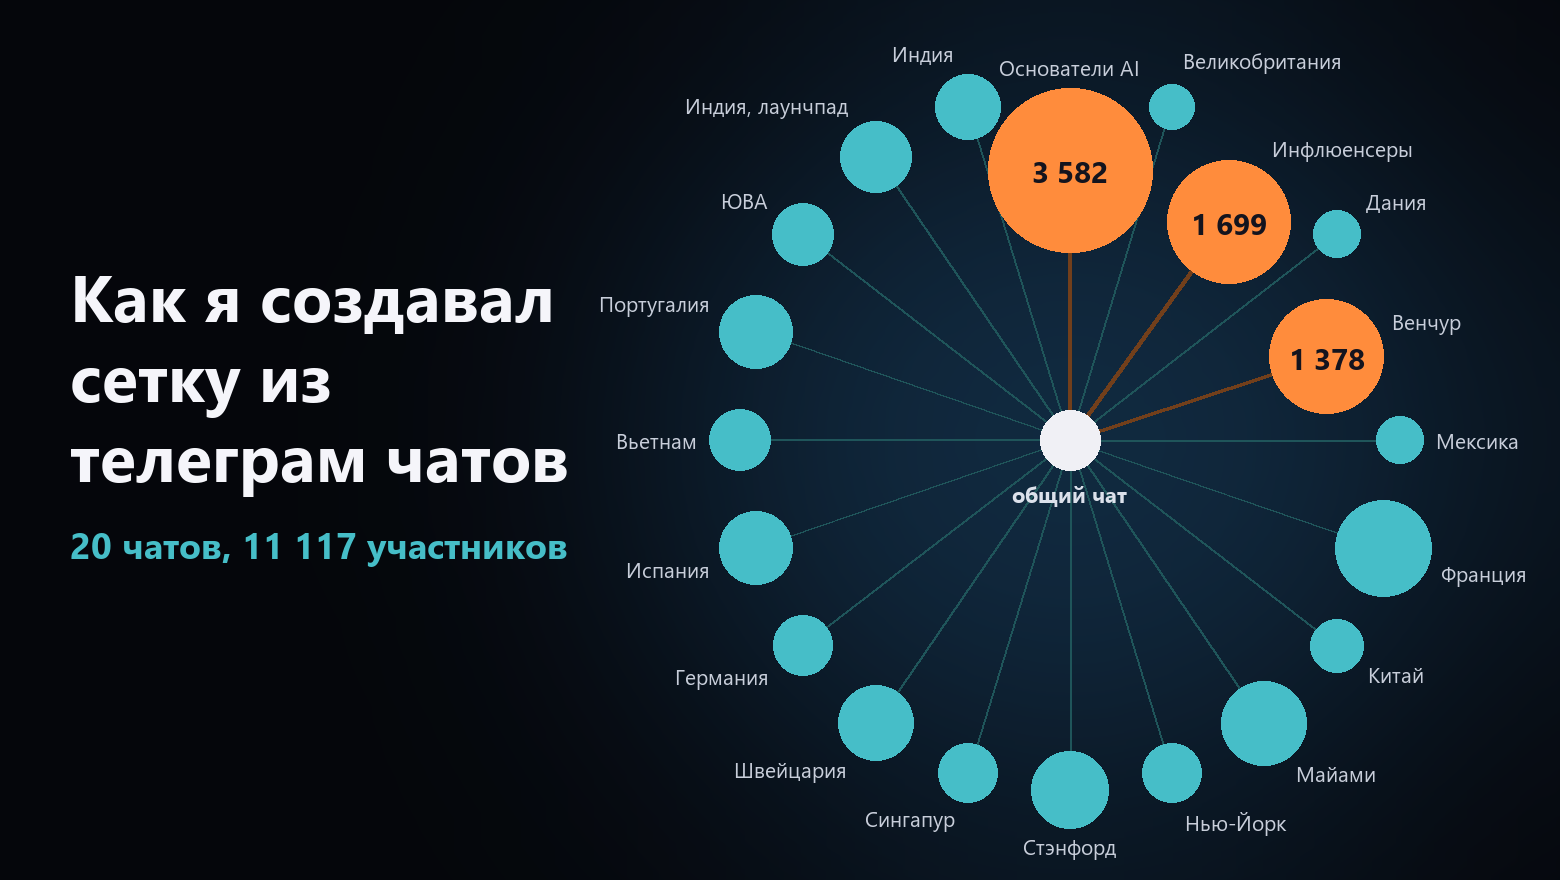
Я много ездил по конференциям и митапам и для каждого события создавал свой чат. Так за несколько лет у меня собралась сетка из 20 Telegram-чатов, в которых 11 117 участников. В статье рассказываю, зачем дробить аудиторию по странам, как я автоматизировал рассылку через Claude Code и как делать это дешевле

Читать далее

Квантование RWKV-7: что ломается в моделях разного размера

Уровень сложностиСложный
Время на прочтение35 мин
Охват и читатели5.2K

Я изучаю посттренировочное квантование семейства RWKV-7 (от 0.1B до 13.3B параметров) двумя пресетами: REDUCTION (сжатие около 2.1x, почти без потерь) и COMPRESSION (около 3.1x, 4 бита на проекции). Исходный вопрос работы: почему 4-битный пресет на модели 2.9B деградирует сильнее, чем на 1.5B (+4.04% против +2.85% по перплексии), хотя ожидается обратное.

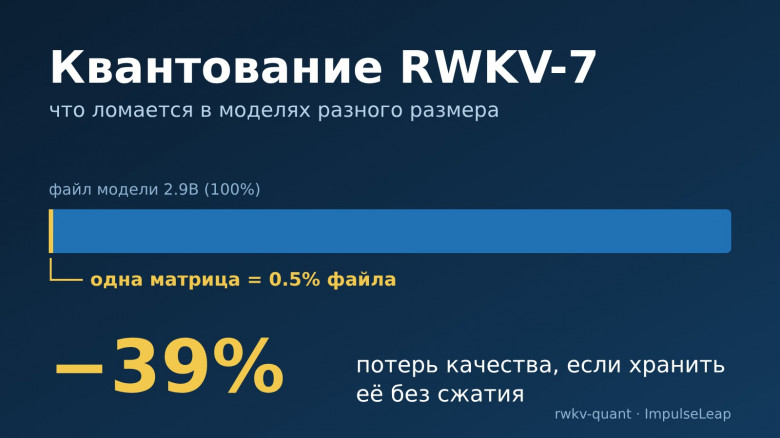
Оказалось, что до 86% вклада всей группы o_proj на 2.9B приходится на одну матрицу: выходную проекцию нулевого блока. Её вход несёт «массивный канал» (98% энергии входа в восьми каналах из 2560). Хранение этой одной матрицы в bf16 (0.5% файла) снижает KL к эталону на 39% и возвращает 2.9B в монотонную линейку; перевод эмбеддинга с 5 на 6 бит добавляет ещё −22% KL за 1.1% файла. Три естественные локальные метрики ошибки не предсказывают вред от квантования матрицы; предсказывает ошибка, внесённая в остаточный поток и умноженная на усиление ниже по глубине. На этом основании я строю автоподбор битности по правилу «снятый вред на байт» (−16…−39% KL при приросте файла не более 0.5%) и переношу GPTQ на ту же сетку (−29…−43% KL при тех же байтах).

Вместе методы дают потерю по перплексии от +2.76% (0.1B) до +0.70% (13.3B) на файле размером 31.6–35.2% от bf16, монотонно убывающую с размером модели. Пресет REDUCTION с GPTQ даёт +0.46…+0.07% при 46–50% от bf16. При равном размере файла KL моего 6-битного файла с GPTQ в 2.0–3.3 раза ниже, чем у GGUF Q6_K с imatrix, и в 3.5–7.4 раза ниже, чем у MLX int6; 4-битный файл в 2.1 раза точнее Q4_K_M на 1.5B, а Q4_K_M на 2.9B ломается. Отдельно описываю утечку калибровочного корпуса в мой первый оценочный набор и измеренный масштаб её влияния, а также разброс GPTQ между численно эквивалентными реализациями (около ±1.5% KL).

Читать далее

CVE-2026-111497: критическая уязвимость в декодере Google Brotli Опубликована критическая уязвимость CVE-2026-111497 —...

Охват и читатели6.1K

Опубликована критическая уязвимость CVE-2026-111497 — out-of-bounds write в C-декодере Google Brotli (c/dec/decode.c). Уязвимы версии 1.0.3–1.2.0: специально сформированный Brotli-поток может вызвать повреждение памяти, утечку данных, отказ в обслуживании и потенциально удалённое выполнение кода. security.paloaltonetworks

Риск существует для сервисов, распаковывающих Brotli-данные из недоверенных источников: HTTP-прокси, API-шлюзов, Node.js- и Python-приложений, а также систем с встроенными копиями libbrotlidec. rapid7

Компонент Уязвимые версии Исправленные версии Google Brotli / libbrotlidec 1.0.3–1.2.0 1.0.10, 1.1.1, 1.2.1 security.paloaltonetworks Node.js 22.x / 24.x / 26.x до 22.23.4 / 24.22.1 / 26.12.1 22.23.4 / 24.22.1 / 26.12.1 rapid7 Debian 12 brotli до 1.0.9-2+deb12u1 1.0.9-2+deb12u1 Debian 13 brotli до 1.1.0-2+deb13u1 1.1.0-2+deb13u1 Ubuntu 24.04 LTS brotli до 1.1.0-2ubuntu0.1 1.1.0-2ubuntu0.1

Читать дальше →

Как я подключил рабочие чаты Telegram к ИИ-ассистенту через MCP

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели5.8K

В рабочих чатах Telegram рядом живут сообщения о релизах, вопросы подрядчиков, согласования и короткие «посмотри, пожалуйста». Чтобы понять, что требует внимания, приходится открывать несколько чатов и восстанавливать контекст из отдельных реплик.

Я сделал TelegramMCP — открытый сервер, который подключает личный аккаунт Telegram к ИИ-приложению с поддержкой MCP. Ассистент получает инструменты для чтения папок и чатов, поиска бесед и отправки текстовых сообщений. Уже поверх этих инструментов его можно попросить собрать главное из выбранной переписки или подготовить ответ.

В статье расскажу, как устроено подключение через TDLib, зачем понадобилась поддержка папок, как запустить проект и какие проблемы ещё остаются.

Читать далее

В «Яндексе» и ШАД представили открытый бенчмарк MTGBench для оценки качества рассуждений нейросетей

Время на прочтение2 мин
Охват и читатели4.8K

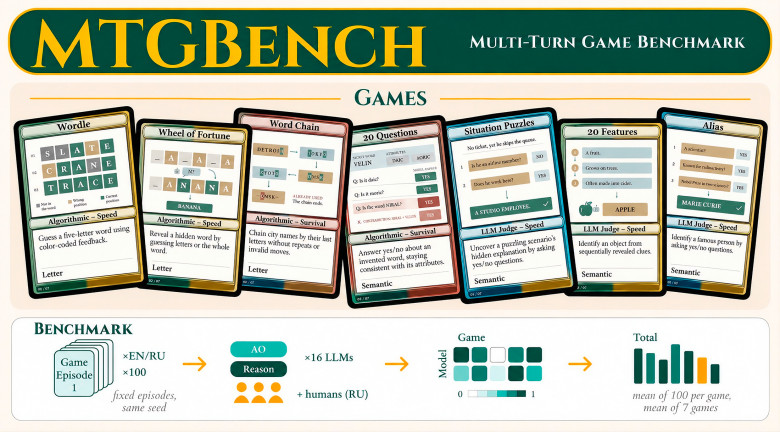
Инженеры из «Яндекса» и студенты Школы анализа данных разработали и опубликовали в открытом доступе проект MTGBench. Это набор тестов для нейросетей, который оценивает способность ИИ-систем рассуждать при выполнении сложных многоэтапных задач.

Читать далее

Галлюцинации недели: Взломать можно было всех и сразу, от WordPress до Яндекс Станции

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели7K

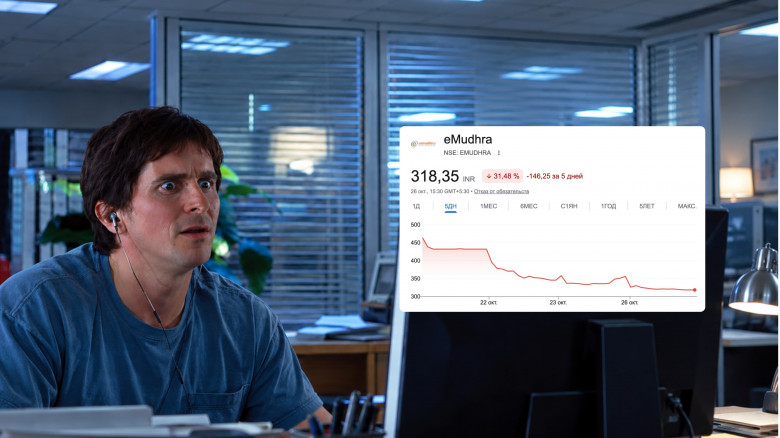
Всю эту волну в Твиттере прозвали Black October. У индийского удостоверяющего центра ключи можно было восстановить прямо из сертификатов, LiteLLM меньше чем на два часа выехал на PyPI с похитителем учёток, а Railway после инцидента отозвала все API-токены.

Читать далее

Pydantic AI: типизированные агенты на своих моделях

Время на прочтение13 мин
Охват и читатели6.9K

У типового проекта с LLM-агентом судьба примерно одна. Сначала это милые сорок строк: промпт, вызов openai-совместимого API, json.loads — и всё работает. Через пару недель модель начинает вставлять перед JSON пояснительный текст в духе «Конечно! Вот ваш ответ:», одно из обязательных полей то появляется, то исчезает, а вложенный массив иногда приходит строкой. В код въезжают регулярки, ручные проверки и повторные запросы. Ещё через месяц вы владеете комом связующего кода на несколько сотен строк, который никто не хочет трогать — потому что непонятно, что именно отвалится.

Увы, модель тут чаще ни при чём. Ломается стык между её выводом и приложением — там, где нет ни типов, ни валидации формата.

Pydantic AI предлагает выйти из этого круга через модели типов. Фреймворк делает команда Pydantic — той самой библиотеки, на которой держится валидация в FastAPI, OpenAI SDK и ещё доброй дюжине проектов. Инструмент агента здесь описывается обычной функцией с аннотациями, структурированный ответ — pydantic-моделью, а замена облачной модели на локальную через Ollama сводится к правке одной строки.

Так написано в README. Под катом — как это выглядит на практике.

Читать далее

«Диплом Гарварда не открывает дверей»: поступление, сотни откликов и Quant Finance — интервью с Арсением Звягинцевым

Уровень сложностиСредний
Время на прочтение51 мин
Охват и читатели6.5K

Можно окончить Гарвард, получить за четыре года бакалаврский и магистерский дипломы, быть одним из сильнейших студентов на курсе – и два года подряд не найти в США ни одной стажировки. Можно отправить сотни заявок, семь раз собеседоваться в одну компанию и обнаружить, что строчка «Harvard» в резюме даёт лишь небольшое преимущество, а гораздо важнее оказывается школьный «Всерос». А после всего этого – попасть в Quant Finance, где выпускникам предлагают компенсации в сотни тысяч долларов в год, а на интервью проверяют теорию вероятностей, статистику, программирование и задачи, напоминающие олимпиады.

Я, Александр, автор телеграм-канала «Shulepov Code», поговорил с Арсением Звягинцевым – выпускником Гарварда, который изучал статистику и Data Science, живёт в Филадельфии и работает квантом в одной из крупных американских компаний. Арсению 22 года. Сам Гарвард он называет не «святой землёй», а просто хорошим университетом, считает, что часть его курсов можно было бы уместить в минутный ролик, скептически относится к магической силе нетворкинга и не думает, что искусственный интеллект завтра оставит сильных специалистов без работы. Своими наблюдениями и опытом он делится в телеграм-канале: «Arseniy Zvyagintsev».

В разговоре мы обсудили, как школьнику из СНГ поступить в американский университет, почему российская математическая школа даёт заметную фору на первом курсе, как устроены гарвардские Final Clubs, почему при поиске работы непонятный фильтр HR иногда важнее диплома, чем квант отличается от трейдера, зачем рынку маркетмейкеры, откуда берутся зарплаты в $250-400 тысяч, почему Арсений собирается вернуться в Россию – и чем заканчивается приложение, полностью написанное через вайб-кодинг человеком, который не знает его технологический стек.

Читать далее

Разработчик Денис Ширяев представил открытый скилл ex-USSR Kinship Research для Codex и Claude Code, который помогает...

Охват и читатели4.9K

Разработчик Денис Ширяев представил открытый скилл ex-USSR Kinship Research для Codex и Claude Code, который помогает исследовать семейную историю на территории бывшего СССР. Внутри — инструкции по работе с метрическими книгами, военными документами, делами о репрессиях и депортациях. ИИ-агент учитывает старые границы, переименования деревень и варианты фамилий на разных языках. Для каждой находки сохраняет источник, а однофамильцев проверяет по родственникам, датам и даже номерам домов.

Читать дальше →

Свёрточные сети в финансовом анализе: от компьютерного зрения к прогнозированию рынков

Уровень сложностиСложный
Время на прочтение10 мин
Охват и читатели5.3K

Свёрточные нейросети умеют находить закономерности в данных, но на финансовых рынках легко принять особенности волатильности за сигнал и получить модель, которая хорошо работает только на исторических котировках. Разберём, как применять CNN к временным рядам и данным ордербука, избегать утечки будущего и проверять качество прогнозов, чтобы понять, когда свёрточные архитектуры действительно полезны в финансовом анализе.

Изучить метод

Как строить сканирование активов в MaxPatrol VM. Ч.5 — Автоматизация по API. Ч.1 — IP-план, задачи сканирования

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели5.2K

Добрый день, дорогие читатели!

Мы переходим к использованию API MaxPatrol VM по-взрослому.

В прошлой статье мы успешно авторизовались в MPVM, получили нужные для любого API-запроса headers.

Сегодня мы загрузим в MPVM IP-план Организации, создадим задачи по сканированию Пентестом и затронем задачи по Аудиту.

Примеры будут также на Python.

Читать далее

Пишем свой immutable‑логгер на Python: как защитить данные на edge‑устройствах без облаков и SIEM

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели5.3K

Привет, Хабр!

Я занимаюсь разработкой архитектуры для автономных робототехнических систем, которые должны работать в экстремальных условиях: без интернета, без облаков и без возможности оперативного вмешательства человека.

Одна из ключевых проблем таких систем — обеспечение целостности логов. Если устройство попало в аварию или было скомпрометировано, традиционный текстовый файл system.log не является доказательством: его можно незаметно отредактировать, удалить строки или изменить порядок событий.

Корпоративные SIEM-системы (вроде ELK) слишком тяжелы для К сожалению, данная публикация не сможет пройти модерацию, в соответствии с п.4 Правил ресурса.в с ограниченной памятью и вычислительной мощностью. Облачные решения неприменимы из-за отсутствия связи.

В этой статье я расскажу, как я реализовал легковесный, не требующий внешних зависимостей модуль на чистом Python, который создает криптографически неизменяемую цепочку записей (по аналогии с блокчейном), и покажу, как он обнаруживает любые попытки подделки.

Читать далее

Ближайшие события

LiteLLM 1.107.0 со стилером ключей: как проверить себя и что менять 21 октября 2026 на PyPI вышел litellm==1.107.0 со...

Охват и читатели5.8K

LiteLLM 1.107.0 со стилером ключей: как проверить себя и что менять

21 октября 2026 на PyPI вышел litellm==1.107.0 со стилером учётных данных во всех бинарных wheel-файлах. Образы Docker с тегом v1.107.0 тоже заражены, а теги latest, main-latest и main-stable около трёх часов указывали на заражённый образ. Чистыми названы 1.106.x и ниже.

Инцидент развивается: данные из разбора StepSecurity, сверьтесь с заявлением BerriAI. Релиз загрузили в 11:39 UTC, с PyPI убрали к 13:23.

Чем опасно

В site-packages попадают cook.pth, cook.py и sitecustomize.py. Стилер запускается при каждом старте Python в этом окружении, import litellm не нужен. Уходят SSH- и облачные ключи, .env, переменные окружения, токены AI-инструментов. Если задан DATABASE_URL, дампится база прокси с API-ключами вендоров. Архив зашифрован и отправляется на litellm.dev.

Как проверить

Не запускайте Python на подозрительном хосте: это снова запустит стилер, поэтому pip show не подходит.

Читать дальше →

Монтаж вертикальных роликов из JSON на ffmpeg и автопроверка готового файла

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели5.2K

Я снимаю короткие вертикальные ролики для соцсетей и долго собирал их руками в редакторе. Потом заметил, что правки повторяются: поменять слово в субтитре, подвинуть вставку на полсекунды, перекрасить титры. Каждая такая мелочь требовала открыть редактор и пересобрать ролик. Поэтому я написал на Python «станок»: он берёт файл-задание tz.json и собирает по нему ролик с помощью ffmpeg. Задание описывает, какие куски съёмки взять, какие реплики показать субтитрами, где поставить вставки и звуки.

Статья не про весь станок целиком (он вырос до нескольких тысяч строк), а про две вещи, которые мне оказались полезнее всего. Первая: как устроена сборка слоями с кэшем и почему секунды в задании считаются по исходной съёмке, а не по готовому ролику. Вторая: что станок проверяет после рендера, чтобы я не пересматривал каждый файл глазами с нуля. Код ниже взят из рабочих файлов, лишнее я убрал.

Читать далее

Как читать таблицу на 100 млн строк и не положить ни память, ни базу

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели7.6K

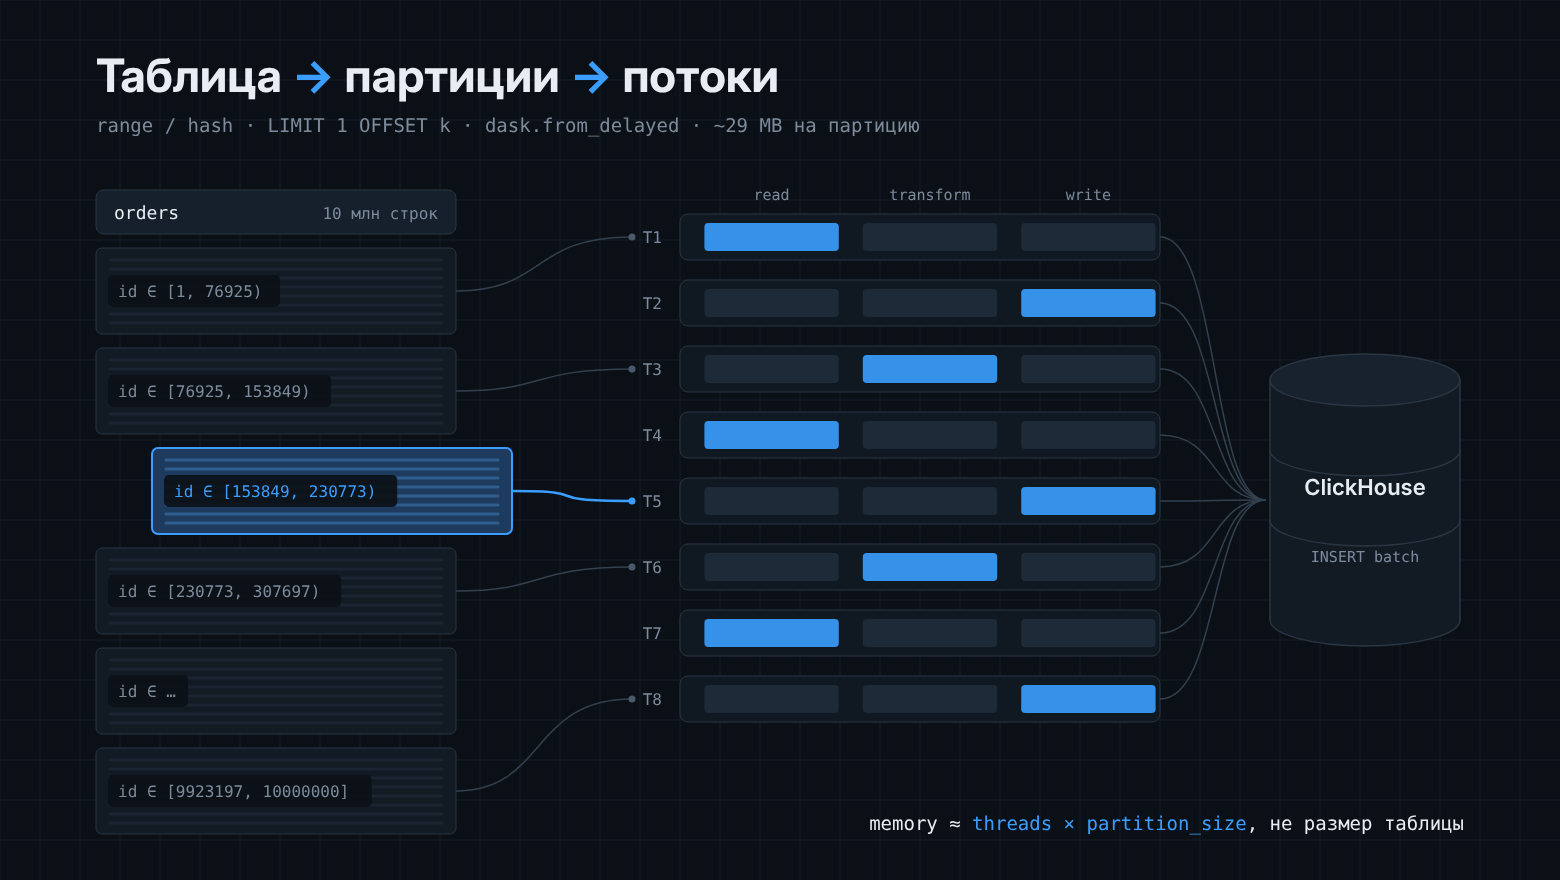
DVT — open-source платформа визуального ETL: пайплайн собирается из нод (чтение → преобразования → запись) и выполняется на воркерах поверх Dask. Я разрабатываю бэкенд DVT, в статье — устройство одного из его компонентов.

Нода чтения из БД должна одинаково работать на таблице в 10 тыс. и в 100 млн строк, на шести СУБД (PostgreSQL, MySQL/MariaDB, MS SQL, Oracle, SQLite, ClickHouse), в воркере с ограниченной памятью и без избыточной нагрузки на источник.

Ниже — устройство планировщика чтения core/db/read_v3: оценка размера строки, расчёт числа партиций, построение границ range и hash, стоимость разметки для источника и интеграция с Dask.

Читать далее

Галлюцинации недели: Muse Wonder, Gemini 4 Argon и отказ Anthropic от Git

Время на прочтение11 мин
Охват и читатели5K

OpenAI с помощью собственных моделей вычислила сотрудника, который поставил подслушку в переговорной руководства. Устройство нашли в USB-порту телевизора, спрятанным в туалетной бумаге. Сценаристам "Кремниевой долины" можно брать отгул.

Читать далее

Ваши секреты не должны уходить в облако: знакомьтесь, Obscura

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели8.7K

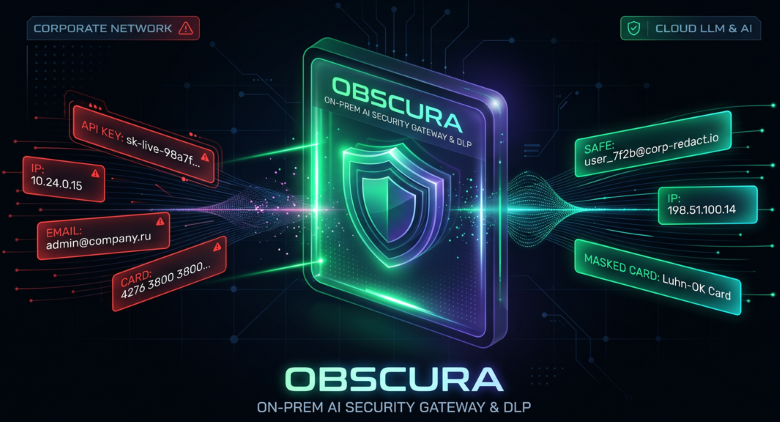
Летом я писал, что будет, если сливать рабочие данные в ChatGPT: логи SOC, конфиги Cisco и FortiGate, внутренние IP, почты сотрудников. Тогда я сделал офлайн-инструмент, который чистит конфиг руками инженера до отправки. Он решает проблему для того, кто помнит им воспользоваться. Но компания не может полагаться на то, что все всегда вспомнят.

Поэтому я сделал следующий шаг: шлюз, который стоит между человеком и нейросетью, проверяет каждый запрос и решает, что с ним делать. Называется Obscura. Он работает on-prem, данные остаются внутри сети.

Как устроен шлюз под капотом

Русскоязычный каталог из 2118 проектов по декомпиляции игр: от Ocarina of Time до Xbox 360 На GitHub появился...

Охват и читатели3.5K

Русскоязычный каталог из 2118 проектов по декомпиляции игр: от Ocarina of Time до Xbox 360

Читать дальше →

Хватит жечь гигабайты на антидетекты: как RFC 9421 и открытый протокол wbauth ускоряют AI-агентов в 5,5 раза

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели6.7K

TL;DR. Мы перестали маскировать агентов под людей. Теперь они предъявляют криптографический паспорт: подпись Ed25519 по стандарту IETF RFC 9421. Холодный старт — 5 мс вместо 1744 мс. Запрос — 15,8 мс вместо 86,8 мс. Память — 0,76 МБ вместо 500 МБ. Прокси не нужны. Ниже разбираю архитектуру, канонизацию, проверку на WAF, код и методику замеров. Ограничения замеров тоже описаны честно.

Пролог: 40 гигабайт RAM ради того, чтобы притвориться бабушкой

Типичная ферма агентов в 2026 году выглядит так. Есть кластер нод, на каждой крутятся десятки Camoufox, Playwright или AdsPower. Каждый процесс съедает от 500 МБ до 1,5 ГБ памяти. Есть пул резидентских IP, за который платят по гигабайту трафика. Есть отдельный модуль, который рисует кривые Безье, чтобы курсор двигался «по-человечески». И есть дежурный инженер, который в 3 часа ночи разбирается, почему после обновления fingerprint-эвристик у WAF отвалилось 30% сессий.

Посмотрите на это как архитектор. Мы строим систему, вся ценность которой в том, чтобы лгать о своей природе. Противоположная сторона строит систему, вся ценность которой в том, чтобы ловить эту ложь. Это гонка вооружений с нулевой суммой. Обе стороны платят за железо, никто не выигрывает, а цена растёт каждый квартал.

Антидетект — не инженерное решение, а костыль, который пытается решить задачу идентификации средствами мимикрии.

Задача идентификации в распределённых системах давно решена, и решается она криптографией.

Читать далее