Обновить
15
Иван Голиков@HybridTech

Пользователь

26
Подписчики
Отправить сообщение

Прием платежей в крипто валютах в Telegram боте через WalletPay и Python/Flask

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели53K

Приветствую сообщество.

Бот Telegram @wallet недавно предоставил API для приема платежей в сторонних Telegram ботах. Из крипто валют поддерживаются BTC, TON, USDT.

Необходимо зарегистрироваться на сайте, предоставить сведения о подключаемом к API боте, пройти процедуру идентификации (биометрия для физических лиц), дождаться одобрения заявки и назначения размера комиссии для ваших платежей. У меня процедура заняла чуть более суток.

После одобрения заявки получаете доступ в личный кабинет, где нужно сгенерировать ключ для доступа к API WalletPay.

После этого можно приступать к продажам. Покупателю нужно предоставить ссылку для оплаты через WalletPay товаров/услуг вашего бота. Код для получения этой ссылки может быть таким.

Читать далее

Hetzner прекращает предоставление услуг для клиентов из РФ

Время на прочтение1 мин
Охват и читатели63K

Hetzner предупредил, что 15 декабря 2023 г. распространит официальное уведомление о прекращении предоставления услуг для аккаунтов с почтовым адресом в РФ.

Отключение услуги запланировано на 31 января 2024 г.

Читать далее

Сервисы на базе нейросетей для дизайнеров

Время на прочтение4 мин
Охват и читатели45K

Дизайнер Фёдор Волков сделал подборку сервисов, в которых нейросети помогают дизайнерам сэкономить рабочее время и избавиться от рутинных задач.

Микросервисы vs. Монолит

Время на прочтение20 мин
Охват и читатели77K
В начале ноября на ютуб-канале Яндекс.Практикума прошли дебаты «Микросервисы, Монолит и Зомби». Ведущие дебатов — наставник курса «Мидл Python-разработчик» Руслан Юлдашев и техлид курса Савва Демиденко — разобрали архитектуры двух систем, прошлись по реальным задачам и ошибкам из своей рабочей практики и по очереди защищали свои позиции.

Обсуждение растянулось на 100 минут, поэтому мы публикуем сокращённую текстовую расшифровку.


Этот материал будет полезен разработчикам, которые хотят научиться делать хорошо масштабируемые продукты и задумываются про архитектурные проблемы в разработке, а также для тех, кто принимает архитектурные решения в проектах.

Вы узнаете, как врачи регионов России не получали зарплату из-за микросервисов и сколько монолитов можно запустить, пока согласовывается интерфейс между сервисами.
Читать дальше →

Как живется в США «айтишнику». Три года спустя

Время на прочтение26 мин
Охват и читатели111K

Вместо того, чтобы затеряться в тысяче комментариев под статьей автора, о не самой сладкой жизни в США, я решил описать свой опыт по тем же предложенным темам. Благо недавно я вышел на финишную прямую по легализации и есть некоторая уверенность в том, что в Россию я не вернусь. Давайте опишем все в той же стилистике моих личных впечатлений, спустя 3,5 года жизни в Техасе. 

Поехали!

Как работать с метками времени (timestamp) в PostgreSQL?

Время на прочтение9 мин
Охват и читатели241K
Тема работы с временными метками в PostgreSQL плохо раскрыта в русскоязычных профильных публикациях в Интернете и служит частым источником проблем в работе программистов. Предлагаю вашему вниманию перевод материала от Hubert Lubaczewski, автора популярного зарубежного блога depesz.com. Надеюсь, статья будет для вас полезна!

image

Время от времени в IRC или в почтовых рассылках кто-нибудь задает вопросы, которые показывают глубокое непонимание (или недостаток понимания) меток времени, особенно тех, которые учитывают часовые пояса. Так как я уже сталкивался с этим ранее, позвольте мне рассказать, что такое timestamps, как с ними работать и с какими наиболее распространенными загвоздками вы можете столкнуться.
Читать дальше →

Фантастик-Elasticsearch. Как мы «укротили» умный поиск по документам

Время на прочтение10 мин
Охват и читатели51K

Полнотекстовый поиск даёт возможность искать документы по текстовому содержимому. Такая необходимость может возникнуть, когда система содержит много текстовых сущностей, а пользователям требуется учитывать эти данные во время поиска. Мы столкнулись с подобной ситуацией при разработке решения для документооборота*. Данные системы хранятся в MS SQL Server или PostgreSQL, а гибкий атрибутивный поиск позволяет находить документы по различной мета-информации. Однако со временем этого стало недостаточно. Перед нами встала задача: научиться искать документы по текстовым свойствам и приложенным файлам.


Читать дальше →

Scala коллекции: секреты и трюки

Время на прочтение28 мин
Охват и читатели36K

Представляю вашему вниманию перевод статьи Павла Фатина Scala Collections Tips and Tricks. Павел работает в JetBrains и занимается разработкой Scala плагина для IntelliJ IDEA. Далее, повествование идет от лица автора.


В этой статье вы найдете упрощения и оптимизации, характерные для повседневного использования API Scala коллекций.


Некоторые советы основаны на тонкостях реализации библиотеки коллекций, однако большинство рецептов — это разумные преобразования, которые на практике часто упускаются из виду.


Этот список вдохновлен моими попытками разработать практичные инспекции для Scala коллекций, для Scala плагина IntelliJ. Сейчас мы внедряем эти инспекции, так что, используя Scala плагин в IDEA, вы автоматически выигрываете от статического анализа кода.


Тем не менее, эти рецепты ценны сами по себе. Они могут помочь вам углубить понимание стандартной библиотеки коллекций Scala и сделать ваш код быстрее и выразительнее.


Обновление:
Если вы испытываете тягу к приключениям,
вы можете узнать, как помочь в развитии IntelliJ плагина для Scala и попробовать свои силы в реализации, подобрав подходящую инспекцию.

Читать дальше →

Горизонтальное масштабирование. Что, зачем, когда и как?

Время на прочтение17 мин
Охват и читатели134K
Александр Макаров

Александр Макаров ( SamDark )


Здравствуйте! Я Александр Макаров, и вы можете меня знать по фреймворку «Yii» — я один из его разработчиков. У меня также есть full-time работа — и это уже не стартап — Stay.com, который занимается путешествиями.

Сегодня я буду рассказывать про горизонтальное масштабирование, но в очень-очень общих словах.

Что такое масштабирование, вообще? Это возможность увеличить производительность проекта за минимальное время путем добавления ресурсов.

Обычно масштабирование подразумевает не переписывание кода, а либо добавление серверов, либо наращивание ресурсов существующего. По этому типу выделяют вертикальное и горизонтальное масштабирование.
Читать дальше →

Изучаем Docker, часть 1: основы

Время на прочтение6 мин
Охват и читатели886K
Технологии контейнеризации приложений нашли широкое применение в сферах разработки ПО и анализа данных. Эти технологии помогают сделать приложения более безопасными, облегчают их развёртывание и улучшают возможности по их масштабированию. Рост и развитие технологий контейнеризации можно считать одним из важнейших трендов современности.

Docker — это платформа, которая предназначена для разработки, развёртывания и запуска приложений в контейнерах. Слово «Docker» в последнее время стало чем-то вроде синонима слова «контейнеризация». И если вы ещё не пользуетесь Docker, но при этом работаете или собираетесь работать в сферах разработки приложений или анализа данных, то Docker — это то, с чем вы непременно встретитесь в будущем.

→ Часть 1: основы
→ Часть 2: термины и концепции
→ Часть 3: файлы Dockerfile
→ Часть 4: уменьшение размеров образов и ускорение их сборки
→ Часть 5: команды
→ Часть 6: работа с данными

image

Если вы пока не знаете о том, что такое Docker, сейчас у вас есть шанс сделать первый шаг к пониманию этой платформы. А именно, освоив этот материал, вы разберётесь с основами Docker и попутно приготовите пиццу.
Читать дальше →

Создание подсказок для сайта с помощью EnjoyHint

Время на прочтение6 мин
Охват и читатели38K
Друзья мои! Время от времени каждый из нас сталкивается с ситуацией, когда, попав на новый для себя сайт, приходится хорошенько поразмыслить минуту-другую, чтобы понять, как там все устроено. Примерно в таком же положении можно оказаться, обнаружив радикальные (или не очень) перемены во внешнем облике любимых сайтов, будь то last.fm или Кинопоиск. Существуют разные способы примирить пользователей с новым дизайном: от постепенного знакомства с привнесенными новшествами («Попробуйте бета-версию обновленного сайта прямо сейчас!») до создания пошагового гайда по новым возможностям. О последнем варианте мы сегодня и поговорим.

finding a way
Читать дальше

Особенности реализации MVP для Windows Forms

Время на прочтение8 мин
Охват и читатели97K
Доброго времени суток!
Model-View-Presenter — довольно известный шаблон проектирования. С первого взгляда все выглядит просто: есть Модель (Model), которая содержит всю бизнес-логику экрана; Вид/Представление (View), который знает, как отобразить те или иные данные; Представитель (Presenter), который является связующий звеном — реагирует на действия пользователя во View, изменяя Model, и наоборот.
Сложность начинается, когда количество форм в проекте становится более одной.
В данной статье рассматривается:
— немножко теории;
— общие проблемы реализации MVP (а именно Passive View) под Windows Forms;
— особенности реализации переходов между формами и передача параметров, модальные окна;
— использование IoC-контейнера и шаблона Dependency Injection — DI (а именно Сonstructor Injection);
— некоторые особенности тестирования MVP приложения (с использованием NUnit и NSubstitute);
— все это будет происходить на примере мини-проекта и постарается быть наглядным.
В статье затрагивается:
— применение шаблона Адаптер (Adapter);
— простенькая реализация шаблона Контроллер приложения (Application Controller).
Для кого эта статья?
Главным образом для начинающих разработчиков на Windows Forms, которые слышали, но не пробовали, или пробовали, но не получилось. Хотя уверен, что некоторые приемы применимы и для WPF, и даже для веб-разработки.
Читать дальше →

Простое объяснение принципов SOLID

Время на прочтение7 мин
Охват и читатели305K


Принципы SOLID — это стандарт программирования, который все разработчики должны хорошо понимать, чтобы избегать создания плохой архитектуры. Этот стандарт широко используется в ООП. Если применять его правильно, он делает код более расширяемым, логичным и читабельным. Когда разработчик создаёт приложение, руководствуясь плохой архитектурой, код получается негибким, даже небольшие изменения в нём могут привести к багам. Поэтому нужно следовать принципам SOLID.

На их освоение потребуется какое-то время, но если вы будете писать код в соответствии с этими принципами, то его качество повысится, а вы освоите создание хорошей архитектуры ПО.

Чтобы понять принципы SOLID, нужно чётко понимать, как использовать интерфейсы. Если у вас такого понимания нет, то сначала почитайте документацию.

Я буду объяснять SOLID самым простым способом, так что новичкам легче будет разобраться. Будем рассматривать принципы один за другим.
Читать дальше →

Основы внедрения зависимостей

Время на прочтение7 мин
Охват и читатели77K

Основы внедрения зависимостей


В этой статье я расскажу об основах внедрения зависимостей (англ. Dependency Injection, DI) простым языком, а также расскажу о причинах использования этого подхода. Эта статья предназначена для тех, кто не знает, что такое внедрение зависимостей, или сомневается в необходимости использования этого приёма. Итак, начнём.

Читать дальше →

Understanding Dependencies

Время на прочтение12 мин
Охват и читатели84K

От переводчика


Мы — внедрители. Мы должны внедрять, а не фантазировать!
(Рина Зеленая, к/ф «Девушка без адреса»)

К переводу этой статьи меня побудили две причины: 1) желание лучше разобраться с фреймворком Spring, 2) небольшое количество источников по теме на русском языке.

Краеугольный камень ООП — «внедрение зависимостей». Если описание процесса «внедрения» в целом, удовлетворительно, то объяснение понятия «зависимость» обычно оставляют за скобками. На мой взгляд, это существенное упущение.


Чтобы не фантазировать, а внедрять, нужно сначала разобраться с тем, что мы внедряем. И в этом нам может помочь лаконичная статья Jakob Jenkov «Understanding Dependencies». Она будет полезна не только тем, кто пишет на Java, но и тем, кто пишет на других языках и следит за качеством проектирования приложений.

UPD: Я перевел еще одну статью Jakob Jenkov о зависимостях. Читайте на Хабре перевод статьи Dependency Injection, которая открывает одноименную серию статей и по смыслу продолжает данную статью. В статьях серии рассматриваются такие понятия как Dependency, Dependency Injection (DI), DI-контейнеры.

Читать дальше →

Контейнеры внедрения зависимостей и выгоды от их использования

Время на прочтение7 мин
Охват и читатели91K

От переводчика


Всем привет! Я продолжаю серию переводов, в которой мы по косточкам разбираем, что такое Dependency Injection.

В предыдущих статьях серии речь шла о «внедрении зависимостей» как подходе к проектированию приложений и возможных способах реализации такого подхода. Были разобраны типы зависимостей, варианты их внедрения, давались советы по снижению связанности компонентов кода.

В сегодняшнем переводе речь пойдет о том, что собой представляет DI-контейнер, его функциях, преимуществах использования и отличии от фабрик.

Читать дальше →

Dependency injection

Время на прочтение5 мин
Охват и читатели410K

От переводчика


Представляемый вашему вниманию перевод открывает серию статей от Jakob Jenkov, посвященных внедрению зависимостей, или DI. Примечательна серия тем, что в ней автор, анализируя понятия и практическое применение таких понятий как «зависимость», «внедрение зависимостей», «контейнер для внедрения зависимостей», сравнивая паттерны создания объектов, анализируя недостатки конкретных реализаций DI-контейнеров (например, Spring), рассказывает, как пришел к написанию собственного DI-контейнера. Таким образом, читателю предлагается познакомиться с довольно цельным взглядом на вопрос управления зависимостями в приложениях.

В данной статье сравнивается подход к настройке объектов изнутри и извне (DI). По смыслу настоящая статья продолжает статью Jakob Jenkov Understanding Dependencies, в которой дается определение самому понятию «зависимости» и их типам.


Читать дальше →

Зарплаты ИТ-специалистов на середину 2018 года

Время на прочтение3 мин
Охват и читатели150K
image

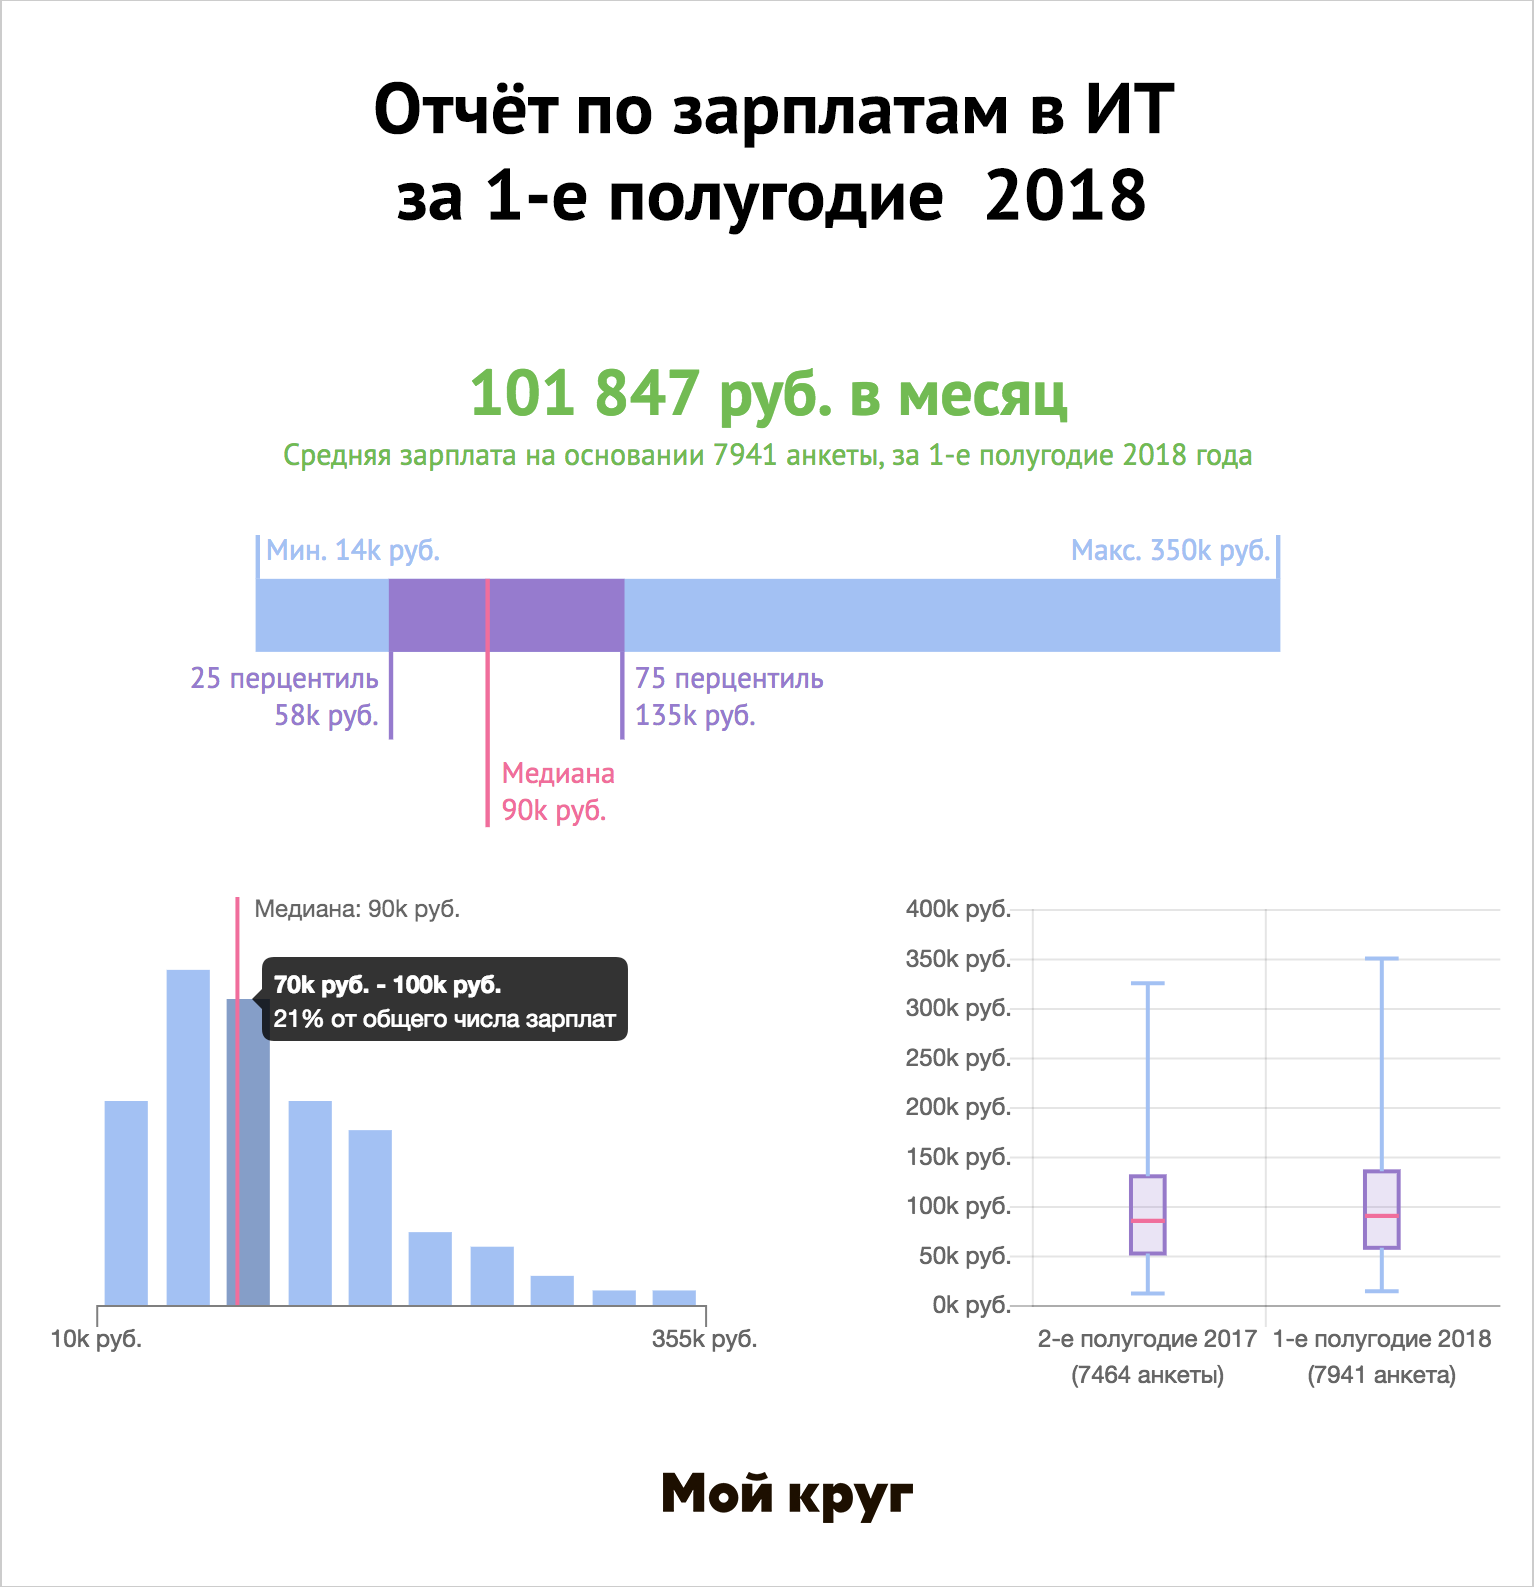
Публикуем второй отчет зарплатного сервиса «Моего круга». Отчёт построен на данных по 7900+ зарплатам, внесенных нашими пользователями за последние полгода. 70% зарплат внесено разработчиками, остальные — администраторами, тестировщиками, менеджерами, аналитиками, дизайнерами, эйчарами, маркетологами и специалистами поддержки.

В этот раз мы не только посмотрим текущие зарплаты по основным ИТ-специализациям, языкам программирования и компаниям, но также увидим полугодовую динамику некоторых из них.
Читать дальше →

Использование memcached и Redis в высоконагруженных проектах

Время на прочтение14 мин
Охват и читатели110K


Вячеслав Москаленко (Ленвендо)


Я буду рассказывать вам об инструментах высоконагруженных проектов, кэшировании, в частности, о memcached, Redis-е и о сервисе очередей RabbitMQ или в простонародье «кролике».

В первой части доклада я расскажу о том, что такое memcached — базовые понятия, что такое Redis, о его особенностях, и чем эти два сервиса отличаются. Расскажу о практическом применении в наших проектах обоих сервисов.

А во второй части я буду рассказывать о брокере сообщений RabbitMQ, об основных понятиях, которые есть в «кролике», о том, как работает маршрутизация сообщений между продюсерами и консьюмерами. Также расскажу о практическом применении в наших проектах данного брокера сообщений.

О кэшировании. Думаю, многие из вас хоть что-то кэшировали в своих веб-проектах, поэтому все будет очень просто и доступно.

Шпаргалка по Redis

Время на прочтение8 мин
Охват и читатели462K
Про Redis (официальный сайт, материалы на Хабре) написано много, но мне до сего дня не хватало материала, который послужил бы шпаргалкой по его практическому использованию, а так же справочником по базовым теоретическим моментам. Постараюсь заполнить этот пробел в богатой базе знаний Хабра.

Я поставил перед собой цель показать возможности Redis с помощью примеров кода. После публикации приму любые предложения по улучшению материала.

Здесь используется общение с сервером через консольный клиент, но, основываясь на приведенных примерах, можно легко найти реализацию этих примеров в клиентских библиотеках на вашем любимом языке.

Ключи


Redis — хранилище данных в формате «ключ-значение». Факты о ключах:
  • Ключи в Redis — бинарно-безопасные (binary safe) строки.
  • Слишком длинные ключи — плохая идея, не только из-за занимаемой памяти, но так же и в связи с увеличением времени поиска определенного ключа в множестве в связи с дорогостоящим сравнением.
  • Хорошая идея — придерживаться схемы при построении ключей: «object-type:id:field».


Типы данных Redis


  • Строки (strings). Базовый тип данных Redis. Строки в Redis бинарно-безопасны, могут использоваться так же как числа, ограничены размером 512 Мб.
  • Списки (lists). Классические списки строк, упорядоченные в порядке вставки, которая возможна как со стороны головы, так и со стороны хвоста списка. Максимальное количество элементов — 232 — 1.
  • Множества (sets). Множества строк в математическом понимании: не упорядочены, поддерживают операции вставки, проверки вхождения элемента, пересечения и разницы множеств. Максимальное количество элементов — 232 — 1.
  • Хеш-таблицы (hashes). Классические хеш-таблицы или ассоциативные массивы. Максимальное количество пар «ключ-значение» — 232 — 1.
  • Упорядоченные множества (sorted sets). Упорядоченное множество отличается от обычного тем, что его элементы упорядочены по особому параметру «score».

Про типы данных Redis есть отдельная хорошая статья: «Структуры данных, используемые в Redis».
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Ростов-на-Дону, Ростовская обл., Россия
Зарегистрирован
Активность