Обновить
-11
markoni@markoni

Python dev

1,2
Рейтинг
1
Подписчики
Отправить сообщение

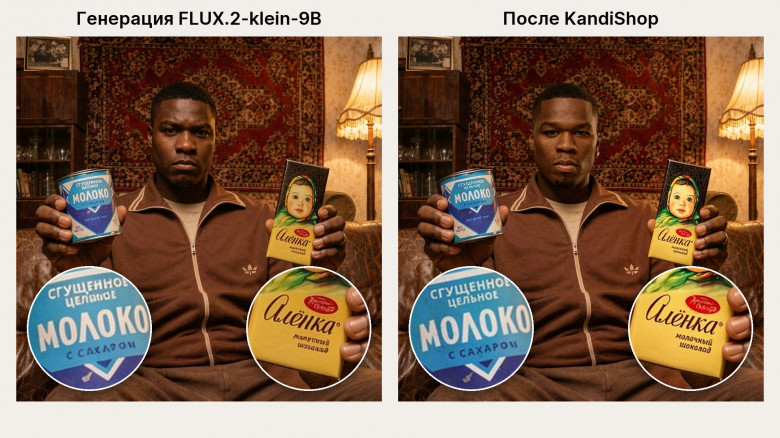
KandiShop: как за считанные секунды получить узнаваемые лица и читаемый текст на любых ИИ‑изображениях

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели7K

Современные генеративные модели уже умеют по одной фотографии поместить человека или товар в любую сцену. Но присмотритесь: лицо получилось «почти» тем, а мелкий текст на упаковке превратился в набор похожих на буквы закорючек.

На связи команды Контролируемого генеративного ИИ и Генерации видео AIRI. В этой статье мы расскажем, откуда берется эта проблема и как мы её решили с помощью нашего нового метода KandiShop — без единого шага обучения.

Читать далее

Typing в Python 3.11–3.14: что изменилось и как это использовать уже сейчас

Уровень сложностиСредний
Время чтения18 мин
Охват и читатели9.3K

За последнее время я прочитал множество репозиториев, где в Pyhton пользуются типизацией и почти везде синтаксис не новее 3.11: Optional, TypeVar на уровне модуля, Generic[T], кавычки вокруг опережающих ссылок. При этом у Python 3.10 поддержка закончилась, и разработчики языка дали нам новых удобных инструментов и чтобы ими пользоваться не всегда нужно обновляться до последней версии. В этой статье расскажу, какие основные фишки появились за последние несколько лет и как ими пользоваться даже в проектах на старых версиях.

Читать далее

Whisper без облака: локальное распознавание чувствительных записей

Уровень сложностиСредний
Время чтения16 мин
Охват и читатели15K

Представим юридическую фирму, у которой за несколько месяцев накопились сотни часов аудиозаписей. В них нужно искать фамилии, даты, показания и детали конкретных эпизодов. Пока записи существуют только в виде файлов, нужный фрагмент приходится искать почти вслепую, с ручкой и блокнотом в руках. Открывать аудио, перематывать и слушать.

Подкрадывается очевидное решение. Отправить запись в сервис расшифровки и через несколько минут получить готовый текст. Но для материалов с чувствительными данными такой сценарий подходит не всегда. Передача файла во внешнюю систему может противоречить внутренним правилам компании, а сам факт отправки означает, что появилась ещё одна копия записи, и за доступ к ней теперь отвечает кто-то другой.

Поэтому я собрал локальное решение на базе Whisper. Аудио обрабатывается на своей машине, а на выходе остаются текст и таймкоды.

В этой статье разберём, откуда взялся Whisper, как он превращает звук в текст, что умеет официальная консольная версия без дополнительных модификаций и как я применил эту технологию на практике.

Читать далее

Развитие FastAPI приложения в ходе разработки production-системы

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели11K

Полтора года назад я написал о своём подходе к структуре FastAPI-приложений. С тех пор два крупных проекта, production и несколько архитектурных граблей заставили меня многое пересмотреть. В этой статье расскажу, что изменилось и какие решения действительно упростили мне разработку.

Читать далее

Строим RAG вручную: как это работает под капотом

Время чтения10 мин
Охват и читатели11K

Имея некоторый опыт в построении классических ML и CV-проектов, я решил разобраться в NLP (Natural Language Processing) и собрать свою RAG-систему без использования сторонних RAG-фреймворков (LangChain, LlamaIndex и т.п.). Моя цель - понять, как на самом деле работает RAG под капотом: от разбиения текста до генерации ответа.

Проблема, которую решает RAG

Готовые LLM модели имеют несколько недостатков:

Читать далее

Как мы вынесли семантический поиск на обычный сервер без видеокарты, облака и выделенной поисковой системы

Время чтения9 мин
Охват и читатели6.2K

Когда мы занялись поисковым слоем AI-ассистента в «Первой Форме», договорились на входе: языковую модель, которая отвечает пользователю, не трогаем. Вся эта история — о том, что происходит на шаг раньше: как система решает, что именно показать модели, прежде чем та начнёт отвечать.

Планку себе поставили простую на словах и сложную на деле: семантический поиск промышленного уровня, но без специализированной инфраструктуры, целиком внутри изолированной сети, на том же оборудовании, что и само приложение.

Спойлер: получилось. В статье расскажу, какие решения мы принимали и что перебирали в качестве альтернатив. Но отдельно хочу выделить методику оценки: первые замеры качества нас обманули и увели в неверном направлении, и разбор того, почему так вышло, — возможно, самая полезная часть этого текста.

Читать далее

Структурированные логи в FastAPI: практический гайд от request_id до trace_id

Уровень сложностиСредний
Время чтения16 мин
Охват и читатели12K

Самая неприятная часть расследования инцидента начинается, когда нужные данные в логах вроде бы есть, но связать их между собой невозможно. Один запрос оставляет десятки строк, пользовательский контекст теряется, а события микросервисов живут каждый своей жизнью.

На примере FastAPI соберём JSON‑логирование, в котором запрос можно проследить целиком, ошибки — фильтровать по типу, а задержки — анализировать по duration_ms.

Читать далее

Сколько стоит контекст для кодового агента: grep vs граф vs LSP на большом проекте (936 прогонов)

Уровень сложностиСредний
Время чтения11 мин
Охват и читатели13K

Я взял одного и того же агента (Claude Code), менял у него ровно одну вещь — какой MCP-сервер отдаёт контекст по коду, — и гонял по 26 задачам на apache/superset. Четыре «руки»: filesystem (grep + read), graphlens (структурный граф), serena (LSP) и codegraph. Три модели (haiku / sonnet / opus), три сида — 936 прогонов.

Главный результат: вывод переворачивается в зависимости от типа задачи.

Смотреть цифры

Настройка Claude Code: спиннер-пасхалки, скрытые параметры settings.json и CLAUDE.md, о которых не пишут в документации

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели6.8K

Пока Claude Code думает, в терминале мелькают Noodling, Honking, Clauding — 56 слов-пасхалок, систему которых внутри Anthropic зовут Tengu. Но это только верхушка. Собрал всё, что можно настроить: spinnerVerbs, CLAUDE.md как память между сессиями, permissions для защиты .env, автоформатирование через хуки, LSP-навигация и три режима работы через Shift+Tab. Готовый конфиг для копипасты внутри.

Читать далее

Пробуем использовать локальные LLM для написания кода

Уровень сложностиСредний
Время чтения16 мин
Охват и читатели81K

Рассмотрим альтернативу облачным моделям — локальный запуск LLM на своём компьютере.

Этот подход даёт полный контроль над данными, но требует понимания ресурсов, форматов моделей и особенностей настройки. В статье расскажу, как выбрать модель под ваше железо, запустить её с помощью LM Studio, подключить к агентам и что из этого вышло в эксперименте. И несколько рекомендаций для тех, кто задумывается о такой возможности.

Читать далее

Как я запускал Qwen 3.5 на Mac: бенчмарк 8 локальных LLM-серверов. Кто быстрее?

Уровень сложностиСредний
Время чтения16 мин
Охват и читатели17K

Взял MacBook Pro M2 Max, 64GB, и задал простой вопрос: какой MLX-сервер реально готов держать Qwen 3.5 35B как локальный API для команды? Оказалось - серверов восемь, каждый в README обещает «blazing fast», а по факту между ними пропасть.

Написал харнесс на Python, прогнал пять итераций на восьми промтах - от AIME до 52k токенов. Single-user тройка идёт ноздря в ноздрю. Но стоит пустить два запроса параллельно - и четыре фреймворка из шести откатываются в очередь, один деградирует до 0.85×, и только один выдаёт честные 2.17×.

По дороге всплыли квадратичный attention в 2026 году, фантомные 14 000 tokens/sec из-за одной строчки в SSE-парсере и зомби-процесс на 20GB RAM, про который молчат все README. Внутри - графики, таблица «что выбрать под ваш сценарий» и репозиторий, чтобы повторить у себя.

Читать далее

20+ лучших инструментов и гайдов Anthropic по ИИ

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели16K

Все самое лучшее от Anthropic в одном месте: нейросети, промты, гайды. Подойдет предпринимателям, создателям контента, разработчикам софта и всем кто интересуется нейросетями.

Читать далее

Как я перестал бояться Claude Code и научил его не ломать мои проекты

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели24K

Знакомая ситуация: просишь Claude Code добавить авторизацию — он переписывает половину проекта. Просишь поправить одну функцию — получаешь удалённые тесты и новую зависимость, о которой не просил. За час строишь рабочий прототип, а потом три часа разгребаешь то, что Claude наворотил при «улучшении».

Я Python-бэкенд разработчик, веду свою компанию CREATMAN и кожу в основном один. У меня нет роскоши держать QA-инженера, который будет ловить регрессии после каждого промпта. Мне нужно, чтобы AI-агент помогал быстрее шипить, а не создавал новые проблемы.

После нескольких недель исследования — чтения доков, обсуждений на Reddit, разбора чужих сетапов — я собрал конфигурацию, которая реально работает. Собрал всё в открытый репозиторий с готовыми файлами: claude-code-antiregression-setup. В этой статье — что именно и почему.

Читать далее

Локальная LLM для кодинга за 12 минут: LM Studio, Kilo Code и четыре бесплатных облачных варианта

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели77K

Показываю, как запустить локальную LLM и подключить её к IDE за 15 минут, а также четыре бесплатных облачных альтернативы.

Локальный вариант: LM Studio + Qwen3-Coder + Kilo Code. Работает офлайн, без подписки и лимитов на запросы.

Облачные варианты: Kilo Code со своими бесплатными моделями, Qwen Code с 1 000 запросов в день, OpenCode с ротируемыми open source free моделями и OpenAI Codex — пока бесплатный для Free-аккаунтов.

Читать далее

Про IT в 2025 году

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели134K

Сегодня хочу поделиться своим видением текущей ситуации в ИТ. О ней только ленивый сейчас не говорит, вставлю и я свои 5 копеек. Пишу изнутри (в ИТ с 2003 года) — это добавит контекст к моим наблюдениям.

Если вы работаете в ИТ или думаете туда пойти (а может, даже отдать туда своих детей), в этой статье разберём, что сейчас происходит на рынке, и как это отразится на зарплатах, требованиях и шансах устроиться на работу.

Будет про раздутые зарплаты, про качество работы, про гордость за факапы, про фейковые резюме, про техническую поддержку и про смузи, конечно.

Дальше — больше

Полная домашняя автоматизация в новостройке. Продолжение

Время чтения9 мин
Охват и читатели96K
Неожиданно статья про мой опыт автоматизации однокомнатной квартиры площадью 41 кв. м. в новостройке, опубликованная две недели назад, стала популярна и на 10 марта её добавил в закладки 781 image человек, просмотрели 123 921 раз и Хабр даже запилил рекламный блок в разделе «Рекомендуем» с пометкой «Интересно».
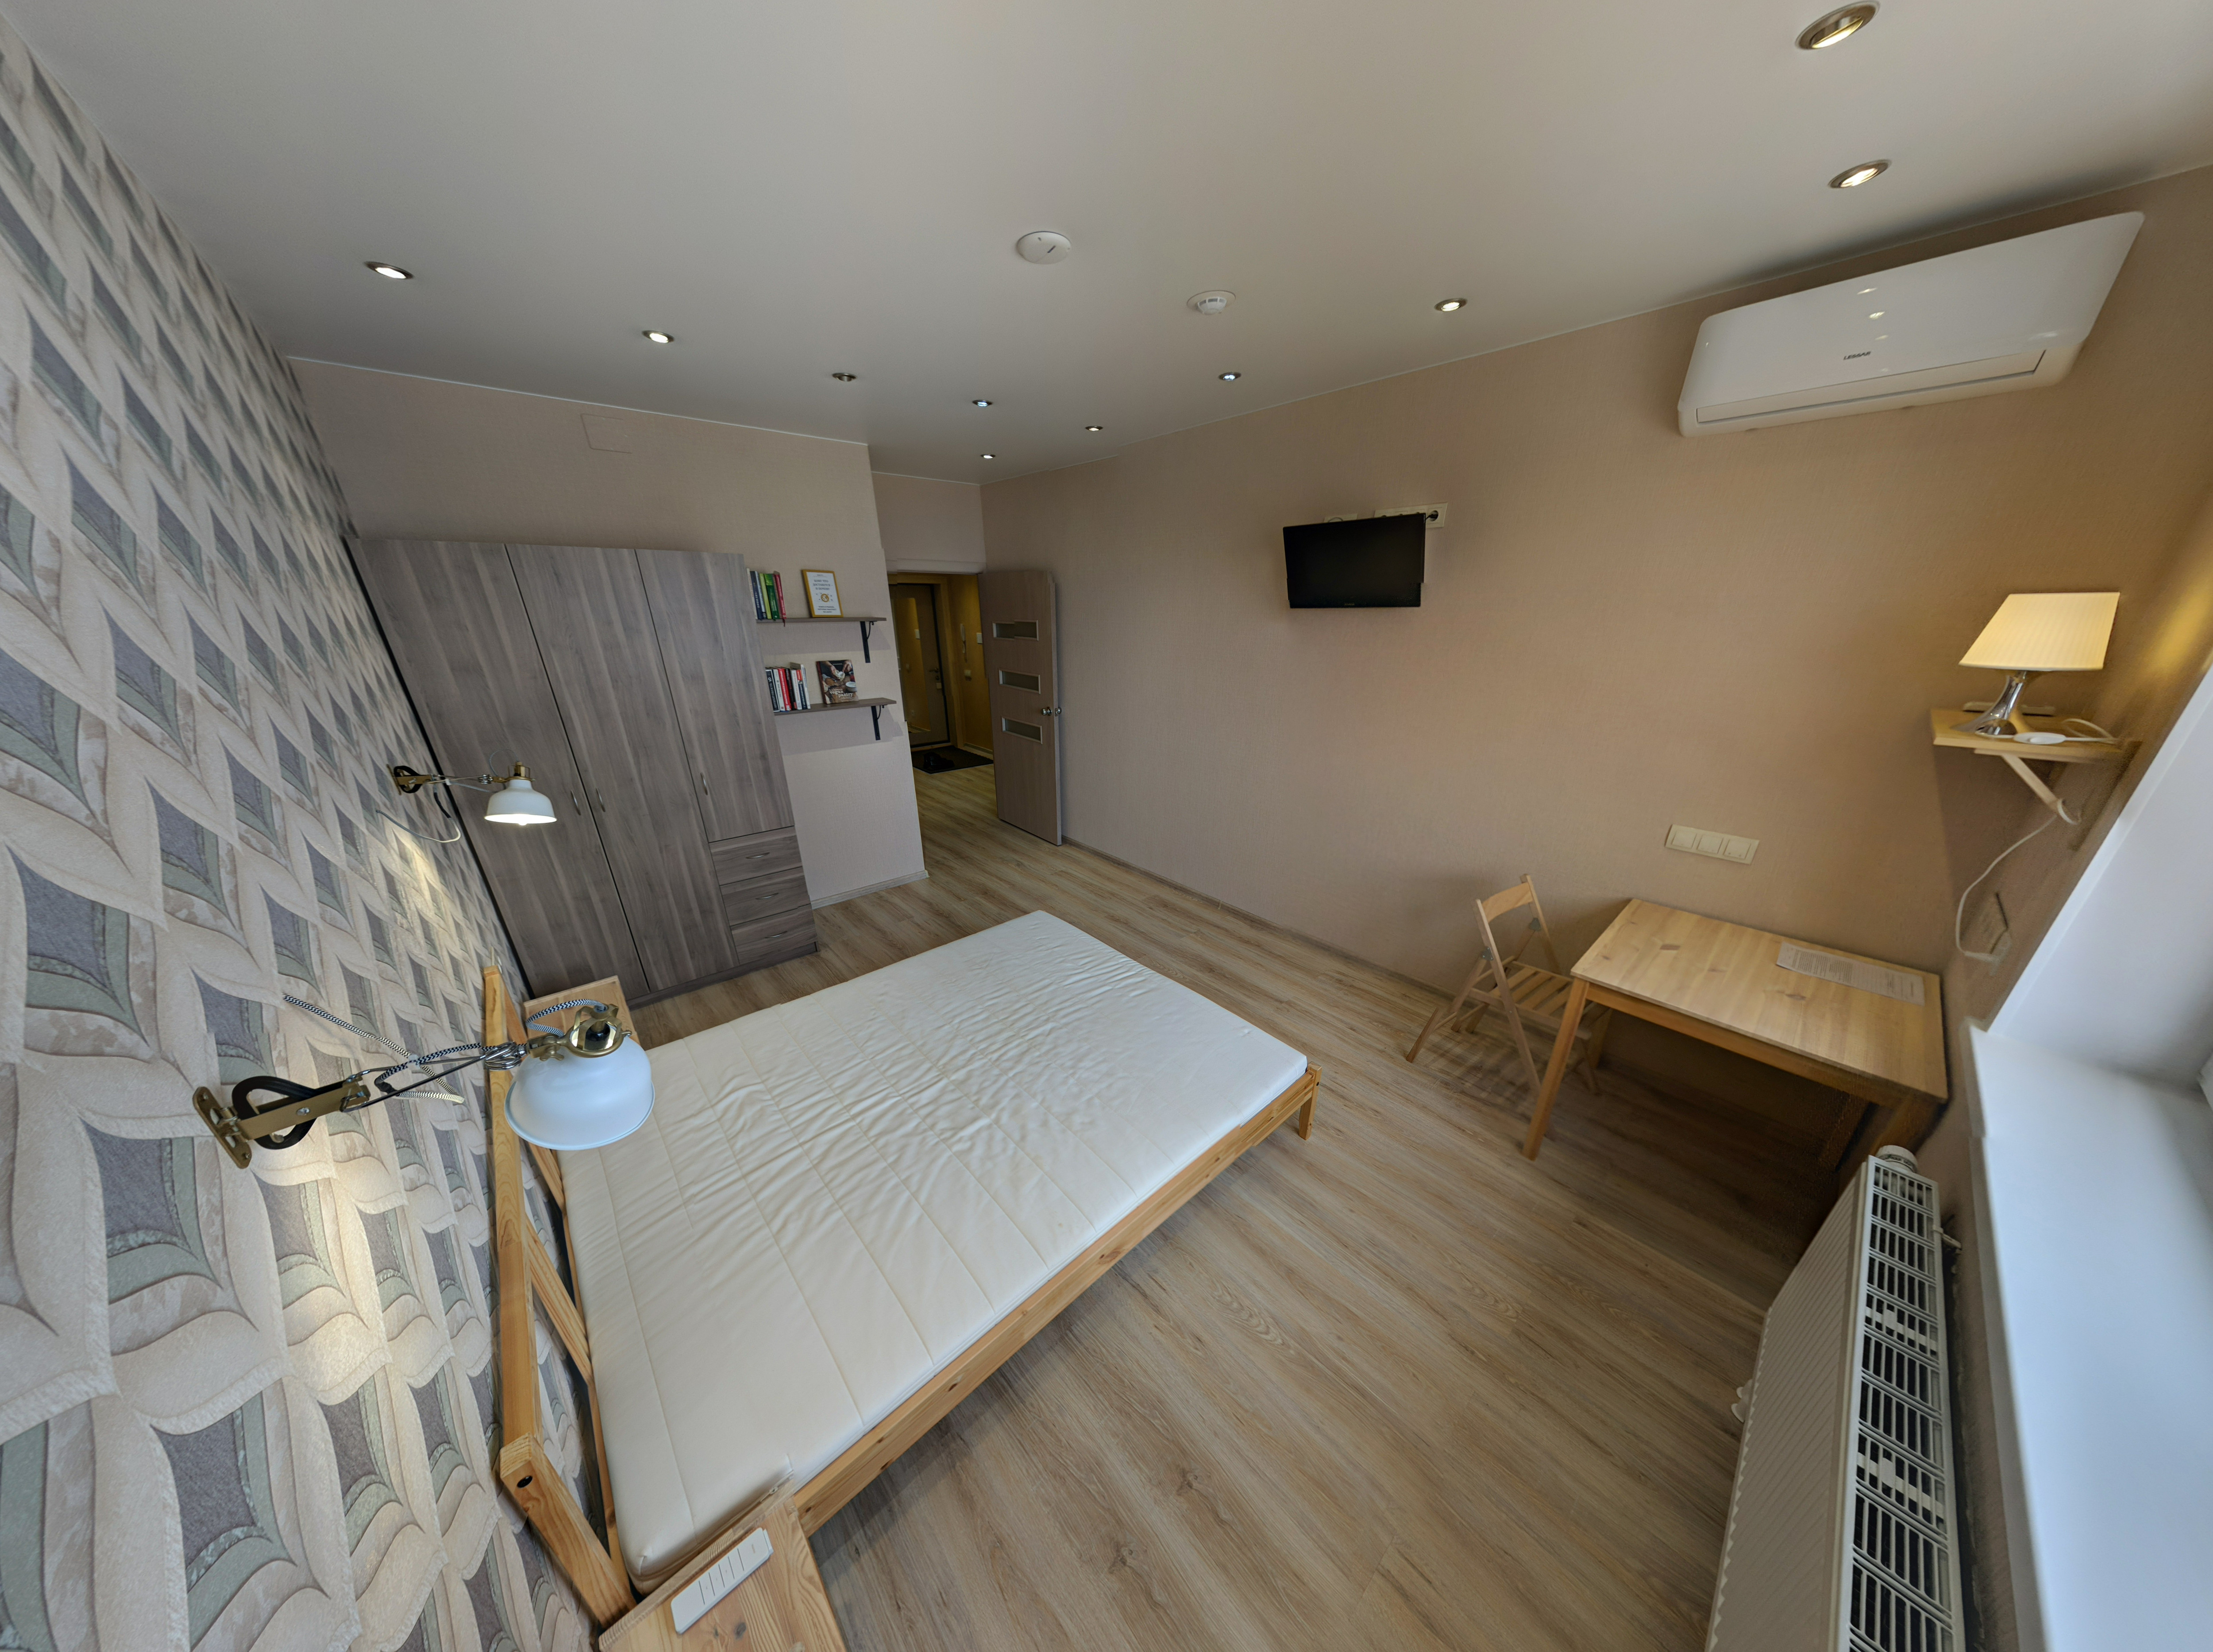

1500 метров проложенных кабелей после окончания ремонта не видны. На фото спальня

Перед вами продолжение истории, где я отвечу на комментарии, приведу фотографии квартиры с мебелью, получившиеся электрические щиты, а также расскажу о тех сложностях, с которыми я столкнулся после того, как перешёл c openHAB в другую систему домашней автоматизации — Home Assistant.
Самая умная однушка ...

Информация

В рейтинге
1 727-й
Откуда
Bialystok, Польша
Зарегистрирован
Активность

Специализация

Бэкенд разработчик, Разработчик мобильных приложений
Ведущий
От 7 000 $
Python
Linux
SQL
Git
Django
RESTful API
MongoDB
FastAPI