
Быть тим-лидом: ожидания и реальность
7 мин

Выводы о том, какого тим-лида ценит и команда, и клиент. Баланс качества и сроков, прогноз рисков и список задач, который поможет вам не стать мелким тираном <3

Пользователь
Выводы о том, какого тим-лида ценит и команда, и клиент. Баланс качества и сроков, прогноз рисков и список задач, который поможет вам не стать мелким тираном <3

В России не любят Линукс. Студенты и корпорации всячески отлынивают его использовать, даже если Линукс насаждают преподаватели или госзаказчики. Но есть область, в которой Линукс придется полюбить. Это разработка микросхем. Даже внутри Apple и Microsoft инженеры используют Synopsys Design Compiler / IC Compiler и Cadence Genus / Innovus, у которых вообще нет версий для Windows и MacOS, только для Linux. Да, я знаю, что Synopsys и Cadence ушли из России. Но даже открытые тулы для синтеза ASIC - Open Lane - есть только под Linux.
Я уже несколько лет использую для семинаров по FPGA загружаемые через USB SSD диски, на который ставится весь необходимый софтвер. Такое решение позволяет избежать агонии первого дня семинара, когда приходит куча народу со своими ноутбуками, три часа ставят Quartus, а потом мучаются с драйверами USB Blaster для китайского контрафактного клона, который без танцев с бубном не хотят поддерживать не Win10, ни Linux, ни особенно Win11, который хочет подписанные драйверы.
А как же виртуальные машины? - спросите вы. С моей точки зрения они вносят дополнительный уровень танцев с бубном. И это не мое дремучее мнение - так же считает мой приятель, который работал над виртуализацией в Микрософте. То оно USB порт не пробивает, то еще какие-нибудь глюки. Плюс учить дополнительные опции, качать и копировать файлы в десятки гигабайт. А тут вставил в USB порт, и если загрузится, то заработает.
Конечно, загружаемые SSD тоже не без проблем: тут и Legacy BIOS boot против UEFI boot, и Secure Boot с Bit Locker, и зловещий "хвост GPT", и отрубание всего из-за скачка напряжения в USB хабе - но с этими проблемами мы методично разобрались. Решение я и описываю в этой заметке, предназначенной в первую очередь для учеников и руководителей кластеров в Школе Синтеза Цифровых Схем, которая начинается с сентября в 14 российских городах (объявления и точных дат еще нет, но уже записалось 200 учеников).
Прежде всего: как выглядит загружаемый SSD? А вот так:

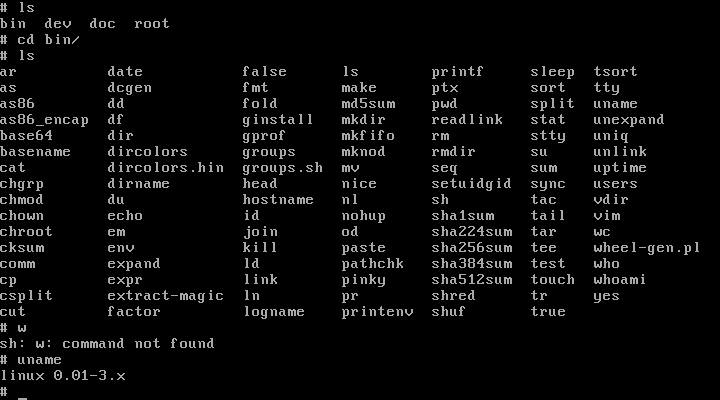
Ядро Linux часто упоминают как ужасно масштабное опенсорсное ПО. На момент написания этой статьи последняя версия 6.5-rc5 состоит из 36 миллионов строк кода. Не нужно говорить, что Linux — это плод упорного многолетнего труда множества участников проекта.
Однако первая версия Linux, v0.01, была довольно маленькой. Она состояла всего из 10239 строк кода. Если исключить комментарии и пустые строки, то остаётся всего 8670 строк. Это достаточно малый объём для анализа и хорошее начало для изучения внутренностей ядер UNIX-подобных операционных систем.
Я получил удовольствие от чтения кода v0.01. Это походило на посещение Музея компьютерной истории в Маунтин-Вью — я наконец-то убедился, что легенды верны! Я написал эту статью, чтобы поделиться с вами этим восхитительным опытом.


Часто определение разницы между select_related и prefetch_related звучит как “первый для ForeignKey полей, второй для ManyToMany”, однако это описание не раскрывает суть работы этих методов. Ниже я попробовал на примерах показать разницу между этими методами и какое влияние они оказывают на сгенерированный SQL для получения данных.
TLDR: Статья будет в первую очередь полезна тем кто начинает свое знакомство с Django, а также тем, кто использует select_related/prefetch_related в ежедневной работе, но не углублялся в глубь Django.


? Upd. Добавили пример запуска в Colab'е.
Друзья, свершилось. Сегодня мы рады сообщить вам о релизе в открытый доступ нейросетевой модели, которая лежит в основе сервиса GigaChat.
Про то, что такое GigaChat и как мы его обучаем, вы можете прочитать в нашей предыдущей статье. Скажу лишь, что главной его частью, ядром, порождающим креативный ответ на ваш запрос, является языковая модель обученная на огромном количестве разнообразных текстов — сотен тысяч книг, статей, программного кода и т.д. Эта часть (pretrain) затем дообучается на инструкциях, чтобы лучше соответствовать заданной форме ответа. Обучение такого претрейна занимает около 99% от всего цикла обучения и требует значительного количества ресурсов, которыми обычно обладают только крупные компании.
Этот претрейн, названный ruGPT-3.5, мы выкладываем на Hugging Face под лицензией MIT, которая является открытой и позволяет использовать модель в коммерческих целях. Поговорим о модели подробнее.


Добрый день уважаемый читатель, первым делом хотел бы поблагодарить родных и близких а так-же кошку, за проявленное терпение и т. д. шутка.
это моя первая статья, надеюсь не последняя - думаю станет ясно после появления первых комментариев - надеюсь я не как Джерри из "Рик и Морти", впереди есть еще идеи. В этой же статье хочу описать свой путь пройденный для некоторого погружения в изучение и последующего проведения испытаний с нейронными сетями вроде ChatGPT. Явно описывать как из России сейчас подключиться к Канаде с использованием заветных трех букв и тому подобные телодвижения смысла не вижу, так как вероятно следующие за прогрессом уже давно все это перепробовали, и убедились что да, ChatGPT ответит на ваши заветные вопросы ответом типа: я лишь реализация нейронной сети созданная для возможностей развития, и тому подобное, а позже и облегченно выдохнули, мол время еще есть не такой умный уж код она и пишет, за работу можно(или нет?) не переживать... Этой статьей я хотел сократить или перенаправить на большую продуктивность время соискателя знаний в этом направлении.

Первая статья на Хабре, будь она от компании или пользователя, — фактически визитная карточка, которая либо даст хороший старт и мотивирует писать больше и интереснее, либо отобьёт руки. Опыт показывает, что авторы в своих первых публикациях совершают одни и те же ошибки, которые смазывают впечатление и сказываются на отношении аудитории. Известно, что лучше предотвратить ошибку, чем исправлять её после совершения, поэтому решено: в этой статье разберём все типичные ошибки и будем давать на неё ссылку новичкам.

В поисковых системах ежедневно растет количество запросов, что такое нейросеть (далее — НС). Прежде всего это связано с растущим интересом к технологиям на базе искусственного интеллекта (далее — ИИ). Многие из нас даже не подозревают, что мы практически ежедневно используем модели глубокого обучения. Запросы Siri или взаимодействие с чат-ботами в мессенджерах — один из ярких примеров использования НС.
Мало кто из нас знает, что нейронки существуют уже 80 лет. Первая НС была представлена в 1943 году Уорреном Маккалоу и Уолтером Питтсом. В ее основе лежала пороговая логика для построения вычислительных моделей. Но с годами подходы к реализации нейронных сетей изменились, как и технологии, которые используются для их разработки. Углубимся в основы НС и разберемся с ключевыми вопросами.


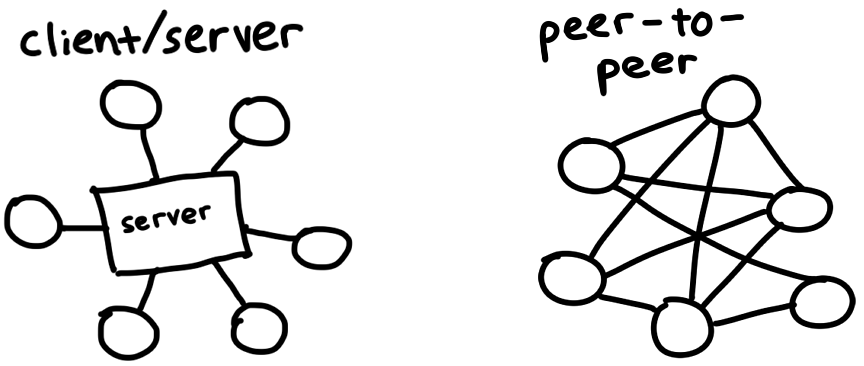
BitTorrent — протокол загрузки и распространения файлов через Интернет. В отличие от традиционных отношений клиент/сервер, когда загрузчики подключаются к центральному серверу (например, для просмотра фильма на Netflix или загрузки веб-страницы), участники сети BitTorrent, называемые одноранговыми узлами, загружают фрагменты файлов друг с друга. Это то, что делает BitTorrent одноранговым протоколом. Исследуем, как он работает, и создадим собственный клиент, который сможет находить одноранговые узлы и обмениваться с ними данными.

Хотя нейронные сети стали использоваться для синтеза речи не так давно (например), они уже успели обогнать классические подходы и с каждым годам испытывают на себе всё новые и новый задачи.
Например, пару месяцев назад появилась реализация синтеза речи с голосовым клонированием Real-Time-Voice-Cloning. Давайте попробуем разобраться из чего она состоит и реализуем свою многоязычную (русско-английскую) фонемную модель.
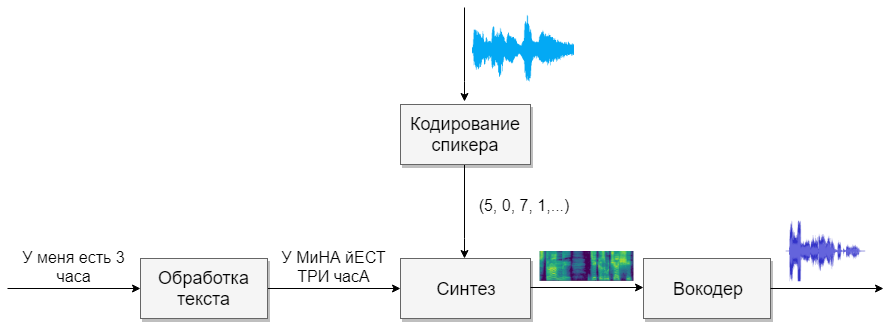
Наша модель будет состоять из четырёх нейронных сетей. Первая будет преобразовывать текст в фонемы (g2p), вторая — преобразовывать речь, которую мы хотим клонировать, в вектор признаков (чисел). Третья — будет на основе выходов первых двух синтезировать Mel спектрограммы. И, наконец, четвертая будет из спектрограмм получать звук.


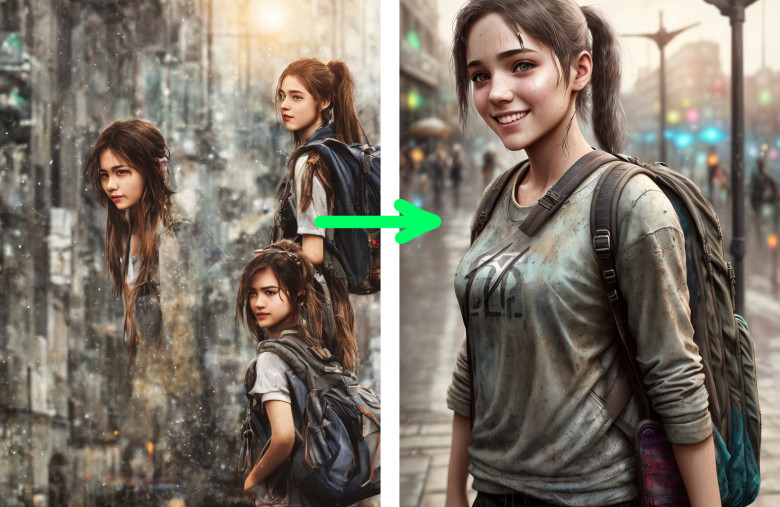
Многие слышали про Midjourney, но про то, что есть локальная Stable Diffusion, которая может даже больше, знает уже куда меньше людей, или они не знают, что она локальная. И если они пробовали её онлайн, то быстро приходили к выводу, что она сильно хуже чем Midjourney и не стоит обращать на неё более внимания. И да, SD появился раньше Midjourney. Для запуска хватит и cpu или 4гб видеопамяти.
Аналогично с chatGPT, про попытку сделать его локальную версию, не требующую супер компьютер, тоже мало кто слышал и знает, несмотря на то, что выходило несколько статей.

В интернете много информации о том, как развернуть MinIO на хосте по порту, но практически нет о том, что делать, если порт наружу открывать не хочется, а файлы загрузить надо? Потратив пару дней на разбирательство, получился вполне "рабочий велосипед". Я решил воспользоваться Законом Каннингема и разместить своё решение. Надеюсь, оно не ложное. ?


Мы сделаем чувствительный дисковый гидрофон, дополнив который предусилителем, мы сможем записывать гидроакустические сигналы в диапазоне частот примерно от 10 до 40 кГц: звуки рыб и морских млекопитающих, шумы двигателей судов и лодок и даже шум снежной метели и скрип шагов по льду, если вы захотите изучать звуки в водоемах, закованных в ледяную корку. А еще мы дадим несколько простых приемов работы со звуковым редактором, и научим видеть то, что не слышно. Все это под катом!

Думаю про VPN слышали все, и многим приходилось им пользоваться. При этом использование готового VPN, которым руководит какой - то неизвестный человек, не является хорошей идей. Тем более в России на данный момент пытаются блокировать, как сами VPN провайдеры (Windscribe, Proton и другие известные сервисы), так и сами протоколы.
