Обновить
32K+

Микросервисы *

Микросервисная архитектура и все что с ней связано

26,77
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Круг второй: шесть попыток, один ключ

Уровень сложностиСложный
Время чтения12 мин
Охват и читатели7K

Учим Zabbix не забывать историю метрик Docker Swarm. Круг второй — вскрытие базы данных Zabbix, шесть попыток заставить систему принять стабильный ключ и разгадка того, как это сработало. Внутри — логика работы шаблона и заголовок X-PortainerAgent-Target, который спас ситуацию.

Погрузиться в ад...

Основы: шардирование и репликация

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели6.2K

Всем доброго времени суток. В данной статье я хочу рассказать, чем шардирование отличается от репликации, какие задачи решает каждый подход и почему шардирование не всегда является оптимальным решением на ранних этапах. Сразу предупрежу, что информация ориентирована на человека, который хочет узнать в общем о данных подходах, если понравится мой метод рассказа, можете перейти в мой телеграмм канал: https://t.me/backend_iznutri там в скором времени расскажу более глубоко о данных подходах.

Для разберемся, что означают данные термины:

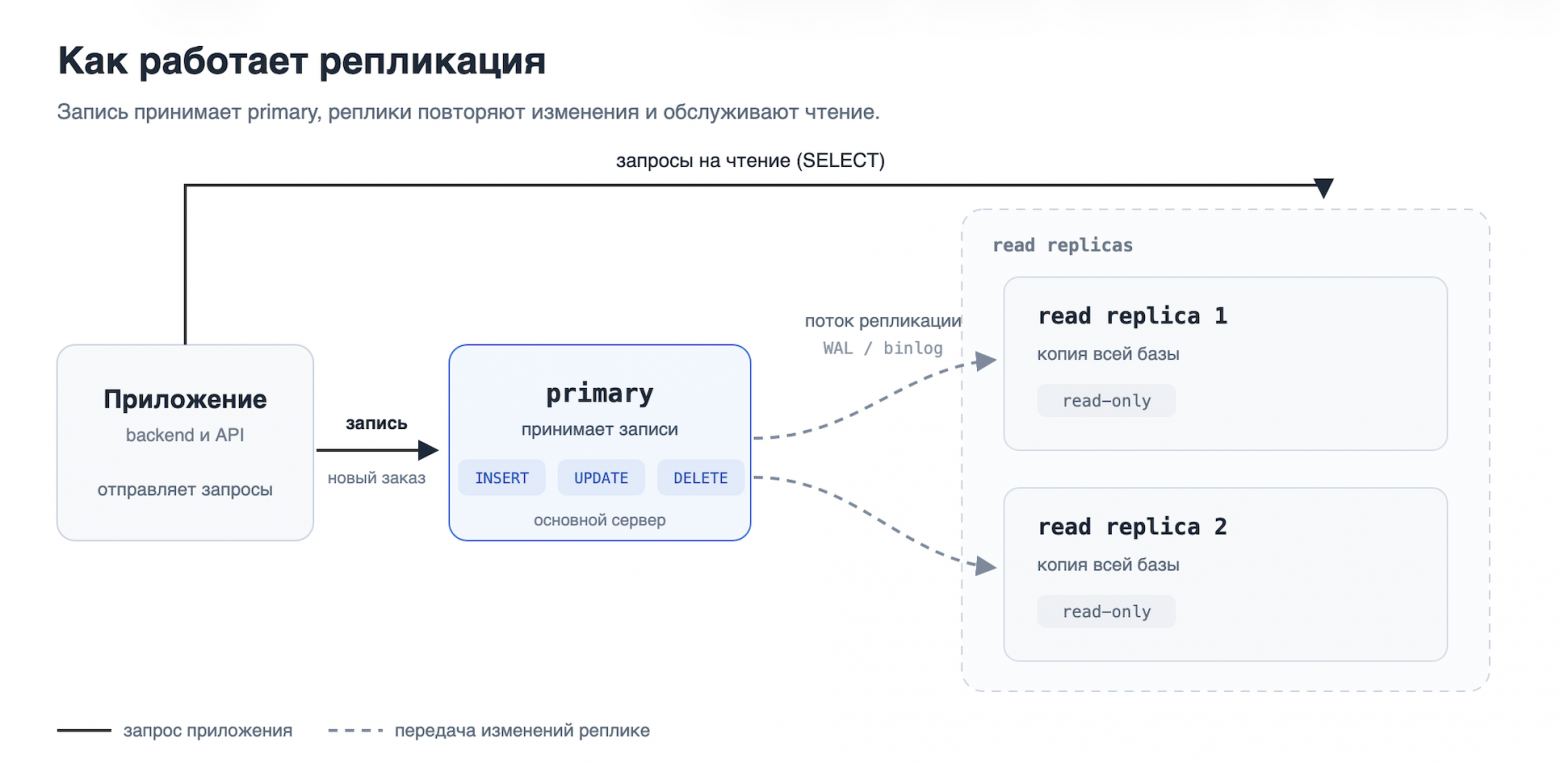
Репликация создаёт одну или несколько копий базы данных. Такие копии называют репликами. Они могут повышать доступность системы, резервировать данные и распределять нагрузку на чтение.

Шардирование не создаёт маленьких копий базы данных. Мы делим большую базу на шарды, и каждый шард хранит только часть общего набора данных.

Разницу данных подходов лучше увидеть на примере интернет‑магазина:

Читать далее

Нужно ли бэкендеру разбираться в сетях?

Время чтения1 мин
Охват и читатели9.5K

Зачем бэкендеру сети, если всё работает из коробки, а платформа сама балансирует трафик? Всё работает. До первого инцидента, который не уложится в автодашборд.

Коля Губин, Паша Агалецкий и Арсен Абдусаламов спорят, какие знания действительно нужны (необходимый минимум), а какие избыточны. Что важнее изучать: базы данных или сети?Нужно ли Таненбаума или Клеппмана?

В новом выпуске Бэкенд расправил плечи обсуждаем, как сетевые вызовы стали частью повседневной работы микросервисов, и не делают ли готовые инструменты инженеров слабее.

Смотрим по ссылкам:

VK

YouTube

А как вы думаете, нужен ли вопрос «что происходит после ввода URL» на собеседовании?

Читать далее

eShop: запилить модульный монолит. Часть 1

Уровень сложностиСредний
Время чтения34 мин
Охват и читатели6.4K

После того как я сделал доклад на DotNext, я решил получившиеся анализаторы завернуть в отдельную библиотеку. Для конвертации микросервисного приложения сделал скилл для Claude. Натравил скилл на eShop, и за три часа он свернул все микросервисы в модули.

Я посмотрел внимательно что делал ИИ и понял, что много действий по конвертации легко автоматизируются и только небольшая часть изменений требует вмешательства человека. Поэтому я создал набор инструментов, которые помогают мигрировать микросервисную архитектуру в модульный монолит.

В этой статье разберем пошагово, как с помощью инструментов FusionModules превратить eShop в модульный монолит.

Статья получилась из двух частей. В первой, этой, все сервисы переезжают в один процесс и перестают ходить друг к другу по сети. Во второй свернем четыре DbContext в один, перенесем данные в одну базу и уберем шину событий и MediatR.

Это пятая статья по мотивам моего доклада «Модульность без микросервисов в ASP.NET из коробки» на DotNext 2026

Читать далее

37 уроков для тех, кто отвечает за бэкенд: масштабирование, надёжность и архитектура сервисов

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели7.7K

Чем сложнее становится бэкенд, тем больше внимания приходится уделять производительности, архитектуре и надёжности сервисов. Даже привычные решения могут создавать проблемы под нагрузкой, а новые требования заставляют пересматривать подходы к проектированию систем.

Собрали 37 бесплатных вебинаров для бэкенд-разработчиков: от разбора узких мест в Java и проектирования микросервисов до работы с базами данных и внедрения ИИ в приложения. В программе — практические инженерные задачи, инструменты и подходы, которые можно применять в реальных проектах.

Смотреть подборку

Ретраи, которые вы добавили ради надёжности, не дают сервису подняться после сбоя

Уровень сложностиСложный
Время чтения8 мин
Охват и читатели8.8K

Сервис уже поднялся после сбоя, health‑check зелёный, но ошибки продолжают сыпаться, а нагрузка растёт: ретраи, которые должны повышать надёжность, могут удерживать систему в аварийном состоянии. На модели на Python разбираем, как таймауты, повторные запросы и очереди формируют метастабильный отказ и какие механизмы помогают разорвать этот цикл, чтобы сервис действительно восстановился.

Разобрать проблему

Круги ада Docker Swarm: нативная «святая троица» против потери истории в Zabbix. Круг первый: боль и потерянный якорь

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели9K

Статья для тех, кто мониторит Docker Swarm в Zabbix и устал от рваных графиков после каждого деплоя. Разбираю, как собрать непрерывную историю метрик через нативную святую троицу — {#STABLE.KEY}, X-PortainerAgent-Target и host/key. Внутри — рабочая схема на нативных механизмах Zabbix, инженерные хаки, грабли и готовые шаблоны с дашбордами.

Погрузиться в ад...

4 грабли в связке Laravel Echo + Kafka + микросервисы (event-driven архитектура)

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели5.1K


Разбор 4х интересных (ИМХО) инцидентов в работе связки Laravel Echo + Kafka (transactional outbox) + микросервисной event-driven архитектуры.

В этой статье, как и обещал в прошлой, речь пойдёт об инцидентах, связанных с реалтайм-составляющей проекта, над которым я работал. Надеюсь, что кто-то научится на моих ошибках.

Инциденто нумеро уно!

В чате сообщения появляются только после перезагрузки страницы, хотя цепочка
(очередь -> Kafka -> сервис -> Reverb -> слушатель) полностью зелёная. И причин в коде для подобных проблем нет. Согласитесь, неприятно. Я начал дотошно изучать, где может всё ломаться, и спустя N-ное кол-во сожжённых нервных клеток в логах nginx увидел аномально часто повторяющийся 101 Switching Protocols и иногда 502-е.

Причина оказалась достаточно простой: в location /app, где вебсокет проксируется на Reverb, не были заданы таймауты proxy_read_timeout и proxy_send_timeout. И так как nginx ждёт 60 секунд по умолчанию, а Reverb ровно раз в те же 60 секунд отправляет ping, получается гонка: nginx убивает соединение чуть раньше, чем ping доходит. Браузер переподключается, и так по кругу.

Исправилось всё достаточно просто: нужно было явно выставить таймауты, чтобы они были больше интервала ping. Выглядит это примерно так:

Читать далее

Мой опыт с Strangler Fig(положительный)

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели7.4K


Переписать систему с нуля и выкатить одним днём почти всегда плохая идея. Есть способ лучше. Он называется Strangler Fig, или по-русски «фикус-душитель». Я покажу, как он работает на практике, и расскажу про моменты, где лично у меня всё пошло не по плану.

Какую проблему вообще этот паттерн решает? В моём случае он помогает просто, структурировано, безопасно и удобно перенести систему с монолита на микросервисы без даунтайма. Также паттерн подходит для замены части системы на SaaS или, к примеру, для разбивки на модульный монолит. Но у меня речь пойдёт о переносе с монолита на микросервисы.

Какая задумка у паттерна? Всё достаточно просто: для начала мы мысленно находим самый не связанный с монолитом кусок системы (например, я для начала выделял из системы функционал чатов, т. к. это была самая новая фича на тот момент и самая небольшая по объёму), а затем потихоньку его выносим. Но при этом делаем это через фасад (или прокси, кому как удобнее) - в моём случае фасадом выступал сам монолит, который перенаправлял запросы сервису и исполнял функцию BFF.

Если быть конкретным, то принцип выглядит следующим образом.

Читать далее

Виртуальные потоки в Spring Boot Web на JDK 25: что даёт `spring.threads.virtual.enabled=true`

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели6.5K

Практическая статья на основе проекта vthreads: Spring Boot 4.1.2, JDK 25, PostgreSQL 17, Kafka 3.9. Один и тот же профиль нагрузки прогоняется дважды — с виртуальными потоками и без них — а затем профили потоков совмещаются на одном графике вместе с нагрузкой.

Репозиторий https://github.com/maxmiracle/vthreads

Содержание

1. Проблема: thread-per-request и блокирующий I/O

2. Как устроены виртуальные потоки

3. Виртуальные потоки в Spring Boot Web

4. Что именно блокируется в этом проекте

5. Схема обработки запроса

6. Методика эксперимента

7. Результаты

7.1. График VT ON

7.2. График VT OFF

7.3. Совмещённый график

8. Объяснение результатов

9. Выводы

10. Ограничения и на что обратить внимание

1. Проблема: thread-per-request и блокирующий I/O

Классическая модель Spring MVC/Tomcat — один запрос на один платформенный (OS) поток. Пока запрос ждёт ответа от базы, Kafka, HTTP-клиента или файловой системы, поток блокируется: он остаётся занятым, но ничего не делает. Пул потоков Tomcat ограничен (server.tomcat.threads.max, по умолчанию 200), поэтому при большом числе одновременных «медленных» запросов:

новые соединения ждут в очереди accept;

растёт latency;

каждый поток занимает память под стек и требует переключения контекста на уровне ОС;

увеличивать пул до тысяч потоков экономически невыгодно.

Именно поэтому долгое время для I/O-нагрузок предлагали reactive-стек (WebFlux) или асинхронные API. Виртуальные потоки (JDK 21+, в JDK 25 — стабильная и доработанная технология) позволяют сохранить привычный императивный код и при этом не держать платформенный поток на каждое ожидание.

2. Как устроены виртуальные потоки

Виртуальный поток (VT) — это поток, планируемый JVM, а не ОС. Он выполняется на небольшом пуле carrier-потоков (по умолчанию ForkJoinPool, parallelism = числу доступных процессоров). Когда виртуальный поток упирается в блокирующую операцию, поддерживаемую JDK (LockSupport.park, CompletableFuture.get, Socket I/O, Thread.sleep и т.п.), JVM размонтирует его: carrier освобождается и выполняет другие виртуальные потоки. Когда ожидание завершается, VT ставится в очередь планировщика и снова монтируется на свободный carrier.

Читать далее

Zero Trust на практике

Время чтения9 мин
Охват и читатели8.5K

Думаете, NetworkPolicy надежно закрывает ваш backend?
Мы проверили — и нашли 12 сценариев, где защита дает сбой.

От периметровой защиты к микросегментации: пошаговый разбор настройки mTLS, AuthorizationPolicy в Istio и проверки RBAC. Все с реальными логами, таблицами статусов и манифестами. Для тех, кто уже устал от теоретического Zero Trust.

Читать далее

Паттерн Scatter/Gather: как опросить несколько источников параллельно и не упереться в самого медленного

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели7K

Scatter/Gather — паттерн, который почти каждый, кто проектировал интеграцию с несколькими источниками, хотя бы раз рисовал. Не все знают, что у схемы есть название, и ещё меньше тех, кто помнит про побочный эффект: чем больше источников опрашиваешь параллельно, тем сильнее система зависит от самого медленного из них.

Я системный аналитик, проектирую интеграции в корпоративном сегменте. В этой статье разберу главу про Scatter/Gather из книги Брендана Бёрнса «Распределённые системы. Паттерны проектирования» и покажу, что это за паттерн и как он работает в интеграциях, где источники данных чаще всего чужие.

Что будет в статье:

Читать далее

Почему не сохранялись навыки учеников, хотя код был готов. Три ошибки при передаче данных между сервисами

Уровень сложностиСредний
Время чтения4 мин
Охват и читатели7.9K

В StudyNinja каждая задача знает, какой навык она тренирует. Платформа была готова принимать этот навык и учитывать его везде, где нужно. А потом мы заглянули в данные и увидели, что поле с навыком пустое во всех 1782 попытках учеников на тестовом стенде.

Причин нашлось три, и каждой хватило бы одной. Запрос к графу знаний проходил через навык, но не мог вернуть его наружу. Граф отдавал пустую строку вместо честного «значения нет». А платформа искала навык не в том месте ответа, где он лежал. Когда починили все три, всплыло четвёртое звено.

Самое неприятное в другом. Ничего не падало и не ругалось. Всё, что опиралось на навыки, тихо считалось по темам и выглядело исправным.

Полный разбор с кодом и чек-листом для тех, кто строит похожие системы

Читать далее

Ближайшие события

Монолит, модульный монолит и микросервисы: практическое сравнение для.NET

Уровень сложностиПростой
Время чтения10 мин
Охват и читатели12K

Разработчики редко выбирают архитектуру в вакууме. Обычно мы сталкиваемся с разными подходами поэтапно: классические монолиты попадаются в легаси-проектах или на старте новых продуктов, микросервисы появляются, когда компания хочет независимо масштабировать команды, а к модульному монолиту приходят, когда бизнес понимает, что распределённые системы тянут за собой слишком дорогие расходы на поддержку.

Каждый новый подход часто подают как очевидную замену предыдущему. Но на практике это просто разные точки на шкале компромиссов между простотой эксплуатации и жёсткой изоляцией кода.

В этой статье мы сравним классический монолит, модульный монолит и микросервисы по ключевым инженерным критериям, разберём конкретные библиотеки .NET для каждого варианта и определим понятные правила, как выбрать подходящую архитектуру под задачу.

Читать далее

Отказоустойчивость Kubernetes-кластера: практика тестирования

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели7.8K

Про отказоустойчивость распределенных систем обычно говорят на уровне архитектурных схем: несколько реплик, несколько серверов, резервное хранилище, Kubernetes-кластер. На схеме все выглядит убедительно. Но у инженеров возникает более практичный вопрос: Что произойдет, если прямо сейчас взять и выключить часть инфраструктуры? Именно это мы и проверяем.

Читать далее

Удобно всем, идеально никому: кому не нужна платформа поверх брокера сообщений

Время чтения17 мин
Охват и читатели6.5K

Привет, Хабр!

На связи команда «Диасофт». У нас в линейке есть оба слоя, о которых пойдет речь в названии: брокер сообщений Digital Q.MessageBroker на базе Kafka и интеграционная платформа Digital Q.Integration, внутри которой этот брокер работает. Так что в этой теме мы не сторонние наблюдатели.

Cпор на самом деле идет не о Kafka и не о брокерах в целом. Он идет о слое вокруг них: писать его самим или покупать готовый. И в формулировке «у нас есть сильная команда, мы все сделаем сами» обычно скрываются три важных условия: команда действительно есть, она компетентна и у нее есть опыт не только разработки интеграций, но и их многолетней эксплуатации.

Если выполняются все три условия, готовая платформа действительно может оказаться лишней. Если нет хотя бы одного, собственный интеграционный слой довольно быстро начинает обходиться дороже, чем казалось в начале. Именно об этом и пойдет речь - в том числе о случаях, когда вендорская платформа честно проигрывает самописному решению.

Читать далее

SilentJSON: не просто быстрый JSON-парсер для Go

Уровень сложностиСложный
Время чтения8 мин
Охват и читатели7K

Рассказываю о релизе библиотеки SilentJSON для Go: почему дело не только в бенчмарках, а в подходе к обработке данных. Разбираем работу с RawMessage, потоковую десериализацию гигабайтных файлов и распараллеливание массивов без лишних аллокаций.

Читать далее

Агентная система для тех, кто вкатывается: собираем агента поддержки от одного файла до Temporal, саги и circuit breaker

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели10K

Тысяча классификаций обращений стоит $0,23 на Claude Haiku 5.5 и $4,50 на Sonnet 5.5. Почти двадцать раз, и это не самое дорогое место в системе, где агент поддержки возвращает клиентам деньги. Дороже выходят возврат, проведённый дважды после падения воркера, сто воркеров, которые долбят упавшего провайдера модели, и крупная сумма, ушедшая без человека.

Собираем такую систему по шагам, начиная с агента в одном файле. На каждом шаге упираемся в проблему и добавляем компонент: API и базу, Temporal с его собственной базой, LLM-шлюз с circuit breaker, сагу с точкой невозврата и консоль оператора, роутер, который отдаёт агенту только спорные случаи, трейсы и outbox. Схема растёт вместе с текстом по C4, от Context до Component. В конце чек-лист из 11 пунктов: какой компонент добавлять при какой боли.

Где ставить circuit breaker

Как ломается модульный монолит и как с этим бороться

Уровень сложностиСложный
Время чтения24 мин
Охват и читатели5.7K

В микросервисах логические границы удерживаются границами процесса и хранилища. Для пересечения надо явно написать удаленный вызов, сделать контракт и обновить как минимум два сервиса. В монолите нет механизма контроля логических границ. Одна часть кода в любой момент может сослаться на другую, сборка и тесты это пропустят. Даже в рантайме может может все работать без ошибок. Но таких ссылок станет много и монолит превратится в big-ball-of-mud.

Эти же явные границы микросервисов помогают настраивать деплой. Структура сервисов и их зависимости видны в коде (не всегда очевидно, но всегда явно) и “случайно” их нарушить сложно. В модульном монолите структура деплоя не отражена вообще.

В прошлой статье я описал как сделать контроль зависимостей между модулями в рантайме, но хотелось бы раньше. Закончил статью списком поломок, которые не замечают ни сборка, ни локальная отладка.

В этой статье я покажу как превратить ошибки нарушения границ и деплоя в ошибки компиляции и красные тесты.

Читать далее

Микросервисы становятся дорогими: как понять, что вашему проекту пока нужен монолит

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели6K

Микросервисная архитектура обещает независимые релизы и гибкое масштабирование, но вместе с ними приносит сетевые задержки, инфраструктурные расходы и дополнительную нагрузку на команду. Если границы домена ещё меняются, а разработчики пока могут работать в одном релизном цикле, декомпозиция рискует превратиться в дорогой распределённый монолит.

Разберём, по каким критериям выбирать между монолитом, модульным монолитом и микросервисами, какие скрытые издержки учитывать и в какой момент переход действительно оправдан.

Разобраться в архитектуре
1
23 ...