Обновить
512K+

Python *

Высокоуровневый язык программирования

452,05
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Век поиска кратчайшего решения задачи о кратчайшем пути
Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели15K

TL;DR Очень подробный разбор алгоритмов решения задачи о кратчайшем пути от классики до двунаправленного А* и ALT с кодом и примерами на OSM

Люди пытались найти более быстрые способы передвижения на протяжении всей своей истории. Появление качественной дорожной системы в римской империи в своё время привело к её расцвету, но со временем выяснилось, что и в продуманных дорожных системах бывают забавные изъяны, как например в небезызвестной задаче о кёнигсбергских мостах, считающейся отправной точкой возникновения теории графов. Неудивительно и то, что с развитием вычислительной техники логистические задачи стали одними из первых, над которыми трудились первопроходцы компьютерных наук. Задача о кратчайшем пути -- одна из них, звучит достаточно просто: есть несколько городов и дорог, соединяющих пару городов между собой, мы хотим попасть из города А в город Б пройдя при этом минимальное расстояние. Первый системный подход к этой задаче был описан в работе Эгервари в 1931г., спустя 25 лет Эдсгер Дейкстра придумал алгоритм, который сейчас является частью любого уважающего себя базового курса алгоритмов на графах. На нём же, будем честны, заканчиваются знания о кратчайших путях у большинства профессиональных разработчиков, ибо сценариев, где реализации с википедии/stackoverflow будет не хватать, крайне мало.

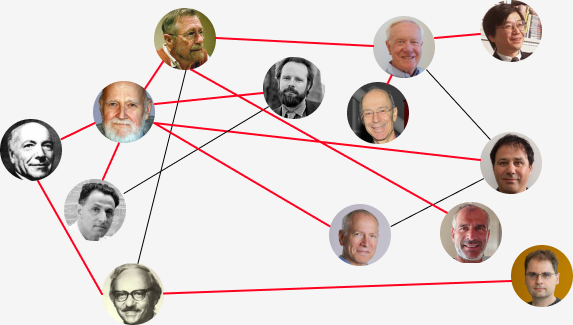
Может показаться, что на самом деле просто не было существенного прогресса с 60х годов, так как Дейкстра предоставил почти асимптотически оптимальный алгоритм решения задачи. На самом деле нет, прогресс был и придумали много чего интересного, хоть и действительно с того времени фокус сместился на другие задачи. Приглашаю под кат если интересно узнать что такого напридумывали, что используется в современных логистических системах, почему меня огорчает отсутствие учёта флага единства в HOMM3 при расчёте пути, ну и наконец, что за мужики на картинке выше рядом с Дейкстрой?

Читать далее

Мега-Учебник Flask Глава 7: Обработка ошибок (издание 2024)

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели12K

Это седьмая часть серии мега-учебника Flask, в которой я собираюсь рассказать вам, как выполнять обработку ошибок в приложении Flask.

Начать изучение

Data сontract: давайте попробуем договориться

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели14K

В последнее время всё чаще и чаще натыкаюсь на термин data contract. И чтобы не отставать от трендов на рынке data engineering, решил изучить эту тему и рассмотреть тенденции. Постараемся понять, с чем его кушать и стоит ли кушать вовсе.

Читать далее

На практике пробуем KAN – принципиально новую архитектуру нейросетей

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели48K

На днях ученые из MIT показали альтернативу многослойному перцептрону (MLP). MLP с самого момента изобретения глубокого обучения лежит в основе всех нейросетей, какими мы их знаем сегодня. На его идее в том числе построены большие языковые модели и системы компьютерного зрения.

Однако теперь все может измениться. В KAN (Kolmogorov-Arnold Networks) исследователи реализовали перемещение функций активации с нейронов на ребра нейросети, и такой подход показал блестящие результаты.

Читать далее

Обновлённый ЕМИСС: веб-приложение от непрограммиста

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели6.1K

Меня зовут Александр, я активно исследую экономические данные, строю регрессии, ML-модели. Данные использую разные: перекрёстные, панельные, временные.
По специфике своей работы часто пользуюсь ЕМИСС. ЕМИСС — это кладезь социально-экономических данных, но и одновременно платформа, которая может довести до головных болей и дергающегося глаза, а то и двух сразу.

Поставим себе, например, задачу выяснить, как влияет Х на У. Возьмём в качестве объектов наблюдения — регионы РФ. И тут нас будут ждать сюрпризы. Как быстро, не вырывая волосы из головы, получить две колонки данных за последний год по субъектам? Мы, конечно, можем использовать VLOOKUP/XLOOKUP в экселе и всё такое. Но нам встретятся обязательно двойняшки (тройняшки): «г. Москва» и «Город Москва столица Российской Федерации город федерального значения»; «Кемеровская область - Кузбасс» и «Кемеровская область — Кузбасс». Да, мелочи, но неприятно бороться с этими исключениями вручную.

Читать далее

ABC-XYZ анализ на Python. Управление ассортиментом и схемами поставок

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели7.4K

Управление ассортиментной матрицей и складскими запасами является нетривиальной задачей для бизнеса, требует аналитики и научного подхода к решению задачи. Одним из методов управления ассортиментом и закупками является ABC-XYZ классификация.

Рассмотрим ее реализацию на Python, поговорим об основных принципах построения и предобработке входных данных, в рамках рабочего проекта, в который мне пришлось погрузиться в одной крупной торгово-производственной компании.

Читать далее

Кратко про Uplift-моделирование

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели17K

Uplift-моделирование — это метод оценки эффекта от воздействия, который использует алгоритмы ML для предсказания изменения вероятности интересуемого события под влиянием этого воздействия. Зачастую цель Uplift заключается в выявление тех клиентов, которые с наибольшей вероятностью изменят своё поведение в желаемую сторону в ответ на предложение.

Uplift-модели считают разницу между вероятностями наступления события в обработанной и контрольной группах. С ними можно предсказать результат и определить, был ли он действительно вызван проведенной кампанией.

Читать далее

Изгиб питона: 6 взглядов на игру из 1970-х

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели11K

Один из первых практических проектов в курсах по Python-разработке в Практикуме — это классическая «Змейка». Несмотря на одинаковые стартовые условия, все студенты подходят к её решению по-разному. Рассказываем, как написать игру для портфолио уже через месяц обучения, и показываем шесть вариантов — с «отравой», сбрасыванием хвоста, а также барсуками и кошками.

Читать далее

Карты, деньги, ELK. Или как айтишник деньги считал

Время на прочтение18 мин
Охват и читатели11K

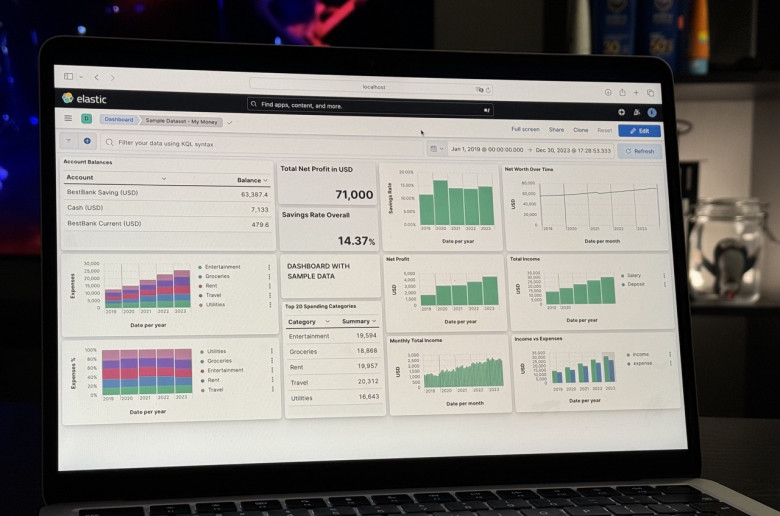
Привет, Хабр! Вот уже 7 с половиной лет я веду учет своих личных финансов в одном из многочисленных приложений. Всё это время оно неплохо закрывало базовые потребности в моменте, но с годами захотелось глубже проанализировать свою накопленную микро-бигдату и просмотреть на картину в целом. Желательно, в буквальном смысле: воспринимать информацию в виде визуализаций, диаграмм и дашбордов мне проще.

Поэксперементировав, я за несколько вечеров собрал себе решение на довольно нестандартной для таких целей платформе – Kibana. Как по мне, получилось неплохо. По горячим следам я описал этот кейс в своем англоязычном Твиттере и поделился им же в одном русскоязычном сообществе. Угадайте, откуда какой первый комментарий:

– А [зачем], собственно?
– Интересное решение! Я евангелист из Эластик – не хочешь на митапе выступить?

Выступить и правда было бы интересно. И в процессе подготовки презентации родилась эта статья. В ней я поделюсь своим опытом и подходом к личным финансам, расскажу о техническом стеке и воспроизведу по шагам процесс его трансформации. А также расскажу о том, как накопить и погасить технический долг, найти баланс, перестать беспокоиться и начать жить (но это не точно).

А зачем, собственно?

SVG-виджеты для tcl/tk. Часть I

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели6.8K

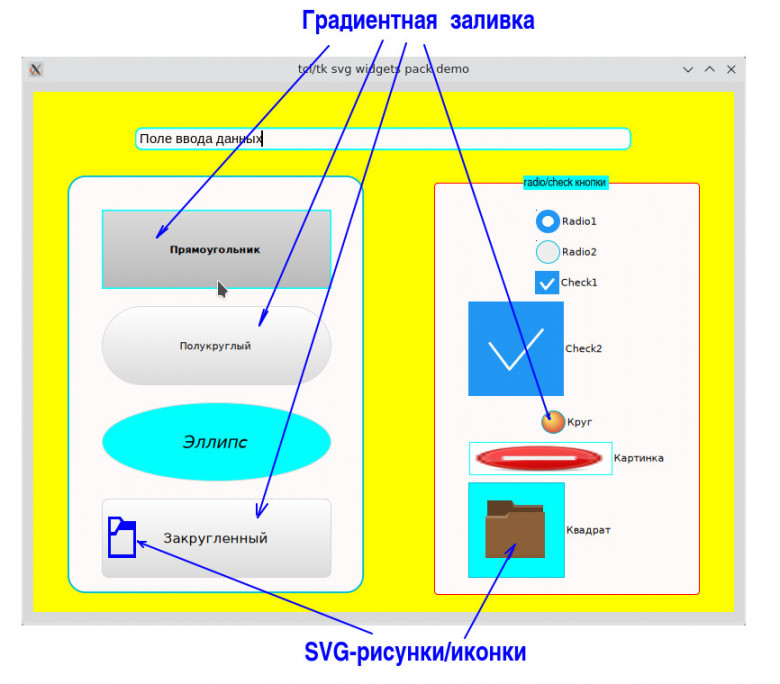
Начать статью хочу с цитаты из слов Брайана Кернигана,которую мне посчастливилось найти:

Tcl/Tk придает работе магическую продуктивность, за несколько часов можно достигнуть тех же результатов, что за дни или недели при разработке на C или C++... Tk весьма эффективен для большинства приложений, многие элементы интерфейса (виджеты) реализованы настолько хорошо, что остается только удивляться, как подобная работа могла быть выполнена так качественно... Удачным кажется и то, что разделение задач между Тсl и С/С++ осуществляется достаточно легко, надо только знать, какой инструмент лучше справляется с задачей... Расширение системы дополнительным Tcl-кодом, загружаемым напрямую в Tcl-библиотеку приложения, в полном согласии с оригинальной идеей Остераута, повышает эффективность программы, в целом, упрощает ее структуру и улучшает мобильность... Я не уверен, что Тсl мог бы выжить как самостоятельный продукт - у него слишком много конкурентов. Но у сочетания Tcl/Tk в Unix-мире нет конкурентов... Система исключительно надежна, очень хорошо документирована... свободно доступна... безукоризненно высокого качества

Читать далее

Python — Дескрипторы (Descriptors)

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели21K

Если обратиться к документации, то дескриптор — механизм, который позволяет объектам настраивать поиск, хранение и удаление атрибутов.

Дескрипторы используются в классах, выступая в роли атрибутов класса(не экземпляра).

Думаю, мало кто, хотя бы раз, сам писал дескрипторы в коммерческой разработке, но я уверен, что большинство программистов используют механизмы, которые являются дескрипторами, или используют их «под капотом».

Читать далее

Продвинутое использование форм в Django (на примере Bootstrap и crispy)

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели14K

В этой статье поговорим о существующих подходах к рендерингу веб-форм в Django.

Обсудим подходы с использованием стандартных средств Django, а также применим сторонние средства для продвинутого управления рендерингом форм на примере пакета django-crispy-forms и фронтенд библиотеки bootstrap 5.

Читать далее

Подбор гиперпараметров RAG-системы с помощью Optuna

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели12K

Сказ о том, как с помощью Opuna’ы сделать вашу RAG-систему чуточку (а может и не чуточку) эффективнее :)

Мои курсы: Разработка LLM с нуля | Алгоритмы Машинного обучения с нуля | Геопространственный анализ данных на Python

Читать далее

Ближайшие события

Погружение в метаклассы в Python

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели21K

Задумывались ли вы, почему функция isinstance(int, object) возвращает True? Объяснение, что все является объектом, которое можно часто услышать, хоть и является правдой, но не дает ответа на вопрос и на самом деле есть профанация, потому что не дает настоящего понимания, а создает только его видимость. Ведь совсем непонятно, почему int (как и любой другой стандартный класс) является непременно экземпляром базового класса. Да, он является подклассом, но почему именно экземпляром? Ответ будет дан по ходу изложения.

Читать далее

Как обнаружить и устранить мультиколлинеарность с помощью Statsmodels в Питоне

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели17K

Привет, Хабр!

Мультиколлинеарность возникает, когда в модели множественной регрессии одна из независимых переменных может быть линейно предсказана с помощью других независимых переменных с высокой степенью точности. Это явление приводит к тому, что расчетные коэффициенты регрессии становятся нестабильными и их значения могут сильно изменяться в зависимости от включения или исключения других переменных в модель.

Высокая мультиколлинеарность может привести к значительному изменению коэффициентов при незначительных изменениях в данных или спецификации модели. Это усложняет интерпретацию коэффициентов, поскольку они могут значительно изменяться от одного анализа к другому.

Когда переменные сильно коррелированы, стандартные ошибки оценок коэффициентов увеличиваются. Это ведет к увеличению p-значений, что может ошибочно привести к заключению о том, что переменные не имеют значимого влияния на зависимую переменную, хотя на самом деле это не так.

В статье рассмотрим как обнаружить и устранить мультиколлинеарность с помощью Statsmodels в Питоне.

Читать далее

LLM Leaderboard за апрель 2024

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели6.4K

Привет, Хабр!

Сегодня мы поговорим о том, какие LLM лучше всего работают на бизнес-задачах. AI-хайп находится на локальном пике, похоже, что весь мир только и делает, что внедряет AI-фичи в свои продукты, собирает миллионы на разработку еще одной оболочки для ChatGPT, заполняет свои ряды AI-тулами и, кажется, предоставляет работу роботам, пока сами попивают кофе в старбаксе. 

Читать далее

Мега-Учебник Flask Глава 6: Страница профиля и аватары (издание 2024)

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели12K

Это шестая часть серии мега-учебника Flask, в которой я собираюсь рассказать вам, как создать страницу профиля пользователя.

Начать изучение

Анализ мощности статистических критериев с использованием бакетизации

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели4.3K

В данной статье рассматривается влияние бакетизации на мощность статистических критериев в условиях различных распределений данных и при разном объеме выборки. Особое внимание уделено зависимости мощности критерия от количества бакетов и размера выборки. Исследование предоставляет важные выводы для проектирования и анализа A/B тестирования и других форм экспериментальных исследований.

Не кладём все яйца в одну корзину

Похоже, я придумал свой алгоритм поиска кратчайшего пути (upd: меня опередили...)

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели42K

Всем привет! Я реализовал, похоже, собственный алгоритм поиска кратчайшего пути с отрицательными ребрами графа.

Почему собственный? Я искал подобное решение, но не нашел, возможно, оно уже было реализовано, просто плохо поискал. Жду Нобелевскую премию =)

Додумался я до него путем модификации классического Дейкстры. Прошу адекватно отнестись к содержимому, ибо это моя первая статья, и, возможно, я ничего не придумывал и, вообще, этот алгоритм не работает вовсе (но по многочисленным тестам он работает правильно).

Читать далее

ViT для новичков: как нейросети научились определять зависимости в изображениях

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели12K

В этой статье мы попытаемся рассказать про трансформерную архитектуру VIT и предысторию его формирования. Сегодня не совсем понятно, почему этот "формат" нейронок настолько эффективен. Некоторые говорят механизм внимания, но некоторые практики делают больше ставок в области Computer Vision на MetaFormer. https://github.com/sail-sg/poolformer

Нейросети остаются для нас “теневым” процессом, подобным черному ящику. И изучение Deep Learning уже напоминает больше не математику, а биологию, где мы следим за поведением нашего детища.

Читать далее