Обновить
64K+
9
Андрей Приемко@AndrewDeveloper

Программист-практик

13
Рейтинг
14
Подписчики
Отправить сообщение

Жизнь после блокировки: нейронки изменили мою профессию и я не хочу снова работать по‑старому

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели84K

Недавние истории с блокировками от Anthropic заставили меня всерьез задуматься, как я буду работать, если и мой аккаунт отлетит в бан.

В мгновение я поймал себя на мысли, насколько сильно изменилась моя инженерная профессия. Прошло всего около года, но я уже вспоминаю прежний уклад своей деятельности, как что‑то очень далекое из прошлой жизни.

Но самое главное в другом: я осознал, что меня пугает возврат назад...

и вот почему

Статическая рефлексия в C++

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели13K

Статическая рефлексия обсуждается в грядущем C++26. Wu Yongwei демонстрирует, как применять рефлексию сейчас, и показывает примеры того, что может будет возможным в C++26.

Статическая рефлексия будет важной частью программирования времени компиляции программы на C++, как я рассказывал в октябрьском выпуске Overload. Здесь мы обсудим детально статическую рефлексию, включая, как эмулировать её прямо сейчас, до того, как она будет добавлена в Стандарт.

Читать далее

Как и зачем компании накручивают голоса на хабре

Время на прочтение9 мин
Охват и читатели23K


Так получилось, что я много лет занимаюсь консалтингом различных компаний на хабре по теме того, как надо вести блог. На данный момент консультирую несколько компаний. И вижу, что большинство блогов, которые выходят на хабр, не понимают, что это за аудитория и как с ней работать. Поэтому решил сделать серию статей о том как надо или не надо писать статьи, вести блог и что следует или не следует делать на хабре. Начать хочу с порочной практики, которыми грешат некоторые компании — это накрутка голосов.

Большинству читателей хабра даже невдомёк, что на этом ресурсе идёт настоящая корпоративная борьба за первые места в рейтинге компаний. Это престиж, имя, реклама и вообще можно почесать чувство собственной важности. Хотя в новой версии хабра, особенно мобильной, это совершенно потеряло смысл, потому что рейтинг компаний не видно.

Главная цель быть на первых местах: чтобы имя компании было узнаваемым. И в целом, если борьба идёт честной: ищут хороших авторов, приносят годный материал на ресурс и вообще стараются сделать его лучше, то это всегда идёт только на пользу читателям и хабру в целом. Но, понятно, что честными методами долго держать такой темп невозможно. Поэтому в какой-то момент начинают компании мухлевать, поднимая свой рейтинг искусственным путём.

Сегодня мы на хабре наблюдаем просто удивительную гонку накрутки рейтинга, которая выражается в том, что некоторые компании ушли в неадекватный отрыв от всех остальных компаний в списке, в гонке за право быть на первом месте.

Чем это плохо для нас, читателей: мы не получаем адекватную оценку статей на хабре, средние статьи занимают первые места, а по-настоящему качественный материал теряется за накрутками.

Сократ мне друг, но истина дороже

Поэтому расскажу вам, механизм рейтинга, и как компании его накручивают. И предложить методы борьбы с накрутками у компаний, для администрации Хабра.
Читать дальше →

Как я писал свой TCP на чистом Си: надежный протокол доставки данных поверх UDP

Уровень сложностиСложный
Время на прочтение33 мин
Охват и читатели16K

История о том, как реализовать надежный протокол поверх ненадежного UDP: скользящее окно, SACK, чексумма и почему при потерях сеть внезапно заработала быстрее

Зачем вообще писать свой RDT-протокол? Каждый джун знает, что TCP у нас «надежный, но медленный», а UDP — «быстрый, но ненадежный». Но это очень поверхностные знания, которые не раскрывают всего масштаба происходящего под капотом. И как раз недавно я задался вопросом: а почему бы не попытаться повторить TCP? Амбициозная цель: приблизить своё детище к работе TCP, поработить мир и захватить умы человечества, объединив всех в единый организм… Кхм, ну что-то типа того.

Получилось ли у меня? Захватить мир — пока нет, а вот добиться надежной доставки данных через ненадежную сеть с потерями, порчей данных, дублированием, задержками и так далее — более чем. Так что хочу рассказать свою историю о том, как я писал это чудо, с чего начинал, с какими проблемами столкнулся и как пришел к рабочему варианту протокола: с поддержкой скользящего окна, SACK, таймаутов, флагов и прочих прелестей, которые я подглядел в архитектуре TCP. Протокол прошел краш-тест с 30% потерь в сети и смог передать данные байт-в-байт, правда, с нюансами, о которых расскажу дальше :)

Читать далее

Как ускорить обработку данных. Часть 2: распараллеливание цифровых схем по зависимым операциям

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели8.9K

Привет, Хабр! Меня зовут Кирилл Алексеев, я ведущий инженер в отделе интеграции систем на кристалле радиочастотного центра YADRO. В прошлых статьях я рассказывал о процедурных и конвейерных вычислениях и распараллеливании цифровых схем по независимым операциям. Сегодня продолжим тему и разберем, как получить конвейерную реализацию КИХ-фильтра через распараллеливание схемы MAC-операции по зависимым операциям.

В статье рассмотрим простейшие способы оптимизации цифровых схем, связанные с методом распараллеливания, сравним полученные схемы между собой и со схемами из предыдущих статей. Расскажу, в каких случаях какие методы распараллеливания использовать, чтобы получить максимум производительности при минимуме аппаратного ресурса.

Статья будет полезна молодым специалистам, которые только начинают работу с ПЛИС, опытным инженерам и архитекторам вычислительных устройств: приглашаю обменяться опытом в комментариях.

Читать далее

Воскрешаем динозавров С++ в современных проектах: как применяют интрузивные контейнеры, ООП и разные стандарты языка

Время на прочтение2 мин
Охват и читатели8.2K

Библиотеку Boost.Intrusive применяют в разработке 5G-сетей, а ООП — в тестировании систем хранения данных. Не верьте стереотипам о том, что эти технологии устарели — эксперты YADRO на митапе для разработчиков на С++ доказали обратное.

А Константин Владимиров, Илья Казаков, Антон Полухин и Игорь Гусаров обсудили, какой стандарт С++ предпочитает каждый из них, чем хорош С++17 и должны ли компиляторы успевать за обновлениями в языке.

Читать далее

Руководство Google по стилю в C++. Часть 5

Время на прочтение7 мин
Охват и читатели16K
Часть 1. Вступление
…
Часть 4. Классы
Часть 5. Функции
Часть 6. Специфика Google
…


Эта статья является переводом части руководства Google по стилю в C++ на русский язык.
Исходная статья (fork на github), обновляемый перевод.
Читать дальше →

UDP без потерь и переупорядочивания

Уровень сложностиСредний
Время на прочтение23 мин
Охват и читатели7.4K

UDP ничего не обещает: датаграмма может не дойти, прийти дважды или обогнать соседнюю. Обычно в ответ берут TCP или пишут свой протокол с повторными запросами. Оба пути платят за потерю как минимум одним round trip, и платят именно тогда, когда сеть и так перегружена. В статье разобран другой вариант: отправитель заранее добавляет в поток избыточные пакеты, и получатель восстанавливает потерянное сам, ни о чём не спрашивая. Это прямая коррекция ошибок (FEC, forward error correction) кодом Рида — Соломона.

Читать далее

Вайбкодинг: что дальше?

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели32K

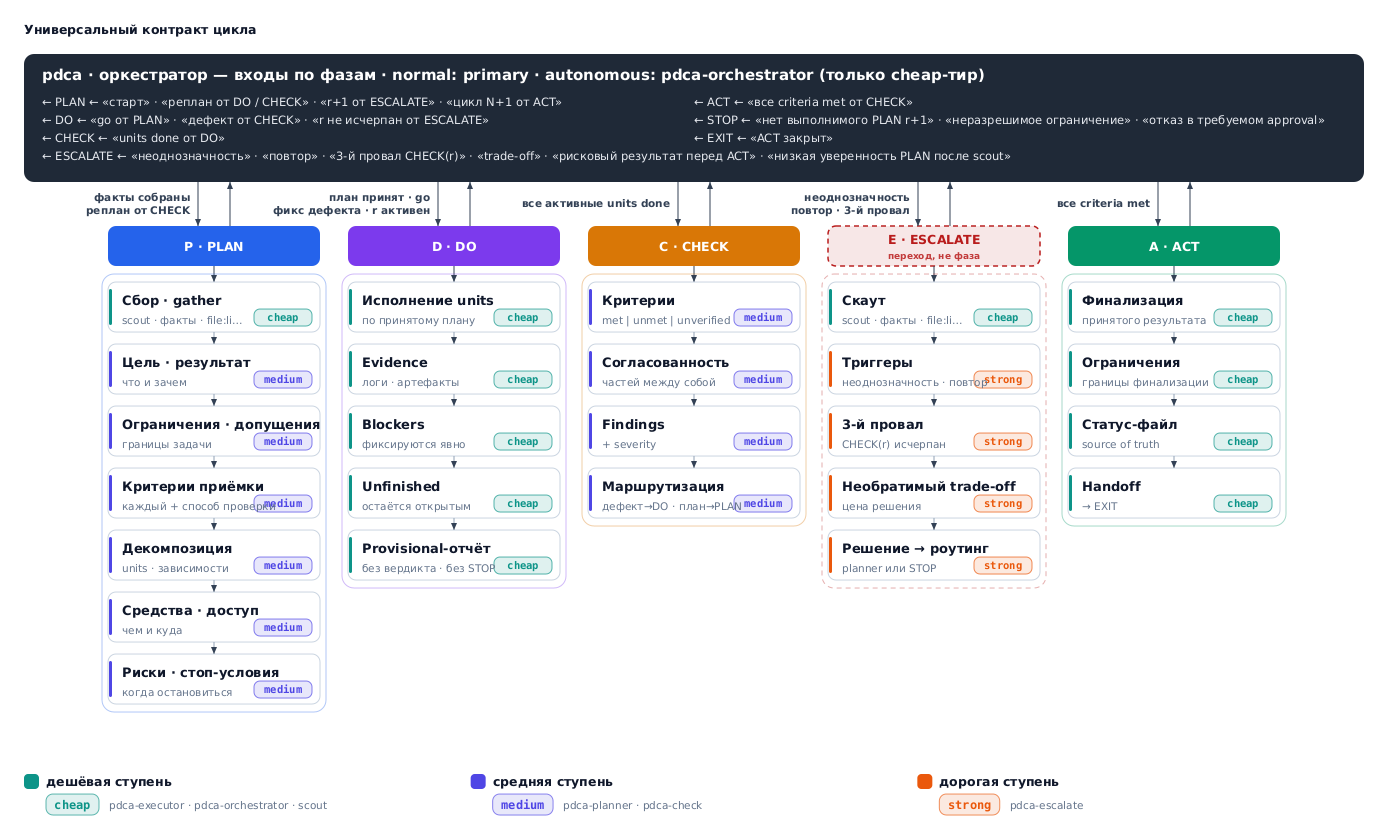
Агенты стали новой средой разработки, которая фактически заменяет существующие IDE. Новые методы разработки (вайбкодинг, промпт инженеринг, харнесс инженеринг) заменяют прежние подходы. Статья относится к агентской разработке и описывает скилл, который позволяет решать большие и сложные задачи.

Читать далее

Рецензия на книгу «Практическое руководство для архитекторов решений»

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели8.7K

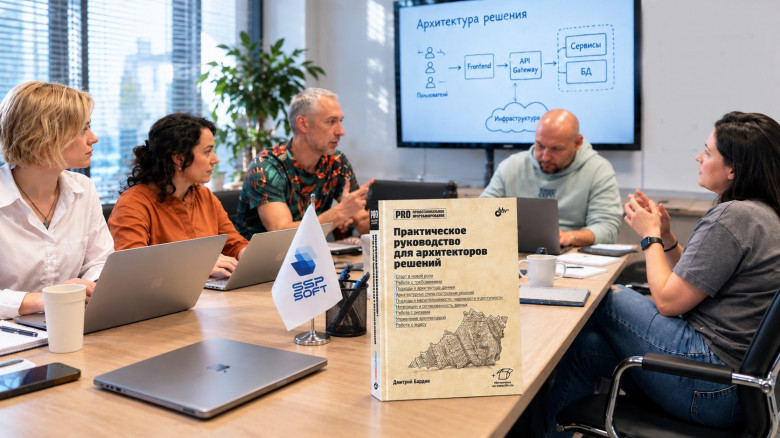
В этой рецензии продолжаем линию на обзор книг по бизнес‑практикам в ИТ, которую задала недавняя статья издательства БХВ. Книгу «Практическое руководство для архитекторов решений» написал российский автор Дмитрий Бардин, архитектор решений из Кинопоиска. Автор старался показать, как объединить архитектуру отдельного приложения с корпоративной архитектурой. Книга адресована разработчикам, аналитикам и руководителям групп (тимлидам), которые хотят понять, чем на самом деле занимается архитектор решений и как в эту роль перейти.

Читать далее

Как работают сетевые неймспейсы внутри Docker‑контейнера

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели98K

Привет! Я Лев, системный администратор технической поддержки в Selectel.

Все знают, любят и ненавидят контейнеры. Сейчас самым популярным инструментом для упаковки приложений со всеми их зависимостями является Docker. В этой статье рассмотрим его сетевой стек, а именно — работу сетевых неймспейсов. Разберем, почему они превращают обычный процесс в полноценный сетевой узел, как устроены и какие режимы предлагает Docker.

Читать далее →

Быстрые кешбэки для быстрых платежей: как работает платформа лояльности НСПК

Время на прочтение12 мин
Охват и читатели144K

Типичный кешбэк, как правило, приходит в конце расчётного периода. Иногда увидеть вознаграждение можно через несколько недель. Но если сам платёж проходит быстро, почему бы не сделать таким же быстрым и вознаграждение?

На связи Константин Гузаров, эксперт направления в команде платформы лояльности «Мир Plat.Form», технологической команды Национальной системы платёжных карт (НСПК), и сегодня я расскажу, как мы запускали моментальный кешбэк за покупки по Системе быстрых платежей (СБП) и что пришлось изменить в платформе, чтобы вознаграждение приходило практически одновременно с платежом. 

Сейчас кешбэк за покупку по СБП начисляется мгновенно по заведённым акциям. Для пользователя это выглядит просто: оплатил покупку — получил кешбэк. Но между этими двумя событиями происходит цепочка операций: процессинговый центр лояльности (ПЦЛ) получает информацию о транзакции, проверяет условия акции, учитывает историю покупок клиента, определяет размер вознаграждения и инициирует процесс выплаты. 

Читать далее

Неклассические контейнеры в C++

Время на прочтение17 мин
Охват и читатели61K

Контейнер - это объект, используемый для хранения других объектов. Контейнер берет на себя управление всей памятью, которые эти объекты занимают.

В стандартную библиотеку C++ входит несколько контейнеров. Кроме этого, в Open Source есть несколько контейнеров, которые покрывают больше юзкейсов. Я опишу устройство интересных контейнеров вне STL и их отличия от классических контейнеров.

Читать далее

О том, как легкомысленное использование полиморфных аллокаторов может испортить вам жизнь

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели5.3K

Вы хотите идти в ногу со временем и перевести ваш проект на полиморфные аллокаторы? Вас не могут отговорить от этого даже затраты на виртуальные вызовы? Тогда вы просто обязаны знать о нюансах с лайфтаймом, и почему нельзя просто взять и поменять свои контейнеры на аналоги из пространства имён pmr.

Читать далее

Lock‑free по нарастающей

Уровень сложностиСложный
Время на прочтение16 мин
Охват и читатели12K

Большинство учебников предложит синхронизировать потоки с помощью мьютекса. Но под реальной high-performance нагрузкой блокировки превращаются в кошмар планировщика ОС: несвоевременное вытеснение потока после захвата критической секции способно парализовать ваш пайплайн обработки данных, провоцируя многочисленные переключения контекста, уходы в спячку и сбрасывания кэшей процессора.

В качестве панацеи предлагают lock-free структуры, но и тут полно ловушек — банальный регулярный вызов ядра SetEvent способен сжечь весь выигрыш от lock-free. Сами алгоритмы lock-free порой тяжеловесны, не всегда предлагают удачный trade-off и даже не всегда уместны. Но что ещё хуже: будучи применёнными без должной тщательности, они могут не только не дать выигрыша, но даже навредить.

В этой статье мы разберём устройство нескольких базовых объектов библиотеки wxl и познакомимся с концепцией «алгоритм дешевеет под нагрузкой». Мы пройдём путь от трёх базовых инструкций процессора до готового канала, разберём, как продление release-последовательности спасает от ABA, как ленивые триггеры arm/disarm позволяют будить поток только тогда, когда он реально спит, и как заставить данные летать между ядрами без обращений к операционной системе.

Готовы? Приступаем...

Корутины C++: как приручить асинхронный I/O

Уровень сложностиСложный
Время на прочтение23 мин
Охват и читатели10K

Когда комитет стандартизации проектировал корутины, за кадром остался один неловкий момент: фрейм корутины (coroutine frame) — это динамический объект. Локальные переменные, буферы под чтение, аргументы и состояние автомата с точкой останова co_await должны где-то физически лежать, и по умолчанию компилятор выделяет это пространство из общей кучи через глобальный operator new. В асинхронном GUI, где корутина заводится на каждое нажатие клавиши и на каждое чтение из файла, это означает межпоточные блокировки кучи на каждом шаге с потенциальным переключением контекста — ровно то, от чего корутины обещали избавить.

И это не единственный сюрприз: сам по себе co_await асинхронности не даёт. Учебный awaitable запускает работу только в момент ожидания, и две асинхронные операции подряд на деле не запускаются асинхронно - идут с холостым кругом между ними; чтобы корутины стали по-настоящему асинхронными, механизм запуска операции пришлось отделить от того, что даёт язык. Эти вещи неочевидны, о них почти не пишут, и тем, кто присматривается к корутинам, стоит смотреть на них в первую очередь.

Заглянуть под капот

C++: Айсберг времени жизни объектов

Уровень сложностиСложный
Время на прочтение47 мин
Охват и читатели8.2K

Вам нужна эта статья, если вам не хватает знаний, чтобы ответить на эти вопросы:

• Чем отличается new expression от operator new
• Что такое placement new, какой у него синтаксис, и выделяет ли он память
• В каких случаях и зачем нам может понадобиться вызывать деструктор вручную
• Когда использовать std::launder
• Почему какие-то типы можно копировать через memcpy, и ими можно сразу пользоваться, а для других это будет UB?
• Что вы реально можете кастить через reinterpret_cast
• Почему стандарт C++ такой запутанный и бесчеловечный

Занырнуть

Динамическая память в системах жёсткого реального времени

Время на прочтение6 мин
Охват и читатели19K

Существует класс приложений реального времени, для которых тяжело предсказать потребности в распределении памяти во время выполнения статически. В этот класс входят, например, встраиваемые реализации стеков некоторых коммуникационных протоколов, где поведение и распределение ресурсов определяется отчасти активностью других агентов в сети. Классический подход в таких случаях заключается в использовании блочных менеджеров памяти, выделяющих фрагменты фиксированного размера (как это сделано, например, в LwIP). Этот подход накладывает нежелательные функциональные и качественные ограничения на реализацию. В этой заметке я предлагаю точку зрения, что традиционные (не блочные) аллокаторы незаслуженно обделены вниманием разработчиков систем реального времени, делюсь соображениями по релевантным вопросам, жалуюсь на жизнь, и предлагаю улучшить положение дел.


(КДПВ – см. аннотацию к диаграмме в конце)

Читать дальше →

Главная проблема использования ИИ (Иллюзии Интеллекта) при разработке ПО

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели13K

Меня часто поражает, как технически грамотные люди спорят, есть ли у LLM интеллект или это всего лишь математические вычисления по определенному алгоритму без зачатков разума. И что самое интересное, иногда оппонентами в споре за наличие интеллекта у генеративных нейросетей выступают люди, которые таким образом рекламируют свое IT-решение, не понимая, что тем самым они только создают себе проблемы.

Ведь создавая рассуждающую иллюзию интеллекта, разработчики фактически ставят крест на возможности какого-либо реального применения подобных решений в серьезных задачах, так как имитация разума превращает потенциально полезный рабочий инструмент в игру на бубне без каких-либо гарантий качества и воспроизводимости полученных результатов.

Читать далее

Учимся правильно использовать ИИ при разработке программного обеспечения

Время на прочтение9 мин
Охват и читатели18K

Недавно написал статью о проблемах использования ИИ (Иллюзии Интеллекта) при разработке программного обеспечения / Хабр, и решил не ждать у моря погоды, когда (и если) провайдеры исправят ситуацию на своей стороне, а попытаться самостоятельно выработать приемлемый алгоритм работы с ИИ, который был бы экономически выгодным и целесообразным при разработке ПО хотя бы лично для меня.

Данная статья - это очередной Хабрахак с подведением итогов и получением обратной связи об использовании ИИ-помощников при разработке программного обеспечения с примерами кода и итоговыми выводами о целесообразности использования ИИ в том или ином проекте.

А также поделюсь неожиданным инсайдом, который я случайно обнаружил в процессе работы над ИИ-кодом, который будет очень полезен матёрым программистам, которые до сих пор скептически относятся к использованию ИИ в своих проектах.

Читать далее
1
23 ...

Информация

В рейтинге
488-й
Откуда
Таганрог, Ростовская обл., Россия
Зарегистрирован
Активность

Специализация

Разработчик мобильных приложений, Разработчик игр
Git
PostgreSQL
Python
Linux
Docker
SQL
ООП
REST
Golang
C++