Обновить
8K+
-2
Перова Анна@TechRecruiter

ИТ рекрутер 17+ лет, изучаю data science 3 года

9
Рейтинг
18
Подписчики
Отправить сообщение

Спекулятивный декодинг в проде: сравнение методов в ИИ-ассистенте покупателя на Wildberries
Уровень сложностиСложный
Время чтения21 мин
Охват и читатели6.9K

ИИ-ассистент покупателя на Wildberries работает на модели из нашего собственного семейства языковых моделей BerryLM, дообученной под сценарии ассистента. На одно сообщение пользователя он делает много вызовов LLM, в нашем тестовом наборе в среднем около 26: разбирает контекст, извлекает предпочтения, генерирует поисковые запросы, подбирает фильтры, пишет ответ. Часть вызовов идёт параллельно. А пользователь всё это время ждёт, так что от скорости генерации напрямую зависит, как быстро ответит ассистент.

Мы перевели ассистента на спекулятивный декодинг. Но сначала прогнали на одном стенде, одной нагрузке и одних данных семь методов: от n-gram без обучения до свежих DFlash 2 и DSpark. Это рассказ о том, что из этого вышло, какие грабли нашлись по дороге и почему в проде в итоге DFlash 2.

Читать далее

Подробное руководство по облачной инфраструктуре для ИИ-проектов

Уровень сложностиСредний
Время чтения18 мин
Охват и читатели1.9K

Как вычислительные ресурсы, системы хранения, сетевые технологии и AI-фреймворки влияют на производительность AI-проектов.

Почему понимание этой инфраструктуры даёт конкурентное преимущество

Читать далее

Открываем претрейн Alice AI Search: как устроена модель быстрых ответов Алисы на Поиске

Время чтения14 мин
Охват и читатели28K

Быстрый ответ Алисы AI — это самый массовый генеративный продукт Яндекса и первое соприкосновение с Алисой для пользователей Поиска. 

Даже в час пиковой нагрузки пользователь должен получить лаконичный ответ за считаные секунды. Для этого мы, команда Alice AI Search, адаптируем весь пайплайн быстрых ответов — от собственного претрейна с кастомной архитектурой до онлайн‑rl‑обучения на поведенческие сигналы пользователей.

В статье разберём, как устроен генеративный ответ в Поиске, и расскажем про основные улучшения июньского релиза: как мы ускорили ответы за счёт коротких инфоконтекстов, зачем совместили Encoder‑Decoder с разреженной MoE‑архитектурой и как обучение на реальных пользовательских сигналах повлияло на качество и использование продукта.

Кроме того, мы выложили в открытый доступ обученную с нуля модель Alice AI‑T5-35B‑A0.6B Base с тем ограничением, что внешним пользователям доступен инференс через Hugging Face Transformers, а оптимизированный production‑инференс пока доступен только внутри Яндекса.

Читать далее

Запускаем FLUX 1 Dev в Google Colab

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели5.2K

Ранее я уже делал статью про запуск в пару кликов моделей Stable Diffusion в Google Colab с помощью Fooocus (способ актуальный), сегодня мы проделаем похожее с моделью FLUX 1 Dev, но без web интерфейса.

Читать далее

Как создать свой бенчмарк: 6 уроков с туториала NeurIPS

Время чтения2 мин
Охват и читатели5.9K


Посмотрела Туториал NeurIPS «The Art of Benchmarking» — панель с авторами SWE-bench, GPQA и ведущими исследователями из Google DeepMind, NYU и Berkeley.
Вот мой конспект. Делюсь с вами, так как бенчмарки теперь не только про науку, но и про безопасность, регуляторику и миллиардные решения о деплое.

* Тирания метрик
Оказывается, любая метрика имеет honey spots, которые модель может хакнуть. Проблема в том, что текущая мета-оценка (корреляция Пирсона) эти точки не показывает. А если метрика становится еще и reward'ом при обучении — могут быть проблемы

* Про долговечность
Бенчмарки действуют только определенный период, и нередко - далеко не 10 лет. Всё насыщается. ImageNet продолжает быть полезным, потому что его используют для 10 разных задач (диффузия, CLIP, zero-shot). А большинство бенчмарков теряют актуальность, но продолжают кочевать по paper'ам еще 5 лет — просто потому, что их удобно цитировать. Это плохая практика.


* Субъективность — везде
Даже в классификации изображений люди расходятся. Две принципиально разные причины: (а) задача плохо задана (underspecification), (б) люди реально думают по-разному. Проблема краудворкинга: если не кэпировать ответы, вы получите не мнение популяции, а мнение Боба, который сделал 80% аннотаций.

* LLM как источник оценки — это очень опасно
Они коррелируют с людьми только на той выборке, на которой их калибровали(!). Модель становится умнее — распределение данных меняется — корреляция падает. А при генерации бенчмарков LLM имеют сильнейший self-bias (даже с независимой метрикой). Единственный корректный подход — заставить модель генерировать примеры, на которых она ошибается

Читать далее

DeepSeek подорожает в разы с 16 августа

Время чтения2 мин
Охват и читатели13K

На официальном сайте DeepSeek появилась новая сетка тарифов. Также вводятся отдельные цены для пиковых часов:

• с 01:00 до 04:00 (UTC)

• с 06:00 до 10:00 (UTC)

Рост цен составил от 1.5 до 12 раз в зависимости от типа токенов (кэш / входные / выходные) и времени (пиковые часы или нет).

Новые тарифы начинают действовать с 16 августа с 16:00 (UTC).

Читать далее

Обзор GPU-облаков в России для обычного пользователя в 2026

Время чтения4 мин
Охват и читатели9.9K

Сейчас я учусь на 2 курсе магистратуры МИФИ по ML ( это моё второе высшее образование, по 1 специальности я психолог и TechHR с опытом 17+ лет), и пишу диплом о GENAI аватарах, в рамках диплома я создала прототип коммуникативной системы для HR и кандидатов на основе GENAI аватаров и LLM (подготовка для кандидатов к интервью, первичная оценка кандидатов + доп.сервисы - аналитика по ML-вакансиям в Real-Time). Мой диплом - это полноценный прототип системы с бэкэндом и UI, LLM, Gen-AI аватарами.

Этот небольшой обзор - для моих локальных студенческих задач. Cейчас для меня важна невысокая стоимость GPU сервисов - для демо-версии на защите диплома в МИФИ, в связи с этим я сделала обзор GPU решений в России, которые подходят для студента, будут не слишком дорогими, и на перспективу - могут быть подходящими и для небольших Production решений.

Читать далее

AI для Тестирования (QA): краткий гайд по инструментам

Время чтения5 мин
Охват и читатели11K

В своей статье об автоматизации различных аспектов QA роли с помощью AI я писала, что с высокой вероятностью, в ближайшие годы, с помощью AI будет возможность автоматизировать большую часть рутины тестировщика.

В данной статье, мне бы хотелось рассмотреть конкретные полезные инструменты для автоматизации роли QA с помощью AI. Статья ориентирована преимущественно на специалистов уровня junior/middle, а так же - на тех, кому интересно разобраться в современных AI инструментах для профессии QA

Ниже — конкретные шаблоны промптов и список инструментов. Я не претендую на экспертизу именно в QA, но более 17+ лет проработав в TechHR, из которых 12 лет - в AI рекрутинге, включая и найм QA, я вижу, что опыт и знания в области AI - необходим.

Лучшие инструменты для QA в 2026 году

Читать далее

Влияние AI на позиции QA в 2026 году

Время чтения5 мин
Охват и читатели12K

В 2026 году уже никто не спорит, что искусственный интеллект радикально меняет тестирование, как и все сферы бизнеса. Вопрос только в том, кого он заменит и кого сделает значительно ценнее как эксперта.

По данным World Quality Report 2025, 89% компаний пилотируют или внедряют Generative AI в процессы Quality Engineering. При этом только 15% сделали это на уровне всей организации. Остальные находятся в стадии осторожного эксперимента.

Читать далее

Когда автоматизация становится умнее: как трансформеры изменили AutoDL в Альфа-Банке

Уровень сложностиСредний
Время чтения30 мин
Охват и читатели6.5K

Всем привет! С вами Артемий Лямин (@lyaminartemiy) и Иван Тренёв (@123-39). Мы работаем специалистами по разработке нейронных сетей в команде автоматизации машинного обучения Альфа-Банка. В данной статье рассказываем, как провели масштабную модернизацию нашей внутренней AutoDL-библиотеки, пересмотрев её с самых основ.

Мы покажем, какие ограничения были у предыдущей версии и почему точечные улучшения перестали работать. Далее разберём архитектурные решения, которые легли в основу новой системы: переход к модульной мультимодальной трансформерной архитектуре, автоматический поиск архитектур, оптимизацию гиперпараметров, а также переосмысление пайплайна работы с данными. Отдельно остановимся на инфраструктурной части — удалённых запусках и оркестрации экспериментов.

В результате мы покажем как превратили набор разрозненных моделей в единую воспроизводимую и расширяемую AutoDL-платформу. Предлагаем пройти этот путь вместе с нами.

Читать далее

Как на самом деле работает распознавание лиц

Время чтения15 мин
Охват и читатели33K

Мы, команда NtechLab, постараемся понятным языком рассказать, из чего на самом деле состоят самые современные алгоритмы распознавания лиц, с которыми каждый из нас сталкивается в повседневной жизни, порассуждаем, на что они способны и на что — пока нет, и попробуем ответить на вопросы о том, когда технология работает хорошо, а когда плохо, и от чего это зависит.

Читать далее

Распознавание лиц для чайников

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели20K

Система распознавания лиц - очень распространенная система на сегодняшний день. Она широко используется в различных областях, таких как безопасность, развлечения, социальные сети и т.д. Данная технология развивается каждый год с невероятными темпами. В этой статье будет по полочкам разложено то, как работает система распознавания лиц, очень простыми словами.

Читать далее

Жестовый язык: похожее в непохожем и наоборот

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели3.4K

Привет, Хабр! Наша команда RnD CV продолжает приближать момент, когда компьютер по видео сможет распознавать жестовый язык (ЖЯ) глухих так же качественно, как речь. 

Сегодня мы расскажем, как собрали один из самых больших в мире датасетов изолированного русского жестового языка Logos, чем различаются визуально одинаковые жесты, как мы с помощью нашего датасета обучили универсальную модель-энкодер и попутно заняли первую строчку в бенчмарке распознавания американского жестового языка. По итогам этой работы мы опубликовали препринт.

Читать далее

Hugging Face выпустила SmolTalk — синтетический датасет для обучения языковых моделей

Время чтения1 мин
Охват и читатели2.4K

Разработчики платформы Hugging Face представили SmolTalk — синтетический англоязычный датасет для обучения больших языковых моделей. Он включает в себя существующие и новые наборы данных. С его помощью Hugging Face обучала нейросеть SmolLM2.

Читать далее

Гистограмма и ящик с усами на пальцах

Время чтения4 мин
Охват и читатели112K
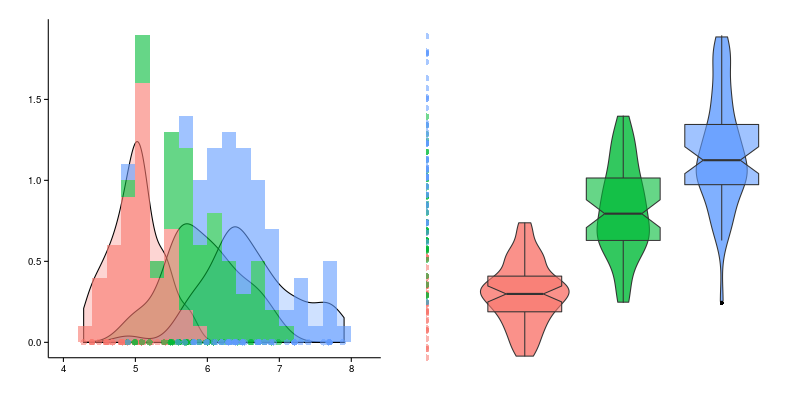
В этой заметке я хочу описать два типа графиков для одномерных данных, а именно
  • гистограмма
  • ящик с усами


image
Читать дальше →

T-Lite и T-Pro – открытые русскоязычные опенсорс-модели на 7 и на 32 млрд параметров

Уровень сложностиСложный
Время чтения9 мин
Охват и читатели72K

Всем привет! Я Толя Потапов, MLE в Т-Банке. Руковожу командой разработки фундаментальных моделей. 

Почти два года мы плотно работаем с LLM, развиваем продукты на базе больших языковых моделей. Например, Вселенную ассистентов, которая входит Gen-T — семейство собственных специализированных языковых моделей. 

Сегодня мы открываем две большие языковые модели — T-Lite и T-Pro, над которыми работали последние полгода, их можно скачать с huggingface. Они распространяются под лицензией Apache 2.0. Для адаптации моделей под бизнес-кейсы рекомендуем воспользоваться нашей библиотекой turbo-alignment с инструментами для полного цикла работы над LLM. 

Читать далее

Джон Маккарти: открытия и наследие создателя термина «Искусственный интеллект»

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели18K

Ученый и новатор Джон Маккарти придумал термин «Искусственный интеллект», создал язык программирования Lisp и разработал концепцию разделения времени. В этой статье мы отследили путь Джона Маккарти от юного энтузиаста математики до титана компьютерной науки, чье наследие продолжает вдохновлять ученых и направлять эволюцию ИИ.

Читать далее

Краткий алгоритм организации процесса ИТ-рекрутмента и коммуникации с заказчиком для внутреннего Senior IT recruiter

Время чтения4 мин
Охват и читатели1.7K

Процесс ИТ-рекрутмента - процесс, который занимает действительно много времени (поиск и отбор резюме, назначение интервью, согласование встреч, согласование офферов и так далее, когда кандидатов становится больше необходимого - процесс работы становится бесконечным), в случае если его не оптимизировать, с точки зрения коммуникации с внутренним заказчиком - он может занять неоправданно времени.

С помощью данного алгоритма мне удалось сделать много результатов за мой опыт работы, закрыть в целом более 1000 вакансий за 12 лет, в том числе - нанять за 4 месяца - 4 лаборатории из разработчков, ML дата-саентисов, лидеров команд, проектных менеджеров в крупной международной ИТ компании и сберечь данной компании до 30млн на услугах рекрутинговых агентств, от которых в том поекте по моей инициативе отказались, так как я предложила альтернативную и более быструю систему найма.

Итак, краткий алгоритм организации процесса ИТ- рекрутмента для случая если - вы Senior Tech Recruiter в крупной ИТ-компании, если вы делаете качественный отбор на своем этапе, но внутренний заказчик пока не готов закрыть вакансию с 1-3 резюме.

Этот алгоритм организации процесса ИТ-рекрутмента - необходим, чтобы быстро закрыть вакансию и не превратить работу над ней - в бесконечные отборы резюме/собеседования):

1. Сделать фильтр из ~200 резюме, сохранить их в БД, чтобы было видно заказчику, фильтр важно сделать честный (можно их сохранить в базе, чтобы у заказчика была возможность посмотреть весь обьем работы ( прозрачность вообще один из факторов, влияющих на качество) - ресурсы: linkedin/внутренние рекоммендации и тд.

Читать далее

Что такое «чистый код» в 2020-м?

Время чтения10 мин
Охват и читатели45K

«Чистый код» и чистый кот

Разработчиков хлебом не корми, дай поспорить о чистоте кода: например, недавно шумиху навёл пост Дэна Абрамова «Goodbye, Clean Code».

Но при этом у самого понятия «чистый код» нет чёткого определения. Главная книга по этому вопросу — «Clean Code», где Роберт «Дядюшка Боб» Мартин сразу заявляет: «сколько программистов, столько и определений». Впрочем, из этого он делает не вывод «говорить об этом бесполезно», а вывод «стоит сравнить разные определения». Поэтому в книге он привёл мнения нескольких выдающихся программистов о том, что такое чистый код.

Нам стало интересно: в 2020-м представления человечества о чистом коде остались теми же, или с выхода книги как-то изменились? Различаются ли мнения у разных айтишников: может, бэкендеры видят всё с одного ракурса, а тестировщики с другого?

В апреле Дядюшка Боб прилетит в Петербург выступить на трёх наших конференциях, и они как раз по трём разным направлениям (про .NET-разработку, про тестирование и про JavaScript). Поэтому мы спросили нескольких спикеров этих конференций, что такое чистый код для них, чтобы сравнить мнения экспертов индустрии в 2020-м.

А поскольку тема холиварная, наверняка кто-то из вас окажется не согласен с какими-то из мнений. В таком случае айда спорить в комментариях, это тоже весело!

UPD: Когда мы писали эту статью, Роберт планировал приехать на наши конференции. К сожалению, ситуация изменилась. Также из-за запрета на проведение массовых мероприятий мы перенесли конференции на другие даты. Следите за обновлениями на сайте конференции. 13 марта мы обновили этот пост, чтобы он не содержал некорректную информацию.

Читать дальше →

Математика для Data Science и машинного обучения за 8 месяцев. Подробный план обучения

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели154K

Беспилотные автомобили, продвинутые голосовые ассистенты, рекомендательные системы – это только малая часть тех классных продуктов, которые создаются с помощью инженеров по машинному обучению и, думаю, не для кого не секрет, что за кулисами сего чуда стоит математика. Именно она играет главную роль в понимании алгоритмов машинного и глубокого обучения.

Машинное обучение держится на трёх основных столпах:

Читать далее
1

Информация

В рейтинге
674-я
Дата рождения
Зарегистрирована
Активность