Обновить
32K+
34

Пользователь

101
Рейтинг
171
Подписчики
Отправить сообщение

Как оценить зрелость безопасной разработки своими силами? Сравниваем четыре методологии
Время на прочтение7 мин
Охват и читатели6.5K

Безопасная разработка сейчас — одна из самых горячих тем в российском ИТ. Чаще всего к ней подталкивают внешние обстоятельства: требования регуляторов, предстоящие проверки или инцидент, после которого процессы приходится пересматривать. Самый редкий, но самый честный повод — руководство действительно хочет разрабатывать безопасное ПО.

Но прежде чем внедрять новые для компании практики безопасной разработки, нужно честно посмотреть на текущие процессы: что из практик уже внедрено и работает, где пробелы и какие есть проблемы. Только тогда станет понятно, в каком направлении двигаться и как строить план внедрения.

Как же оценить зрелость процессов? На глаз? По одной из западных методологий? По ГОСТу? Если звать внешнего аудитора не хочется, вариантов, на самом деле, четыре: BSIMM, DSOMM, SAMM и ГОСТ Р 56939-2024. Какому из них отдать предпочтение, не очевидно: методологии по-разному устроены, по-разному ложатся на российские реалии, и не каждая доводит от оценки до понятного плана действий. Где-то есть готовый опросник с расчетом, где-то его придется собирать самому, а где-то практики рассчитаны на очень зрелые компании и для большинства российских слишком затратны. 

Я прогнал все четыре методологии через имитацию аудита на одной вымышленной компании и проверил, с какой проще пройти весь путь — от оценки зрелости до рекомендаций и дорожной карты. 

Материала набралось на три статьи. В этой сравню все четыре методологии, разберу их преимущества и недостатки и сделаю вывод, для каких задач годится каждая. Во второй на примере BSIMM, DSOMM и SAMM покажу, как провести оценку, какими инструментами воспользоваться и с какими ограничениями придется столкнуться. В третьей разберу оценку по ГОСТ Р 56939-2024.

Заваривайте кофе и устраивайтесь поудобнее — отправляемся в путешествие по внутреннему аудиту!

Читать далее

Пытаемся сделать лаборанта из локальной Qwen 3.8 на 16 ГБ VRAM

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели9.7K

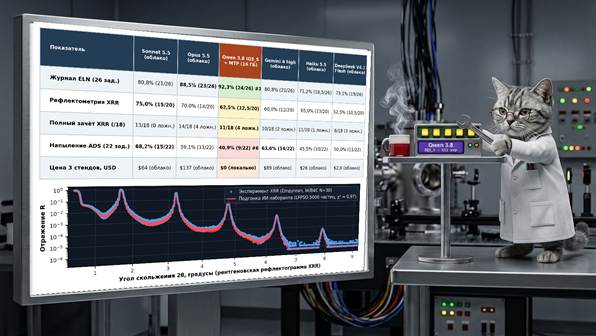
В прошлой статье мы запустили локальную Qwen 3.8 на машине с одной картой RTX 5080 на 16 ГБ. На вопросах по лабораторному журналу она обошла даже Claude Opus 5.5. Но радость оказалась преждевременной, потому как поиск по базе — самая простая часть работы физика. Когда мы проверили модель ещё на двух стендах: в обратной задаче рентгеновской оптики (XRR) и за пультом вакуумной установки (ADS), результат сильно упал. Пришлось разбираться, почему при переходе от таблиц к физике и «железу» мелкая модель начинает сыпаться.

Читать далее

Kubernetes слишком тяжёлый для мини-ПК? Собрал почти продовый кластер с потреблением всего 10 Вт

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.8K

Насколько тяжёлым должен быть Kubernetes-кластер, чтобы на нём можно было тестировать решения из промышленной инфраструктуры? Автор собрал такой стенд на одном мини-ПК с потреблением около 10 Вт: с реплицируемым хранилищем, полноценным LoadBalancer и Gateway API. В статье — подробный разбор конфигурации, неожиданных проблем и компромиссов, благодаря которым удалось уместить почти продовый Kubernetes в столь скромные ресурсы.

Как это работает

Помогаем малышке стать сильной: локальная Qwen против облачных флагманов на 16 ГБ видеопамяти

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели24K

В двух предыдущих статьях мы проверяли языковые модели на наших повседневных задачах: работе с данными в электронном лабораторном журнале и исправлении ошибок в трёх закрытых проектах на Delphi — от программы рентгеновской рефлектометрии X‑Ray Calc до нашей системы управления лабораторией.

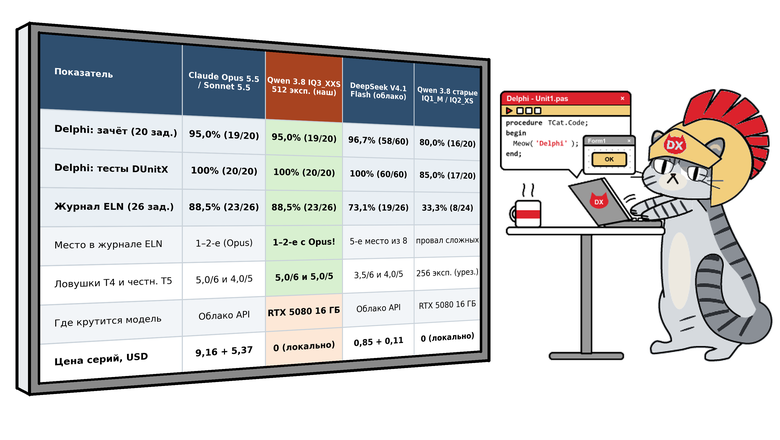
В обоих тестах локальные модели на моей рабочей станции (одна карта RTX 5080 на 16 ГБ и 62 ГБ оперативной памяти) заметно отставали от облачных лидеров. На вопросах по журналу ранняя сборка Qwen 3.8 IQ2_XS набрала жалкие 33% (8 из 24), а gpt‑oss-20b — 40%. На задачах Delphi специализированная Qwen 3.8 Coder IQ1_M взяла 16 задач из 20 (80%). Результат уже вполне рабочий, но до Claude Sonnet 5.5 (19/20) она всё‑таки не дотянула.

Конечно, можно было на этом успокоиться и списать отставание на скромные 16 гигабайт видеопамяти. Но мне не давал покоя вопрос: модель действительно упёрлась в свой потолок или мы сами подрезали ей крылья настройками и капризными инструментами? Сели разбираться — и довольно быстро нашли узкие места. Поменяли урезанную сборку весов на полную, поправили конфигурацию сервера, научили инструменты спокойно относиться к мелким огрехам сериализации — и на том же самом железе локальная Qwen 3.8 взяла реванш!

Читать далее

Локальные LLM в AppSec: что можно доверить открытым инструментам и моделям

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели7.1K

Для экспериментов с ИИ в AppSec необязательно покупать облачную подписку. Модель можно запустить на рабочей станции, связать с анализаторами кода и поручить ей часть исследования. Открытые инструменты-обвязки позволяют настраивать такую работу под своё приложение. Таким образом, у команды появляется выбор, какие данные передавать модели, где их обрабатывать и насколько самостоятельной делать проверку.

Впрочем, установить модель заметно проще, чем понять, какую работу ей стоит доверить и как её организовать. Разобрать сообщение сканера, восстановить путь пользовательских данных или провести многошаговое исследование приложения – это всё задачи разного масштаба. Если сразу поручить небольшой локальной модели весь аудит, то по результату такого эксперимента будет трудно судить, какие отдельные задачи она способна решать.

Поиск подходящих задач связан и с организацией проверки. Открытые инструменты позволяют менять её под своё приложение и понимать, какие решения повлияли на результат. Постепенно у команды складывается собственная методика работы с ИИ, которую можно уточнять и применять в следующих проектах.

В этой статье мы сначала проследим, как появились эти возможности, а затем рассмотрим локальные сценарии AppSec и последствия свободного выбора моделей и инструментов.

Читать далее

Два столпа Linux мониторинга

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели20K

И снова здравствуйте! Продолжаем наш цикл статей о методах сбора данных (Прошлые статьи здесь и здесь). В данной (третьей) статье опубликована сжатая аналитика по двум технологиям сбора на Linux Endpoint на основе проработки наших продуктов по лог-менеджменту и сбору событий.

Читать далее

Omnia Metria in SAR Collecta — Мониторинг Linux с SAR: обширное описание метрик и как их читать

Время на прочтение34 мин
Охват и читатели13K

Состояние сервера можно условно сравнить со здоровьем человека: оно у всех разное и умирают все от разных причин. Пульс, давление, температура — это показатели, которые помогают в диагностике нас. В мире Linux эти показатели: CPU, использование памяти, работа дисков и прочее. Как и в медицине, мониторинг можно проводить в реальном времени или анализировать уже собранные данные.

Если у человека проблема с сердцем 🩺, врач может сделать ЭКГ прямо сейчас, но если нужны показатели за длительный период, нужен суточный мониторинг ЭКГ по Холтеру, который может показать, например, проблемы ночью. В Linux этим занимается набор инструментов sysstat, в состав которого входит, в том числе, утилита sar, которая помогает визуализировать данные в логах /var/log/sysstat/.

Разделы:

Часть I. Установка и настройка sysstat.

Часть II. Пример использования sar для чтения из логов двух нод Kubernetes — умозрительный пример.

Часть III. Команда sar и диагностика проблем: описание метрик и что они означают, наглядные таблицы. Описание проблем.

Читать далее

Как у нашей IT-компании бесплатно забрали софт для автоматизации 13% ВВП страны, а нас отправили в РНП без экспертизы

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели111K

Меня зовут Алексей Рыбаков, я генеральный директор IT-компании «Омега Софт» из Йошкар-Олы. Последние 15 лет наша команда создает сложный промышленный софт для крупных российских предприятий. Мы привыкли работать в правовом поле, сдавать проекты в срок и верить, что добросовестное исполнение контракта — это главная защита бизнеса.

Но прецедент, с которым мы столкнулись в рамках дела № А40-311087/2025, показал: перед лицом гигантской корпоративной машины и слепого судейского формализма независимый российский IT-бизнес абсолютно беззащитен.

У нас полностью, до единой строчки кода, бесплатно отобрали уникальный отечественный программный продукт, отказались выплачивать заработанные 24,7 млн рублей, взыскали независимую гарантию на 3,2 млн рублей и уничтожили предприятие через внесение в РНП (Реестр недобросовестных поставщиков). Причина? Собственные технические службы заказчика в течение 7 месяцев были не способны настроить свои же сервера.

Этот текст — не просто жалоба. Это детальный разбор вопиющей несправедливости, которая прямо сейчас создает смертельную угрозу для всей отечественной IT-индустрии и выполнения государственных задач по технологическому суверенитету.

Читать далее

Диктовка без «ну» и «вот»: Whisper на своём компьютере и маленький посредник к LLM

Время на прочтение6 мин
Охват и читатели13K

Я пишу книги, и кроме самих книг за день набирается много другого текста: сообщения, письма, задания нейросетям. Говорить быстрее, чем печатать, поэтому большую часть этого я диктую. Только живая речь, записанная слово в слово, читается плохо. Вот фраза, которую Whisper распознал без единой ошибки:

Читать далее

Я написал сканер уязвимостей для вайбкода и проверил им 3 800 чужих репозиториев

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели9.8K

Сегодня Telegram-бот для продажи VPN собирается за вечер: Cursor, пара промптов, и он уже принимает деньги. Только в config.py лежит токен бота, Postgres открыт наружу, а в истории git остался .env, который «потом удалили».

Я написал SAST-сканер для кода, сгенерированного ИИ, и прогнал его по 3 800 публичным репозиториям. Рассказываю, что нашлось, как 16 378 сырых находок превратились примерно в 30 настоящих утечек и почему я не проверил ни одного чужого ключа.

Читать далее

Рабочий стол за NAT: autossh, systemd и VNC

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели9.4K

Домашний компьютер за NAT может сам достучаться до VPS и оставить дверь открытой только для вас. Собираем туннель, который переживает обрывы, смену IP и перезагрузки, и выводим через него рабочий стол.

Читать далее

Купил мини‑ПК с приставкой «AI» ради локальной LLM. Что может NPU на самом деле

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели100K

TL;DR. Я купил мини‑ПК с Ryzen AI 9 365, чтобы гонять большую локальную модель на NPU. Начал с Windows ради гибрида NPU+iGPU, который так и не заработал, прошёл квест с драйвером NPU, выяснил, что NPU видит только половину оперативки, переехал на Proxmox и в итоге запустил Qwen3.6–35B‑A3B через FastFlowLM прямо на хосте. Модель работает 24/7: prefill около 200 ток/с, decode 13–17 ток/с. По дороге выяснилось, что NPU обслуживает один запрос за раз, падает с double free, если клиент не дождался ответа, и умеет выгнать из памяти большую модель ради маленькой embedding‑модели. Ниже вся дорога по порядку, мини‑гайд и цифры.

Читать далее

Бесплатные API к Claude, GPT, DeepSeek и другим моделям: 6 AI-роутеров с бесплатным доступом

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели116K

Собрал 6 AI-роутеров с бесплатным доступом к Claude, GPT, DeepSeek, Qwen и другим моделям. Показываю, что реально дают после регистрации: баланс, доступные модели, лимиты и нюансы работы через API.

Читать далее

Видеомонтаж в blender, бесплатный и надёжный

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели14K

В статье расскажу про незаслуженно неизвестный, надёжный, стабильный и по-своему красивый монтажный стол, интегрированный в программу blender. Дам краткое пошаговое руководство по созданию клипа вместе с его исходниками, которые вы сможете скачать и изучить.

Читать далее

Пентест через GitLab. От раннера до контроля над облаком

Время на прочтение5 мин
Охват и читатели11K

Казалось бы, учетная запись в GitLab — не самая удачная стартовая точка для инфраструктурного пентеста. Ни VPN в корпоративную сеть, ни доменного аккаунта, ни даже RDP на рабочую станцию, только креды рядового разработчика. Вряд ли в начале проекта заказчик ожидал серьезного импакта, но мы доказали, что при типовых настройках CI/CD такая учетка находится на расстоянии нескольких прыжков до контроля над облаком. 

Давайте вместе пройдем эту цепочку.

Читать далее

«Вы сливаете наши номера!» Как мы искали крота внутри компании, а нашли мобильных операторов

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели89K

Представьте... Вы позвонили в конкретную компанию. Поздоровались, пообщались, попрощались. А в течение следующего часа вам начинают названивать конкуренты с аналогичными предложениями. Ситуация не из приятных, согласитесь?

И в такой ситуации оказались наши клиенты. Они были недовольны и винили нас в сливе номеров. Мы тоже были недовольны, потому что не понимали, откуда эти номера утекают.

Версий было много, расследование длилось долго — проверяли всё подряд. Но настоящая причина скрывалась совсем не там, где мы думали...

А теперь обо всём по порядку

ИИ и автотесты: как поймать ложную зелёную галочку?

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели14K

ИИ уже умеет генерировать тесты пачками, но зелёный пайплайн по‑прежнему может врать. В статье разбираем на примере Java и JUnit, как отличить тест, который действительно ловит баги, от теста, который просто создаёт иллюзию проверки.

Читать далее

Информация

В рейтинге
63-й
Зарегистрирован
Активность