Comments 1975


Афигенно! Автор, жги! * обновляет страницу, дабы насладится холиваром *

Динамическую типизацию зачем то придумал и мало того она жива до сих пор, обычно то что никому не нужно умирает на задворках истории.
Но удивительное дело в динамических появляются типы, а в типизированных val.
Такие дела.
Истина где-то рядом, наверно по середине.
И наверно не всех надо по одну гребенку.
Удивительный у автора талант писать статьи, которые вызывают эмоции от полного принятия до лютой неприязни.

val это не динамическая типизация, а лишь вывод типов. Вот почему то многие не понимают принципиальной разницы


Динамическую типизацию зачем то придумал и мало того она жива до сих пор, обычно то что никому не нужно умирает на задворках истории.
Как говорил один мой знакомый:
Так ведь значит же. Динамика это просто атавизм из 90-х, когда языки с нормальными системами типов делать не умели, а писать на вербозном говне не хотелось.
А ЯП с нормальными системами типов начали появляться относительно недавно.

Ни в коем случае не троллинг, действительно интересно.
Haskell (хотя 0xd34df00d щас опять будет ворчать, что выразительности не хватает), Idris, вроде бы Scala (хотя точно сказать не могу), с некоторой натяжкой — Rust.


- Динамика это просто атавизм из 90-х, когда языки с нормальными системами типов делать не умели
- Haskell, 1990 год.
- Python, 1991 год.
Как эти три вещи могут одновременно укладываться в голове? Видимо ваш знакомый не знает одной из них.
Не получится убедить, что Haskell — это подходящий язык для разработки, а Python — не подходящий.
Лучшее, что может быть — это типизация по требованию. Когда нужно, беру и использую. Когда не нужно — избегаю кучи бойлерплейта.
Все таки Haskell это полигон для экспериментов, который тем не менее дорос до прода, а активно вывод типов начал проникать в индустрию только в 10ых годах.

Ну так хаскель 90-го года и хаскель совеременный — это очень разные языки.

Лучшее, что может быть — это типизация по требованию. Когда нужно, беру и использую. Когда не нужно — избегаю кучи бойлерплейта.
Если бы она ещё работала… Потому что когда тебе нужно, а в апстриме не нужно — вылезай, приехали.


Swift
Не очень из-за дурацкого деления типов на структуры и классы.
Структуры и классы никак не делят типы и не мешают. Это лишь определяет reference type/value type и системе типов до этого нет никакого дела.
Есть дело мне при написании программ, потому что мне надо думать, где будет глубокое копирование, а где — поверхностное, где меняется аргумент, а где — его копия. И в дженериках подобное разделение обычно аукается.

Ну скорее всего придётся об этом думать, язык все-таки позиционируется как более менее быстрый и нежручий.
За мутабельные структуры компилятор всегда подскажет. Если один раз понять как работают reference type/value type в свифте и использовать их где нужно и как нужно, то никаких проблем не будет возникать, а компилятор в случае чего все-равно заботливо предостережет. Все четко и явно в этом плане. И не придется переживать за глубокое/поверхностное копирование.
А что не так с дженериками?
В самом простом варианте все по-умолчанию imutable, потому что компилятор не будет знать что именно туда придет, а для мутабельности можно и inout или var в нужном месте указать.
В случаях посложнее (generic constraints) у вас в протоколе все ограничения описываются, вплоть до указания что этот протокол только для классов.
Не знаю с какими проблемами вы сталкивались, но по этому поводу у меня голова ни разу не болела.

К сожалению он существует только в яблочной экосистеме.
К счастью, его можно поставить и использовать практически на все, кроме винды. На малинку вот поставил недавно.

6 лет назад было 50/50, как сейчас — не знаю, но думаю не в пользу винды.
87% windows на 2019 год.
87% это в целом по миру или в сфере разработки? Я видел винду только у тех разработчиков, которым по каким-то причинам было лень ставить линукс. Возможно страх перед неизведанным.

https://swift.org/blog/5-3-release-process/
Теперь и на винде будет.
Так исторически сложилось, что на свифт перешли все кто писал на ObjC, а он существовал в рамках эппловских операционок, поэтому большинство пишущих на нем — маководы. А так как язык молодой, то пока еще не успел выбиться из нативной разработки под MacOS/iOS (в плане популярности), хоть эппл и делает многое, чтобы он мог быть универсальным. Бекенды эти ваши давно уже можно писать, с ардуинками играться, TensorFlow переходит на него как на основной язык. Дайте малышу время)

хоть эппл и делает многое, чтобы он мог быть универсальным.А что именно он делает? Мне просто интересно. Компилятор предоставил? Так Objective C всегда был под разные платформы (стараниями Столлмана, правда, вопреке желанию Джобса… но был).
Каких-либо попыток сделать разумную среду, которую можно использовать вне экосистемы Apple я не наблюдаю… да неясно какой в ней мог бы быть смысл: Apple же нужно сделать так, всё-таки, чтобы «хомячки» не разбежались с его платформы, а не чтобы кто-то вне её творил…
TensorFlow переходит на него как на основной языкКто сказал? Откуда уверенность, что из этого не получится очередная стелла на известном сайте?

Про TensorFlow Google сказал, мол уходят с питона на свифт. Потому что быстрый, безопасный и: https://en.wikipedia.org/wiki/Differentiable_programming
Если появится очередная стелла, свифт от этого никак не пострадает. Но это не отменяет факта, что свифт уже не только язык для “хомячков” с платформ Apple.
Про TensorFlow Google сказал, мол уходят с питона на свифтГде, когда, а главное, кто? Те, кто его разработал? Там им свою разработку и внутри Гугла надо как-то продавать — ещё бы они не излучали оптимизм.
Если появится очередная стелла, свифт от этого никак не пострадает.Пострадает, конечно. Причём уже похоже, что не «если», а «когда». Итересно только — релиз успеют сделать или прямо из беты в небытиё?
Но это не отменяет факта, что свифт уже не только язык для “хомячков” с платформ Apple.Та же самая история, что и с Objective C, на самом деле: когда Objective C только появился — народ разработал GNUstep и были даже попытки куда-то это всё приспособить. Однако со временем всё заглохло и, насколько я знаю, Cocoa уже никто никуда портировать особо не пытался — так, кой-какие обрезки для игрушек.
То же самое и здесь: каждая неудача применить Swift куда-нибудь, кроме iOS и macOS будет подчёркивать «неразрывную связь»: Swift == Apple, Apple == Swift.

Слабо себе понимаю причину захоронения S4TF. Ребята из Google просто искали наиболее подходящий язык и выбрали Swift. Cделали форк языка и на его основе допиливают под нужды. В Colab уже добавили. FastAI, курсы начали переводить. Единственная проблема, крайне сыроват еще, но светлое будущее :).
Ребята из Google просто искали наиболее подходящий язык и выбрали Swift.Именно так: не «Google искал», а «ребята из Google искали».
В Colab уже добавили. FastAI, курсы начали переводить. Единственная проблема, крайне сыроват еще, но светлое будущее :).Где-то я это уже слышал… Chrome Apps, NaCl… Да собственно половина проектов из Google Graveyard когда-то были «сыроватыми, но со светлым будущим».
Слабо себе понимаю причину захоронения S4TF.То же самое, что и всегда: не оправдал надежд, не набрал критической массы… Посмотрим. Самый важный вопрос не в том, смогут ли они в Colab что-то добавить, а смогут ли они хотя бы один «большой» проект этим увлечь… и то может не помочь: NaCl использовался в App Engine, но ему это не очень помогло…
Вот это самое "кроме" такой немаленький минус. И подозреваю в обозримом будущем оно не войдет в Tier1 поддерживаемых ОС. Rust вполне неплохая альтернатива в данной ситуации.


Динамическая типизация переносит ряд возможных ошибок на время исполнения программы вместо времени компиляции.

Как по мне оптимальна гибридная типизация, ибо иногда просто хочется расслабиться и что-то наклепать на коленке, не задумываясь о типах, но в серьезных проектах на том же PHP строгая типизация просто необходима по причинам, которые я описал выше. Причем я понял что словами это не объяснить, с этим нужно сталкиваться чтобы оценить все преимущества.
P. S. Это еще ладно, я еще и после этого с MySQL на PostgreSQL перешел (который тоже строготипизирован), теперь он меня обругивает каждый раз если по какой-то причине в строку суется число (а это может быть следствием какой-то очень серьезной проблемы, ибо почему возвращается число там, где должна возвратиться строка, например, array_search не нашел какое-то значение в массиве, хотя должно, что означает что этот массив сформирован неверно). Очень сильно выручало уже, хотя я не так давно пользуюсь всеми ее преимуществами.

писал на PHP, пару лет назад понадобилось прочно влезть в яву (более строго-типизированного языка я в жизни не видел)Это не та ли система типов, которая считает null объектом любого типа?
В РНР эту «особенность» умудрились не повторить, кстати.

Наверное, просто потому что null в PHP появился чуть ли не раньше чем сама Java появилась (шутка, она старше на пару месяцев) и изначально был отдельным скалярным типом, когда объектов ещё даже в проекте не было


заругается если аргумент имеет другой тип данных
Нуда, только его ругание попробуй еще перехвати, приходится статический анализатор гонять
ЗЫ на самом деле Php начинает нервировать, ятоже много лет на нем пишу, и у меня все более отчетливое желание писать на jsp или на чистой Java
TypeError обычное исключение. Обычно его и особо перехватывать не нужно, так же как любое необработанное.

Хороший пример: когда тон чего-то сказанного в начале убивает желание вообще продолжать смотреть на дальнейшие какие-то рассуждения или аргументы, не важно правильные или неправильные.
Приблизительно как начать общение в таком духе: "слыш, ты, послушай что я тебе сейчас скажу об этом говне...",
что там дальше уже не особо важно.


-А холивар то где???
P.S. После фразы «адское говнище» не читал.


В PHP добавляют строгую. А про джс можно подробнее?


Тот, кому первому пришла в голову идея назвать рантаймовый контроль типов «типизацией» — будет вечно гореть в аду за обман джуниоров.
Типизация — не контроль типов?
Не согласен. Типы — информация о том, как интерпретировать то или иное значение. А где она хранится и как и когда проверяется — детали реализации.
Лучше поздно, чем никогда, нет?
Как по мне, то если контроль типов есть, то это типизация.
Ваша программа станет типизированной.

Большинство источников используют "динамическая типизация" без подобных огооврок.


Строго говоря можно даже говорить о том, что все языки с динамической типизацией — суть языки со статической типизацией, в которых есть ровно один тип (и других создать невозможно). Ну или (как в JavaScript) — их несколько, но их фиксированное число и они все описаны в документации.
Однако в виду полной абсурдности такого подхода обычно от языков со строгой типизацией требуется, чтобы свои типы в них, всё-таки, можно было создавать.
Но нет, позднее связывание не делает язык нетипизированным. Даже если в каким-то месте про тип и нельзя ничего сказать (как в Java, когда вы получаете
Object), но в других-то можно!
назвать типизацией наличие проверок на корректный доступ к элементу массива
Тем не менее в Паскале длина массива именно что входила в определение типа.
(ещё до программирования)
Если вы имеете в виду математические типы в стиле введенных Расселом, то он ведь тоже не уточнял, в какое время их надо проверять.
Поэтому ваше утверждение
которое на программирование отображается как статические проверки
достаточно спорно.
Если уж на то пошло, то и статическая, и динамическая проверка типов вообще не относятся к типам, как таковым — типы просто существуют, а является скорее помощью человеку, который не может не делать ошибок и не путать данные разные типов в процессе программирования или выведения логических формул.
Не только конструктивное, но даже конструктивистское. Т.е. вполне пригодное для практического построения системы типов и ее использования.
Типы в ЯП до формализации примерно так и строились.
Должна ли операция «удалить первые N символов» быть в определении строки?
Может быть, но не обязательно. Она не слишком аксиоматическая, что ли.
Если у вас питон с типа строгой динамической типизацией, то, получается, «abcde» и "" — разные типы?
Непонятно, почему вы пришли к такому выводу. Операция эта будет определена как функция отображения строки в строку, т.е. тип объекта не изменится.
Может быть, но не обязательно. Она не слишком аксиоматическая, что ли.
То есть вместо строгого определения имеем: "Вроде как нет, но если надо, почему бы и не да".
некоторые выражения не имеют смысла, не «вычисляя»
Вы все равно вычисляете — ведь это знание не дано свыше, а требует тех же символьных манипуляций. Просто в данном случае есть более короткий способ вычисления — как некоторые интегралы можно посчитать в символьной форме, а не численно. Но в общем случае вычисления все равно придется проводить полностью.
выделить массив ровно такой длины
Насколько я помню исходный виртовский Паскаль — нет. Массивы там были вообще не динамические, а в их тип входили тип элементов, тип индексов и диапазон индексов.
А для передачи массива в процедуру приходилось определять формальный аргумент, прибегая к чему-то вроде any: ARRAY OF INTEGER, например, вместо полного типа ARRAY[1..10] OF INTEGER.
Хотя бывают разные ассемблеры. Почитайте документацию на TASM. У них там объекты были.

Целочисленный add, применённый к float значению, выдаст хурму на выходе.
елочисленный add, применённый к float значению, выдаст хурму на выходе.Недоумённо смотрит на свой код из релизнутого продукта. А вы точно в этом уверены?
А вот эту статью вы когда-нибудь видели?

Разумеется, какие-то целочисленные операции можно применять к float зная формат и ожидаемый результат.
Я же говорил, что сложив 1+1 вы получите не 2, а 1.7014118346e+38
Точно так же, перепутав знаковое и беззнаковое деление результат может быть неверным.
Я же говорил что сложив 1+1 вы получите не 2А почему вы, собственно, должны получить 2? Вы и без всяких
floatов можете получить чушь, если в одной переменной у вас 1 и в другой 1, только в одной — это метр, а в другой дюйм.Проверено экспериментально.
Процессор не сделает преобразование типов за вас. К чему вот было это ваше «а можно плавать и со штангой»?
>> А почему вы, собственно, должны получить 2?
Потому что я хочу получить 2, наверное?

Потому что я хочу получить 2, наверное?
Интересный аргумент. А если я хочу получить 3, то должно получаться 3?
1+1=3? Cтранное желание, но как хотите.

Ещё, слышал, бывали процессоры, у которых переменные содержали поле с типом.
У типа есть очень формально определённое значение
Много определений типа в программировании. Некоторые ещё тянут в программировании определения типов из математики.

"У типа есть очень формально определённое значение".
Я знаю про несколько определений типа из нескольких разных теорий типов. Не считая определений из прикладных языков программирования, который возникли раньше тапла и из других предпосылок. Какое же из них верное?
Понятие типа в контексте STLC
1. Система типов из «лямбда-исчисления с типами» не единственная система типов, а только одна из.
2. Системы типов в современных мейнстримных языках (как со статической типизацией, так и с динамической) — это очень далеко не STLC и я подозреваю, что их авторы строили их на несколько других основаниях (и не только формальных).
3. Да, можно натянуть сову на глобус (что и делает тапл) и вывести одно из другого, но это вообще не означает, что определение типа из STCL единственно верное или валидное для языков программирования.
4. То что система типов красиво формализуема еще не означает, что она хорошо подходит для промышленной разработки людьми, которым важно получить результат здесь и сейчас, а не формально верифицировать корректность программы.
А в каких других теориях типов это не статическая классификация?
Ну есть, например, такая «Gradual Type Theory». Правда я с ней недостаточно знаком, чтобы внятно ее обсуждать.
По остальным пунктам — а о чём мы спорим-то?
Я спорю с утверждением, что «типы — это не рантайм-метки рядом с другими ячейками в памяти, а что-то, что проверяется компилятором статически», и утверждаю, что если «статическая типизация = типы проверяются компилятором статически», то так же правомерно говорить «типы проверяются рантаймом динамически = динамическая типизация».
automath какой-нибудь возник сильно до любого из ныне существующих языков программирования.
Я думал, что тут разговор о языках программирования, а не доказателях теорем.


А как называются рантайм метки более коротко? И какое название у описания того, что можно делать с некоторой штукой вне зависимости от того, рантайм это или дизайн тайм?
Мне кажется, такой подход к терминологии менее ортогонален.
Ну так и называются, метки.
А кем они так называются? Есть ли какая-то реализация которая называет их не типом?
Например, в вашей любимой IDE при отладке тип переменной и тип значения переменной называются по разному? Один тип, другой метка?
Ээ, не знаю, это какой-то слишком общий термин для меня.
Ну вы в обычной речи слово тип не употребляете?
С моей точки зрения в книжке терминология интересна но неудобна, все говорят "тип" для общего, никто не использует выражения "рантайм метка" а статика тесно связана с динамикой.
С моей точки зрения в книжке терминология интересна но неудобна, все говорят «тип» для общего, никто не использует выражения «рантайм метка»
А зря. На мой взгляд, создаёт неправильные ожидания.
Зря или не зря — это уже больше философский вопрос. Факт в том, что «динамическая типизация» по отношению к языкам программирования используется именно в таком смысле, и причины, по которым так сложилось, здесь не важны.
лишний раз указать на принципиальное различие между типизацией и рантайм-проверками
То, что вы называете типизацией, — всего лишь проверки до рантайма.
Это лишь ваше убеждение :)
От задач зависит. Популярность языка, стэка обеспечивает масштабируемость разработки для бизнеса и наличие рабочих мест для программистов.
Извините, но вы соответствие Карри-Говарда проигнорировали. Избирательное зрение?
Надеюсь теперь всем ясно, что это — тролль?
Они, впрочем, обычно обладают крайне развитым навыком «переноса ворот» (как вы это уже тут видите), потому важно им всячески помогать, но ни в коем случае не брать на себя никаких обязательсв, если они не скрплены «подписями и печатями».
Даже если вам за выполнение чего-то сказанного мимоходом и нигде не зафиксированного обещают кучу плюшек и всяких благ. Лучше прослыть «ничего не понимающим в бизнесе», чем оказаться крайним, когда очередной такой персонаж будет на вас пытаться повесить свои косяки.

А если мне сказали закодить биржевого бота, который будет торговать на какой-нибудь азиатской бирже только в рабочие дни, то, например, если я неправильно скопирую список праздников (или нагуглю список не для той страны), то типы едва ли это помогут отловить, конечно. Но как это отлавливать — вообще непонятно.
Хуже. Список рабочих дней может как в России определяться в предыдущем году по решению Правительства. Или как с "нерабочими" днями. По ходу дела.
Вообще удивительно, что только 0xd34df00d реально вернулся к истокам. Все это программирование — это не код ради кода, а код обработки данных. А все данные типизируются. А код — это просто функции превращения одного в другое.
у него большая проблема: многое из того что он говорит базируется не на научном подходе, а на религиозных предпочтениях/взглядахНу хоть с тем, что ЯП со статической типизацией убирают множество проблем с ошибками типов вы согласны?
однако надо помнить (и это исследовал ещё Ларри Уолл), что большинство проблем с ошибками типов связаны с тем, что в языках некорректно сдизайнены операторы сравнения и математические операции.А ещё нужно помнить, что когда эта «глыба», эта «гора», этот «гений» решил создаить что-то на основе своих идей… то получился высер такого микроскопического размера, что о нём даже как о мыши-то говорить смешно.
и чем крута динамическая типизация: что программист больше думает об алгоритме, нежели занимается обрядами вокруг его реализацииСерьёзно? И потому как только вам требуются реально серьёзные алгоритмы (распределённые базы данных или хотя бы SQL-базы, компиляторы, операционные системы и всё такое прочее) — так прям все на динимических языках начинают программировать? Вы это сейчас серьёзно?
Знаете — весь этот ваш пафос был бы слегка более уместен если бы подверждался опытом. И вы могли назвать хотя бы одну систему, где динамически типизированный язык — это не «пенка» на базисе из модулей на статически типизированных языках, а что-то, что сущесвует само по себе. Хотя бы.
Уж не говоря о том, что если бы динамически типизированные языки были бы так круты, как вы описываете, то именно они должны были бы формировать базис, а на статически типизированных языках люди бы писали что-то, ошибки в чём были бы не так опасны.
и это путь решения тех же проблем но на дороге динамической типизацииЭто махание руками. Давайте ближе к практике:
1. Реализация динамически типизиванного языка на динамически типизованном языке же: ___
2. Операционная система на этом самом динамически типизованном языке: ___
3. База данных на таком же языке: ___
4. Процент рынка, который вот всё это заняло в ___ году: ___
Вот как заполните пропуски — так сможете лить в уши сказки про преимущество динамической типизации в деле реализации алгоритмов. А до тех пор — это всё рассказы условного «таджика» умеющего неплохо строть туалеты и двухтажные домишки дендрофекальным метордом о том, что у оного метода есть масса преимуществ перед сталью и бетоном, а что какие-то идиоты из говна и палок даже не пытаются строить мосты и небоскрёбы — так это потому что у архитекторов и инжинеров-строителей умишко слабенький и нет того опыта строительства туалетов, что «таджика»…
назовите три полезных программы на Расте/Хацкеле стоящие на большинстве компьютеровНазовите хоть одну такую на Raku для начала. Или вам можно выбирать языки, а мне нельзя? Вы же сами тут поёте песни про крутизну Ларри — ну вот покажите… на практике.
динамически типизированные языки — это скриптовые языки, прежде всего.Внезапно как, а. А почему так, не расскажите? Почему языки, в которых «программист больше думает об алгоритме, нежели занимается обрядами вокруг его реализации» не применяются там, где алгоритмы сложны и о них действительно приходится думать — но всё больше там, где алгоритмы тривиальны и думать о них не нужно?
затем попробуйте удалить Perl и Bash. и посмотрите на результатИ много вы алгоримов на Bash написали? Я как-то писал топологическую сортировку банальную — то ещё равлечение было. В Android, кстатати, нет ни Perl, ни Bash. И ничего — работает как-то.
А вот попробуйте оттуда удалить модули, написанные на C…
Вы хотите сказать что языки со строгой/статической типизацией все находятся в стадии «бета» (== «ещё не доделан»)?Я хочу сказать, что с идиотами, записывающими в языки с динамической типизацией C и Java разговаривать бессмысленно. Хотя вас я идиотом не считал, но… теперь вижу._
Статически типизированный язык, между прочим
Да, предствьте себе — даже такая слабая типизация, как в C, и даже при такой ужасной культуре кода, как в openSSL (поговорите с теми, кто внутрь смотрел) всё равно снижает количество уязвимостей. В каком-нибудь NGINX — их меньше на порядок. В Chrome — да, побольше будет… но вы когда-нибудь сраванивали по объёму Drupal и Chrome? Сравните как-нибудь на досуге.
поэтому языки вроде C, C++, Java (и прочие языки традиционно ориентированные) — это языки, которые я противопоставляю высказываниям сектантов.У… как всё запущено. Что такое вообще «традиционно ориентированный язык»?
именно строгую типизацию сектанты вроде 0xd34df00d противопоставляют тестам.Серьёзно? У вас всё с логикой настолько плохо?
Извините, но я нигде и никогда не слышал, чтобы 0xd34df00d говорил о том, что типами нужно заменять тесты. Он всегда говорит о том, что можно — и да в Idris это попроще, а в C++… ну на спор, наверное, тоже можно, но в реальной программе — не получится.
Вопрос того, что нужно выражать ограничениями на типах, а что лучше оставить в виде тестов — он совершенно отдельный от вопросов принципиальной реализуемости того или иного подхода.
Давайте теперь Вы назовите пару монополистов, имеющих аудиторию в миллиард людей, чтобы их основной язык был со строгой/статической типизациейВы издеваетесь или как? Ну пусть будет Google и Microsoft, если уж так хотите. Только не рассказывайте сказок про то, что Microsoft меньшая монополия, чем какой-нибудь Facebook: в китае без Facebook отлично живут, а без Window — таки не обходятся. Ну или Apple возьмите — да, это не монополия… но денег она зарабатывают больше, чем Facebook и Mail.Ru вместе взятые.
то FaceBook — это PHP.Нет. PHP такую махину не потянет. Facebook — это Hack. И да — он статически типизирован.

На Java. Какой смысл уходить на Python для такой нагруженной задачи?
(распределённые базы данных или хотя бы SQL-базы, компиляторы, операционные системы и всё такое прочее) — так прям все на динимических языках начинают программировать?
Однако же поверх всех этих замечательных программ тут же возникают динамические языки — шеллы или тот же SQL. SQL сильно типизирован?
Совпадение? Не думаю.

Так никто вроде бы и не спорит, что в качестве glue code для одноразовых задач динамические языки вполне себе работают.
Совпадение? Не думаю.Нет, конечно. Как только вы решаете, что вам не нужен качественный код, но нужны дешёвые программисты — так динамические языки становятся, вдруг, резко осмысленными.
Программисты на PHP получают меньше, чем программисты на C++, а администраторы («программисты на bash») — ещё меньше.
В некоторых случаях возможна и обратная ситуация (финансовый аналитик, пишущий только программы на каком-то простеньком язычке, но никак не на C++ — может получать и больше программиста на C++), но в этом случае они получают столько не за то, что умеют лихо писать программы на Python, а за что-то совсем другое.
Где-то тут уже приводил: в Киеве разница между PHP и Javaсеньорами порядка 5% всего. Это во столько бизнес оценивает надежность статической типизации (забудем про то, что часто Java и быстрее)?

к чему тогда пассажи про "нужны дешёвые программисты — так динамические языки становятся, вдруг, резко осмысленными. Программисты на PHP получают меньше, чем программисты на C++"
У меня есть цифры, что эти "дешевые" лишь на 5% дешевле, а разница в качестве, вроде как, качественная, если верить адептам статики.
У меня есть цифры, что эти «дешевые» лишь на 5% дешевлеНет у вас таких цифр, извините. У вас есть информация про кое-что другое.
Разница между дешёвыми и дорогими программистами лишь слегка кореллирует с зарплатой.
Более того — в некоторых случаях программист, получающий более высокую зарплату может оказаться дешевле.
Подумайте над этим.
а разница в качестве, вроде как, качественная, если верить адептам статики.Разница качественная — но не между динамикой и статикой.
А между продукцией «дешёвых» и «дорогих» программистов.
Я это уже показывал на примере CVE.
И да, разница между зарплатами — гораздо меньше, тут вы, что забавно, тоже правы.
> В языке «ться» и «тся» не различаются, они различаются лишь на письме, которое представляет собой условность. Потому, собственно, их и путают на письме.
В языке у них разная роль, что можно увидеть, например, по тому, что для некоторых глаголов вместо "-ться" получается "-тись": нестись, пастись…
(это как раз о типизации;))
В фонетике, да, они сливаются — но уже после этого.
И если мы обсуждаем преимущества разных видов типизации, то, ИМХО, лишний раз указать на принципиальное различие между типизацией и рантайм-проверками, которое по-хорошему должно быть определено даже в терминологии, вполне себе стоит.
Так никто не против указывать на различия статической и динамической типизации. Более того, никто вроде не отрицает, что с некоторой точки зрения правильнее эти две альтернативы называть по-другому. Но для того, чтобы как можно больше людей, связанных с программированием, вас сразу без дополнительных пояснений правильно понимало, нужно использовать именно «статическая типизация» и «динамической типизация» — это устоявиеся названия классов языков. Можно для себя их называть как угодно, но все (?) официальные документы по динамически типизированным языкам программирования используют слова «тип» и «динамическая типизация»/«динамическая проверка типов» — например python, js. То же верно и для обсуждений этих языков на практике. Поэтому смена терминологии привнесёт только путаницу на этом этапе.
В моей IDE для хаскеля вообще нет рантайм-меток (да, я за всю практику пользовался Typeable в своём коде ровно один раз). Да и дебаггером я там не пользуюсь.
Если вы им не пользуетесь это не значит что его нет. Я посмотрел — оно умеет как-то определять тип в рантайме.
Кстати, определите до конца термин "рантайм метка" он не отражает метка чего именно.
В моей IDE для плюсов их тоже не особо много для рантайм-поведения.
А что у вас за IDE для плюсов? У вас там нет cимволов и RTTI? в окне watch нет колонки type для переменных? Или там написано что-то типа "рантайм метка относящаяся к набору операций которое можно совершать со значением"?
А зря. На мой взгляд, создаёт неправильные ожидания.
Какие и у кого?
Не обязательно. В том же хаскеле в общем случае после того, как вы проверили типы, вы можете их стереть и не иметь вообще ни намёка на них в рантайме.
Я хаскель знаю очень поверхностно. Мне трудно с этим поспорить.
С моей точки зрения, терминология, которую вы предлагаете требует введения разных слов для одного и того же и необщепринята, т.е. никакой выгоды от нее нет.
прекрасный термин, и никого не обманывает

Скорее не линтерами, а статанализаторами. Да, если использовать все возможности языка на полную, не помогая анализатору тайпхинтами и аннотациями, то много ошибок типов будет как ложно положительных, так и ложно отрицательных, но тем не менее как современные IDE, так и отдельные статанализаторы широко используют информацию о типах из исходников.
Можно писать на Idris и эммитить код на PHP

Тот, кому первому пришла в голову идея назвать рантаймовый контроль типов «типизацией» — будет вечно гореть в аду за обман джуниоров.
А как по вашему это нужно называть?
Типизация в PHP как была динамической и слабой, так и осталась. И нет никаких предпосылок к изменению этого положения.
Контролем типовВроде это по определению делается во всех системах с проверками типов. Ну там Rust, Haskell. На другом этапе, конечно.
Я не понимаю отчаянного сопротивления применению определенного уважаемого термина к РНР и попыток его замены на какой-нибудь другой, не такой уважаемый.
Типизация в PHP как была динамической и слабой, так и осталасьКстати, вы будете гореть в аду
Тот, кому первому пришла в голову идея назвать рантаймовый контроль типов «типизацией» — будет вечно гореть в аду за обман джуниоров.
Если это не typing (типизация), то как сообщить другому человеку «Я придумал ЯП с динамическим blabla» и остаться понятым?
«Можно ли на этой переменной дёрнуть эту функцию?»Но если мы хотим донести, что эта переменная ведёт себя как string ибо помечена таковой средой выполнения, то нам придётся долго перечислять список функций (и всё равно можем не попасть, потому что у другого типа может быть такой же, но он к примеру несовместим со string). Нам же нужны обобщения.
вы придумали язык без статической типизации.Это можно, да. Термин взаимоисключающий.
Проблема в том, что всё это противоречит естественному языку как средству коммуникации. Лучше было бы придумать для формальных понятий другие слова, например «типоид» и «типоизация». Тогда можно было бы смело поправлять других «Вот это ни в коем случае нельзя называть типоидом по определению», «в этом ЯП не может быть никакой типоизации» и никто бы и слова против не сказал.
Я не знаю, как это было с исторической перспективы, но сейчас частичное пересечение узкоспециального термина с широким общим играет отрицательную роль для первого.
Но да, это не про питон.
Можно просто сказать, что вы придумали язык без статической типизации.
Это может быть и безтиповый язык типа популярных ассемблеров.
А джунам тем стоит взять JSP если уж на то пошло)

В "компайл-тайме" в клиентской коде мы не можем знать что загрузит автолоалер или какая имплементации интерфейса придёт. Вообще проверки не будет?

Компайл тайма нет. Проверка будет только при статическом анализе и канеш в рантайме. Поэтому индустрия пыха требует монструозного техпроцесса на нескольких стадиях.
Ну какой-то компайл тайм есть: преобразование в опкоды. В рамках одного класса можно было бы в нём что-то по минимум проверить, но вот весь проект проверить нереально, по крайней мере с доминирующей моделью автолоадинг классов.
С Java или С# о компиляции в байт-код говорить можем, а с PHP не можем?
А 8 с JIT уже есть https://github.com/php/php-src/blob/master/UPGRADING :)
Java на JIT, насчёт C# не могу сказать ничего. А 8 с JIT ещё только в альфе, первый релиз-кандидат вроде как только осенью будет, а сам релиз в декабре.
В пыхе компиляция пока что относится только к сборке самого бинарника руками) А наш с вами код интерпретируется, это сильно другой процесс.
В альфе, но есть :)
Тут о терминах можно спорить долго. javac запускает компиляцию в байт-код, который отдаётся виртуальной машине. Раньше она его просто интерпретировала, сейчас JIT везде или почти везде. php запускает компиляцию в байт-код, который отдаётся вирткальной машине. раньше она его просто интерпретировала, сейчас JIT в мастере. В чём качественная разница? В отсутствии файла с байт-кодом?
Вопрос ведь не в терминах, ну и не спорю, если грубо — то можно свести к фразе компилится.
Для меня лично компиляция — строго вне рантайма. Если код попадает в кучу когда пришли данные на обработку — интерпретация. Отсутствие файлика — огромная разница в процессе.
Ну и ещё у меня стойкое чувство, что вы меня стебете)
/ пошто пыхоиндуса обижаете? :( /
Ну вот JIT тогда не компиляция? Файлика нет же. :)
А если серьёзно, то в современной разработке грань между компиляторами и интерпретаторами размылась — слишком многое под капотом, на что программист никак повлиять не может обычно.
У вас слишком узкое представление.

PS На всякий случай подчеркну, это вопрос, а не утверждение.
Проверка типов происходит точно на рантайме, когда данные переданы в поток (то есть код уже в куче)
Если развернуто:
1. В зависимости от версии пыха и правил типизации (strict_types) проекта на этапе разработки (локально) доступны:
1.1. Анализ самого IDE в режиме реального времени
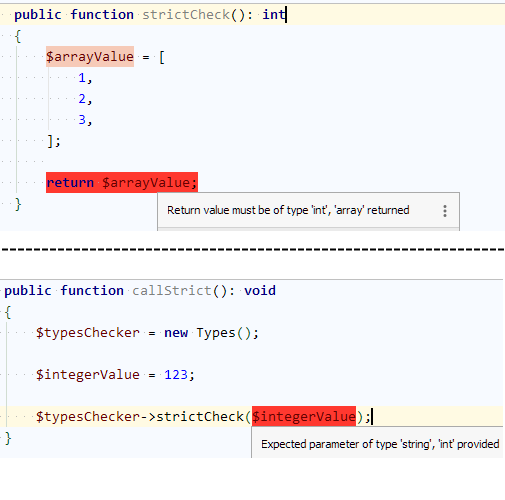
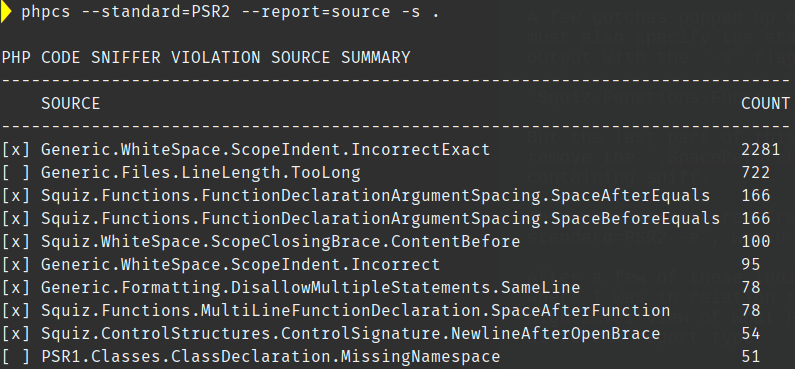
1.2 Встраиваемые пакеты для статического анализа codestyle
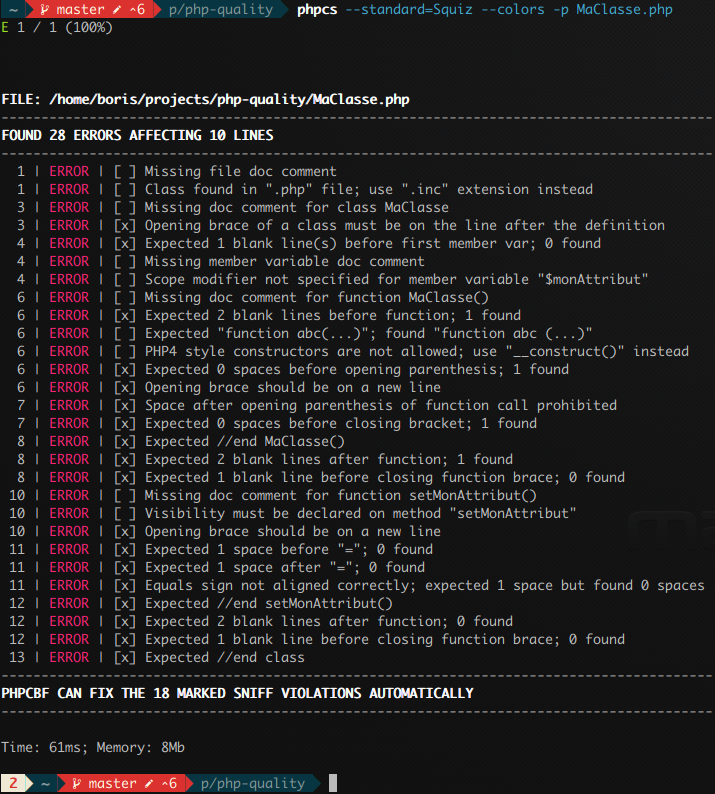
1.3 Встраиваемые пакеты для стат анализа codequality
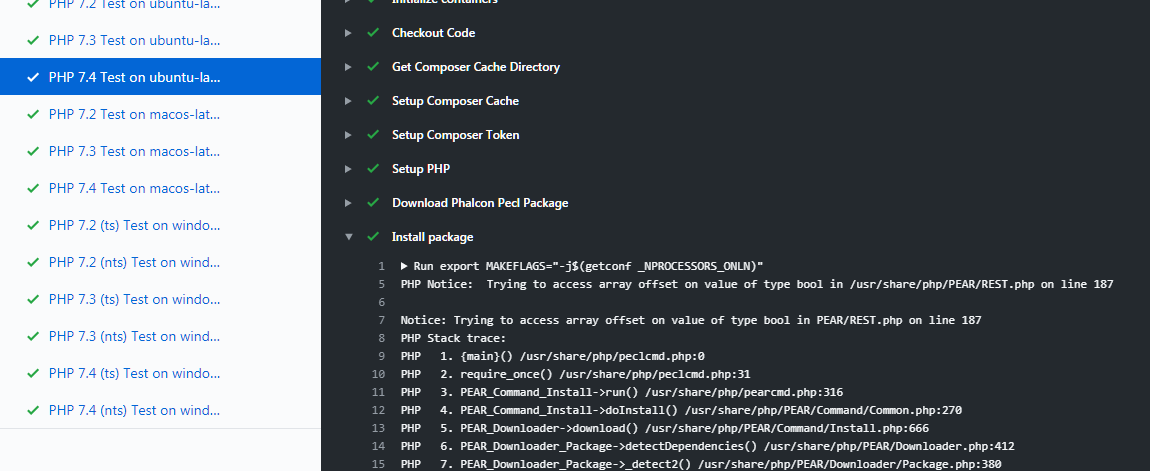
2. Дальше в крупных проектах CI/CD, со стендами для предварительных тестов регрессии, интеграции, фича тестов и вероятнее всего 1.2 и 1.3 повторные.
3. Дальше, в зависимости от критичности проекта, может быть ряд canary продакшн серверов, на которых крутятся «свои» юзеры, которые выступают в роли кроликов-тестировщиков.
4. Ну и сам прод собственно. Тут вызывается код, интерпретируется в псевдокод для виртуальной машины (например нгинкс), выполняется до определенного адреса, там происходит ошибка и бросается исключение (от нотиса до фатала) — вот последнее это рантайм.
А так, по топику могу сказать одно.
Типизация нисколько не спасает от багов на проде.
Чаще всего прод на пыхе страдает от кривой логики реализации бизнес-процесса или не до конца протестированных юзкейсов.
Орут о величии строгой типизации над динамически типизированными языками в основном фронтендеры, которые пересели с js на ts и решили, что они не верстальщики, а программисты =)


Не так плоха динамическая типизация, как ее сочетание со слабой, js, php привет вам.
Вот это уже взрывная смесь по производству багов.


print((not None) + 7)Типичная слабая типизация.
Да, у Python отсутствует автоматическое преобразование число<->строка и возможности преобразования None ограничены. Но в остальном PHP может обеспечить более строгий контроль типов. Аннотации типов аргументов подпрограмм в Python не обеспечивают контроль типов — в отличие от PHP, в котором реализуется реальный контроль и типов аргументов (с возможностью отключения преобразования число<->строка), и типа возвращаемого значения.

Сначала None автоматически преобразуется в bool, потом bool автоматически преобразуется в int.
Типичная слабая типизация.
Оператор not возвращает True или False. Тип bool унаследован от int, поэтому в арифматическом смысле True всегда равен 1, а False всегда равен 0. У вас не получится сделать None + 1.
gaal@catalina monitoring % python3
Python 3.7.6 (default, Dec 30 2019, 19:38:26)
[Clang 11.0.0 (clang-1100.0.33.16)] on darwin
Type "help", "copyright", "credits" or "license" for more information.
>>>
>>> print((not None) + 7)
8
>>> print(None + 7)
Traceback (most recent call last):
File "<stdin>", line 1, in <module>
TypeError: unsupported operand type(s) for +: 'NoneType' and 'int'Python 3.7.5rc1 (default, Oct 8 2019, 16:47:45) [GCC 9.2.1 20190909] on linux Type "help", "copyright", "credits" or "license" for more information. >>> not [] True >>> not "Oops" False
Операция «not» применима к чему угодно. То есть там «None» не преобразуется в Bool. А что
True/False — разновидности целых… это странно, но это Python унаследовал от C. Он ещё парочку странностей от него унаследовал…В моих книжках написано, что not (not x) = x для всех допустимых x, значит, None эквивалентно not (not None).
Ещё раз. У вас не получится сложить None и 1. Оператор not это логический оператор отрицания, который возвращает строго True/False. Двойное инвертирование True вернёт True и наоборот, эта цепочка из not not not [...] может быть бесконечной. Не понимаю, что мы обсуждаем?
Да, это всего лишь ещё один способ указать на unsoundness языка.
Ну, назовите это консистентностью языка. В целом проблемы нет, согласен.
Уже давно это не так.
Да, есть unsound-элементы, но они связаны с изначальными ошибками (или компромиссами) в дизайне системы типов, и о них думают, как бы их устранить.Лучше бы они подумали как «людям снаружи» дать доступ ко всему этому.
Либо объявите GHC «единственной правильной версией» (и тогда версии языка будут соответствовать резлизам GHC), либо сделайте уж, как в C++, регулярные релизы. А то официальной версии 10 лет, а что из бесконечного количества расширений и дополнений, доступных после этого, считать «официальной частью языка» — «снаружи» понять невозможно.
Далеко не у всех есть возможность следить за всей «движухой», если они хотят попробовать Haskell на примере задачи генерации какого-нибудь отчёта.
А с устранением косяков вопрос сложный, на самом деле: в Python считается идеоматичным не писать в
if всякие "== 0" или "== []" (хотя лично я это считают некрасивым как раз) из чего, как бы, очевидно следует, что и not должен работать со всеми типами — иначе будет нелогично.Де-факто это уже давно так.А как до этого догадаться? Захожу я на www.haskell.org (а куда надо было зайти?), открываю раздел с документацией — первым делом, первой ссылкой, меня отправляют на Learn You a Haskell for Great Good!, где есть прям целаю душешипательная история про то что Монада — это не Applicative. Ладно, это тьюториал, они часто не поспевают за развитием языка. Ищем описание языка… единственное, что там есть — это Haskell 2010. Если погуглить — можно на wiki найти информацию про Haskell'… ссылка ведёт на сайт, который не отвечает, а страничка на archive.org радостно сообщает, что Haskell Prime 2020 committee has formed — «свежая» новость от 2016го года.
Ну и куда мне идти, чтобы что-то узнать, а главное, как до этого догадаться?
Сравните с C++. Wikipedia отправляет на isocpp.org. Там есть анносы GCC 10.1 (релиз от 11 мая 2020го), есть ссылка на Core Guidelines, можно добраться до драфта (хотя было бы полезнее, если бы ссылка была бы поближе к корню isocpp.org, а так туда приходится идти через cppreference).
А где у Haskell-community что-то подобное?
P.S. У C++-комьюнити есть, правда, своя, особая фишка: бесконечные
draftы. Попытка найти хоть чего-нибудь отрелизнутое — обречена на неудачу. Нужно некоторое время «повариться», чтобы понять, что это — следствие бюрократии ISO, которое привело к тому, что все и всегда используют draftы. Релиз, типа-вроде-как окончательная версия, никого не интересует настолько, что если draft будет говорить одно, а релиз — другое, то реализуют именно draft: их используют разработчики компиляторов, программисты и вообще все, кто мало-мальски интересуется C++. А релизы? Ну их ISO за деньги продаёт, можно купить и положить на полочку. Всё. Больше в них никакого смысла нету. Да, этот «секрет Полишинеля» сходу, на web-сайте не найти…
1 + "hello" => TypeError (String can't be coerced into Integer)
А я говорю, что описание типов — и есть описание процессаЭ? Вообще-то описание _процессов_ — это функции/процедуры.

Код на динамических языках не только пишется легче, но и легче читается. Поэтому многие ошибки видны невооруженным глазом.
Но с определенного размера кодовой базы все связи уследить уже просто не возможно, и вот тут на помощь приходит статическая типизация.
В общем, для каждой задачи — свой инструмент.
Не совсем так. Динамически-типизированный код может вообще не отличаться от статически-типизированного, просто автоматический вывод.

function foo (string) : string { } // error В хаскеле сделано удобнее. Но это имхо и вкусовщина, не буду спорить если у кого-то другое мнение.

function f(a: number): string;попробуйте так

В Вашем варианте foo я понятия не имею, что за строку она от меня хочет, но стоит написать вот так:
function foo(userName: string): string;
И да, по-нормальному было бы вообще так:
function foo(userName: UserName): string;

Вобще-то даёт. Гуглите брендированные типы.
import {
$mol_data_nominal as Unit,
$mol_data_integer as Int,
} from "mol_data_all";
const Weight = Unit({ Weight : Int })
const Length = Unit({ Length : Int })
let len = Length(10)
len = Length(20) // Validate
len = 20 // Compile time error
len = Weight(20) // Compile time error
len = Length(20.1) // Run time error
let mass: typeof Weight.Value
mass = len // Compile time error
А Delpha/Pascal — это уже «закат эпохи». Когда теоретики заизолировались у себя в башне, а практики начали делать «удивительные открытия», известные теоретикам в середине прошлого века.
type UserName = string & { readonly tag: unique symbol };
type Password = string & { readonly tag: unique symbol };
const nameOf = (name: string) => name as UserName;
function stringOf(name: UserName): string {
return name;
}
stringOf(nameOf("bingo347")) // OK
stringOf("bohdan-shulha") // Argument of type '"bohdan-shulha"' is not assignable to parameter of type 'UserName'.
stringOf("hellowrld" as Password) // Argument of type 'Password' is not assignable to parameter of type 'UserName'.Вот я и говорю, что это не работает, любую строку можно просто привести к типу UserName без доказательства последнегоconst nameOf = (name: string) => name as UserName;
Я могу ошибаться, но вы именно о таком поведении писали в комментарии выше.
А как доказать, что строка, которая пришла с сервера, это действительно UserName, а не что-то иное?Проверить, что она соответствует всем ограничениям на тип UserName, если проверка успешна — я получу тип UserName, иначе получу ошибку. Другого способа получить тип UserName в программе нет, поэтому ему можно доверять. А вот типу, в который можно просто кастануть любую строку я доверять не могу, он для меня бесполезен.
Но я согласен с автором что «в продакшене» всё-таки лучше использовать языки со статической типизацией.

В плюсах же как раз есть пользовательские суффиксы.

Ну и, кроме того, всё уже сделано до нас: Boost.Unit
Писать много много оберток над тривиальными математическими операциями и сравнениями. Фактически копипаст. Нельзя просто сказать что вот этот int будет метры, этот секунды, а этот тугрики. Плюс взаимодействие сложных типов вышеупомянутое.

Там ограничения есть, например, для целого это всегда long long int, а зачем мне это, если я метры хочу только int32.
Другое дело, что можно все в классы обернуть… тогда точно, одно с другим не сложишь. Но это конечно дополнительно писать придется кода...
В C++ как раз сложишь, если оператор + переопределишь :)
И как так просто метры с миллиметрами сложить? Переопределить то можно… придется делать столько этих операторов, сколько типов собираетесь складывать.
Для такого есть std::ratio
Хорошо, Фаренгейты с Цельсиями.
температуру с температурой складывать нельзяВот у меня литр воды 20 градусов и 5 литров 50 градусов, как мне посчитать температуру смеси (пренебрегая теплопередачей посуде и воздуху)? Всегда думал что для этого нужно средневзвешенное значение находить (в кельвинах), а для этого множить на скаляры и складывать.

Фаренгейты и Цельсии изоморфны, можно перевести одно в другое и сложить.В том-то и дело, что они нифига не изомрфны. Сколько будет 1°C + 1°F? А фиг его знает: может быть 15⁄9°C, может быть -304⁄9°C. И без дополнительной информации вы это не узнаете.
Да, тут есть неоднозначность, каким должен быть тип результата, но это вполне может зависеть от вызывающего кода, и какой тип он там ожидает.Если бы речь шла только о типе результата — беды бы не было. К сожалению меняется ещё и значение этого самого результата.
Результаты, как несложно заметить, будут сильно разными.
Потому — только перевод в Кельвины (ну или, если очень приспичит, в Ранкины), потом что-то там можно считать…
Просто группа градусов как дельт действует (ну как в алгебре) на множестве градусов как температур с привязкой к абсолютному нулю или ещё чему-нибудь.Не совсем так. В отличие от времени для температуры ноль имеет чёткий физический смысл: это средняя квадратичная скорость поступательного движения молекул (вернее пересчитывается в неё через постоянную Больцмана. Потому для неё не нужны все эти сложности.
Но это только в Келвинах или Ранкиных.
Если же вы хотите что-то считать в Цельсиях или Фаренгейтах… то да, можно развести весь этот дуализм… но обычно не нужно. Ибо всё равно запутаетесь.
Вы как-будто в школе физику не учили. Первым делом в любой задаче было привести все параметры к СИ. С другой стороны это очень странная система, если вам приходится складывать такого рода значения. Но в целом проблема N+1 операторов существует. В соседней ветке предложили использовать Boost.Units для таких штук, но если я правильно понял доку, то там собственно все для единиц измерения СИ и его альтренатив вроде СГС. Если нужны будут свои собственные еноты на парсек в час, то кучу бойлерплейта писать все равно придется.
int meters = 1;
std::chrono::seconds seconds{1};
auto val = meters + seconds;А библиотеку обернуть:
int flib_mul2(int i){
return i * 2;
}
std::chrono::seconds mul2(std::chrono::seconds i){
return std::chrono::seconds{flib_mul2(i.count())};
}
int main()
{
std::chrono::seconds seconds{1};
auto seconds2 = mul2(seconds);
}
Haskell же!
{-# LANGUAGE GeneralizedNewtypeDeriving #-}
newtype Seconds = Seconds { getSeconds :: Int }
deriving NumRust же!
use derive_more::Add;
#[derive(Add)]
struct Seconds(u32);
Например squants:
scala> val energyUsed = 100.kilowatts * (3.hours + 45.minutes)
energyUsed: squants.energy.Energy = 375000.0 Wh
scala> val energyUsed = 100.kilowatts + 3.hours
^
error: type mismatch;
found : squants.time.Time
required: squants.energy.Power
В F# есть такая встроенная фича, называется units of measure. Очень удобная, в моём физическом коде пару ошибок помогла поймать.
Во многих других функциональных языках, в которых есть конструкции вида newtype, это также делается достаточно изящно.
(забавный факт: автор обсуждаемой статьи как раз тоже топит за F#)

В F# есть такая встроенная фича
Там степени только целые, а хотелось бы рациональные иметь.
Вроде в какой-то версии это допилили. У меня работает, например, такое:
[<Measure>] type cm
[<Measure>] type xx = cm ^ (1/3)
let a = 10<cm>
let b = 10<xx>(извините, хорошего примера я не придумал, и даже помню, как во времена введения этой фичи ломал голову — где она может понадобиться; ни одной физической величины, использующей такие единицы, мне в голову ни тогда, ни сейчас не пришло)


чем же js чист?


Несите нового!


Динамическая типизация — адское говнище
Погодите это про отсутствие типов а ля питон или разрешения типов компилятором в F# перед компиляцией?


Может все-же в некоторых ситуациях оно таки надо, м?
Да и те-же темплейты в C++ это шаг в сторону динамических типов…

Он шаг в сторону строгой типизации как раз
template <typename T>
class Summ
{
T x;
public:
Summ(T value): x(value) {};
Summ(): x(0) {};
Summ operator+(Summ const& rhs) const
{
Summ result ;
result.x += rhs.x ;
return result ;
}
};
Summ<int> sum0(0);
Summ<float> sum1(2.0f);
sum0 = sum0 + sum1 ; //Такое не проканает
int sum00(0);
float sum01(2.0f);
sum00 = sum00 + sum01 ; //а такое проканаетsum00 = sum00 + sum01 ; //а такое проканает
Предупреждение C4244: преобразование «float» в «int», возможна потеря данных
Warnings as errors и такое не проканает.
Это какой то специальный ворнинг, скорее всего с ключём диагностики, потому что GCC и Clang без ключей никаких ворнинга не дают. Это же не запрещено стандартом. Просто неявно тип катится к другому.
А так конечно со статическим анализатором можно все узкие места находить на этапе компиляции.
Для GCC есть -Wconversion
Естественно, что он не включён по умолчанию, так как обычно это ненужно.
Опции компилятора для того и есть, чтобы настроить под конкретные нужды. Компилировать без настроенных флагов, значит полагаться на дефолтные значения. Далеко не факт, что это те настройки, что требуются.
А каким образом темплейты — шаг в сторону динамики, непонятно.
Ну как-же. Вы ведь можете подставить в темплейт любой тип, или переменную, т.е. строгого типизирования нет. Понятно что с точки зрения компилятора все будет все равно типизировано строго, но с точки зрения программиста чем не «динамический» тип?
Собственно концепты и ввели чтобы изобразить что-то вроде типизирования для темплейтов.

any почти наверное означает, что где-то сделана ошибка
Либо что оно прилетело оттуда, где у вас нет власти
В играх ECS без std::any довольно сложно представить, особенно когда это дело еще из сети откуда-нибудь качается.
Если речь про примеры кода, то сходу едва ли. У нас используется для сериаизации-десериализации данных с нашей админки в основном. На основе json питонячий скрипт генерит шаблоны полей, магия макросв и бустовых лексеров и бустового же any (который собственно предок std::any) рождают на свет класс в который собственно грузятся данные с админки. Есть, конечно, альтернативы вроде того же protobuf с похожим пайплайном, но под наши задачи он не подходил т.к. для синхронизации шаблонов нужно было б делать правки полей в нескольких местах и перегенерациию также соотвественно в нескольких местах, а так в админке выставил галку на отгрузку, клиенту шаблон перегенерировал и пользуйся.
Как вариант могу предложить почитать расширеный вариант выступления разработчицы из chucklefish про переезд на Rust и собственно переходу к ECS архитектуре. Там есть кусок про AnyMap.
У вас же игровой движок — это по сути отдельная тьюринг машина со своим описаниям мира и мутациями над этим самым миром. Как там можно по-другому?
Неудивительно, что в тех же майнкрафтав на стандартных блоках умудряются вычислители собирать (ну, или на dwarf fortress)
Можно кучу лапши из классов, например. И если это не UE или Unity, то это довольно частое явление. Подсмотрите как делаются игры на каком-нибудь cocos2d-x или love2d, или новеллы на RenPy. Последним ECS редко нужна, например — там от того тьюринга только переключение экранов.
А что это она тьюринг машина? Может это просто лямбда-функция или декартово-закрытая категория (;
На хаскеле неплохо пишется ECS без std::any.
А много тех игр на хаскеле? Чтоб с графонием и грабить корованы можно было. Всякие шахматы и крестики-нолики в расчет, соотвественно, не берем. Использование ECS вне контекста игр тоже.
For science it worked flawlessly
Try using it for graphics
Write in C…
Какое количество требуется чтобы аргумент стал валиден?
Хотя бы штук 5 и суммарное количество игроков было хотя бы over 9000. Или хотя бы исходники размером с какой-нибудь battle fo wesnoth
Думаю у MagicCookies уже есть больше 9000 игроков. Плюс три игрушки только я сам написал. Думаю ещё одну можно найти.
А ссылки хоть на что-то можно посмотреть? Гугл выдает слишком разнообразную выдачу, включая мод на майнкрафт.
Я думаю можно просто пойти почитать реализацию ECS в хаскеле и посмотреть, что там используются вполне статические функции на типах, а не динамические касты.
Если я правильно прочитал, то вместо any у хаскела стирание типов происходит через Data.Proxy. Какие накладные расходы по памяти/процессору при этом возникают и возникают ли- для меня вопрос.
А вообще предложение почитать, что-то вроде
forall w m c. Set w m c => Entity -> c -> SystemT w m ()
довольно сомнительно. С синтаксисом хаскела знаком мало и гадать, что за однобуквенные параметры большого желания нет.
А ссылку на магические печеньки все же приложите.

Шаблоны в C++ это и есть, как сказал бы автор статьи, "адское динамическое говнище". И как раз в C++20 это попытались исправить так называемыми концептами.
Не понял, как темплейте и динамические типы вообще связаны? Темплейты наоборот — шаг в сторону строгой типизации… Каждый темплейтный класс — это новый тип. И по идее будет проблема, если вы будете их складывать, например, в случае складывания float с int.
template <typename T>
class Summ
{
T x;
public:
Summ(T value): x(value) {};
Summ(): x(0) {};
Summ operator+(Summ const& rhs) const
{
Summ result ;
result.x += rhs.x ;
return result ;
}
};
Summ<int> sum0(0);
Summ<float> sum1(2.0f);
sum0 = sum0 + sum1 ; //Такое не проканает
int sum00(0);
float sum01(2.0f);
sum00 = sum00 + sum01 ; //а такое проканает
Обобщенные, и динамические разные вещи. В обобщенную метод код будет подставлен все равно конкретный, с конкретным типом, где вы не сможете float сложить с int. Там будет либо float, либо int. И да, все это проверится компилятором, во время компиляции.
Не совсем так, если вы сделали условно обобщенный метод, который может считывать из файла float, или int. Откомпилировали программу с только float методом, так как предполагаете, что правильный файл всегда содержит только float и дали ему на вход int — он выдаст ошибку. А в вашем случае, любой файл подай на вход — он его обработает, только вопрос как?

Интересно, сможем ли мы зайти ещё дальше, и повсеместно взяться за формальную верификацию программного обеспечения? Ведь мало проверить соответствия типов — хотя, на мой взгляд, лучше, чем не проверять — в целях повышения надёжности было бы выгодно сделать невалидные состояния невыразимыми, и вообще, формально доказать, что софт работает корректно во всех возможных сценариях. К сожалению, сейчас такое экзотическое удовольствие дороговато.
Верификация дизайна намного проще, но для её использования требуется преодолеть культурный барьер. Думаю, ситуацию можно изменить. Двадцать лет назад автоматизированное тестирование и код-ревью были довольно экзотическими и нишевыми темами, но в конечном итоге стали мейнстримом.
— Почему люди не используют формальные методы? Хабр, 2019.
А в F# изобрели type providers. Которые, тем не менее, в продакшене пока встречаются нечасто.
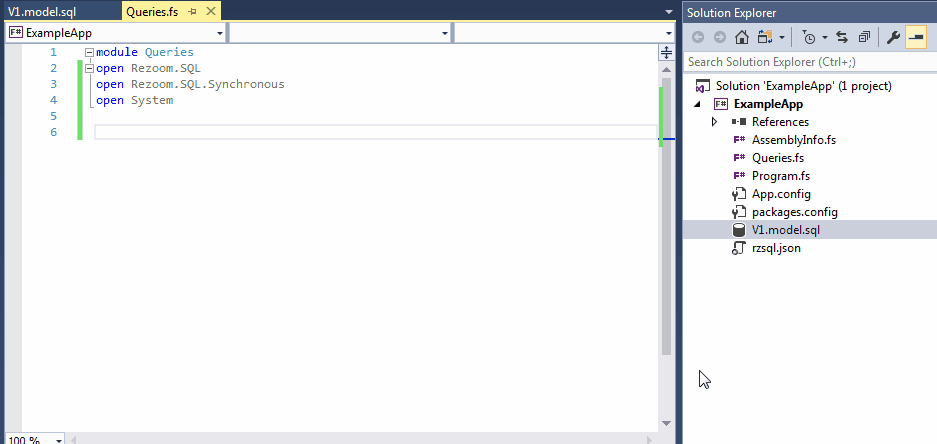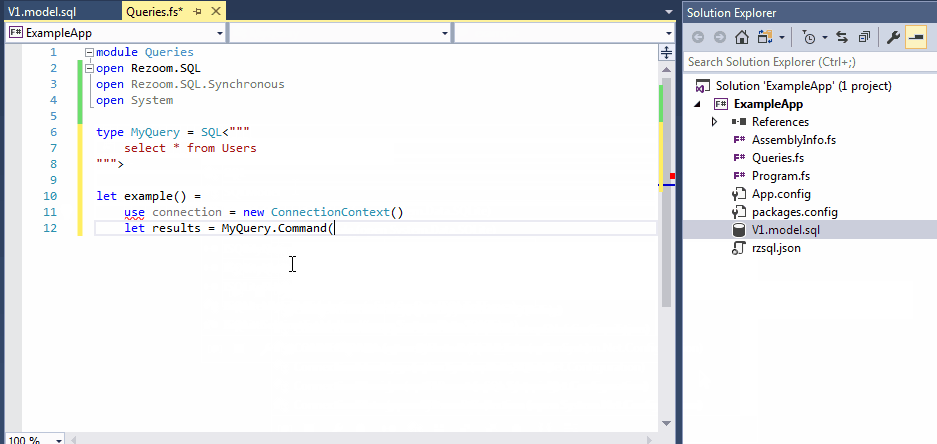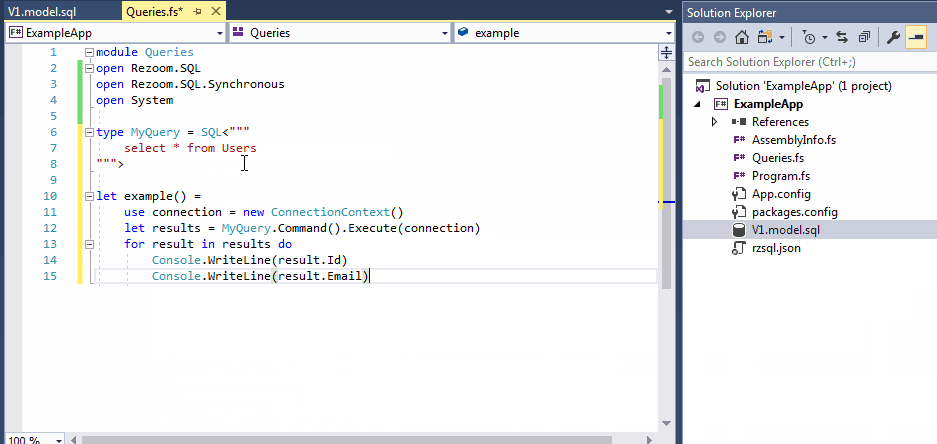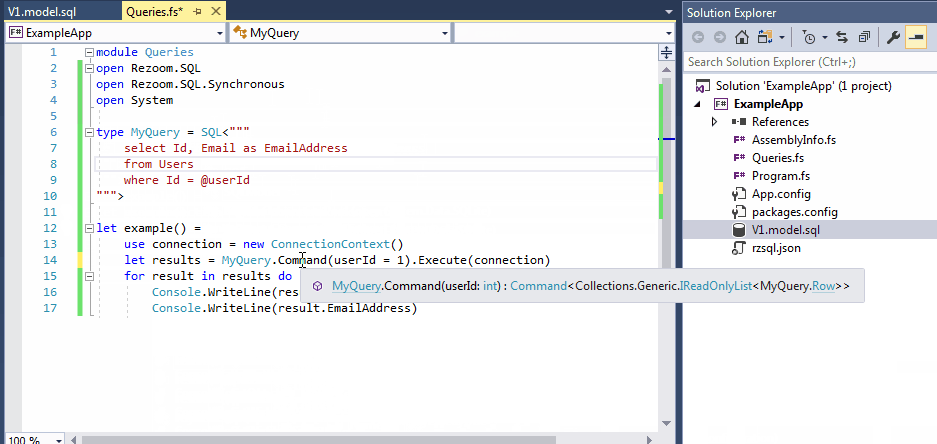

Интересно, сможем ли мы зайти ещё дальше, и повсеместно взяться за формальную верификацию программного обеспечения?
Сможем, когда придёт время:
«Formal methods will never have a significant impact until they can be used by people that don’t understand them» (с) Types And Programming Languages
Не думаю, что время, о котором тут говорит Пирс, настанет.
Я не думаю, что оно настанет в обозримом будущем.
Это, ну, как программировать, не имея ни капельки алгоритмического мышления.
К слову, нужен ли какой-то бэкграунд в математике/теории типов чтобы более-менее продуктивно писать на каком-нибудь Идрисе, или можно всё покрыть документацией(или книжкой по языку)?

Как там, кстати, поживает SQL для создания отчётов теми же менеджерами?
Вполне нормально живёт, если не требуется высокой производительности или если нет строгих требований к форме. Типовые задачи, вроде управленческого учёта, закрываются готовыми инструментами. Там где нет готовых, колхозят на коленке на SQL или на Excel или даже на R.
Если предположить, что SQL "отменят", то для простого подсчёта данных и фильтрации придется писать программу для чтения файликов.
"Менеджеры" в наше время уж точно такого не пишут.

А в F# изобрели type providers.
Выглядит круто. Аж захотелось на F# перейти.

в динамических языках а-ля жабаскрипт или РНР — строгая типизация только помогает при работе с большой кодовой базой, где уже есть своя куча классов и их иерархия и т.д.
если кодовая база маленькая — строгая типизация только мешает, т.к. создает накладные расходы на то, что нужно писать эти типы и поддерживать и не дает всех преимуществ динамического языка/интерпретатора.
Я люблю динамическую типизацию в маленьких программах узкого предназначения т.к. она позволяет полностью использовать всю экспрессивность языка и писать код очень быстро и эффективно.
Автор — а как вы думаете почему игровую логику везде пишут на Lua? Вот дураки игроделы, ведь на плюсах типизация гораздо лучше и компилятор дает гарантии
в динамических языках а-ля жабаскрипт или РНР — строгая типизация только помогает при работе с большой кодовой базой, где уже есть своя куча классов и их иерархия и т.д.
Я ни один скрипт не стану писать без типов, если его будет кто-то читать(а его будет, кроме единственного случая, когда я хочу что-то сделать и удалить на локальной машине). В случае PHP хотя бы psalm(костыль, конечно, но что есть).
если кодовая база маленькая — строгая типизация только мешает, т.к. создает накладные расходы на то, что нужно писать эти типы и поддерживать и не дает всех преимуществ динамического языка/интерпретатора.
1. Накладные расходы чтобы прописать тип который в голове и так должен быть — серьёзно?
2. Типы нужно поддерживать и в динамическом языке. Поддерживать, проверяя что код рабочий и типы те что ожидаются, и в статически-типизированном языке эту работу за вас сделает компилятор.
а зачем? вы приводите к строке то, что вам пришло из $_POST['fieldname']?
в таком случае просто типизации мало, нужно еще очищать пользовательский ввод от потенциально опасных данных (инъекции, xss) и ограничивать его по длине.
Т.е. типизация это всего лишь один из инструментов для гарантии правильной работы и даже он не дает всех гарантий.
например вам пришло $_POST['number'] в пользовательском вводе, которое вы счастливо приводите к int. Потом делите на него и потенциально получите либо деление на отрицательное число (что может не соотв бизнес логике) либо на ноль (что вызовет рантайм ошибку).
Т.е. типизация не заменяет то, что данные в динамических языках соотв. логике, надо следить чтобы данные были в корректных диапазонах и т.д.
если вы хотите городить иерархии классов на каждое поле в бизнес логике это просто отнимает время и раздувает код как в яве. Эти фактори. которые порождают фактори, которые используют билдеры, которые порождают фактори и так на 20 уровней вниз по стеку
Это можно делать как своими классами, так и простыми if/else, но ведь if/else это же не типизация?
динамические языки тем и сильны, что помимо системы типов есть другие вещи которые гарантируют корректность структур данных, например те же регулярные выражения — позволяют выразить сложную грамматику на уровне текстов, которая посложнее чем просто приведение к string.
Мне кажется типизация это не панацея, нужна культура кодинга где все данные проверяются на корректность максимально строго — именно это и дает в итоге правильно и безопасно работающие программы
Нужно еще поверх типизации, например кастования к int еще и проверять на корректный диапазон значений (чтобы не было отрицательного кол-ва товаров в корзине например).
Ну во первых вам никто не мешает создать свой «wrapper» для любого примитивного типа, который будет вам автоматом гарантировать что вы всегда находитесь в корректном диапазоне значений.
А во вторых в динамической типизации вам это точно так же надо делать. То есть никакого преимущества динамическая типизация вам здесь не даёт.
например те же регулярные выражения — позволяют выразить сложную грамматику на уровне текстов, которая посложнее чем просто приведение к string.
А с чего вы решили что регулярные выражения существуют только в языках с динамической типизацией?
Например, пусть в функцию суммирования прилетают два числа с ограничением
0 < Int < INT_MAX & Int <> 42. Что будет корректным типом для результата? Чтобы вывести, компилятор должен знать кое-что о целых числах, свойствах операции сложения и, возможно, переполнении.Реальный код, как правило, будет еще чуть более сложным, чем эта функция сложения. Даже если математика сойдется, то вы вряд-ли будете довольным временем, которое тратится на компиляцию.
И что-то я сомневаюсь что в языке с динамической типизацией вы найдёте решение проблемы которое будет сильно проще. Ну или как вы там будете складывать два таких числа и что получите в результате?
Ну или этой проблемы в динамической типизации быть в принципе не может? Или она там решается как-то более элегантно?
написал вам возможный вариант её решенияПока я увидел лишь отвлеченные размышления. Покажите примеры кода, где вы использовали на практике предложенный подход.
Если у вас такие проблемы встречаются часто, то вы можете перейти на язык со статической типизацией и они будут решаемы. Или вы можете показать мне ваши примеры кода из языка с динамической типизацией, где вы как-то по другому решаете эти проблемы. Более элегантно. Или более перформантно. Или ещё как-то по другому, но «лучше» чем мой вариант.
Или у вас таких проблем тоже нет и вы их просто решили высосать из пальца в попытке придумать пример с которым не справится язык со статической типизацией? Или как понимать вот этот ваш комментарий?
Насчёт примеров и простых случаев — в языке, на котором я пишу по работе, отсутствует Option/Maybe и почти все типы по умолчанию nullable. Сделать Optional на уровне типов — примитивщина, в разы проще тех же dependent types, но профит от неё огромен.
Собственно, мой поинт — у статик типизации есть sweet spots, где она не выливается в необходимость писать математические пруфы и позволяет реально улучшить качество и надёжность кода. Вполне возможно, со временем эта планка будет меняться и те же не отрицательные числа на уровне типов будут мейнстримом.
динамические языки тем и сильны, что помимо системы типов есть другие вещи которые гарантируют корректность структур данных
Простите, я искренне не понял — а в статических языках эти «другие вещи» отсутствуют?
Проблема, которую я лично вижу в статик типизации — слабые системы типов не всегда позволяют развернуться и приходится городить очень много кода. Однако, это не делает плохой статик типизацию per se.
проблема которую я вижу — в статической типизации — нужно перекомпилировать программу, или активно использовать рефлексию, чтобы добиться чтобы один метод работал с разными типами. А рефлексия это по сути и есть динамическая типизация. Ну и много кода получается, да.
в динамических языках не надо изменять код, там все это встроено. Код проглотит любой тип которые ему дали. Неважно строка вам прилетела, или число, если вы в итоге после всех проверок засовываете это в базу — он просто возьмет и запишет переменную. Что конечно не отменяет что нужн проверять данные на соответствие, но я могу эту задачу переложить на базу данных, если захочу.
присутствуют, но в виде уродливых темплейтов или менее уродливых дженериков.
Какие именно «другие вещи гарантирующие корректность структур данных» вы имеете ввиду? Конкретный пример можно?
Ну и желательно чтобы они были «не уродливее дженериков». Ну и неплохо было бы ещё увидеть объяснение в чём конкретно заключается и измеряется эта самая «уродливость».
проблема которую я вижу — в статической типизации — нужно перекомпилировать программу
Зависит от области, конечно, но в вебе, с которым я работаю, это не вызывает проблем. В чём именно ишью с компиляцией программы?
Код проглотит любой тип которые ему дали
Приведите пример такого кода и таких проверок, плз.


Причём написан многими людьми за пять лет.
Мне очень, очень хочется получить статическую типизацию для него, потому что сейчас каждое изменение кода это шаг в неизвестность. Я пристально гляжу на Haxe (у него есть целевая платформа lua), но пока не уверен, что переход себя оправдает.

Правильно говорить динамическая типизация в JS — говно. А не просто динамическая типизация — говно.
А так да, правильно, к одному ЯП надо прикрутить другой ЯП который бы проверял что прога написанная на первом ЯП -ок. Ну а потом еще один который бы проверил что то что проверяет второй ЯП это именно то что надо проверять а не что то другое. Ну а потом четвертый который всё то же самое сделает для третьего.
Система типов это фактически ЯП внутри ЯП. А что если проверять что то что написано на ЯП тем же ЯП? Получится TDD и отсутствие новых сущностей. Что есть гуд. А если программисту (т.е. нежелезному болвану) нужны какие то там подсказки к IDE — ну прикрутите их сбоку! Железный болван и без них сделает все что от него просят.

На разных языках решаю разные задачи, где то удобно со статической типизацией, где то с динамической.
А вы можете привести пример, где действительно удобнее применять динамическую типизацию?

Задача:
С порносайта сайта открытой библиотеки скачать все сочинения Ленина. Все кнопки скачивания помечены классом .button, везде в onclick заинлайнен обработчик.
Решение:
Array.from(document.querySelectorAll('.button'))
.map(a=>a.onclick.toString().match(/https:\/\/[^']+/)[0])
.join('\n')Полученный список url'ов скармливаем скриптику:
xargs -a library-lenin.urls -L1 -P8 wgetЗадача:
Посчитать время, потраченное на разработку нескольких формочек
Решение:
a = `5:11 2:41 1:31 3:8 1:6 2:31`.split(' ').map(a=>a.split(':').map(Number))
h = a.reduce((s,a) => s + a[0], 0)
m = a.reduce((s,a) => s + a[1], 0)
h += (m / 60) | 0 // float to int **magic**
m %= 60
console.log(`${h}:${m}`)Задача:
Полоучить строку из ASCII кодов.
Решение:
[97,67,101,123,114,99,84,84,101,104,95,116,48,121,125,116,53,52,115]
.map(a => String.fromCharCode(a))
.join("")PS. Под рукой всегда открыт браузер. И задачки решаются в одну строчку. На питоне их решать надо в несколько...
Задача:
С порносайта сайта открытой библиотеки скачать все сочинения Ленина. Все кнопки скачивания помечены классом .button, везде в onclick заинлайнен обработчик.
Тут показаны преимущества готового API в браузере, а не динамической типизации как таковой. Но удобно, да.
С остальными примерами, извините, не убедили:
Задача:
Посчитать время, потраченное на разработку нескольких формочек
Haskell:
totalTime s = (hours + minutes / 60, minutes % 60)
where
parsed = map (map read . splitOn ":") . unwords $ s
hours = sum . map head $ parsed
minutes = sum . map (!! 1) $ parsed
main = putStrLn . formatted $ totalTime "5:11 2:41 1:31 3:8 1:6 2:31"
where formatted (h, m) = show h ++ ":" ++ show mRust:
fn main() {
let parsed: Vec<Vec<u32>> = "5:11 2:41 1:31 3:8 1:6 2:31"
.split(' ')
.map(|s| s.split(':').map(|n| n.parse().unwrap()).collect())
.collect();
let mut h = parsed.iter().map(|nums| nums[0]).sum::<u32>();
let mut m = parsed.iter().map(|nums| nums[1]).sum::<u32>();
h += m / 60;
m %= 60;
println!("{}:{}", h, m);
}Задача:
Полоучить строку из ASCII кодов.
Haskell:
main = putStrLn . map toEnum $ [97,67,101,123,114,99,84,84,101,104,95,116,48,121,125,116,53,52,115]Rust:
fn main() {
let s = [97,67,101,123,114,99,84,84,101,104,95,116,48,121,125,116,53,52,115]
.iter()
.map(|&n: &u8| n as char)
.collect::<String>();
println!("{}", s);
}Я бы не сказал, что это сильно сложнее.
С экспрессивностью и удобством хаскеля для такого рода задач я спорить не буду, прекрасный язык)
Тут показаны преимущества готового API в браузере, а не динамической типизации как токовой.
Позвольте, .onclick, как и .match(..)[0] могут вполне неиллюзорно выкинуть undefined, и писал бы я на ts, обязательно пришлось бы его убеждать, что я понимаю что происходит с помощью as. В данной задаче я просто знаю о данных больше, чем о них знает исполнитель. Именно в этом доверии к моим умозаключениям и заключается удобство — я знаю лучше и мне не надо никому это доказывать, тем более глупой машине.
Вы же во всех примерах с растром именно занимаетесь тем, что доказываете что лучше его знаете данные (.parse().unwrap(), sum::\<u32>). А ещё вы напрямую сталкиваетесь с самой системой типов — руками говорите, где u8, потому что другие беззнаковые нельзя просто так скастовать к символу, не встретив угрюмую морду rustc.
Конечно, к этому постоянному доказательству, что ты не верблюд, привыкаешь. Но лично мне легче за 3 секунды написать однострочник, который через следующие 3 секунды канет в лету, без явного объявления, что я хочу отстрелить себе ногу, потому что я знаю что не отстрелю.
Ну и ещё один плюс, почему я привёл примеры на js, а не на питоне например — alt + tab, f12 намного быстрее нажимается, чем подождать пока загрузится текстовый редактор и ещё подождать пока rustc выругается на тебя кучей предложений по тому как код писать красивее и правильнее, хорошо если скомпилирует ещё.
Ну и ещё один плюс, почему я привёл примеры на js, а не на питоне например — alt + tab, f12 намного быстрее нажимается, чем подождать пока загрузится текстовый редактор и ещё подождать пока rustc выругается на тебя кучей предложений по тому как код писать красивее и правильнее, хорошо если скомпилирует ещё.
Я тоже IDE не запускал, я просто play.rust-lang.org открыл.
Ну и я не про ide говорил, а про редактор) Но согласитесь, это ожидание, что ты где-то забыл что map работает со ссылками, или что он не выведет сам collect остаётся даже когда ты достаточно много писал на расте. Эдакое ощущение что сейчас тебя учитель будет ругать за то что в хорошем сочинении таким корявым почерком написал все. Хотя может такое глубинное ощущение испытываю только я при компиляции на любом языке… Зато в динамических получишь как Цезарь без объявления войны нож в спину, а иногда и несколько ножей)
Мой изначальный тезис состоял в том, что в задачках, где ты все решение 10 строчек кода, использование типов является излишней работой, ведь ты сам контролируешь все. И отрицать существование такого класса задачек к сожалению не получится.
Позвольте, .onclick, как и .match(..)[0] могут вполне неиллюзорно выкинуть undefined, и писал бы я на ts, обязательно пришлось бы его убеждать, что я понимаю что происходит с помощью as
Если Вы уж так уверены, что там точно нет ни одного undefined/null, то на ts добавится всего 2 символа:
Array.from(document.querySelectorAll('.button'))
.map(a=>a.onclick!.toString().match(/https:\/\/[^']+/)![0])
.join('\n')
Хотя гораздо безопаснее все же написать так:
import {fromNullable, andThen, map, unwrapOr} from '@lambda-fn/option';
import {pipe} from 'ramda';
Array.from(document.querySelectorAll('.button'))
.map(a => pipe(
andThen(fn => fromNullable(fn.toString().match(/https:\/\/[^']+/))),
map(matched => matched[0]),
unwrapOr('')
)(fromNullable(a.onclick))
)
.filter(url => url !== '')
.join('\n');
Реклама хацкеля удалась, зачет )
Крутой пример решения, и задачка интересная. Всегда любил такие простые но экспрессивные примеры на хаскеле. К сожалению задача не входит в тот класс задач, что показывал я. Да и система типов тут не очень то и роляет. Тут роняется наличие оператора паттернметчинга (в принципе вполне заменяемого на switch в js) и самое главное генераторов списков.
А можете припомнить время, за которое нужно было 2к-ты элемент найти? Я бы хотел попробовать решить такую задачку.
N = 2000;
start_ijk = {
i: 0,
j: 0,
k: 0
};
list = {
v: start_ijk
};
list_last = list;
nums = {};
nums_count = 0;
function getNum(v) {
return Math.pow(2, v.i) * Math.pow(3, v.j) * Math.pow(5, v.k);
}
function expand(v) {
if (nums[getNum(v)] == undefined) {
list_last.next = {
v: v
};
list_last = list_last.next;
nums_count++;
}
nums[getNum(v)] = true;
}
while (nums_count < N) {
expand({
i: list.v.i + 1,
j: list.v.j,
k: list.v.k
});
expand({
i: list.v.i,
j: list.v.j + 1,
k: list.v.k
});
expand({
i: list.v.i,
j: list.v.j,
k: list.v.k + 1
});
list = list.next;
}
let max_in_loop = Math.max.apply(null,
Object.keys(nums).map(Number)
);
while (list) {
if (getNum(list.v) < max_in_loop) {
expand({
i: list.v.i + 1,
j: list.v.j,
k: list.v.k
});
expand({
i: list.v.i,
j: list.v.j + 1,
k: list.v.k
});
expand({
i: list.v.i,
j: list.v.j,
k: list.v.k + 1
});
}
list = list.next;
}
nums_array = Object.keys(nums)
.map(Number)
.sort(function(a, b) {
return a - b;
});
//console.log(nums_array);
console.log(nums_array[N]);Работает менее секунды, однако не факт, что решено правильно. Ответ получился 8153726976.
Я бы вместо объектов для проверки решенности воспользовался бы Set, он обещается побыстрее быть особенно на моменте приведения строковых ключей к чиселкам.
Да и я вот пока думал, кажется совершенно необязательным одновременно во все стороны из каждого состояния идти.
Ну и ещё тут у вас ошибка с next, который почти всегда будет указывать только на увеличение k.
N = 5000;
start_ijk = {
i: 0,
j: 0,
k: 0
};
list = {
v: start_ijk
};
list_last = list;
nums = {
1: true
};
nums_count = 0;
function getNum(v) {
return Math.pow(2, v.i) * Math.pow(3, v.j) * Math.pow(5, v.k);
}
function expand(v) {
if (nums[getNum(v)] == undefined) {
list_last.next = {
v: v
};
list_last = list_last.next;
nums_count++;
}
nums[getNum(v)] = true;
}
while (nums_count < N) {
expand({
i: list.v.i + 1,
j: list.v.j,
k: list.v.k
});
expand({
i: list.v.i,
j: list.v.j + 1,
k: list.v.k
});
expand({
i: list.v.i,
j: list.v.j,
k: list.v.k + 1
});
list = list.next;
}
let max_in_loop = Math.max.apply(null,
Object.keys(nums).map(Number)
);
while (list) {
if (getNum(list.v) < max_in_loop) {
expand({
i: list.v.i + 1,
j: list.v.j,
k: list.v.k
});
expand({
i: list.v.i,
j: list.v.j + 1,
k: list.v.k
});
expand({
i: list.v.i,
j: list.v.j,
k: list.v.k + 1
});
}
list = list.next;
}
nums_array = Object.keys(nums)
.map(Number)
.sort(function(a, b) {
return a - b;
});
//console.log(nums_array);
console.log(nums_array[N - 1]);Всё так-же меньше секунды. Сколько ест не скажу, в браузере запускал.
Сколько на 5000 оно работает и сколько памяти ест?А что за проблемы вообще в это задаче? Тут даже Python ест какие-то копейки, пишется за минуту, работает секунду.
N = 5000
numbers = [1]
mt = 1
while len(numbers) < N or numbers[N-1] > mt:
numbers = sorted(list(set(numbers +
[n * 2 for n in numbers] +
[n * 3 for n in numbers] +
[n * 5 for n in numbers])))
mt += mt
print numbers[N-1]
P.S. Ленивость, кстати, в Python есть. Но это будут уже монстры как у Druu или samrrr… Зачем?
Чет жесть. Это же простой обход графа в ширину:
const next = (lst: number[]) => [...new Set([lst[0] * 2, lst[0] * 3, lst[0] * 5, ...lst])].sort((x, y) => x < y ? -1 : 1).slice(1);
const loop = (lst: number[], i: number): number[] => i === 0 ? lst : loop(next(lst), i - 1);ну или он же если перформансом упарываться:
function binarySearch(lst: number[], val: number) {
let m = 0;
let n = lst.length - 1;
while (m <= n) {
const k = (n + m) >> 1;
if (val > lst[k]) {
m = k + 1;
} else if (val < lst[k]) {
if (k === 0 || lst[k - 1] < val) {
return k;
} else {
n = k - 1;
}
} else {
return k;
}
}
return -m - 1;
}
const insert = (lst: number[], val: number) => {
let i = binarySearch(lst, val);
if (i < 0) {
i = lst.length;
}
if (lst[i] !== val) {
lst.splice(i, 0, val);
}
};
const next = (lst: number[]) => {
const fst = lst[0];
insert(lst, fst * 2n);
insert(lst, fst * 3n);
insert(lst, fst * 5n);
lst.shift();
};
const loop = (i: number) => {
const lst = [1n];
while (i > 0) {
next(lst);
i--;
}
return lst;
};хз как на js быстрее, там уже рядом начинаются тормоза splice/slice и бигнумов
Хз, у жс свои взаимоотношения с массивами. Если на списках переделать (но тогда бинарный поиск работать не будет), то 3n*(средний_бигнум + указатели) выделено и мало в пике (размер списка очень медленно растет, на 1кк он что-то вроде 20к элементов).
Бтв решение samrrr с оценкой как я понимаю допиливается до константы (просто формулой считаем ответ :))
Соответственно, это можно считать в сильно сублинейной памяти
Я не про память, я имел ввиду, что в принципе, кажется, можно посчитать нужное число аналитически.
Потому что интересно же решать задачу так, чтобы она малой кровью работала с как можно большими порядками величины!Совершенно необязательно. Если мне задачу нужно решить один раз и получить ответ, то важным для меня будет время написание + время прогона. И для чисел до нескольких тысяч «наивное» решение достаточно.
В любом случае, это на полтора порядка больше, чем эмпирически необходимые ~30 мегабайт в случае с сублинейной памятью выше.Согласен. Вопрос только том, как часто такие задачи, удачно ложащиеся на ленивость, возникают на практике.
Платить-то за это приходится всегда, а вот прибыль получить… ну вот Вы, вроде бы, писали что-то реальное на Haskell. Как часто вас ленивость спасала? В реальных задачах, не в задачах с собеседования?
В любом случае, это на полтора порядка больше, чем эмпирически необходимые ~30 мегабайт в случае с сублинейной памятью выше.
30мб это сколько элементов списка имеется в виду?
Каждый раз, когда надо распарсить лог или бинарный файл на десяток-другой гигов и что-то там подсчитать. Делать это за константную память автоматически и не сильно об этом думая очень приятно.
Ну тут-то ленивость вообще не при делах.

Переписал ваш пример для читаемости
function generate(maxValue) {
const nums = new Set(), vecQueue = [ [0, 0, 0] ]
let maxInLoop = false
for(let [i, j, k] of vecQueue) {
const num = (2 ** i) * (3 ** j) * (5 ** k)
if(maxInLoop && num > maxInLoop) continue
if(nums.has(num)) continue
nums.add(num)
if(!maxInLoop && nums.size > maxValue) {
maxInLoop = Math.max(...nums)
// = 186264514923095700000
console.log('Max in loop:', maxInLoop)
console.log('Queue:', vecQueue) // length: 15_001
}
vecQueue.push([ i + 1, j, k])
vecQueue.push([ i, j + 1, k])
vecQueue.push([ i, j, k + 1])
}
console.log('Full queue: ', vecQueue) // length: 46_162
return Array.from(nums)
.sort((a, b) => a - b)
// .slice(0, maxValue)
}
console.time('test')
var values = generate(5000)
console.assert(values[1999] === 8062156800)
console.assert(values[4999] === 50837316566580)
console.log('Values:', values) // length: 15_387
console.timeEnd('test')0xd34df00d, время выполнения ~150ms, количество всех объектов подписано в коде. Вывод Node.js по памяти:
RSS: 22.6 MB (22634496)
HeapTotal: 12.9 MB (12890112)
HeapUsed: 5.9 MB (5918300)
External: 856.7 kB (856689)Я под ночь плохо представляю себе этот ряд полностью, но кажется что EQ не будет никогда и это вполне себе dead code.
В данном конкретном случае получить число 10 мы можем только вектором 1,0,1 (2^1 3^0 5^1). Может я не очень понимаю что-то про expand, но в такой вектор система может придти только однажды, вроде
2^i*3^j*5^k <=> (i,j,k)
10 <=> (1,0,1)
15 <=> (0,1,1)
Значит разные наборы ijk создадут разные числа и наоборот.
Но туда рантайм Haskell даже без программы не влезет, так что смысла в Haskell не будет точно.
Я придумал как решить эту задачку. Решается она все же больше математически чем программированием. Завтра днём покажу. Сразу скажу что Решать собираюсь графом… Ну и решается она к сожалению нифига не за линейное время...
import heapq
import itertools
def sequence(start=1, factors=(2, 3, 5)):
nums, prev = [start], None
while True:
if (current := heapq.heappop(nums)) != prev:
prev = current
for k in factors:
heapq.heappush(nums, current * k)
yield current
pos = 2001
print(next(itertools.islice(sequence(), pos, pos + 1)))8 строчек питона против 9 строчек хаскеля, считая саму функцию.
Даже корявая плюсовая реализация
int64_t get_nth(size_t pos) {
std::priority_queue<int64_t, std::vector<int64_t>, std::greater<int64_t>> nums;
nums.push(1);
int64_t prev = -1;
while (pos) {
int64_t top = nums.top();
nums.pop();
if (top != prev) {
prev = top;
for (auto k : {2, 3, 5}) {
nums.push(top * k);
}
pos--;
}
}
return prev;
}содержит всего лишь 13 осмысленных строчек.
Только вот сам пример не очень, потому что он демонстрирует решение ad-hoc задачи уровня "смотри как могу". В этих 9 строчках недостаточно когнитивной нагрузки чтобы статическая типизация начала помогать лучше понимать код и недостаточно практической применимости чтобы статическая типизация дала измеримый выигрыш в скорости.
Профиты типизации начинают появляться когда ты пишешь переиспользуемый код в котором ты должен быть уверен, и в который ты должен очень быстро въехать увидев его впервые или через 3 месяца после написания. Собственно именно поэтому в питоне более менее серьезные проекты обмазывают всё тайпингом.
А так, если стоит задача быстренько посчитать что-то здесь и сейчас — динамические скриптовые языки вполне удобны. Каждой задаче — свои инструменты.
p.s. а статика, конечно, лучше динамики для проектов на 1к+ строк кода.
А, хип импортируете…Тут, всё-таки, речь идёт про стандартную библиотеку, против стороннего модуля… но это уже всё к статике/динамике уже совсем никакого отношения не имеет.
Тогда можно было бы не писать mergeUniq руками, а взять что-то такое из уже готовых библиотек, и было бы две осмысленных строки хаскеля.
var a = "5:11 2:41 1:31 3:8 1:6 2:31".Split(' ').Select(x => new int[]{ int.Parse(x.Split(':')[0]) , int.Parse(x.Split(':')[1]) });
var h = a.Sum(e => e[0]);
var m = a.Sum(e => e[1]);
h += m / 60;
m %= 60;
Console.WriteLine(h + ":" + m);И никакой magic.
3 задача C#:
Console.WriteLine(
(new []{97,67,101,123,114,99,84,84,101,104,95,116,48,121,125,116,53,52,115})
.Select(e => (char)e)
.ToArray()
);.Select(e => (char)e)Разве Cast<char> не эквивалентен?

Cast<TResult>return (TResult)(object)x;А что случается после попытки анбоксинга в неправильный тип, думаю всем известно.
Условно говоря Cast несмотря на своё название вообще ничего не кастит, а лишь удостоверяется, что все элементы коллекции имеют нужный тип.
Круто! Ещё бы можно было писать просто parse, с последующим автоматическим выведением типов, как в расте, и все стрелочные функции заменить на выражения с it, как в котлине, и вообще пальчики оближешь)

Console.WriteLine("5:11 2:41 1:31 3:8 1:6 2:31".Split(' ').Select(i => TimeSpan.Parse(i)).Aggregate((s, i) => s += i));
bytearray([97,67,101,123,114,99,84,84,101,104,95,116,48,121,125,116,53,52,115]).decode('ascii')

Задача:
Получить строку из ASCII кодов.
Решение:
val a = "5:11 2:41 1:31 3:8 1:6 2:31".split(' ').map { it.split(':').map(String::toInt) }
var h = a.fold(0) { s, a -> s + a[0] }
var m = a.fold(0) { s, a -> s + a[1] }
h += m / 60
m %= 60
println("$h:$m")Чуть упрощенная версия:
var (h, m) = "5:11 2:41 1:31 3:8 1:6 2:31"
.split(' ')
.map { it.split(':').map(String::toInt) }
.reduce { s, a -> listOf(s[0] + a[0], s[1] + a[1]) }
h += m / 60
m %= 60
println("$h:$m")Задача:
Посчитать время, потраченное на разработку нескольких формочек
Решение:
arrayOf(97,67,101,123,114,99,84,84,101,104,95,116,48,121,125,116,53,52,115)
.map { it.toChar() }
.joinToString("")Количество приведений типов даже меньше (отсутствует float to int **magic** ;) )

Сделать класс контейнер в который возможно добавлять функции с любым количеством аргументов, после вызывать их по индексу из контейнера.
Например так:
void foo(int a) {}
void bar(std::string str1, const std::string &str2) {}
int main()
{
list_function_t list_function;
list_function.push(foo);
list_function.push(bar);
list_function[1]("Hello, ", "world!");
return 0;
}
Что делать, если по соответствующему индексу другая функция?
Это хороший вопрос, к сожалению если мы хотим получить return от функции, то место для обработчика ошибок будет занято return`ом. Есть не красивый вариант использовать объект list_function дальше для проверки
list_function.is_error();Ошибки мы можем получить разные, количество аргументов не верное, невозможно сопоставить типы аргументов между собой. Как вы понимаете если бы у нас был объект с динамической типизацией, мы бы могли выполнять проверки на типы на лету.
Но зачем это делать-то?
Одним из случаев может быть сервер/клиентский обмен пакетов с игнорированием сериализации/десериализации, которую мы делаем ручками. Мы просто получим send с множеством аргументов. В данном примере никакой статической проверки типов в рамках C++ невозможно.
Отмечу сразу что существует очень много подводных камней у этого примера.
Приведу еще один хороший пример, кстати последний случай моего использования контейнера функций.
Это просто работа с графом. Перебирать рекурсивно граф не очень удобно, поэтому я перебросил его на коллбек.
typedef graph_t<int> int_graph_t;
void test(int_graph_t *graph)
{
print_space(graph->level);
if (graph->is_root)
{
printf("is root ");
}
printf("%d %d %d parent value: %d parent index: %d\n", graph->level, graph->get_value(), graph->index, graph->parent->get_value(), graph->parent->index);
}
int main()
{
int_graph_t graph = 0;
graph.push(100);
graph.process_function["base"] = test;
graph.start_process();
return 0;
}
Если потребуется передать аргумент через start_process() в test(int_graph_t *graph), я просто это сделаю. Это насаживается на классы. Если мне потребуется реализовать новый вид функций, то я легко это сделаю добавив в process_function еще что-то.
Например JavaScript. :) Если смотреть с точки зрения рантайма, то благодаря динамической типизации экономится куча времени на старте программы, которую бы в противном случае приходилось делать браузеру для анализа корректности программы при каждой загрузке скриптов.
С позиции разработчика — формулы в Excel, bash, lua и прочие встраиваемые сценарии — где полезный эффект будет ничтожным по сравнению с трудозатратами на дополнительные церемонии с типами.
Если смотреть с точки зрения рантайма, то благодаря динамической типизации экономится куча времени на старте программы, которую бы в противном случае приходилось делать браузеру для анализа корректности программы при каждой загрузке скриптов.
А представьте, сколько времени можно сэкономить, не проверяя постоянно типы в рантайме!
экономия на типах не даёт никакого профита.
Угу, и именно поэтому V8 старается перевести JavaScript в типизированный код. Как и LuaJIT. И потому же PyPy выдаёт производительность сильно лучше CPython.
большинство программ 99.99% времени проводят в ожидании действий пользователя.
Но это не отменяет того класса задач, в которых программы не проводят 99.99% времени в ожидании пользователя.
А представьте, сколько времени можно сэкономить, не проверяя постоянно типы в рантайме!Проверка типов на старте программы это дополнительные секунды, когда пользователь результат не видит. Есть ненулевая вероятность, что большая часть поанализированного кода вообще не будет востребована на странице. В вебе идет борьба за микросекунды, поэтому все что можно отложить, откладывается до того момента, пока оно реально не понадобится. С дальнейшей оптимизацией хорошо справляется JIT.
Если вам нужен анализ кода и AOT — делайте это на сервере, один раз во время сборки для продакшена. Тащить все вот это в браузеры ваших пользователей нет ни какого смысла.
В вебе идет борьба за микросекунды, поэтому все что можно отложить, откладывается до того момента, пока оно реально не понадобится.Только какие-то не за те микросекунды там борются. Потому что перед тем, как на страничке появится первая буква, зачастую исполняется кода больше чем в каком-нибудь Turbo Pascal 7.0 в принципе. А это, так-то, была цела интегрированная среда со встроенным компилятором и дебаггером.
Тащить все вот это в браузеры ваших пользователей нет ни какого смысла.Ага. Зато 100 копий библиотек — тащить имеет смысл. Современный Web — это самое продорливое и тормозное изобретение человечества. У него много достоинств, но малое потребление ресурсов и отзывчивость — это не сюда.
Веб работает начиная с допотопных телефонов, телевизоров и вплоть до мощных ПК.Вы пробовали хотя бы вот эту вот статью открыть на «допотомном телефоне» или «телевизоре»? Попробуйте. У меня где-то Nintendo DS есть с модулем Opera, если что.
Наши бекендеры если время поджимает то и дело норовят перетащить куски логики на фронтенд потому, что тут разрабатывать в разы проще и быстрее.И это назвается «мы боремся за миллисекунды» и «допотопные телефоны»?
Не смешите мои тапочки: эпоха «лёгкого веба», который действительно стремился экономить ресурсы (потому что на сервере был мощный SGI или Sun, а на клиентах мог и 80386й оказаться с парой мегабайт памяти), давно прошла.
Сегодняшний веб транжирит ресурсы просто чудовищно и решает тривиальные задачи криво и плохо. Какой-нибубь «порхающий листик» (типа того, что в Windows 95) тормозит на компьютере с несколькими ядрами и гигабайтами памяти. Про «допотопных телефоны» и «телевизоры» лучше вообще помолчать…
Инженерные задачи от абстрактно логических отличаются там, что решаются всегда в ограничениях.Совершенно верно. Только нужно понимать какие именно ограничения у вас имеются и как вы с ними боретесь. И эти ограничения — это нифига не «допотопные телефоны» (про них уже все забыли давно и никакой веб там давно не работает) и не «миллисекунды» (если бы они были важны — то решения были бы тоже совсем другими).
Ограничение — это отсуствие качественного, грамотного, персонала, способного, как раз, сделать что-то работающее на допотопных телефонах (привет, Java ME) и «экономящих миллисекунды» (для этого есть C++, Rust, в некоторых случаях, возможно, Haskell, но ни javaScript с Babel'ем, ни Web вообще для этого не предназначены). Про WML, который действительно пытался что-то в этом направлении сделать, все уже давно забыли (да и негодная это была попытка изначально, если честно).
Такая потребность была всегда — и решение было тоже всегда (если вы, конечно, не аксакал, помнящий эпоху до JOSS).
Посмотрите на статьи про ретро-компьютеры: на Микроше был бейсик, на БК — ФОКАЛ.
Но никто нигде не пытался заявить, что они используют эти инструменты ради «экономии миллисекунд». Все понимали, что даже если программа, написанная на скомпилированном языке, будет запускаться чуть больше (на пару секунд даже) — это всё равно будет лучше для пользователя.
Я сам лично писал верификатор, который обрабатывал 150-250MB в секунду. Если у вас кода — несколько мегабайт, то он отрабатывает, с точки зрения пользователя, многовенно. А если уж вы грузите на клиента сотню мегабайт (неважно каких — JS или скомпилированного кода), то вас уж совершенно точно не будут волновать те 1-2 секунды, которые ваша программа стартует…
Бэйсик для Микроши позволял напрямую раотать с памятью и вызывать подпрограммы по адресу. Эти возможности часто использовались для "экономии миллисекунд" в том числе ассемблерными (вернее прямо в машкодах) вставками
Но это всё — уже следствие изначального выбора. Знаете, я регулярно общаюсь с людьми, которые «оптимизируют» свои решения на PHP, Python, да даже javaScript (хотя там сегодня уже реально можно делать вещи, которые будут «тормозными», а не «дико тормозными»). И, как правило, после того, как удаётся-таки получить реальные числа получается так: они подставляются в табличку, даётся прикидка «на пальцах» и «достижение», в 9 случаях из 10, превращается примерно в следующее: «мы смогли организовать умную схему базы и систему кеширования и теперь наш 64-ядерный сервер с SSD держит такую же нагрузку, как какой-нибудь одноядерный Pentium!!! на 1GHz начала века с HDD».
После чего остаётся только переспросить: «А вы точно уверены, что в вашей архитектуре главное — это „масштабируемость“, „эффективность“ и другие модные слова? Или, может быть, всё-таки зарплата людей, которых вы нанимаете на работу — важнее?».
И, заметьте, в ответе «да, нам нужны дешёвые и, соотвественно, тупые, программисты» я не вижу ровным счётом ничего зазарного: это — нормальный бизнес-подход. Нанять «таджиков» для копки погреба под три кадки с огурцами — вполне нормально. Но не нужно после этого заявлять, что два вас самое главное — соблюдение параметров проекта и санитарных норм. Не для этого вы «таджиков» нанимали, ведь согласитесь?
И да, в программировании, как и в строительстве, попытки нанять слишком неквалифицированную рабочую силу выходят боком… но это уже зависит от проекта.
С зарплатой мне как-то сложно судить. По опыту (PHP, JS/TS) с ФОТ порядка 5000$ нанять можно самых разных программистов. Одни шаг влево-вправо от любимого фреймворка и загребаются на несколько дней, другие плюют на фреймворк и пишут 10 строк "ванильных"
Незначительно больше, не настолько чтобы мотивировать меня переключиться с PHP на Java из-за денег.
Сложно сказать. Может у вас на Java пишут только вещи, которые на PHP написать сложно, а то и практически невозможно, а у нас то же что на PHP большей частью. Я вот у наших джавистов то, что видел на Sзring MVC кажется — большей частью можно копипастить в Symfony, убрать типы, синтаксис немного поправить и должно работать.
Вот, кстати, забавно, да. И PHP и Java по сложности практически одинаковы (кроме многопоточности, но, справедливости ради, отсобеседовав порядочно джавистов претендовавших на синьёра с большими деньгами, знания в этой области были даже не у каждого второго).
Да, вход в PHP попроще и наговногкодить там легче. Но если смотреть на задачи и требуемое качество от мидла и выше, то разница нивелируется. Мало того, дейстивтельно сложные задачи на джаве решаются легче и требуют меньше знаний. Т.е. синьёр на пыхе зачастую знает свой язык лучше, чем синьёр. на джаве. А зарплаты ровно наоборот. Мистика.
Звучит так, что изучить мне многопоточность и синтаксис, и можно на java сеньора подаваться :)
А с зарплатами может быть дело в том, что Java это не только веб, но и десктоп с мобайлом (не знаю на встраиваемых она ещё применятся или нет) и хорошо спеиалиста переманить больше желающих.
Звучит так, что изучить мне многопоточность и синтаксис, и можно на java сеньора подаваться :)
Можно, да не возьмут. Обязательно об опыте спросят :)
Но за годик, настрофигачив большое портфолио, вполне. Синьёр — это же не про синтаксис, а про принципы, архитектуру и опыт скорее. Так-то все ООП языки(с автоматическим управлением памятью) — близнецы братья.
Вот, кстати, забавно, да. И PHP и Java по сложности практически одинаковы (кроме многопоточности)
Ну, как уже написали выше, Java это ещё и куча десктоп-приложений и там есть своя специфика. Плюс многопоточность это не такая уж и мелочь.
Т.е. синьёр на пыхе зачастую знает свой язык лучше, чем синьёр. на джаве. А зарплаты ровно наоборот.
Ну так вопрос не в том кто там насколько хорошо что-то знает, а скорее в том что он с этими знаниями может. То есть что он в принципе может написать за приложения, как быстро он пишет код, насколько хорошо этот код работает, как выглядит с багами и дальнейщей поддержкой. И т.д. и т.п. И я не настолько хорошо знаю PHP чтобы с уверенностью говорить что он в этом плане хуже той же Java, но почему-то у меня такое впечaтление.
И если например сравнивать в этом плане Java и C#, то сами по себе языки более-менее одинаковы. Но вот если мы возьмём имеющийся тулинг, количество имеющихся open source пакетов и их доступность/простоту использования, то я бы сказал что C# всё-таки выигрывает.
Даже если целевая платформа Linux? Я знаю про .Net Core, но вот насколько тулинг и библиотеки представлены? GUI есть десктопный?
И как бы .Net Core вроде как бы и под линуксом работаeт. Есть та же Avalonia UI например и я ради прикола дома запускал Avalonia UI/.Net Core 3 приложения на линуксе. Но пока это всё ещё очень сыровато. И как минимум нам тогда проще на джаве сделать.
Ну вот именно Core работает вроде уже нормально. А вот насколько вся экосистема готова...
И лично я сейчас однозначно не буду делать что-то в продакт на .Net Core под линукс. Особенно учитывая что в этом-следующем году будет .Net 5 и там опять всё может поменятся. Ну или точнее я надеюсь что там многое поменяется в лучшую сторону :)
дешёвые и, соотвественно, тупые, программистыПо-моему, не стоит ставить знак равенства. Даже в одной и той же сфере с одинаковыми технологиями нет равенства из-за личных особенностей. В разных сферах будет играть всё больше рыночный фактор относительно используемых технологий и самой области применения.
В разных сферах будет играть всё больше рыночный фактор относительно используемых технологий и самой области применения.Собственно именно наличие рынка и должно приводить к тому, что дешёвые программисты будут тупыми. Рассчитывать на высококвалифицированных фанатов своего дела, готорых работать «за похлёбку риса» — неконструктивно.
Забавно, у меня на куда более слабом железе и Firefox последней версии всё нормально работает
При этом, так-то, Chrome ничуть не менее популярен, чем Firefox, «отмазаться» тем, что разработчики про него не знали не получится.
У вас нет «когнитивного диссонансса» во всей этой истории?
У меня, как ни странно, нет претензий ни к писателям на JS, ни даже к владельцам Хабрахабра: у них другие заботы, экономить чужие ресурсы они ни разу не обязаны.
Но ради бога, если вы «специалист по дендрофекальному методу строительства», то не рассказывайте никому о том, что вы выбираете этот метод за качество результата и можете построить хоть многокилометровый мост, хоть телебашню.


Аминь!
П.С. А ведь скрипты на хабре на .js =)
console.time(); $(':focus'); console.timeEnd()На этой странице выполняется 130мс. На каждое нажатие клавиши.
Boomburum пользователи страдают.

И язык тут — дело второстепенное, с тем-же JS можно прекрасно юзать статический анализ и тайп-линтинг с аннотациями в JSDoc. Типы — это вопрос архитектурный и пылать праведным хейтом стоит, разве что, в адрес плохой архитектуры но никак не стека и самой возможности использовать динамическую типизацию.
Нет, язык тут дело первостепенное.
Все попытки впилить статические проверки сбоку в языки без статической типизации обречены быть костылём.
Потому что эти типы не будет поддерживаться синтаксисом языка, потому что комьюнити динамических языков к ним в принципе будет настроено скептически, потому что это будет отдельный инструмент а не компилятор, и большая часть кода по прежнему будет без каких-либо типов.
Ну вот как-то в PHP нормально относятся к phpdoc аннотациям типа. Другое дело что сейчас бывают споры, а нужны ли они, если в язык добавили средства почти полностью их заменяюшие.
Как к этому относится какая-то ненавистная вам часть комьюнити — совершенно не важноЭто важно как минимум потому, что это самое комьюнити пишет код, с которым придётся взаимодействовать, и типы в нем либо будут указаны, либо нет.
В компилируемом языке вынос проверки типов в отдельный инструмент будет костылем, в скриптовом — нет.Во первых он будет костылём потому что он не сможет ничего гарантировать если часть кода будет писаться без типов.
Во вторых, если язык не поддерживает синтаксис для типов и всего что с ними связано, появляются сомнительные вещи в виде указывания типов в комментариях, а потом появляются эти комментарии в разных форматах для разных анализаторов.
В третьих, никакие стат. анализаторы рядом не стоят по удобству и надежности с компиляторами статически типизированных языков.
скепсис к типам — это ваша личная выдумка, напротив, все больше разработчиков начинает использовать подобные инструменты в обязательном порядке.
Нет, это вздор хотя бы потому что мы говорим о разработчиках которые уже выбрали динамические языки. Линтеры и подсказки IDE это не подобные инструменты.
Ваши личные эмоции тут не аргумент.
Аргументы вы почему то решили «не заметить».
Аргументы вы почему то решили «не заметить».
И я до сих пор их не вижу. «будет костылём», «рядом не стоят» — это все ваши эмоции.
Еще раз: в скриптовых языках дистрибуция происходит на более раннем этапе чем обработка в среде исполнения.
Это никак не оправдывает неудобство от динамики и не делает её удобнее.
И я до сих пор их не вижу. «будет костылём», «рядом не стоят» — это все ваши эмоции.
Тогда попробуйте наконец прочитать мой предыдущий комментарий полностью.
А то что вы ставите статическую типизацию в один ряд с необязательными линтерами для js'а говорит лишь о том что вы не понимаете о чём пишете.
Поэтому проверка типов и должна производится отдельно, ДО компиляции. Если говорить о веб-платформе — то там еще и большая сегментация самих сред, что добавляет
Тайпскрипт и другие компилирующиеся в js языки вполне себе показывают что веб-платформа и компиляция с тайп-чекером могут успешно сосуществовать.

Например когда работаешь с рефлексиями(что само по себе тоже не особо рекомендуется) или скажем с СОМ-объектами или c результатами динамических LINQ-запросов.
Но никому же не придёт в голову весь свой С# код перевести на динамическую типизацию.
ЕМНИП в .NET её завезли для более удобных поддержки динамически-типизированных языков и работы с COM'ом. Т.е. никакую отдельную задачу в шарпе dynamic не решал, а нужен был для интеропа.
В платформу .NET могли и завести, а в язык C# зачем?
Не сосем понимаю вопроса. Почему я сказал .NET а не C#? Не знаю. Может потому что dynamic добавили на уровне платформы, а не только языка.
Видимо неправильно понял без вашего контекста. Для меня звучит типа: платформе нужна была поддержка динамически типизированных языков и COM, поэтому добавили динамический тип. Ну и между делом в C#, раз уж в платформе уже есть. Для меня COM и прочие OLE только с C/C++ ассоциируются, что на C# кому-то с ними может понадбиться работать как-то в голову не приходило, хотя казалось бы...
Не подумайте, что «удобство» в данном смысле заменяет «правильно». Любое взаимодействие нуждается в проверке (и типизации, чаще всего).
Медленные тулы, потому что написаны на JS, а он к сожалению пока проигрывает компилируемым языкам. А "нормальные IDE для js" медленная только одна — WebStorm, потому что написана на Java, VSCode причём по-шустрее будет, и написан он на js (ts).
В общем, да, задумывались и знаем почему, удивляться тут нечему.
Я думаю тулы настолько медленные не столько от языка, а от того как они написаны.
От программы зависит. Как минимум V8 активно использует JIT c оптимизацией по типам.
Часто все упирается в ассимптотическую сложность, во всяких сложных тулах это особенно часто бывает.
Грубо говоря, неправильный алгоритм даст не в 10 раз просадку, а во все 10^n раз.
А если задача не cpu-bound, то основные тормоза как раз работа с io дает.
JIT может в каких-то случаях отбросить проверку, когда типы можно вывести статически.
Сейчас же function f(a,b){return a+b;} в JS не оптимизируешь.
Нет, совсем проверку типов он не сможет выкинуть, то есть он может запустить по быстрой ветке, но ему никто не дает гарантий, что в каком-то случае вместо int не прилетит string
Любой вызов внешней функции из такого цикла
f(i) = i^2
res = 0
for i in 1:1000
res += f(i)
endдолжен без проблем оптимизироваться нормальным JIT.
Любая функция, ходящая через границы сред исполнения, которую невозможно заинлайнить, ну например какие-нибудь built-in браузерные функции или любые нативные вызовы из nodejs.
Хорошо, а если она возвращает значение, как компилятор может доказать, что оно всегда int например? Никак, вот и обломинго с оптимизацией.
Фиксирован, но ведь js не знает об этом, внешняя функция может и не всегда один и тот же тип возвращать, типизация ведь динамическая, а если такая гарантия есть, то тогда мы приходим к типизации статической.
function f(a,b){return a+b;}
sum=["", 1, " thing ", 12, " things"].reduce(f);
console.log(sum);а jit скомпилирует две реализации функции f — f(string, string) и f(string, int).
И получатся шаблоны из С++. В таком случае это уже статическая типизация и есть.
Ну так этот пример JIT может оптимизировать ещё и лучше, чем статический компилятор (если он вообще сможет такой код скомпилировать).
С помощью С++ и магии шаблонов скомпилится, и будет работать быстрее. Так как будут проверятся id типов, а не строковые названия типов.
Ничего не мешает jit'у после некоторого количества итераций, когда соберётся статистика по типам с которым вызывается f()
Это не позволит обогнать C++, так как в C++ будут заранее созданы эти варианты и не придётся постоянно считать, сколько раз и с какими аргументами вызвана функция.
Статическая типизация в смысле c++ здесь никак не поможет, ведь во время компиляции вообще неизвестно, что в массивеВ массиве всегда будет ограниченный набор типов, не бывает так, чтобы хранилось неизвестно что. Но никто не мешает сделать std::variant по всем типам используемым в массиве.
Если jit начнёт создавать варианты одной функции, оптимизированные под конкретные типы, то выйдет тоже-самое что и делают сейчас шаблоны в C++.
Насколько я знаю с++, шаблоны специализируются только по compile-time типу. Но за всякими новыми добавками после с++11 не слежу, может туда уже полноценную динамику ввели :)

Не стану высказывать здесь своё мнение. Все знают, что в Erlang динамическая типизация. Но вот (к сожалению не вспомнил, где об этом прочитал), Джо Арстронг, автор Erlang, как-то посетовал, что жалеет, что в Erlang изначально не предусмотрели статическую типизацию, и что был проект по её внедрению в него, но когда он был готов на 95%, оказалось, что оставшиеся 5% реализовать невозможно.
Нашёл другое интервью с Армстронгом https://www.infoq.com/interviews/Erlang-Joe-Armstrong/, где он ратует за статическую типизацию и признаётся в любви к Haskell.
Тут пожалуй полезно будет потом их собирать в доходчивые F.A.Q. Чтобы была прямо удобная выжимка.

намного выгоднее.
Но, кажется для вас эта информация и так известна:
«Внутренности вордовских файлов: просто ужас»
«Привет из мезозоя»
Одни из самых популярных ваших статей, и они прям разжигают) Да, тоньше чем это сделал fillpackart, но принцип-то тот же. И судя по тому, что в эту статью я зашел из топа за сегодня, количеству ее оценок и т.д. — разжигать толще тоже можно, просто запас кармы нужен)
Это уж точно лучше, чем быть «серьезным взрослым человеком», составляющим свое Очень Важное Мнение по паре фраз, не читая весь текст)
Вы ведь тоже вряд ли читаете бульварные сайты, надеясь случайно найти там шедевры духа или чтобы быть уверенным, что ничего не пропустили.
Что же касается меня, то я, ценя литературные таланты автора, прочитал данную статью целиком и вынужден констатировать, что она несколько ниже его обычного уровня.
Я же всего лишь имел в виду, что подобная статья привлечет скорее любителей развлечений (типа холиваров), чем профессионалов.
Если тебе просто важнее самоутвердиться, то конечно, а вот практической пользы больше все же от фака, его меньше холиворить будут, но читать точно станут.

> писать, что ты идиот
>> аргументированное
И какой вывод для себя тут можно сделать?

Так это же вполне себе решаемая проблема.
Какое решение порекомендуете?
The goal is to define a datatype by cases, where one can add new cases to the datatype and new functions over the datatype, without recompiling existing code, and while retaining static type safety (e.g., no casts).Так, что она напрямую связана со статической типизацией.

К сожалению, разница в том, что 20 часов ты ищешь баг УЖЕ с деньгами за проданное ПО, а вот 5 часов думаешь над типами ЕЩЕ без денег. И это самое бабло решает все.
П.С, У меня вот тут почему-то код на perl не работает, может кто поможет?
$??s:;s:s;;$?::s;;=]=>%-{<-|}<&|`{;;y; -/:-@[-`{-};`-{/" -;;s;;$_;seeЯ в своей практике сталкивался только со стартапами, а они по неустойкам не платят, максимум — возвратят деньги.
Я думаю риск довольно разумный — все таки ты держишь деньги в руках, а как оно там дальше пойдёт — вдруг повезёт?)
Кроме того, бэклог по багам есть всегда. Понять что из-за типизации их там на 30% меньше, с учётом того что ты НЕ видишь как оно могло бы быть, для менеджера ( Читай бизнеса ) не представляется возможным.
А вот цена и срок MVP — величина конкретная.
П.С. Для чувства риска и адреналина можно в рулетку сыграть.
Абсолютно точно, именно такой подход. Только на совещаниях надо говорить «Полный Agile с максимальным учётом пользовательского фидбека». Ну или не работать в стартапе, если тошнит. Но мы к сожалению идём туда прямым ходом, и вероятно это единственно верный подход в высококонкурентном капиталистическом мире
вероятно это единственно верный подход в высококонкурентном капиталистическом мире
Ну это вы прям загнули :) Программирование в стольких сферах применяется, что выбор огромный. И это именно выбор — никто не заставляет выбирать конкретный путь, и более того — его можно спокойно менять с одного на другой.
Скорость исправления ошибок в основном зависит от того, насколько просто человеку разобраться в проблеме и локализовать изменение. Мудреные решения не всегда этому способствуют, скорее даже наоборот. Самое накладное в поддержке большого проекта, на мой взгляд, это knowledge sharing. Поэтому, чем проще решение — тем лучше
Коммерческая разработка — это в первую очередь про длительную поддержку тем самым маньяком, который знает, где вы живёте.
Может владеет, но:
а) их установка и настройка займёт время
б) их использование займёт время
в) (опционально) переделывание существующего кода займёт время
И вот мы проект развивается и мы имеем наш index.html и спагетти в app.js. Я согласен, что не нужно палить из пушки по воробьям, но попадать в ловушку «время/качество» тоже не стоит. Проф. за меньшее время со сложным инструментарием сделает то, что средний спец. с небольшим набором инструментов. Ну, тут уже вопрос цены. Да, можно рискнуть качеством.
Во всяком случае я с javascript «близко познакомился» после того как относительно долгое время писал на java/c#. И мне в javascript компайлера и статической типизации дико нехватало. Особенно поначалу.
И я бы сказал что у меня основная проблема была в отсутствии интерфейсов. И в базирующихся на этом отсутствии проблемах с контрактами/«состыковкой» кода, разрабатываемого разными командами/фирмами.
Отдельный микросервис для либы?
Если у меня есть интерфейс, то я точно знаю что я получу. И если кто-то вдруг решит поменять контракт на «своей стороне», то он просто не сможет этого сделать.
Но если есть возможность исключить какие-то варианты или хотя бы снизить наносимый ими ущерб, то почему бы это не сделать?
. Вы же не будете спорить, что объявления типов — это лишние затраты?
Ещё как буду. Это не такие уж и большие затраты и они на мой взгляд однозначно не лишние.
Например потому что обычно позволяют избежать кучи других затрат. На дополнительный тестинг, на разбор чужого кода, на дополнительные проблемы при саппорте, правке багов и дальнейшем развитии/поддержке кода.
"Лишние" тут, видимо, в смысле без типов этих затрат нет, а что они позволяют избежать — это их эффективнотсь.
Но затраты по-любому.
Но затраты по-любому.
Угу, вот только у вас откуда-то там ещё взялось слово «лишние».
И зависит он от решаемой задачи, требований к результату, доступных ресурсов
Угу и когда кто-то озвучивает свою ситуацию и говорит что ему хотелось бы определённую фичу языка, которая бы позволила исключить нарушения контрактов, то неужели логичным ответом будет вот такое:
Налажать можно и не меняя контрактов.
?
Но разве сам факт необязательности делает их автоматически лишними? На мой взгляд «лишние» здесь всё таки неподходящее слово.
Да, это всё лишние затраты с точки зрения получения конечного результата. Но эти затраты могут окупиться. Окупаемость некоторых из них уже принята за аксиому, но холивары по многим из них не стихают десятилетям.
аксиома в том, что введение строгой типизации ничего кроме удорожания разработки не даёт.
Какое сильное и при этом ничем не обоснованное высказывание.
Вот есть, например, nalgebra, это библиотека на Rust для линейной алгебры. В ней есть тип Matrix, который параметризован, в частности, числом строк и колонок. За счёт этого, например, операция умножения там определена только для матриц с совместимыми размерами, а операция транспонирования и обращения матрицы определены только для квадратных матриц. Как вы на это будете писать тесты?
Учитывая аналогичную поправку для тестов, получаем, что их количество будет расти уже не как O(e^n), а как O(e^e^n), что ли?
Это как? Мне представляется только случай, когда человек неверно понял техзадание и начал делать что-то другое (от этого ничего не спасёт). Типы выбираются, чтобы иметь свойства нужные для реализации алгоритма. Нужно очень прецизионно ошибиться, чтобы неверный тип имел точно такой-же интерфейс как и верный, но делал не то что нужно.
Собственно потому так смешён, нет, по настоящему смешён этот спор между
Если вам нужен код, который работает гарантированно и всегда — статическая типизация ваше всё, а то может и в Ada/Idris может повезти поиграться. Собственно тот факт, что сегодня не существует ни одной операционки, ядро которой было бы написано на динамически типизированном языке, равно как нет и браузеров, написанном на динамически типизировнных языках, да и даже какой-нибудь PyPy, который, типа «интерпретатор Python, написанный на Python», если чуть-чуть поскрести, то выяснится, что нет, там нифига не Python, там restricted subset of Python that is amenable to static analysis.
А вот если вам нужно тяп-ляп и «как-нибудь, пусть оно хотя бы что-то хоть как-то на демонстрации заказчику отрисует» и тот факт, что закрытие одного бага создаёт пять новых… тут к вашим услугам и GUI и динамически типизированные языки и куча всего ещё. И тут, действительно, вам статическая типизация будет сильно мешать: потребуются более квалифицированные кадры, а скорость закрытия тасков — упадёт (новых станет тоже меньше, но если у вас всё равно почасовая оплата, то это для вас скорее минус, чем плюс).
Так что… если ваша цель — это решение некоторой задачи, которую вы можете сформулировать — то статически типизированные языки незаменими. Если вам нужен процесс (с почасовой оплатой и демонстрацией «достижений» заказчику) — динамические языки прекрасны.
Заметьте, кстати, что между этими двумя типами программ нет жёсткой границы. Например у нас почти весь код написан на на C++ плюс всякие анализаторы, и прочее… но если и генераторы кода на Python. Потому что вот там как раз важно, чтобы оно на том ровно файле, который у нас есть породило бы разумный выхлоп… и всё — больше ничего не нужно. Совсем. «Заказчики» тут мы же сами — но требования у нас такие же, как у всех: делать этот код надёжным как скала — не нужно.
Сейчас правда есть идея переписать все эти генераторы на чём-нибудь другом (рассматривается Go), но то такое: Python2 больше не поддерживается, код всё равно переписывать, а поддержка Go встроена в билд-систему Android и всё-таки лаконичнее, чем на C++.
Если бы не это — ещё 10 лет бы никто ничего не переписывал.
Бывает, например, еще поисковый процесс — когда вы не знаете, что писать, и только ищете. Нетиповая задача.
Или те же генераторы. Если сам генерируемый код меняется каждый день, нет никакого смысла писать генератор на компилируемом языке.
Или те же генераторы. Если сам генерируемый код меняется каждый день, нет никакого смысла писать генератор на компилируемом языке.
Какой-то неочевидный вывод
Поэтому вы сделаете какой-то шаблонизатор, который в зависимости от требований постепенно превратится в язык, полный по Тьюрингу, как это обычно и бывает. И тогда вы снова получаете динамический язык, только кривой и самопальный, т.е. то, что могли бы гораздо проще сделать сразу на динамическом.
Вы же не будете каждый раз перекомпилировать программу при смене шаблона, если это происходит часто?
Буду перекомпилировать.
А вы используйте не текстовые шаблоны, а структурированные. И внезапно статическая типизация начнёт вам подсказывать, что в атрибут datetime надо вставлять время, а не рубли.
Простите, что
Вы напрасно ограничиваете процесс для динамического языка почасовой оплатой.Если вас интересует общее количество времени, потраченного на проект — динамические языки проигрывают (народ недаром с Python на Go переходит и даже в самом Python пытается типы как-то добавить). Если вы хотите уменьшть время, затраченное на «закрытие таски» (и вас не волнует сколько это закрытие новых породит) — выигрывает динамика.
Потому при почасовой оплате динамика выигрывает без разговоров: и денег больше получите и объяснить за что вам их нужно оплатить проще. В остальных случаях… всё весьма непросто.
Если сам генерируемый код меняется каждый день, нет никакого смысла писать генератор на компилируемом языке.Почему нет? Если компилятор достаточно быстрый (как в том же Go) то время запуска отличается от динамических языков несущественно.
Не вся разработка ведётся в рамках проектного управления, "под ключ". Достаточно много её идёт в рамках продуктовой разработки с постоянно меняющимися требования, где для бизнеса основная метрика эффективности его команд разработки — time-to-market, время от появления бизнес-гипотезы до выкатки её в продакшен. Сами же разработчики работают на окладе и может быть и рады бы писать не то что статически типизируемый, а вообще формально верифицируемый код, но любое увеличение времени разработки воспринимается бизнесом в штыки, его нужно этому бизнесу "продавать".
любое увеличение времени разработки воспринимается бизнесом в штыки, его нужно этому бизнесу «продавать»Было бы еще это желание.
Нужно просто отдавать себе в этом отчёт, а не пытаться рассказывать сказки, что вам не нужна типизация, потому что у вас тесты или потому что у вас «такая команда».
Нет, вам не нужна типизация, потому что вам не нужен код без багов. И всё. Отдайте себе в этом отчёт — и всем станет резко проще и легче.
Поэтому ваше противопоставление смысла не имеет.
В программах на С++ багов полно и обычно куда более серьезных, чем рубли в поле даты, иначе бы не требовались в дополнение к компилятору разные статические чекеры и отладчики.Гениальная логика. Плащ от дождя защищает не лучше, чем футболка, а иначе — к нему не требовались бы ешё и галоши.
Поэтому ваше противопоставление смысла не имеет.Имеет-имеет. Типичный web-сайт содержит десятки миллионов строк кода в ядре, SQL-сервере, массе разнообразных утилит и прочем. И небольшое количесто кода на динамических языках типа PHP или JS. Примерно на порядок, а то и на две меньшее, чем вот всё вот это вот, написанное на C/C++.
Тем не менее в 9 случаях из 10 взлом происходит через тонкую прослойку, написанную на динамических яыках, а не через кучу кода, написанного на статически типизированных языках.
Даже C и C++ (по современным меркам — ужасно ненадёжные и «опасные») содержат на два-три порядка меньше ошибок (в пересчёте на миллион строк кода), чем месиво на динамических языках, которое исполняется «сверху».
Всё может быть проще: надёжно работающий код нужен, но не такой ценой как смена языка. Это и на уровне компании/продукта/проекта работает, и на уровне отдельного разработчика.
Как определить что нужны типы? Когда смотришь на функцию как эта и задаешь вопросы:
function (duration, divider)function (dration: {start: Date, end: Date}, divider: number): [{start: Date, end: Date}]По опыту самые частые ошибки, что в JS (динамический слабый), что в C (статический слабый), что Java (статический сильный) — это соответвующие вариации NPE (вроде как из Java само понятие). А вот в PHP (динамический слабый с опциональным усилением) всё реже и реже встречаются.
Это потому, что PHP не строгий начальник, а добрая бабушка, которая не бросает NPE, а максимум тихо пожурит нотифаем и печально продолжит работать дальше, оперируя не валидными данными. ;)
То есть "статическая типизация" в подобных статьях следует читать как "статическая типизация в некоторых языках, в которые не входят все(почти? Не знаю что там с сабжем в C#) мэйнстрим языках" или "я бы не начинал новый проект в 2020 на мэйнстрим языке, если он не от MS"?
(почти? Не знаю что там с сабжем в C#)
Opt-in nullability таки завезли и можно пользоваться, правда она местами косячно работает: требует shut-up операторов, неудобно работать с nullable value types, которые появились раньше. Однако, польза всё равно заметна.
chersanya
В F# — нет null (в 99% случаев, на практике он может прилететь из того же C#). Но, к сожалению, F# и не мейнстрим язык.
Приходите к нам в Rust и расскажите, что нужно иметь один единственный способ конкатенации строк.
Большинство примеров, которые демонстрируют недостатки динамической типизации обычно относятся не к ней, а к слабой, к неявному приведению типов в частности. Даже по таким косвенным признакам как использование в примерах JS и PHP без тайп-хинтов, а не, например Python или Lisp :) можно это предположить. Я вот в частных холиварах показываю примеры PHP с type hint vs Java, когда оба падают в рантайме, но первый с TypeError, а второй с NPE и вопрошаю "в чём сила, брат? В статике или строгости? "
Отсюда и мифы, что typescript от чего то там спасет. Но вот от кривых рук писателей библиотек он не спасает… Как и не делает ни малейшей попытки спасти от кривых рук пользователей библиотек у которых нет ts…
А какая в Java типизация? На мой взгляд, сильная статическая номинативная. Вроде как большинство с этим согласно.
От каких-то ошибок типов он всё-таки спасает, особенно с настройками построже.
Ну не надо Java пинать, у неё-то как раз система типов довольно кривая.
2. разделяем числовое и строковое сравнение
И теперь невозможно написать обобщённый код, опирающийся на операции сравнения.
Сумма в массиве и в массиве строк? Но это 1 частный случай, и ради него создавать проблемы в куче других мест глупо.
1. с чего вдруг?
Потому что для того, чтобы сравнивать значения, нужно сначала посмотреть, какой тип имеют элементы.
2. сравнения строк и чисел — разные по своей природе. и именно попадание строки вместо числа и числа вместо строки вызывает максимум проблем в языках где недоделана динамическая типизация (например python, javascript)
В Perl, получается, тоже недоделана:
my $var = "13";
if ($var == 13) {
print "equal";
}Выводит equal.
И теперь невозможно написать обобщённый код, опирающийся на операции сравнения.
все намного хуже. Операция сравнения для символов в общем виде не определена. Не надо только про юникод. IJ — это то же самое, что ij? Или вовсе IJ? Честно — сравнение строк нужно, чтобы их алфавитно упорядочивать. А это в разных языках (локалях) разные правила.
Операция сравнения для символов в общем виде не определена. IJ — это то же самое, что ij?
По такой логике и сравнение между числами не определено. Возьмём повсеместные для floating point +0 vs -1, NaN vs NaN и другие. Да даже формально определённые -1 vs +1, 10.5 vs 10 — иногда их полезно считать одинаковыми, так же как вы пишете про ij vs IJ.
Возьмём повсеместные для floating point +0 vs -1, NaN vs NaN и другие
вся работа с FP производится согласно стандарту. Т.е. ученые мужи сели и договорились. Как оно должно быть. А потом уже весь софт и даже оборудование работает по этим принципам. Но вообще — да, иногда логика работу с FP бывает… загадочной.
Со строками же проблема вроде как до сих пор не решена (?).
крайне маловероятно что неудачный merge приведёт к замене килограммов на доллары.Как было бы хорошо, если это действительно так.
крайне маловероятно что неудачный merge приведёт к замене килограммов на доллары
Легко, достаточно смело поменять порядок аргументов функции, в другой ветке сделать новый вызов функции, который соответственно не исправлен при смене.
Я регулярно влетаю в boolean blindness и аналоги для других примитивных типов. И это при живом-то newtype! Сначала лень, а потом приходится исправлять конечно.
А уж сколько багов NonEmpty отловил!

def call_bar(bar):
bar.call()
class Foo:
bar = None
def op(self, bar):
self.bar = bar
def call_bar(self):
call_bar(self.bar)
foo = Foo()
foo.send_bar() # упали
foo.op(object)
foo.send_bar() # не упали
Типичная ошибка на самом деле по опыту использования софта на ряде нестрогих ЯП.
В чем тут проблема: контекст, когда вызов foo.call_bar() валиден, а когда невалиден, находится в голове программиста. Неявная сцепленность с контекстом, о котором должен знать программист. Юнит-тесты это не ловят, увы.
Неявная (она существует, но только логически, в голове у программиста) сигнатура call_bar принимает только Bar. А мы ей передаём сумму None|Bar.
Если писать всё логически корректно (без неявной зависимости совместимости от контекста), то получается строго типизированный код, но без меток типов. Проставить эти метки — дело небольшого времени, если речь не о трех строчках кода на выброс.
Еще с явными типами намного легче ловить ошибки при изменении контрактов (сигнатур). Это вторая или первая по распространенности причина багов. Юнит-тесты далеко не всегда покрывают полностью интеграцию кода.

Чтобы разгребать не только логические ошибки, но и ошибки несоответствия типов?
И это ведь не специфичный кейс. Обобщенные алгоритмы частенько требуют выполнения специфических условий объектом поданным на вход. Да простейший бинпоиск требует сортированных данных.
Будете писать в начале функции
if(notSatifyCondition(array)){
throw Exception()
}?
Может лучше все же объявить сигнатуру как search(arr: SortedArray) и обойтись без if и рантайм ошибок? Сейчас действительно 20й год 21 века, а вы такие проблемы предлагаете решать не автоматически за счет компилятора, а вручную подпихивая костыли.
вопрос какой оператор сравнения вы хотите
Тот, который предоставляет пользователь, когда вызывает сортировку.
Вот есть у меня Enum, и мне очень захотелось по нему что-то упорядочить. А еще есть объект содержащий Response от сервера — и я хочу упорядочить ято-то другое по информации из этого Response. И при этом хочу запретить пользователю сравнивать Response и Enum — это же бред, как сравнивать слона и шкаф. Ваши динамически типизированные действия?
В бизнес-требованиях может быть, что enum должени сортироваться и не по символам, и не по числам, например OPEN должен быть на первом месте, CLOSE на втором, и т. п. по важности для пользователя. Причём в разных юзкейсах разная важность.
Вот вам задача. Практическая, не какое-то теоретическое занудство.
Пишем менеджер задач. Там есть процессы. Активные, на паузе, завершенные и не начатые.
Хочу чтобы юзер мог их сортировать и умел сам задавать порядок сортировки произвольным образом. UI часть писать не надо — только модель.
Условие номер 2: хочу чтобы я не смог сломать ваш код, используя его неправильно. Представьте что у вас в команде зеленый разработчик, который будет завтра писать к вашей модели UI, а послезавтра — вам выкатываться в прод.
Я похожими вещами раз в месяц-два занимаюсь точно, так что, судя по всему кейс весьма распространенный. Ну, с продом через 2 дня, я конечно загнул, но и такое бывало.
Можете хоть к числам приводить, хоть к строкам, хоть вообще ENUM не пользовать. Накидаете решение? Я в ответ на него скину свое.
Как говорится, болтовня ничего не стоит — покажите мне код)
Прямо спасибо, прекрасный пример, наглядно демонстрирующий, что люди, которые топят за типы, крайне редко понимают, зачем они вообще нужны, и как их имеет смысл использовать.
Тут типы только навредят. Функция sort/3 должна принимать два любых элемента и функцию двух аргументов. Если эта функция вернула не boolean — отказ (это бизнес-логика, тут каждый сам решает, я бы в лог ворнинг бросил и обработал, как если бы вернулось true), если true — первый выше второго, если false — наоборот. И все.
Такой код не сломать неправильной реализацией сортера, и если завтра нужно будет сравнивать по хитрому запросу в базу — весь код готов. А с типами тут придется чуть более, чем все — переписать.
Единственная проверка типа, которая тут имеет смысл — это проверка возвращаемого сортером значения на boolean. Но вокруг хайп, и куча неглупых людей как заговоренные повторяют нелепую мантру про «типы помогают при рефакторинге» — поэтому горе-разработчики тут нагородят типов и обломятся ровно на следующем нестандартном требовании к сортировке.
Так, может быть, проблема не в статической типизации (раз она тут, пусть и по мелочи, но всё же поможет), а в этом самом "хайпе"?
Не очень понял вопрос; я никогда и нигде не заявлял, что со статической типизацией есть проблемы. В некоторых случаях — она вполне уместна.
Проблема даже не в хайпе, а в том, что люди считают ее панацеей, что люди не по делу обижают динамическую типизацию, а также в том, что особо одаренные особи умудряются найти полноценную статическую типизацию в тайпскрипте.
Функция sort/3 должна принимать два любых элемента и функцию двух аргументов.
А вот это смешно. Потому что у вас тут есть тип. Я его в хаскель формате не напишу — слабо. Но очевидно, что сигнатура функции высшего порядка (которой является sort/3) вполне конкретно определяется. Как и сигнатура композируемой функции.
это проверка возвращаемого сортером значения на boolean.
Только эта проверка должна быть на этапе компиляции, а не в рантайме. Т.к. сортер должен быть определен изначально.
Вам это смешно, потому что вы не понимаете, что такое тип.
На Хаскеле такое не написать, потому что там нужен завтип. На Идрисе можно. А у меня там просто паттерн-матчинг в динамически типизованном эрланге.
эта проверка должна быть на этапе компиляции
Конечно. А при чем тут типы, стесняюсь спросить?
Завтип там потребуется просто когда в список завезут задачи разных типов, то есть вчера.
сделайте, пожалуйста, ровно n запросов в базу перед вызовом сортера
Да сделаю я, сделаю. Я один запрос сделаю, а не n даже, которые вам подарила волшебная система типов (но не уберегла от говнокода, правда, но это случайно, я уверен). Пример не очень удачный, но ведь пуговицы — это единственное, к чему тут можно прицепиться.
На каждый вызов сортера?
При чем тут вызовы вообще? Я указал, где тип важен, нужен, интересен.
Динамическая типизация — это не инструмент для разработки. Это чепуха (паршивая)