Обновить
64K+

Big Data *

Большие данные и всё о них

59,73
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Маппинг данных: как объединить разные источники и не исказить результаты анализа

Время на прочтение11 мин
Охват и читатели158

Интернет-магазину нужен отчёт по заказам в разрезе клиентских сегментов. Заказы лежат в системе продаж, сведения о клиентах — в CRM. Вы соединяете таблицы. Запрос выполняется, но сумма заказов оказывается выше исходной. Откуда разница? Можно ли соединять клиентов по одинаковым номерам? Что делать с неизвестным статусом?

Привет, Хабр!

Мы — Karpov Courses, онлайн-школа, где учат аналитике, программированию и работе с данными. Разберём маппинг на учебном примере: пройдём путь от сбора источников до спецификации, SQL-запроса и проверки результата.

Читать далее

Новости

«Лучше пять раз переспросить, чем один раз выдумать» — я посадил ИИ‑ассистента отвечать коллегам в рабочем мессенджере

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели5.7K

Всем привет! Меня зовут Александр, я руковожу направлением аналитики страховой вертикали в Банки.ру. Наша вертикаль живёт в отчётах и данных: продажи ОСАГО и КАСКО, ипотечное страхование, кроссы, пролонгация, воронки, кэшбэк и сверки с партнёрами.

И каждый день в рабочем мессенджере на меня прилетает поток одного и того же жанра: «где посмотреть КВ по ОСАГО за сентябрь?», «почему упало одобрение у страховой?», «сделай выгрузку по регионам», «это у нас баг или так и задумано?». КВ здесь комиссионное вознаграждение.

Постепенно аналитик превращается в справочное бюро. Ответы есть, но живут они в голове, в SQL-запросах и в вики, а вопросы приходят в личку и в каналы в любой момент, в том числе пока ты на встрече. Я решил посадить на эту очередь ИИ-ассистента. Условие одно и жёсткое: ассистент не выдумывает. В аналитике выдуманная цифра хуже отсутствия ответа, потому что по ней примут решение.

В статье рассказал, как бот устроен, какие правила не дают ему врать и как он им учится.

Читать далее

Spark Cluster 2: как я создал приложение для автоматического развёртывания Apache Spark

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели5.3K

Привет, Хабр!

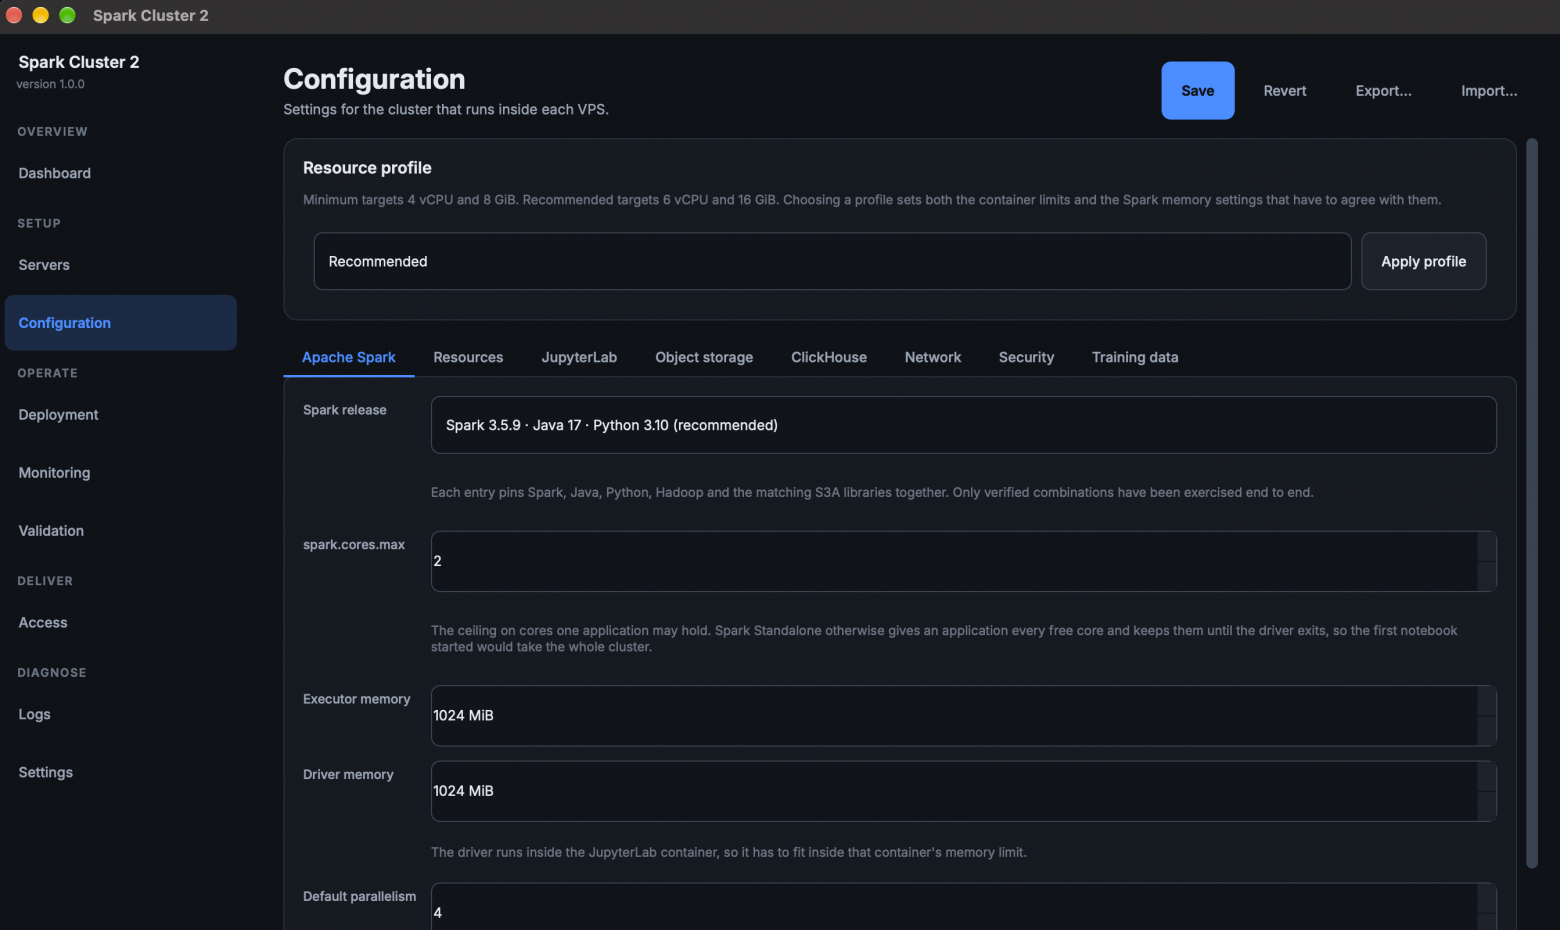
В процессе преподавания дисциплин, связанных с анализом больших данных и распределёнными вычислениями, я регулярно сталкиваюсь с необходимостью организовывать практическую работу студентов с Apache Spark. На первый взгляд задача достаточно простая: подготовить серверы, установить необходимые компоненты, настроить взаимодействие между ними и предоставить студентам доступ к работающему кластеру.

Но когда речь идёт не об одном стенде, а о целой учебной группе, подготовка инфраструктуры превращается в отдельную задачу. Особенно если каждому студенту необходимо предоставить собственный кластер для выполнения лабораторных работ. Некоторое время назад я решил автоматизировать этот процесс и разработал небольшое настольное приложение для развёртывания Apache Spark на виртуальных серверах.

Читать далее

«Диплом Гарварда не открывает дверей»: поступление, сотни откликов и Quant Finance — интервью с Арсением Звягинцевым

Уровень сложностиСредний
Время на прочтение51 мин
Охват и читатели6.1K

Можно окончить Гарвард, получить за четыре года бакалаврский и магистерский дипломы, быть одним из сильнейших студентов на курсе – и два года подряд не найти в США ни одной стажировки. Можно отправить сотни заявок, семь раз собеседоваться в одну компанию и обнаружить, что строчка «Harvard» в резюме даёт лишь небольшое преимущество, а гораздо важнее оказывается школьный «Всерос». А после всего этого – попасть в Quant Finance, где выпускникам предлагают компенсации в сотни тысяч долларов в год, а на интервью проверяют теорию вероятностей, статистику, программирование и задачи, напоминающие олимпиады.

Я, Александр, автор телеграм-канала «Shulepov Code», поговорил с Арсением Звягинцевым – выпускником Гарварда, который изучал статистику и Data Science, живёт в Филадельфии и работает квантом в одной из крупных американских компаний. Арсению 22 года. Сам Гарвард он называет не «святой землёй», а просто хорошим университетом, считает, что часть его курсов можно было бы уместить в минутный ролик, скептически относится к магической силе нетворкинга и не думает, что искусственный интеллект завтра оставит сильных специалистов без работы. Своими наблюдениями и опытом он делится в телеграм-канале: «Arseniy Zvyagintsev».

В разговоре мы обсудили, как школьнику из СНГ поступить в американский университет, почему российская математическая школа даёт заметную фору на первом курсе, как устроены гарвардские Final Clubs, почему при поиске работы непонятный фильтр HR иногда важнее диплома, чем квант отличается от трейдера, зачем рынку маркетмейкеры, откуда берутся зарплаты в $250-400 тысяч, почему Арсений собирается вернуться в Россию – и чем заканчивается приложение, полностью написанное через вайб-кодинг человеком, который не знает его технологический стек.

Читать далее

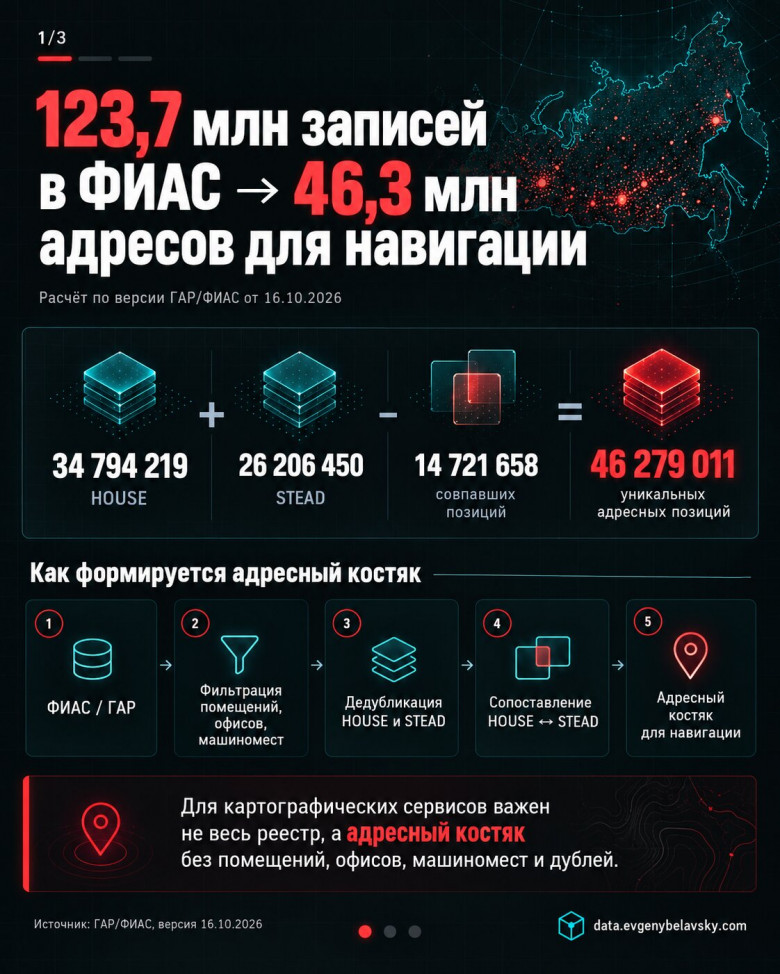
Как из 123 млн записей ГАР/ФИАС получить 46 млн адресов для навигации

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели4.7K

В актуальном ФИАС – 123 720 367 записей. Сколько из этих записей пригодны для навигации в картографических сервисах? Под адресом. пригодном для картографических и навигационных сервисов понимаю

Читать далее

Свежие научные работы про ИИ, агентов и все такое. Сентябрь 2026

Уровень сложностиСредний
Время на прочтение21 мин
Охват и читатели5.9K

Привет, Хабр!  Собрал сентябрьский дайджест из 22 свежих исследований про ИИ. Речь в них идет об обучении моделей, агентном коде, планировании задач и механизмах безопасности. Есть даже работы о пользе ИИ для общества и цене инференса с точки зрения экологии.

Читать далее

Свой AI-харнесс: прод-движок для десятков моделей — единое окно, роутер и управляемые прогоны

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели5.3K

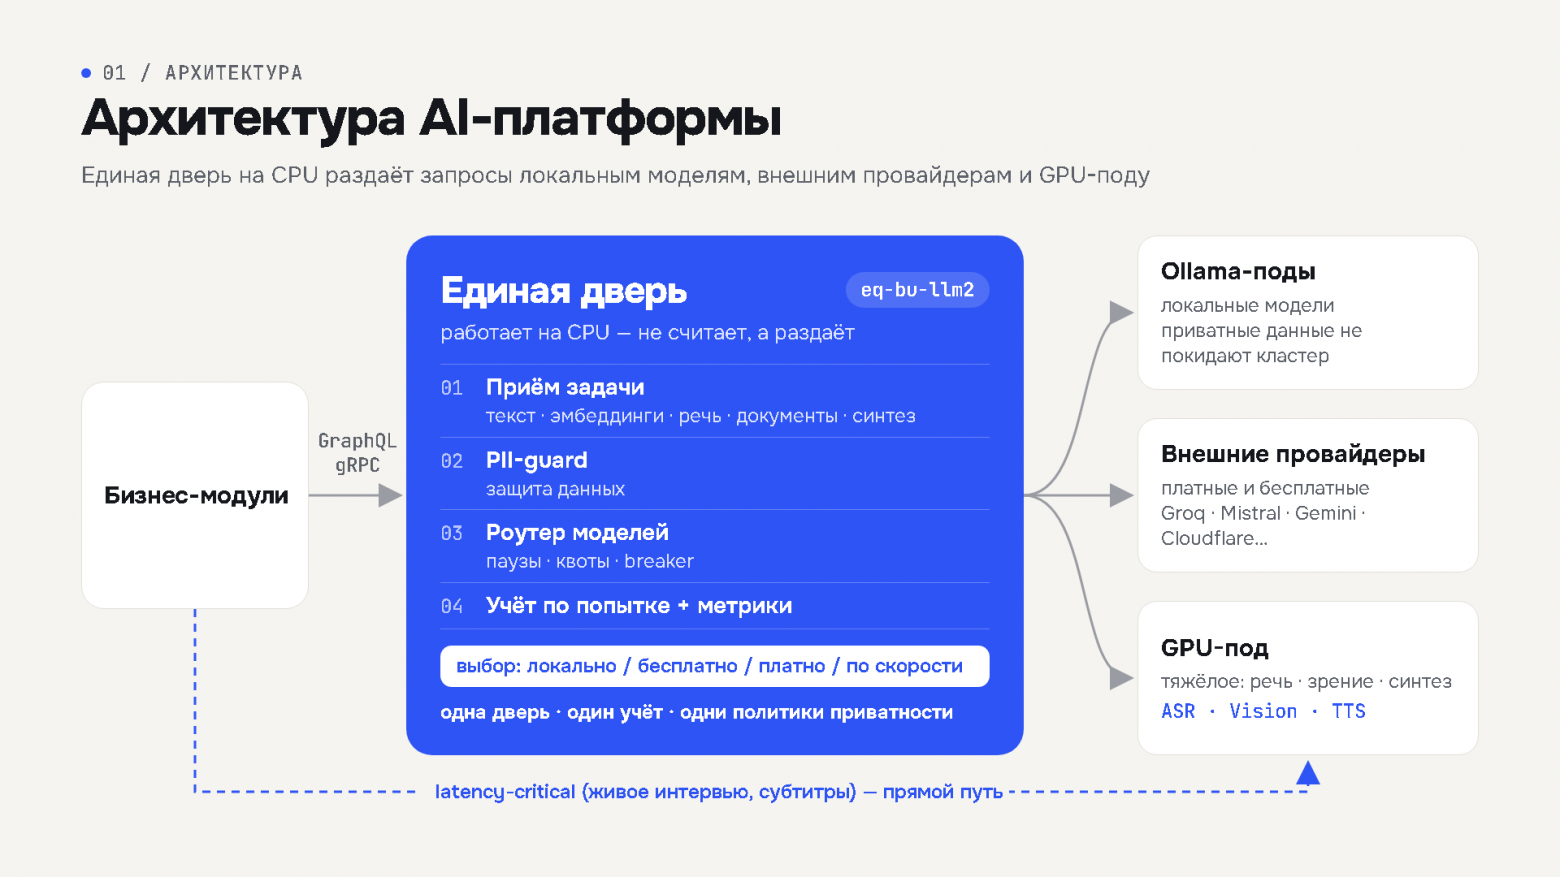
В прошлый раз я рассказывал, как в одиночку с AI-агентами собрал ERP-платформу на Kubernetes из 30+ сервисов. Эта статья — про её мозг: не «ещё один агентский фреймворк», а продакшн-движок, который год несёт живых клиентов (рекрутинг с AI-интервью, CRM, парсинг-конвейеры, копилот).

Про сам термин «харнесс» на Habr уже писали: это обвязка вокруг модели — цикл, инструменты, память, контекст. Повторять общее не буду, разберу конкретику: как это устроено в коде, какие таблицы, где что ломалось. Лонгрид: сначала единое окно и роутер моделей, потом сам харнесс (определения, прогоны, журнал, инструменты, агенты), в конце — всё вместе на одном живом интервью. Нетекстовые модели (речь, зрение, синтез) — отдельная вторая статья.

Сервис работает на Node, на CPU.

Читать далее

Лучшие ИИ для визуализации данных 2026: нейросети для графиков, диаграмм, дашбордов и схем

Время на прочтение11 мин
Охват и читатели4.8K

Нейросеть построила график продаж и написала, что в конце сентября выручка упала. Но действительно ли покупатели стали заказывать меньше? Или выгрузка закончилась 28-го числа, а последнюю неделю сравнили с полной?

Убедительный график ещё не означает правильный расчёт. Возвраты могут попасть в продажи, товарные позиции — превратиться в отдельные заказы, а дубли — создать рекордную неделю. Поэтому при выборе нейросети для графиков меня интересует, можно ли проверить результат и повторить его на новых данных.

Читать далее

Мой PostgreSQL быстрее твоего и почти догнал ClickHouse

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели10K

Мой знакомый - отличный архитектор, но полнейший сноб. У него в проде четыре разных базы данных. PostgreSQL для OLTP, в ClickHouse у него лежат данные OpenTelemetry и веб аналитики, Elasticsearch для полнотекстового поиска в приложении, а MongoDB - “так исторически сложилось”.

Между всем этим ETL, CDC вместе с дежурствами разработчиков в поисках где именно результаты не сходятся. Для него это все продуманная архитектура, а для меня излишняя сложностью в поддержке и разработке.

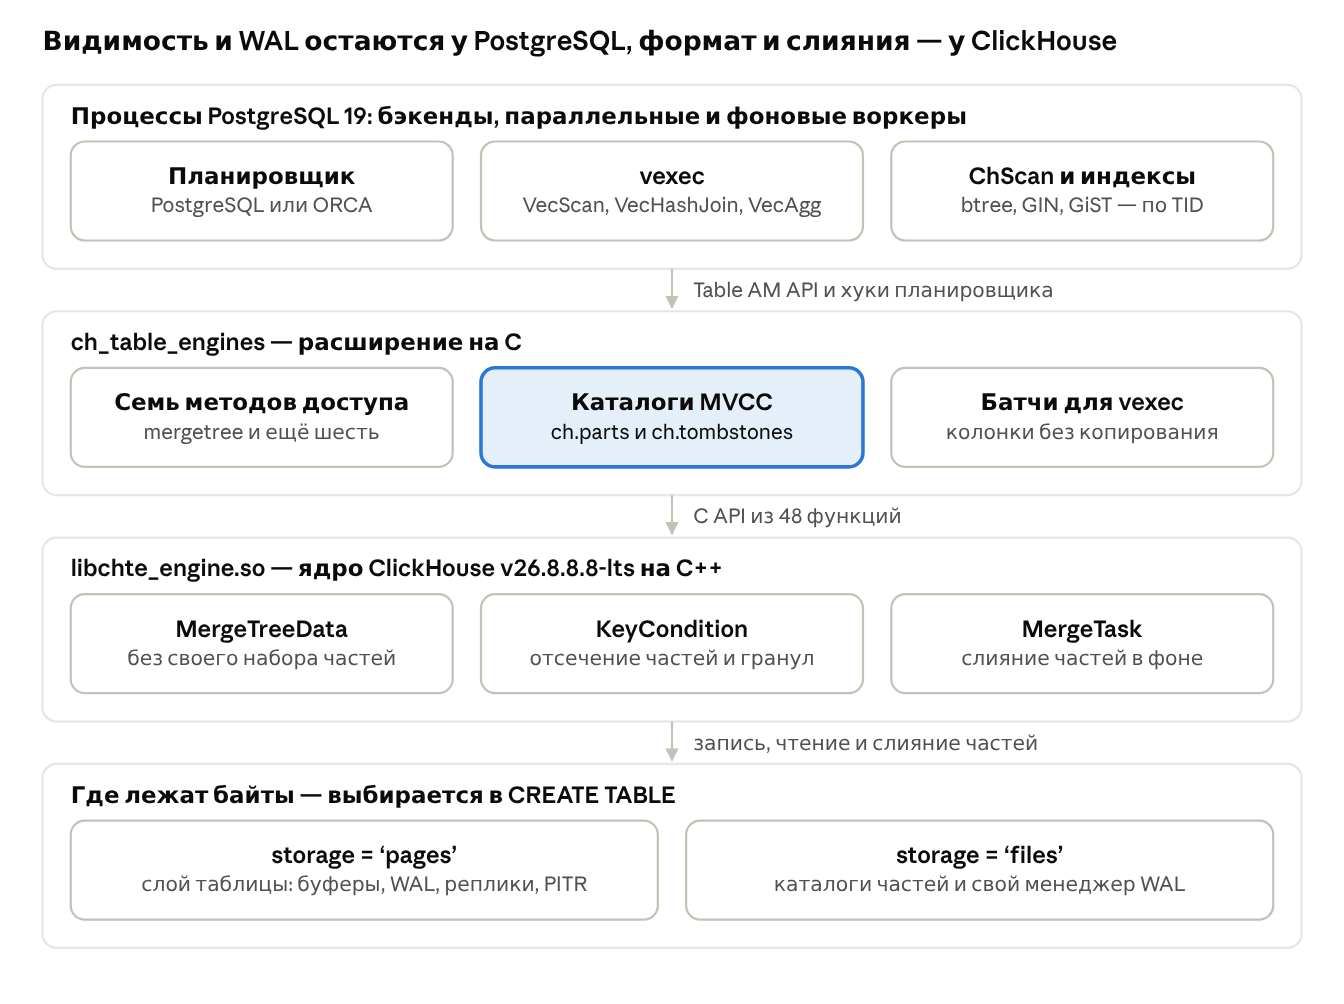
Недавно рассказал ему чем я занимался последнее время. Добавил табличный движок из ClickHouse в PG и поборол раздувание таблиц при обновлениях.

Читать далее

Как читать таблицу на 100 млн строк и не положить ни память, ни базу

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели7.6K

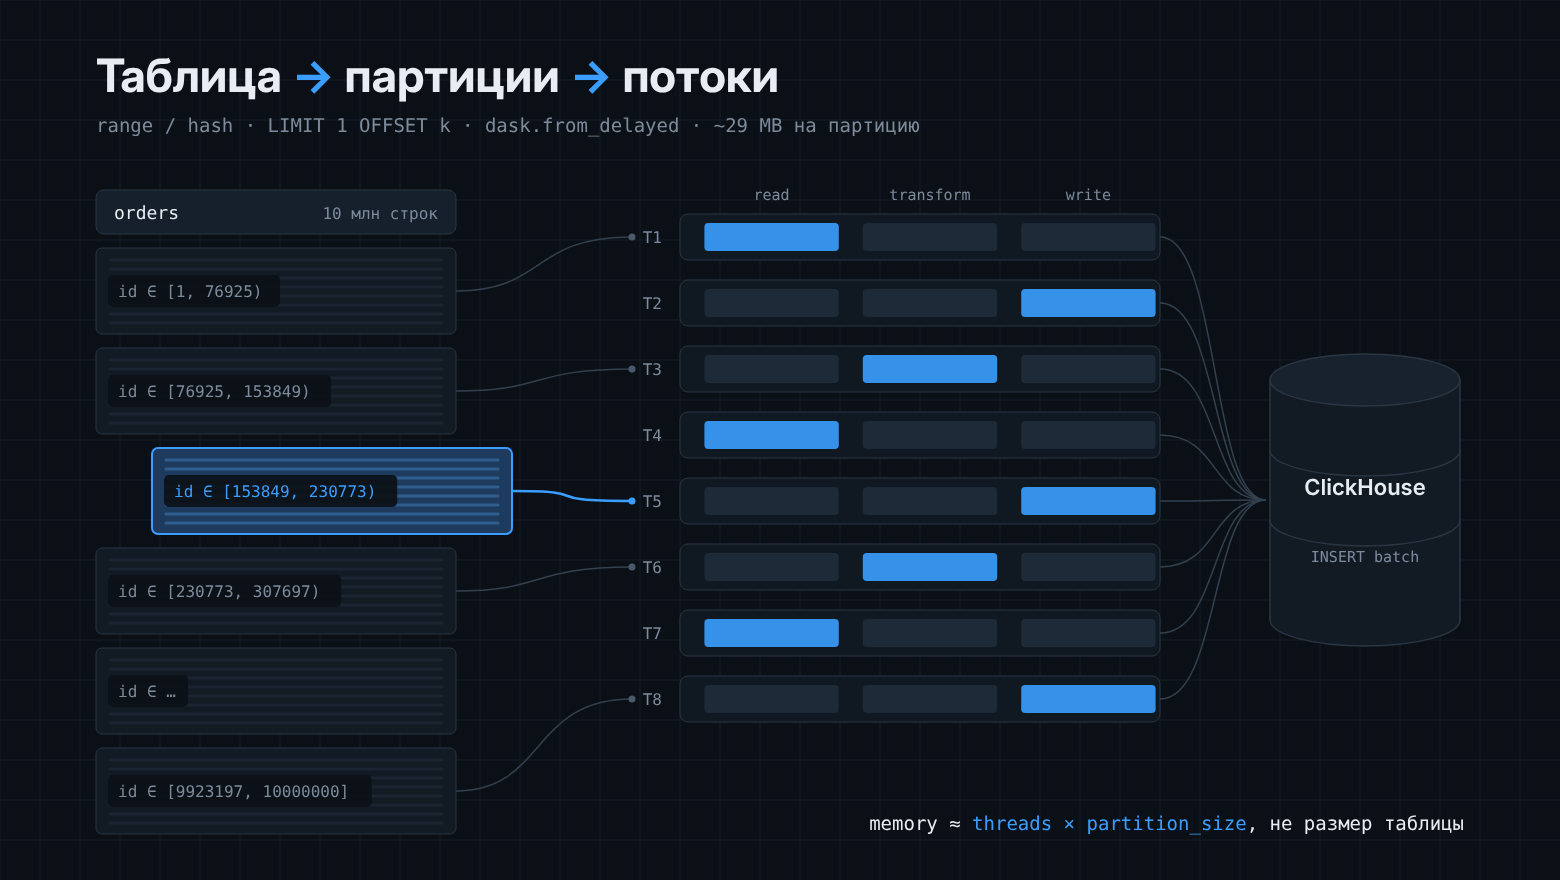
DVT — open-source платформа визуального ETL: пайплайн собирается из нод (чтение → преобразования → запись) и выполняется на воркерах поверх Dask. Я разрабатываю бэкенд DVT, в статье — устройство одного из его компонентов.

Нода чтения из БД должна одинаково работать на таблице в 10 тыс. и в 100 млн строк, на шести СУБД (PostgreSQL, MySQL/MariaDB, MS SQL, Oracle, SQLite, ClickHouse), в воркере с ограниченной памятью и без избыточной нагрузки на источник.

Ниже — устройство планировщика чтения core/db/read_v3: оценка размера строки, расчёт числа партиций, построение границ range и hash, стоимость разметки для источника и интеграция с Dask.

Читать далее

Как контракты данных помогают предотвратить ошибки до выхода в продакшен

Время на прочтение3 мин
Охват и читатели6.8K

Привет, Хаброжители! Во вторник разработчик переименовал столбец в рабочей базе. В четверг ключевой дашборд показал падение метрики, и никто не связал одно с другим. В понедельник руководство одобрило маркетинговую кампанию, чтобы вернуть ушедших пользователей. Через несколько недель выяснилось, что пользователи никуда не уходили, падение было следствием того самого переименования, а бюджет уже потрачен. Знакомая ситуация?

Читать далее

Цифры верные, выводы ложные: AI‑аналитик нашёл тренды в шуме

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели6.5K

ChatGPT может безошибочно посчитать метрики, найти тревожные тренды и предложить план действий — даже если в данных нет ничего, кроме случайного шума. В эксперименте на синтетических данных интернет‑магазина AI‑ассистент сделал 30 аналитических утверждений, ни одно из которых не выдержало статистической проверки. Разбираемся, почему возникают такие ложные инсайты и как проверять выводы ИИ, прежде чем принимать на их основе бизнес‑решения.

Разобрать эксперимент

От SQL‑запроса до результата — в одном окне. Обзор на dbt‑модуль в SubQuery

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.1K

Привет! Меня зовут Маргарита, я BI-архитектор в Далее. Моя задача — чтобы клиенты получали подготовленные данные в удобном для них виде. В этом мне помогает dbt (Data Build Tool).

Раньше мы использовали локальную версию dbt, а с прошлого года перешли на внутреннюю веб-платформу SubQuery. Теперь все задачи я делаю в одном окне, и на ту же работу уходит заметно меньше времени: по моим ощущениям, в 2-3 раза.

Возможно, этот обзор будет полезен коллегам, которые тоже работают с данными. Первое, к чему я быстро привыкла, — результат SQL-запроса модели dbt можно посмотреть сразу в превью. Не нужно отдельно открывать СУБД  и проверять данные на корректность выполненного SQL.

Читать далее

Ближайшие события

От 40 секунд к менее чем 10: перестройка обнаружения инцидентов на OpenTelemetry, Kafka и Flink в Kubernetes

Время на прочтение17 мин
Охват и читатели5.2K

После крупного инцидента SaaS-компании приходится отвечать на неудобный вопрос: кто заметил проблему первым — мониторинг или клиенты? У команды Atlassian долгое время не было однозначного ответа. Команда VK Tech перевела статью о том, как небольшая команда перестроила платформу обнаружения инцидентов на Apache Kafka, Apache Flink в Kubernetes и OpenTelemetry. На этой платформе работает AutoHOT — система автоматического создания инцидентов высокой серьёзности. Авторы рассказывают об архитектурных решениях, показателях, которые отслеживали ежемесячно на протяжении восемнадцати месяцев, и о том, что сделали бы иначе.

Результаты оказались неоднозначными. Доля обнаруженных реальных инцидентов среди тех, которые охватывает мониторинг, выросла примерно с 60% до 86% на пике, но в неудачный месяц снова упала до 64%. Точность — доля срабатываний, оказавшихся настоящими инцидентами, — по-прежнему ниже, чем хотелось бы авторам. Они приводят цифры и разбирают ограничения системы, включая пропущенные инциденты и ложные срабатывания.

Статья адресована тем, кто строит потоковый мониторинг на Kafka и Flink и хочет учесть ошибки авторов при проектировании собственной системы.

Читать далее

Как мы сделали классификатор металлопроката на 15+ млн SKU

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели5.7K

Можно ли разложить 15+ млн хаотичных товаров по 1100 категориям за месяц? Да – без зубодробительного ML и миллионных затрат на LLM-инференс!

В статье о том, как:

1. ML проиграл системе простых бизнес-правил;

2. мы присвоили артикулы товарам для целой отрасли;

3. заставить работать даже самые зашумлённые данные из CRM.

Читать далее

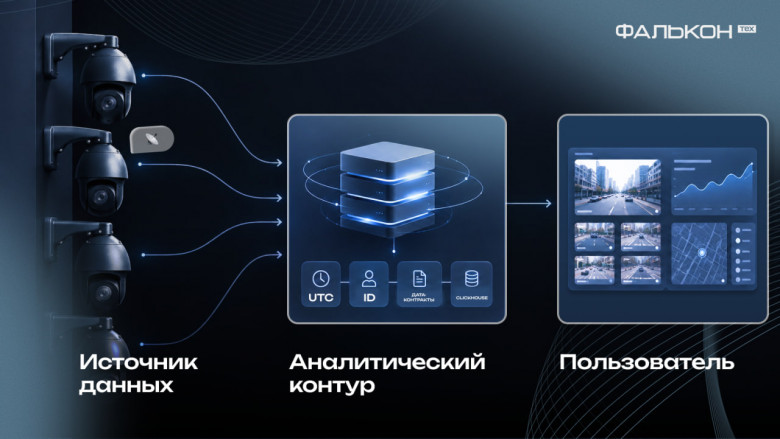
S3, Parquet, ClickHouse и Airflow: архитектура аналитического контура «Фалькон Тех»

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели3.5K

В видеоаналитике важно не только распознать объект, но и правильно связать его с контекстом: временем, местом, камерой и результатом обработки. Если данные рассинхронизированы, даже точная модель машинного зрения может привести к ошибочному выводу. Рассказываем, как мы выстроили архитектуру данных, которая помогает сохранять целостность событий — от камеры до аналитического отчёта.

Читать далее

Оркестратор Apache Airflow: что это и как используется в BI и DWH

Время на прочтение10 мин
Охват и читатели7.9K

В статье разбираем, как устроен Apache Airflow 3, для каких задач он используется, какую роль играет в архитектуре DWH и BI, и когда его стоит выбирать для оркестрации процессов обработки данных. Сравниваем с Prefect и Dagster.

Читать далее

Как реализовать контракты данных для работы с объектами

Время на прочтение15 мин
Охват и читатели8.6K

Привет, Хаброжители! Мы подготовили для вас новый перевод статьи о контрактах данных. Здесь рассмотрены контракты данных на основе объектов, реализованные на базе CDC. Рассказано, каково определение контракта, как он выполняется, и как для него предписывается схема.

Читать далее

Как Cloudflare отодвинул закупку железа на 8 месяцев: сэмплирование, агрегации и zstd в конвейере данных

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.6K

Команда Data в Cloudflare рассказывает, как держит под контролем конвейер данных, через который идёт около двух миллиардов событий в секунду, пока трафик растёт экспоненциально, а железо линейно. Пять шагов за пять лет: разбор монолитной схемы (−35–40% трафика), замена LZ4 на zstd (−40% сжатого трафика), поздняя репликация вместо двойной записи (−36 ГБ/с), двойное сэмплирование (−25 ГБ/с, 2 ПБ в сутки) и агрегации по всему конвейеру (−80% на HTTP-наборе). С графиками и цифрами по каждому шагу.

Читать далее

Apache ICEBERG: Прикасаюсь к Iceberg… а он горячий

Уровень сложностиПростой
Время на прочтение15 мин
Охват и читатели5.2K

Про Iceberg сейчас много чего понаписано. Либо обзор «формат будущего, открытость, лейкхаус», после которого непонятно, где нажать, либо разбор одного механизма — снимки отдельно, каталог отдельно, права отдельно. Iceberg плохо объясняется словами, поэтому я собрал стенд, где все части уже соединены и поднимаются одной командой. Trino, каталог Lakekeeper, права в OpenFGA через OPA, вход через Keycloak, S3 на RustFS, а из инструментов нужен только DBeaver. В статье — путь одного запроса через все компоненты, снимки и откат таблицы, права мышкой и обслуживание таблиц с рекомендациями для рабочей системы.

Читать далее
1
23 ...