Обновить
128K+

C++ *

Типизированный язык программирования

194,47
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как мы перевели 10 миллионов строк кода C++ на стандарт C++14 (а потом и на C++17)

Время на прочтение7 мин
Охват и читатели52K
Некоторое время назад (осенью 2016), при разработке очередной версии технологической платформы 1С:Предприятие внутри команды разработки встал вопрос о поддержке нового стандарта C++14 в нашем коде. Переход на новый стандарт, как мы предполагали, позволил бы нам писать многие вещи элегантней, проще и надежней, упрощал поддержку и сопровождение кода. И в переводе вроде бы нет ничего экстраординарного, если бы не масштабы кодовой базы и специфические особенности нашего кода.

Для тех кто не знает, 1С:Предприятие – это среда для быстрой разработки кросс-платформенных бизнес-приложений и runtime для их выполнения в разных ОС и СУБД. В общих чертах в состав продукта входят:


Мы стараемся по максимуму писать один код для разных ОС — кодовая база сервера общая на 99%, клиента — примерно на 95%. Технологическая платформа 1С:Предприятие преимущественно написана на C++ и ниже приведены приблизительные характеристики кода:

  • 10 миллионов строк С++ кода,
  • 14 тысяч файлов,
  • 60 тысяч классов,
  • полмиллиона методов.

И все это хозяйство надо было перевести на C++14. О том, как мы это делали и с чем столкнулись в процессе, мы сегодня и расскажем.
image
Читать дальше →

В трёх статьях о наименьших квадратах: ликбез по теории вероятностей

Время на прочтение10 мин
Охват и читатели24K
Полтора года назад я опубликовал статью «Математика на пальцах: методы наименьших квадратов», которая получила весьма приличный отклик, который, в том числе, заключался в том, что я предложил нарисовать сову. Ну, раз сова, значит, нужно объяснять ещё раз. Через неделю ровно на эту тему я начну читать несколько лекций студентам-геологам; пользуюсь случаем, излагаю тут (адаптированные) основные тезисы в качестве черновика. Моей основной целью не является дать готовый рецепт из книги о вкусной и здоровой пищи, но рассказать, почему он таков и что ещё находится в соответствующем разделе, ведь связи между разными разделами математики — это самое интересное!

На данный момент я предполагаю разбить текст следующим образом:


Я зайду к наименьшим квадратам чуть сбоку, через принцип максимума правдоподобия, а он требует минимального ориентирования в теории вероятностей. Данный текст рассчитан на третий курс нашего факультета геологии, что означает, (с точки зрения задействованного матаппарата!) что заинтересованный старшеклассник при соответствующем усердии должен суметь в нём разобраться.

Насколько обоснован теорвер или верите ли вы в теорию эволюции?


Однажды мне задали вопрос, верю ли я в теорию эволюции. Прямо сейчас сделайте паузу, подумайте, как вы на него ответите.


Читать дальше →

The Kernel-Bridge Framework: мостик в Ring0

Время на прочтение7 мин
Охват и читатели10K
Хотели ли Вы когда-нибудь заглянуть под капот операционной системы, посмотреть на внутреннее устройство её механизмов, покрутить винтики и посмотреть на открывшиеся возможности? Возможно, даже хотели поработать напрямую с железом, но считали, что драйвера — rocketscience?

Предлагаю вместе пройтись по мостику в ядро и посмотреть, насколько глубока кроличья нора.

Итак, представляю драйвер-фреймворк для kernel-хакинга, написанный на C++17, и призванный, по возможности, снять барьеры между ядром и юзермодом или максимально сгладить их присутствие. А также, набор юзермодных и ядерных API и обёрток для быстрой и удобной разработки в Ring0 как для новичков, так и для продвинутых программистов.

Основные возможности:

  • Доступ к портам ввода-вывода, а также проброс инструкций in, out, cli и sti в юзермод через IOPL
  • Обёртки над системной пищалкой
  • Доступ к MSR (Model-Specific Registers)
  • Набор функций для доступа к юзермодной памяти других процессов и к памяти ядра
  • Работа с физической памятью, DMI/SMBIOS
  • Создание юзермодных и ядерных потоков, доставка APC
  • Юзермодные Ob*** и Ps***-каллбэки и фильтры файловой системы
  • Загрузка неподписанных драйверов и ядерных библиотек

… и многое другое.
Читать дальше →

Полёт свиньи, или Оптимизация интерпретаторов байт-кода

Время на прочтение13 мин
Охват и читатели21K


"No matter how hard you try, you can't make a racehorse out of a pig. You can, however, make a faster pig" (комментарий в исходном коде Емакса)

Всем известен тот факт, что свиньи не летают. Не менее популярно мнение о том, что интерпретаторы байт-кодов как техника исполнения языков высокого уровня не поддаются ускорению без применения трудоёмкой динамической компиляции.


Во второй части серии статей об интерпретаторах байт-кодов я на примере небольшой стековой виртуальной машины ПВМ («Поросячья Виртуальная Машина») постараюсь показать, что не всё потеряно для трудолюбивых поросят с амбициями и что в рамках (в основном) стандартного C вполне возможно ускорить работу таких интерпретаторов по меньшей мере в полтора раза.

Читать дальше →

Четыре года развития SObjectizer-5.5. Как SObjectizer изменился за это время?

Время на прочтение22 мин
Охват и читатели1.5K
Первая версия SObjectizer-а в рамках ветки 5.5 вышла чуть больше четырех лет назад — в начале октября 2014-го года. А сегодня увидела свет очередная версия под номером 5.5.23, которая, вполне возможно, закроет историю развития SObjectizer-5.5. По-моему, это отличный повод оглянуться назад и посмотреть, что же было сделано за минувшие четыре года.

В этой статье я попробую тезисно разобрать наиболее важные и знаковые изменения и нововведения: что было добавлено, зачем, как это повлияло на сам SObjectizer или его использование.

Возможно, кому-то такой рассказ будет интересен с точки зрения археологии. А кого-то, возможно, удержит от такого сомнительного приключения, как разработка собственного акторного фреймворка для C++ ;)
Читать дальше →

Проблемные аспекты программирования на С++

Время на прочтение28 мин
Охват и читатели15K

В С++ достаточно много особенностей, которые можно считать потенциально опасными — при просчетах в проектировании или неаккуратном кодировании они легко могут привести к ошибкам. В статье приводится подборка таких особенностей, даны советы, как уменьшить их негативное влияние.


Читать дальше →

Работа со строками на этапе компиляции в современном C++

Время на прочтение20 мин
Охват и читатели35K


Если вы программируете на C++, то наверняка задавались вопросом почему нельзя сравнить два строковых литерала или выполнить их конкатенацию:


auto str = "hello" + "world"; // ошибка компиляции

if ("hello" < "world") { // компилируется, но работает не так, как ожидалось
    // ...
}

Впрочем, как говорится, "нельзя, но если очень хочется, то можно". Ломать стереотипы будем под катом, причем прямо на этапе компиляции.

Читать дальше →

Интересная задачка на С

Время на прочтение2 мин
Охват и читатели9.6K

Просматривая протоколы собеседований на позицию разработчика, обнаружил такую задачу: "Предложите код, который бы выводил на печать числа в убывающем порядке от n до 0, не используя (скрыто или явно) операторы сравнения (реализация функции вывода на печать не в счет)". Несмотря на то, что ко мне эта задача не имела отношения, она меня заняла и я решил подумать над способами ее решения (хотя, кому и при решении какой задачи может понадобиться такой метод оптимизации кода, мне осталось неизвестно, но тем не менее ).


Первое, что пришло на ум, — попытаться использовать шаблоны. Например так


template<int n> 
void print()
{
    printf("%d\n", n);
    print<n - 1>();
}

template<>
void print<0>()
{
    printf("0\n");
}

int main(int argc, char* argv[])
{
    print<N>();
    return 0;
}

Проблема в том, что программирование это инженерная дисциплина, а не оккультная, и если "что-то" должно в системе происходить, то "оно" должно быть описано и под это должны быть выделены ресурсы, и в данном случае, поскольку отработка шаблонов происходит на этапе компиляции, есть ограницения на вложенность подобного рода конструкций (и это хорошо и правильно, и Слава Богу, что так есть), и компилятор совершенно справедливо выдал "fatal error C1202: recursive type or function dependency context too complex" при размере N больше 2000.

Читать дальше →

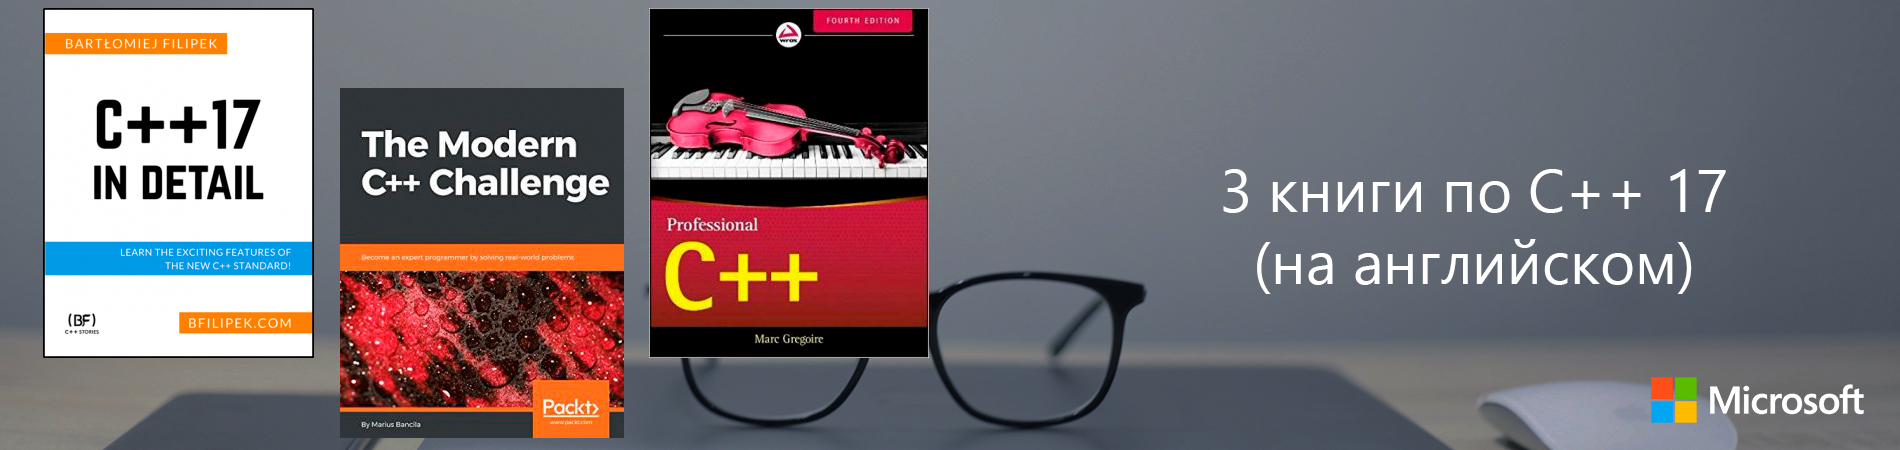
3 книги по C++ 17 (на английском)

Время на прочтение2 мин
Охват и читатели11K
Сегодня мы рассказываем вам о трех книгах, написанных нашими Microsoft MVP, по C++ 17. Они могут быть хорошими отправными точками в пути ознакомления с новой версией этого языка программирования. Все они продаются в электронном и бумажном виде на онлайн площадках (от €8.64 до $42.99 за электронные версии).

Читать дальше →

JsonWriterSax — библиотека для создания JSON

Время на прочтение5 мин
Охват и читатели3.8K

Некоторое время назад я писал приложение на c++/Qt, которое отправляло по сети большие объемы данных в формате JSON. Использовался стандартный QJsonDocument. При внедрении столкнулся с низкой производительностью, а также неудобным дизайном классов, который не позволял нормально детектировать ошибки при работе. В результат появилась библиотека JsonWriterSax, позволяющая писать JSON документы в SAX стиле с высокой скоростью, которую и публикую на github.com под лицензией MIT. Кому интересно — прошу под кат.

Читать дальше →

«Lock-free, or not lock-free, that is the question» или «Здоровый сон хуже горькой редьки»

Время на прочтение7 мин
Охват и читатели7.7K

На написание данной статьи меня подвигли комментарии к статье "Как правильно и неправильно спать".


Речь в данной статье пойдёт о разработке многопоточных приложений, применимости lock-free к некоторым кейсам возникшим в процессе работы над LAppS, о функции nanosleep и насилии над планировщиком задач.


NB: Всё обсуждаемое касается разработки на C++ под Linux, но может быть применимо ко всем POSIX.1-2008 совместимым системaм (с оглядкой на конкретную реализацию).

Вобщем всё довольно сумбурно, надеюсь ход мысли в изложении будет понятен. Если интересно то прошу под кат.

Читать дальше →

Портирование COM на Linux

Время на прочтение4 мин
Охват и читатели20K
Мне нравится технология COM. Но речь пойдет не о технологии, восхвалении или недостатках COM, а опыте переноса и реализации на Linux. Велосипед? Целесообразность?
Читать дальше →

Как правильно и неправильно спать

Время на прочтение7 мин
Охват и читатели30K
Не так давно мимо нас пробегала неплохая статья об ужасном состоянии производительности современного ПО (оригинал на английском, перевод на Хабре). Эта статья напомнила мне об одном антипаттерне кода, который встречается весьма часто и в общем кое-как работает, но приводит к небольшим потерям производительности то тут, то там. Ну, знаете, мелочь, пофиксить которую руки никак не дойдут. Беда лишь в том, что десяток таких «мелочей», разбросанных в разных местах кода начинают приводить к проблемам типа «вроде у меня последний Intel Core i7, а прокрутка дёргается».

Я говорю о неверном использовании функции Sleep (регистр может отличаться в зависимости от языка программирования и платформы). Итак, что же такое Sleep? Документация отвечает на этот вопрос предельно просто: это пауза в выполнении текущего потока на указанное количество миллисекунд. Нельзя не отметить эстетическую красоту прототипа данной функции:

void Sleep(DWORD dwMilliseconds);

Всего один параметр (предельно понятный), никаких кодов ошибок или исключений — работает всегда. Таких приятных и понятных функций очень мало!

Ещё большим уважением проникаешься к этой функции, когда читаешь, как она работает
Функция идёт к планировщику потоков ОС и говорит ему «мы с моим потоком хотели бы отказаться от выделенного нам ресурса процессорного времени, сейчас и ещё на вот столько-то миллисекунд в будущем. Отдайте бедным!». Слегка удивлённый подобной щедростью планировщик выносит функции благодарность от имени процессора, отдаёт оставшийся кусок времени следующему желающему (а такие всегда найдутся) и не включает вызвавший Sleep поток в претенденты на передачу ему контекста выполнения на указанное количество миллисекунд. Красота!

Что же могло пойти не так? То, что программисты используют эту замечательную функцию не для того, для чего она предназначена.
Читать дальше →

Ближайшие события

Реализация алгоритма k-means (k-средних) на примере работы с пикселями

Время на прочтение12 мин
Охват и читатели41K
Всем привет! Недавно нужно было написать код для реализации сегментации изображения с помощью метода k – средних (англ. k-means). Ну, первым делом Google в помощь. Нашел много информации, как и с математической точки зрения (всякие там сложные математические каракули, хрен поймёшь, что там написано), так и некоторые программные реализации, которые есть в английском интернете. Эти коды конечно прекрасны – спору нет, но саму суть идеи сложно поймать. Как – то оно там все сложно, запутано, да и пока сам, ручками, не пропишешь код, ничего не поймешь. В этой статье хочу показать простую, не производительную, но, надеюсь, понятную реализацию этого чудесного алгоритма. Ладно, погнали!
Читать дальше →

Почему перенос при целочисленном переполнении — не очень хорошая идея

Время на прочтение11 мин
Охват и читатели15K
Эта статья посвящена неопределённому поведению и оптимизациям компилятора, особенно в контексте знакового целочисленного переполнения.

Примечание от переводчика: в русском языке нет четкого соответствия в употребляемом контексте слова «wrap»/«wrapping». Существует математический термин "перенос", который близок к описываемому явлению, а термин "флаг переноса" (carry flag) — механизм выставления флага в процессорах при целочисленном переполнении. Другим вариантом перевода может быть фраза «вращение/переворот/оборот вокруг нуля». Она лучше отображает смысл «wrap» по сравнению с «перенос», т.к. показывает переход чисел при переполнении из положительного в отрицательный диапазон. Однако, как оказалось, эти слова смотрятся в тексте непривычно для тестовых читателей. Для упрощения в дальнейшем примем в качестве перевода термина «wrap» слово «перенос».

Компиляторы языка C (и C++) в своей работе всё чаще руководствуются понятием неопределённого поведения — представлением о том, что поведение программы при некоторых операциях не регламентировано стандартом и что, генерируя объектный код, компилятор вправе исходить из предположения, что программа таких операций не производит. Немало программистов возражало против такого подхода, поскольку сгенерированный код в этом случае может вести себя не так, как задумывал автор программы. Эта проблема становится всё острее, так как компиляторы применяют всё более хитроумные методы оптимизации, которые наверняка будут опираться на понятие неопределённого поведения.
Читать дальше →

В PVS-Studio появилась поддержка GNU Arm Embedded Toolchain

Время на прочтение7 мин
Охват и читатели5.1K

GNU Arm Embedded Toolchain + PVS-Studio

Встраиваемые системы давно и прочно вошли в нашу жизнь. Требования к их стабильности и надежности очень высоки, а исправление ошибок обходится дорого. Поэтому для embedded разработчиков особенно актуально регулярное использование специализированных инструментов для обеспечения качества исходного кода. Эта статья расскажет о появлении поддержки GNU Arm Embedded Toolchain в анализаторе PVS-Studio и дефектах кода, найденных в проекте Mbed OS.
Читать дальше →

Как PVS-Studio оказался внимательнее, чем три с половиной программиста

Время на прочтение3 мин
Охват и читатели26K
Как PVS-Studio оказался внимательнее, чем три с половиной программиста

PVS-Studio, как и другие статические анализаторы кода, часто выдаёт ложные срабатывания. Но не стоит спешить считать странные срабатывания ложными. Это короткая история о том, как PVS-Studio вновь оказался внимательнее нескольких человек.

Нам в поддержку написал пользователь, утверждая, что анализатор выдаёт сразу четыре ложных срабатывания на одну строчку кода. Письмо, написанное в поддержку, изначально попало к Евгению Рыжкову, который, бегло прочитав его и не заметив аномального в фидбеке, сразу переслал его ведущему разработчику Святославу Размыслову. Евгений не всматривался в код, так что будет честно посчитать его только за половину программиста :).
Читать дальше →

Разработка интерфейсных классов на С++

Время на прочтение24 мин
Охват и читатели108K

Интерфейсные классы весьма широко используются в программах на C++. Но, к сожалению, при реализации решений на основе интерфейсных классов часто допускаются ошибки. В статье описано, как правильно проектировать интерфейсные классы, рассмотрено несколько вариантов. Подробно описано использование интеллектуальных указателей. Приведен пример реализации класса исключения и шаблона класса коллекции на основе интерфейсных классов.


Читать дальше →

Бесполезный отложенный неблокирующий обмен сообщениями в MPI: лайт-аналитика и туториал для тех, кто немножечко «в теме»

Время на прочтение13 мин
Охват и читатели5.3K
Совсем недавно мне пришлось решать очередную тривиальную учебную задачу от своего преподавателя. Однако, решая ее, мне удалось обратить внимание на вещи о коих я ранее вовсе не задумывался, возможно, не задумывались и Вы. Эта статья скорее будет полезна студентам да и всем, кто начинает свой путь в мир параллельного программирования с использованием MPI.


Наше «Дано:»


Итак, суть нашей, в сущности вычислительной задачи, заключается в том, чтобы сравнить во сколько раз программа, использующая неблокирующие отложенные двухточечные передачи быстрее той, что использует блокирующие двухточечные передачи. Измерения будем проводить для входных массивов размерностью 64, 256, 1024, 4096, 8192, 16384, 65536, 262144, 1048576, 4194304, 16777216, 33554432 элементов. По умолчанию предлагается решать ее четырьмя процессами. А вот, собственно, и то, что мы будем считать:

Читать дальше →

Численная проверка abc-гипотезы (да, той самой)

Время на прочтение8 мин
Охват и читатели17K
Привет, Habr.

На Geektimes Habr было уже несколько статей про abc-гипотезу (например в 2013 и в 2018 годах). Сама история про теорему, которую сначала много лет не могут доказать, а потом столько же лет не могут проверить, безусловно заслуживает как минимум, художественного фильма. Но в тени этой чудесной истории, сама теорема рассматривается черезчур поверхностно, хотя она не менее интересна. Уже хотя бы тем, что abc-гипотеза — одна из немногих нерешенных проблем современной науки, постановку задачи которой сможет понять даже пятиклассник. Если же эта гипотеза действительно верна, то из нее легко следует доказательство других важных теорем, например доказательство теоремы Ферма.

Не претендуя на лавры Мотидзуки, я тоже решил попробовать решил проверить с помощью компьютера, насколько выполняются обещанные в гипотезе равенства. Собственно, почему бы нет — современные процессоры ведь не только для того чтобы в игры играть — почему бы не использовать компьютер по своему основному (compute — вычислять) предназначению…

Кому интересно что получилось, прошу под кат.
Читать дальше →