Обновить
128K+

C++ *

Типизированный язык программирования

275,27
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как enum доступным всем сделать, да в мета-тип записать

Время на прочтение4 мин
Охват и читатели22K

Преамбула


В процессе разработке ПО у меня возникла необходимость определения перечислителей enum в централизованном заголовочном файле, тогда как их использование могло быть во многих исходных файлах. Это весьма удобно с точки зрения организации исходников и зависимостей. Однако для моих задач также требовалась регистрация перечислителей в системе метатипов Qt. О том, как делал я такую регистрацию и пойдет речь.

Интервью с Qt


— Мне нужно чтобы ты понимал мой enum.
Читать дальше →

Находим ошибки в коде проекта LLVM с помощью анализатора PVS-Studio

Время на прочтение17 мин
Охват и читатели9.1K
PVS-Studio vs LLVMОколо двух месяцев назад я написал статью о проверке компилятора GCC с помощью анализатора PVS-Studio. Идея статьи была следующая: предупреждения GCC — это хорошо, но недостаточно. Надо использовать специализированные инструменты анализа кода, например, PVS-Studio. В качестве подтверждения я показал ошибки, которые PVS-Studio смог найти в коде GCC. Ряд читателей заметили, что качество кода GCC и его диагностики так себе, в то время как компилятор Clang современен, качественен, свеж и молод. В общем Clang — это ого-го! Что ж, значит пришло время мне проверить с помощью PVS-Studio проект LLVM.
Читать дальше →

Реализация блочного шифра «Кузнечик» с режимом CFB на С++

Время на прочтение10 мин
Охват и читатели29K
Сегодня речь пойдёт о новом алгоритме блочного шифрования «Кузнечик» из стандарта ГОСТ Р 34.12 2015. В последнее время выходит множество публикаций, посвященных этому стандарту. В них с теоретической точки зрения описываются приведённый алгоритм, изучаются особенности отельных преобразований, а так же предлагаются способы оптимизации, путём включения вставок кода на языке ассемблера.

В данной статье я предлагаю читателю ознакомиться с реализацией данного блочного шифра на языке С++. Стоит отметить, что при написании данной программы не преследовалась цель достичь наибольшей эффективности, а основной задачей было показать, как работает алгоритм. Ознакомиться с описанием алгоритма можно в официальной документации.

Структура программы


Программа состоит из трех частей
  • набор вспомогательных функций и классов — mycrypto.cpp mycrypto.hpp
  • блочный шифр «Кузнечик» — Kuznyechik.cpp Kuznyechik.hpp
  • режим шифрования Cipher Feed Back — modes.hpp
Читать дальше →

Сравнение библиотек логирования

Время на прочтение26 мин
Охват и читатели81K


В сети огромное количество площадок формата Q&A где задаются вопросы из разряда:

  • Предложите С++ логер? (C++ logging framework suggestions)
  • Какой наиболее эффективный потоко-безопасный С++ логер? (What is the most efficient thread-safe C++ logger)
  • Библиотека логирования для игр (Logging library for c games)
  • Асинхронный потоко-безопасный С++ логер? (Asynchronous thread-safe logging in C++)

Люди делятся своим опытом и знаниями, но формат таких площадок позволяет лишь показать личные предпочтения отвечающего. К примеру, одним из самых производительных логеров чаще всего называют Pantheios, который даже по тестам производителя тратит больше 100 секунд на запись 1M строк лога, на современном железе это около 30 секунд, быстро ли это?

В этой статье я сравню наиболее известные и заслуженные логеры последних лет и несколько относительно молодых логеров по более чем 25 критериям.
Читать дальше →

Идем на рекорд: пятая проверка Chromium

Время на прочтение10 мин
Охват и читатели15K
Казалось бы, Chromium был рассмотрен нами неоднократно. Внимательный читатель задастся логичным вопросом: «Зачем нужна еще одна проверка? Разве было недостаточно?». Бесспорно, код Chromium отличается чистотой, в чем мы убеждались каждый раз при проверке, однако ошибки неизбежно продолжают выявляться. Повторные проверки хорошо демонстрируют, что чем чаще будет применяться статический анализ, тем лучше. Хорошо, если проект проверяется каждый день. Ещё лучше, если анализатор используется программистами непосредственно при работе (автоматический анализ изменённого кода).
Читать дальше →

Реализация Undo/Redo модели для сложного документа

Время на прочтение8 мин
Охват и читатели12K

Привет Хабр! В данной статье я хочу показать, как можно организовать модель редактирование документа со сложной структурой с возможностью отмены/возврата действий.


Предыстория и проблематика


Все началось с того, что я писал узкоспециализированный outline-софт, где основная идея заключается в оперировании кучей виртуальных бумажных карточек на разных сценах в разных редакторах.


Получилось похоже на MS Visio с определенной степенью кастомизации и плагинизации. Никаких технических сложностей здесь нету, однако есть ряд особенностей.


Во-первых, сцен несколько. А значит и оконных редакторов нужно несколько, каждый из которых работает по своим правилам.


Во-вторых, т.к. набор карточек один, а одна и та же карточка может быть использована в разных местах, то это рождает определенные зависимости между разными частями документа. И, если карточка удаляется, то это влечет за собой устранение этой карточки из всех мест, где она задействована.


В-третьих, когда я сделал все, что хотел, и показал результаты другу (который даже не программист), то он потыкал и сказал, что неплохо бы сделать Ctrl+Z. Я загорелся идеей, но вот реализовать это оказалось не такой тривиальной задачей. В этой статье я опишу, к чему пришел в итоге.

Читать дальше →

JSON-RPC на C++

Время на прочтение33 мин
Охват и читатели17K

В предыдущей статье про декларативный JSON-сериализатор я рассказал, как с помощью шаблонов C++ можно описывать структуры данных и сериализовать их. Это очень удобно, т.к. не только сокращает размер кода, но и минимизирует количество возможных ошибок.Концепция — если код компилируется, то он работает. Примерно такой же подход применен и в wjrpc, о которой речь пойдет в этой статье. Но поскольку wjrpc “выдран” из фреймворка, под интерфейсы которого он был разработан, я также затрону вопросы архитектуры и асинхронных интерфейсов.


Читать дальше →

PVS-Studio для Linux

Время на прочтение2 мин
Охват и читатели17K
PVS-Studio for LinuxСвершилось! Сегодня мы выпустили публичную версию анализатора PVS-Studio для Linux. Теперь разработчики Linux приложений получат новое мощное оружие для борьбы с багами в коде. Призываем разнести эту новость по миру. Расскажите своим коллегам по работе, напишите в Twitter и Facebook! Да будут программы надёжней и стабильней!

Элементы функционального программирования в C++: частичное применение

Время на прочтение8 мин
Охват и читатели15K

Не буду сильно углубляться в теорию. Что такое частичное применение легко найти в интернете. В том числе на Википедии.


Если кратко, то это механизм, позволяющий зафиксировать k аргументов функции от n аргументов, сделав из неё функцию от (n - k) аргументов.


// Пусть имеется функция f от четырёх аргументов:
int f (int a, int b, int c, int d)
{
    return a + b + c + d;
}

// Фиксируем первые два аргумента:
auto g = part(f, 1, 2); // 1 + 2 + ...

// Добрасываем оставшиеся два:
assert(g(3, 4) == 10); // ... + 3 + 4 = 10

На эту тему уже существует масса публикаций, в том числе и на Хабре:


  1. C++ Variadic templates. Каррирование и частичное применение
  2. Частичное применение и каррирование в C++
  3. Каррируем на C++

А ветка "How should I make function curry?" на stackoverflow — просто кладезь для тех, кто впервые сталкивается с этой темой.


К сожалению, количество пока не переросло в качество, и хорошего, пригодного к использованию варианта я так и не увидел. При этом любопытно вот что.


Замечательный факт №1. В упомянутых статьях присутствуют все техники, которые нужны для реализации правильного (по моему мнению) частичного применения.


Надо только всё внимательно проанализировать и сложить кубики в правильном порядке. Именно этим я и собираюсь заняться в данной статье.

Читать дальше →

learnopengl. Урок 1.5 — Shaders

Время на прочтение14 мин
Охват и читатели155K

Мы уже упоминали шейдеры в предыдущем уроке. Шейдеры — это небольшие программы выполняемые на графическом ускорителе (далее будем использовать более распространенное название — GPU). Эти программы выполняются для каждого конкретного участка графического конвейера. Если описывать шейдеры наиболее простым способом, то шейдеры — это не более чем программы преобразующие входы в выходы. Шейдеры обычно изолированы друг от друга, и не имеют механизмов коммуникации между собой кроме упомянутых выше входов и выходов.

В предыдущем уроке мы кратко коснулись темы “поверхностных шейдеров” и того, как их использовать. В данном уроке мы рассмотрим шейдеры подробнее и в частности шейдерный язык OpenGL (OpenGL Shading Language).

Acyclic Visitor

Время на прочтение8 мин
Охват и читатели9.9K

В этой статье мы рассмотрим один из вариантов реализации поведенческого шаблона проектирования Acyclic Visitor без ипользования RTTI.


Читать дальше →

Филиппинские кроссворды. Доработка мобильной 2D головоломки для работы с цветными кроссвордами

Время на прочтение5 мин
Охват и читатели7.3K

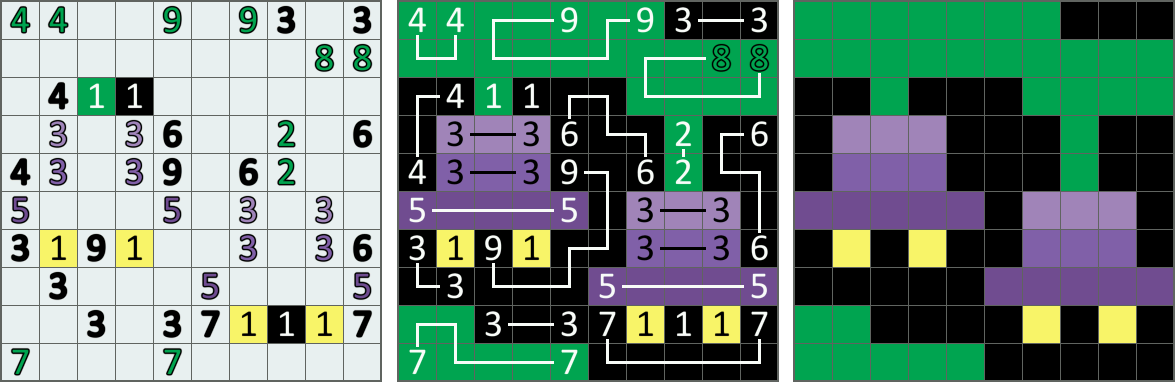
Что такое филиппинский кроссворд.


Цветные филиппинские кроссворды — такой вид головоломок, в сетке которой с помощью чисел зашифрована картинка. Каждое число, расположенные в сетке, кроме единицы, имеет пару. Необходимо подобрать и соединить пары чисел линиями так, чтобы линии удовлетворяли следующим условиям:

— длина каждой линии должна соответствовать числам, расположенным на ее концах;
— линии не должны пересекаться друг с другом и проходить через одни и те же клетки;
— линии могут идти в вертикальном и горизонтальном направлениях, могут преломляться, но не могут проходить по диагонали;
— соединяемые пары чисел должны быть одного цвета.


Так как единица не имеет пары, то она закрашена по умолчанию. В результате решения кроссворда, когда все пары чисел (кроме единиц) соединены линиями, получается рисунок.


Читать дальше →

Майкл Фезерс, автор книги «Working Effectively with Legacy Code», едет в Харьков с докладом

Время на прочтение1 мин
Охват и читатели4.7K
25 октября 2016 года Майкл Фезерс, Director of R7K Research & Conveyance и автор книги «Working Effectively with Legacy Code», выступит на uDev Tech Events с лекцией на тему «Micro Refactoring and Macro Refactoring: Strategies and Techniques».

Читать дальше →

Ближайшие события

Анатомия KD-Деревьев

Время на прочтение14 мин
Охват и читатели60K
image

Эта статья полностью посвящена KD-Деревьям: я описываю тонкости построения KD-Деревьев, тонкости реализации функций поиска 'ближнего' в KD-Дереве, а также возможные 'подводные камни', которые возникают в процессе решения тех или иных подзадач алгоритма. Дабы не запутывать читателя терминологией(плоскость, гипер-плоскость и т.п), да и вообще для удобства, полагается что основное действо разворачивается в трехмерном пространстве. Однако же, где нужно я отмечаю, что мы работаем в пространстве другой размерности. По моему мнению статья будет полезна как программистам, так и всем тем, кто заинтересован в изучении алгоритмов: кто-то найдет для себя что-то новое, а кто-то просто повторит материал и возможно, в комментариях дополнит статью. В любом случае, прошу всех под кат.
Читать дальше →

Задачка на std::multiset или поиск по полям структуры

Время на прочтение6 мин
Охват и читатели12K

Попалась небольшая задачка, где-то на 4 часа кодирования, которую счел занимательной.


Есть база пользователей 10 миллионов:


class User{
 int id; 
 time_t birthday; // дата рождения
 int gender;      // пол
 int city_id;     // место проживания
 time_t time_reg; // дата регистрации
};

Нужно сделать быстрый поиск по базе, с учетом ее не частого обновления. Поиск может проходить по полям: возрасту, полу, городу. Поля поиска могут быть указаны в группировке или отдельно, например:


  • город;
  • город, пол;
  • пол, возраст.

Данные выдачи должны быть отсортированы по дате регистрации пользователей, и выдаваться постранично по 100 пользователей.


Подсказка 1: СУБД не даст нужной скорости.
Подсказка 2: Вспомнить сложность операций со множествами, сложность стандартных алгоритмов.
Подсказка 3: Проверить время поиска реализованного алгоритма, неплохой результат это порядка 0.005 сек.

Читать дальше →

Кластер Asterisk. Централизация информации о регистрации

Время на прочтение4 мин
Охват и читатели14K
У большинства администраторов, работающих с телефонией на базе Asterisk, в компаниях, где штат превышает 500+ сотрудников, рано или поздно встает вопрос о полноценной кластеризации Active/Active. Предпосылками к этому может быть и наличие региональных ответвлений, и желание сделать систему надежнее. Тема обширная и не является целью данной статьи в полном объеме, которая написана с целью показать один из самых быстрых и надежных способов добыть информацию о регистрации устройств на серверах в кластере, с целью последующей централизации или/и дистрибуции внутри кластера. Логично предположить, что самый производительный способ — это быть частью самого Asterisk.
Читать дальше →

Разбираемся в MAVLink. Часть 1

Время на прочтение8 мин
Охват и читатели100K
Для обмена данными многие современные дроны, собираемые энтузиастами, коммерческие или даже промышленные, используют протокол MAVLink. Я бы хотел поделиться своим опытом работы с этим протоколом в этой, а может и в последующих статьях.

image
Читать дальше →

Оптимизация кода: память

Уровень сложностиСложный
Время на прочтение12 мин
Охват и читатели98K
Большинство программистов представляют вычислительную систему как процессор, который выполняет инструкции, и память, которая хранит инструкции и данные для процессора. В этой простой модели память представляется линейным массивом байтов и процессор может обратиться к любому месту в памяти за константное время. Хотя это эффективная модель для большинства ситуаций, она не отражает того, как в действительности работают современные системы.

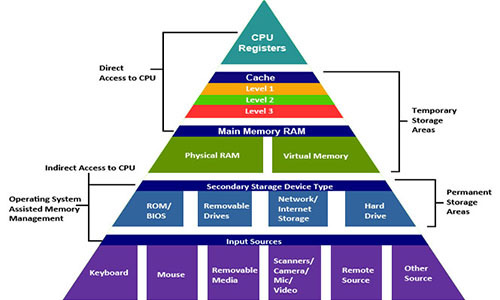
В действительности система памяти образует иерархию устройств хранения с разными ёмкостями, стоимостью и временем доступа. Регистры процессора хранят наиболее часто используемые данные. Маленькие быстрые кэш-памяти, расположенные близко к процессору, служат буферными зонами, которые хранят маленькую часть данных, расположеных в относительно медленной оперативной памяти. Оперативная память служит буфером для медленных локальных дисков. А локальные диски служат буфером для данных с удалённых машин, связанных сетью.

image

Иерархия памяти работает, потому что хорошо написанные программы имеют тенденцию обращаться к хранилищу на каком-то конкретном уровне более часто, чем к хранилищу на более низком уровне. Так что хранилище на более низком уровне может быть медленнее, больше и дешевле. В итоге мы получаем большой объём памяти, который имеет стоимость хранилища в самом низу иерархии, но доставляет данные программе со скоростью быстрого хранилища в самом верху иерархии.
Читать дальше →

Visual Studio «15» Preview 5

Время на прочтение5 мин
Охват и читатели21K
5 октября 2016-го года вышел Visual Studio «15» Preview 5. Команда разработчиков сфокусировалась на повышении производительности IDE. В этой статье мы рассмотрим некоторые из улучшений. Запускайте инсталлятор и, пока он устанавливается, читайте о нововведениях в этой статье или в оригинальных release notes.

Значительный шаг вперёд в производительности и экономии памяти


Я хотел бы начать с видео, которое очень хорошо показывает рост производительности в данном превью. Здесь показана загрузка проекта Roslyn, которая ранее занимала 60 секунд, а в новом превью полностью заканчивается уже к 30-ой секунде.


Нежная дружба агентов и исключений в SObjectizer

Время на прочтение9 мин
Охват и читатели4.4K
Рано или поздно в программе что-нибудь идет не так. Не открылся файл, не создалась рабочая нить, не выделилась память… И с этим нужно как-то жить. В небольшом однопоточном приложении довольно просто: можно прервать всю работу и рестартовать. Это один из факторов, благодаря которому Erlang снискал себе заслуженную популярность, ведь идеология fail fast является одним из краеугольных камней Erlang-а с его легковесными процессами. Если же приложение большое, сложное и многопоточное, то не разумно рестартовать все приложение, если лишь одна из его нитей столкнулась с проблемами. Еще хуже в ситуации с реализациями Модели Акторов, в которых сотни тысяч акторов могут работать на десятках рабочих нитей. Проблема одного актора вряд ли должна сказываться на всех остальных акторах.

В данной статье мы расскажем, как мы подошли к обработке ошибок в своем фреймворке SObjectizer.

Исключениям – да, кодам возврата – нет!


Когда SObjectizer-4 появился в 2002-ом году, мы сделали большую ошибку – предпочли использовать коды возврата исключениям. И весь последующий опыт разработки на SObjectizer-4 снова и снова убеждал в одной простой истине: если ошибка может быть прогнорирована разработчиком, то она будет им проигнорирована. Поэтому при создании SObjectizer-5 мы решили использовать исключения для информирования об ошибках.
Читать дальше →