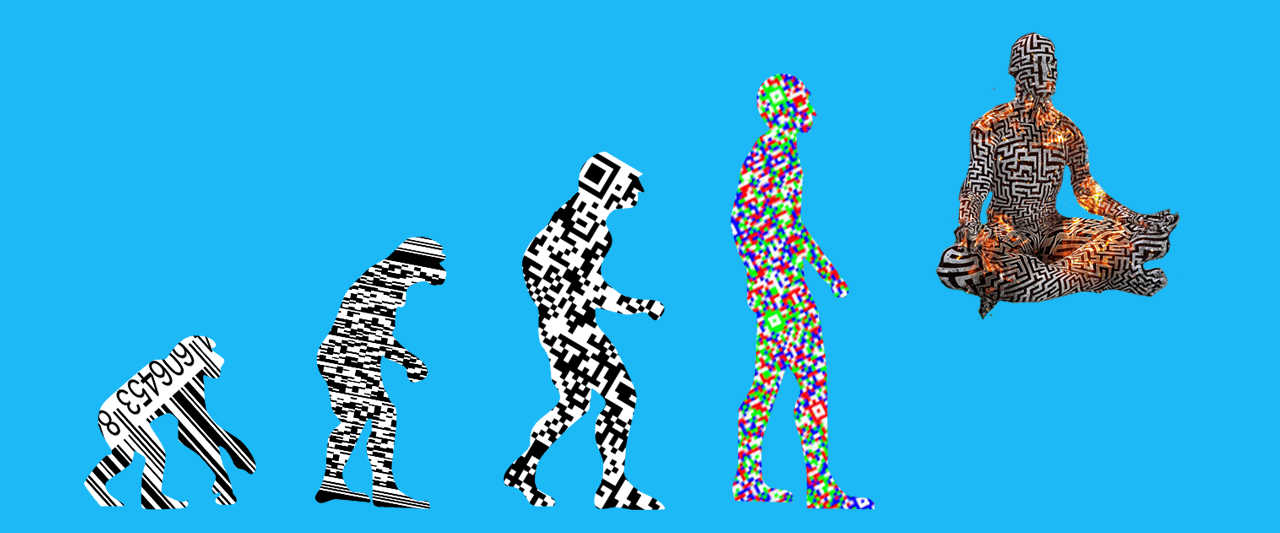Обновить
128K+

Обработка изображений *

Работаем с фото и видео

180,42
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как понять, что нейросеть решит вашу проблему. Прагматичное руководство

Время на прочтение12 мин
Охват и читатели13K
Haystacks at Sunset Reimagined by AshnoAlice

Инженер по машинному обучению Джордж Хосу задает вопрос: «Какие проблемы решает машинное обучение?». Или конкретнее, с учетом современного развития отрасли: «Какие проблемы нейросеть способна решить на практике?». Команда Mail.ru Cloud Solutions перевела статью, так как рассуждения на эту тему, как нам кажется, встречаются редко.
Читать дальше →

Как создавать и изменять интерактивные PDF-формы, или новый скилл ABBYY FineReader PDF

Время на прочтение7 мин
Охват и читатели65K
Мы регулярно обучаем ABBYY FineReader PDF новым навыкам. Две недели назад мы рассказали на Хабре, как научили ABBYY FineReader PDF редактировать целые абзацы. Этот пост — о еще одном продвижении нашего продукта на пути к совершенству: программа теперь умеет создавать и редактировать интерактивные PDF-формы.

Раньше ABBYY FineReader PDF мог только заполнять такие формы – заявления на отпуск или визу, резюме, согласие на обработку персональных данных, исследования, опросы и т.д. Но что если компании нужно создать в формате PDF анкету, разработать шаблон документа или отредактировать в готовом бланке несколько полей, чтобы затем отправить его сотрудникам или клиентам? Теперь все это можно сделать в одной программе. О том, как это работает, для чего и кому может понадобиться такая функциональность, мы сегодня и расскажем. Поехали!
Читать дальше →

Илон Маск против лидаров: Псевдолидар

Время на прочтение5 мин
Охват и читатели14K
Tesla давно мечтает сделать камеры, работающие не хуже лидара. Если ее мечта осуществится, это сильно поможет конкурентам.

image

Всем хорошо известно, что думает Илон Маск о применении лидара (технологии трехмерного изображения) в беспилотных автомобилях. Он не планирует использовать ее в Tesla и считает костылем. Это очень спорная точка зрения, только время покажет прав ли он.

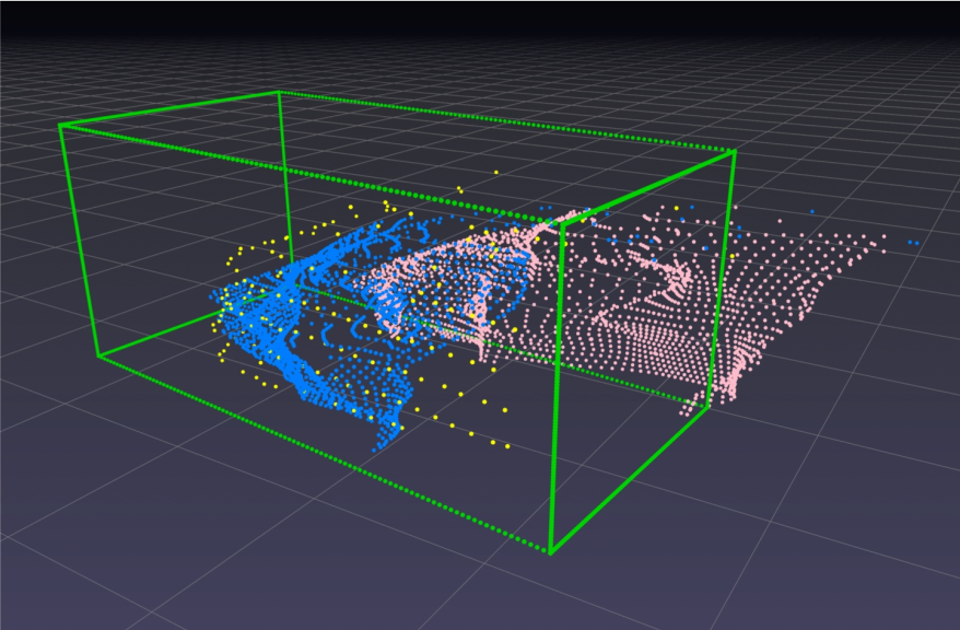
Tesla продвигает технологию, называемую псевдо-лидаром или виртуальным лидаром. Эта технология заключается в построении инструментов для создания снимков с камеры (стерео или обычных). Нужно выяснить насколько далеко находится каждый пиксель на снимке. Лидар вычисляет расстояние до каждого пикселя. Он определяет сколько времени требуется световому импульсу, чтобы попасть в пиксель и вернуться обратно со скоростью света. Люди оценивают расстояние, используя мозг. Мы знаем насколько большие те или иные предметы и как они движутся. Это дает нам представление о том насколько далеко они находятся. Мы также используем стереозрение, потому что у нас два глаза. Однако стереозрение работает только на относительно близком расстоянии. Еще есть параллакс движения — вы наблюдаете за тем как движутся предметы на фоне и используете некоторые другие подсказки, чтобы определить расстояние до объекта.
Читать дальше →

Эволюция баркода

Время на прочтение17 мин
Охват и читатели15K
Баркод, безусловно, относится к одному из тех изобретений человечества, которые изменили течение нашей жизни. Благодаря появлению штрихового кодирования и его последующей эволюции, многие обыденные действия не только значительно упростились и ускорились, но иногда и приобрели неожиданные формы. В процессе нашей деятельности по разработке и улучшению алгоритмов интеллектуального распознавания документов (IDR) и движка распознавания баркодов Smart BarcodeReader мы постоянно систематизируем знания в предметной области. Понимание того, как развивается технология, позволяет нам совершенствовать наши разработки, делать их более быстрыми, точными и эффективными. Сегодня мы расскажем о том, как эволюционировал (и продолжает эволюционировать) баркод от линейного черно-белого рисунка к многомерной конструкции.


Читать дальше →

Чему я научился за (почти) 30 дней Codevemberа — 30 скетчей на p5.js

Время на прочтение4 мин
Охват и читатели3.9K
image

Что такое #codevember и зачем он нужен? В последние пару лет каждый ноябрь я натыкался в соцсетях на интересные произведения искусства, созданные ИИ, отмеченные этим хэштегом. Согласно информации с codevember.xyz:

Codevember – это челлендж для разработчиков, созданный для того, чтобы отточить их креативность и улучшить навыки. Цель – каждый день ноября создавать креативный фрагмент кода. Мы будем давать вам рекомендации для вдохновения каждый день, но вы можете создавать свои скетчи.

В этом году я решил попробовать поучаствовать и в ноябре изучить Processing (p5.js) и побаловаться созданием графики, которая создана не для какой-то определённой задачи.
Осторожно, много картинок

Рубрика «Читаем статьи за вас». Май 2020. Часть 1

Время на прочтение14 мин
Охват и читатели4.9K

Самая сложная задача в Computer Vision

Время на прочтение13 мин
Охват и читатели83K
Среди всего многообразия задач Computer Vision есть одна, которая стоит особняком. К ней обычно стараются лишний раз не притрагиваться. И, если не дай бог работает, — не ворошить.
У неё нет общего решения. Практически для каждого применения существующие алгоритмы надо тюнинговать, переобучать, или судорожно копаться в куче матриц и дебрях логики.

Статья о том как делать трекинг. Где он используется, какие есть разновидности. Как сделать стабильное решение.

Генеративное искусство: создание треугольников после 3 часов изучения p5.js

Время на прочтение6 мин
Охват и читатели4.1K
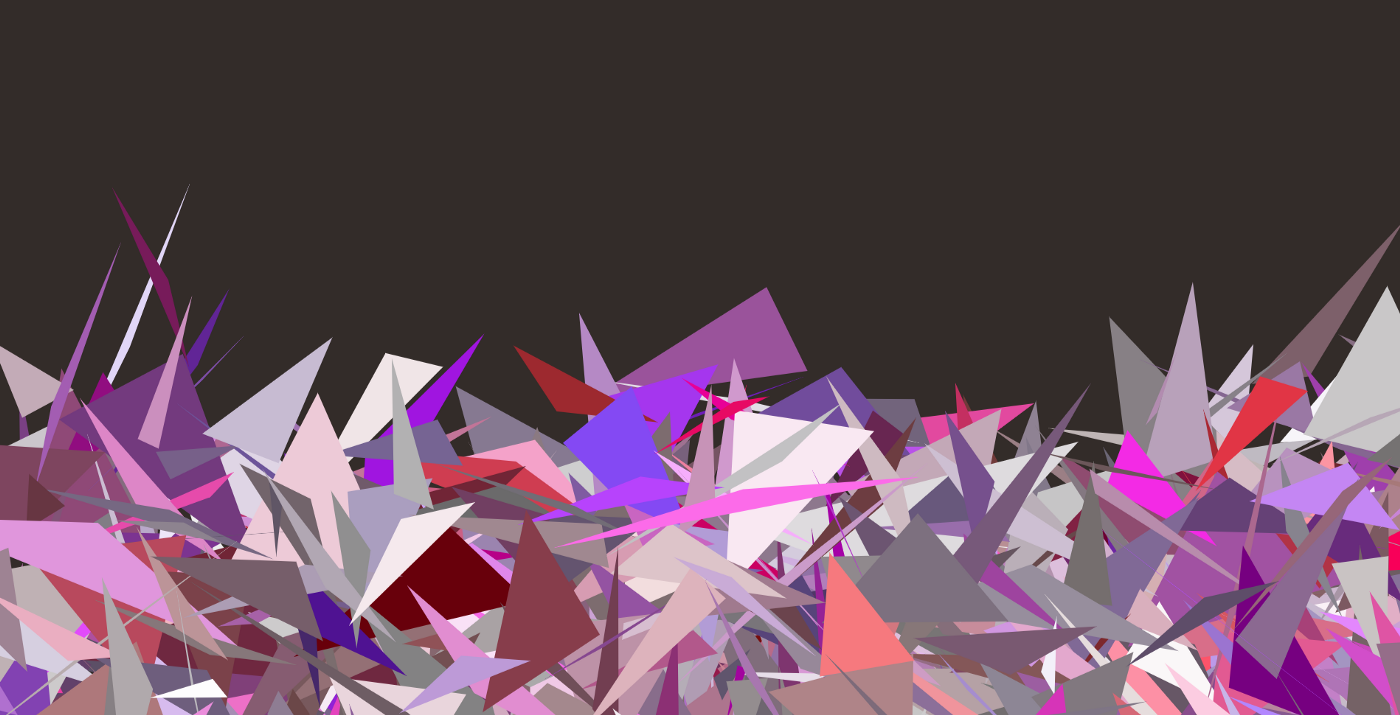
У меня небольшой опыт использования компьютера для творчества и искусства. Когда я начал изучать p5.js, я вдохновился геометрическими рисунками и решил написать код, чтобы создать что-то крутое.

После примерно полутора часов мне удалось получить случайно сформированные треугольники различных цветов.

image
Случайные треугольники

В рамках урока нас просили не останавливаться, пока не получится то, чем мы будем действительно довольны – играть с формой, размером и цветом.
Читать дальше →

Открываем историю Большого. Часть вторая

Время на прочтение9 мин
Охват и читатели2.7K
image

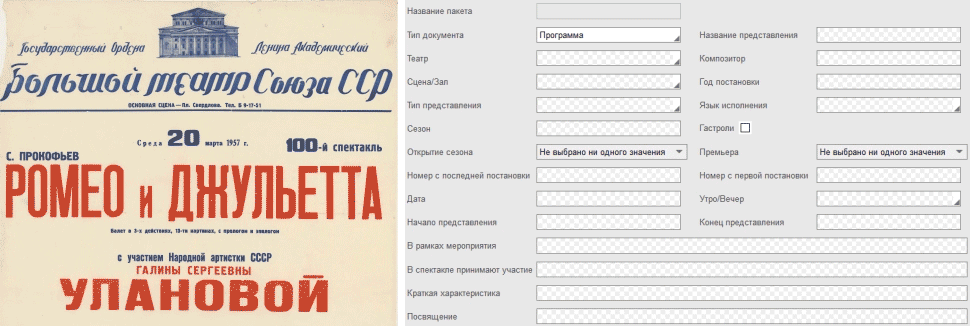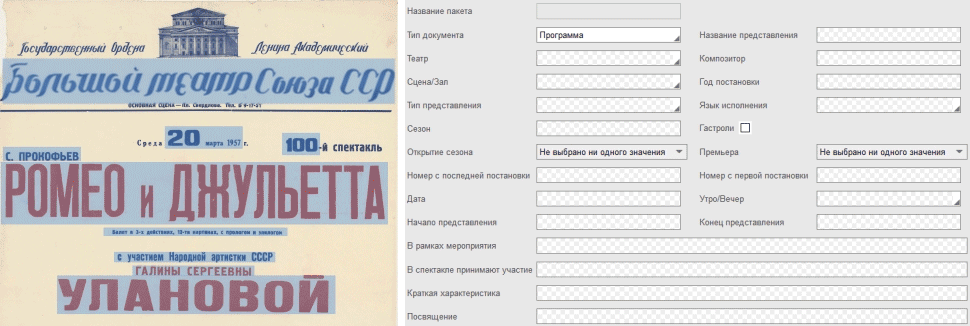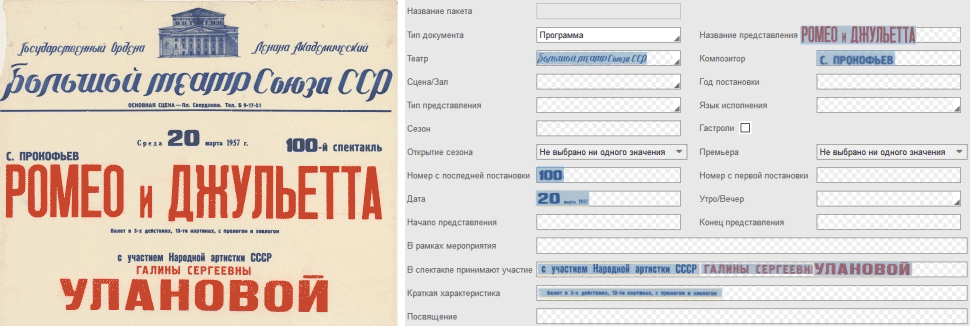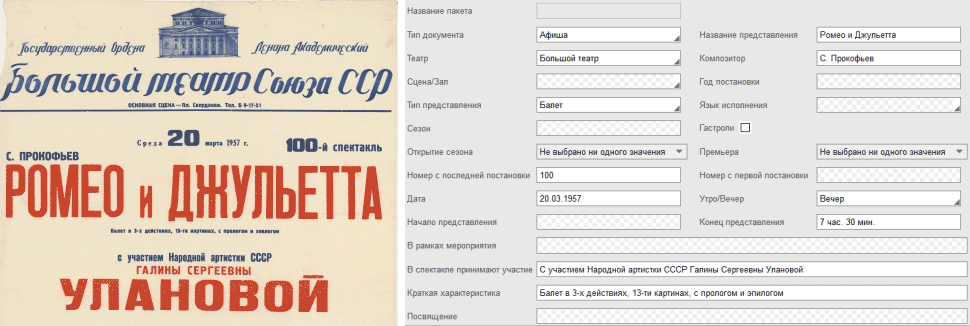
Привет, Хабр. Хорошие новости: мы успешно завершили краудсорсинговый проект «Открой историю Большого» по оцифровке программ, афиш и фотографий, которые хранятся в музее Большого театра. Итогами делимся на сайте openbolshoi.ru, а в этом посте рассказываем, как технически был организован проект.

О том, почему мы начали заниматься этим проектом и что сделали на первом этапе, можно почитать здесь. А что же было дальше? После первой части проекта мы благодаря ABBYY FineReader PDF и с помощью волонтеров подготовили файлы программ и афиш в формате PDF с вычитанным текстовым слоем и передали их музею Большого театра. Теперь все данные хранятся в электронном виде, и сотрудники используют их, чтобы искать и копировать нужную информацию. Это быстрее и удобнее, чем перебирать документы в шкафах и перепечатывать текст из оригиналов.

Но как узнать больше о представлениях, а также о людях, чьи судьбы тесно связаны с историей театра? Как собрать статистику:


Помогли технологии Natural Language Processing (NLP), разработанные в ABBYY. Сегодня мы расскажем, как на втором этапе проекта алгоритмы извлекли из программ и афиш необходимые сведения, заполнили поля базы данных, а затем 7500 волонтеров проверили и дополнили информацию. А в конце поста читайте, как сейчас создается электронный архив музея с удобным поиском по всем представлениям и персонам.
Читать дальше →

OCR-конвейер для обработки документов

Время на прочтение11 мин
Охват и читатели19K
Сегодня я расскажу о том, как создавалась система для переноса текста из бумажных документов в электронную форму. Мы рассмотрим два основных этапа: выделение областей с текстом на сканах документов и распознавание символов в них. Кроме того, я поделюсь сложностями, с которыми пришлось столкнуться, способами их решения, а также вариантами развития системы.


Первичным переводом документа в электронную форму является его сканирование или фотографирование, в результате которого получается графический файл в виде фотографии или скана. Однако такие файлы, особенно высокого разрешения, занимают много места на диске, и текст в них невозможно редактировать. В связи с этим, целесообразно извлекать текст из графических файлов, что успешно делается с применением OCR.
Читать дальше →

RPA спешит на помощь: как распознать паспорт без единой строчки кода

Время на прочтение4 мин
Охват и читатели7.8K
Технология распознавания паспорта уже давно лежит в реестре необходимых решений у крупных корпораций, предоставляющих услуги B2C. Большая тройка операторов связи, крупные банки и страховые компании, Ж/Д и авиаперевозчики, билетные агрегаторы успешно интегрировали в собственные информационные системы технологии распознавания документов Smart IDReader, переведя качество предоставляемой услуги на новый уровень. Но для многих компаний, которые относятся к среднему и малому бизнесу, автоматизация процессов ввода данных из документов клиентов необходима, а интеграция новой функциональности путем встраивания библиотек — это дорого или даже недоступно. И как им быть? В сегодняшней статье мы расскажем вам про то, как за полчаса реализовать распознавание паспорта в практически любой информационной системе.


Читать дальше →

Реверс-инжиниринг микросхем по фото

Время на прочтение3 мин
Охват и читатели14K
Тем, кто любит гикпорн-фотографии от BarsMonster и его товарищей по цеху, наверняка интересно научиться расшифровывать логическую схему по её фотографии. Например, что делает вот этот кусочек Z80?


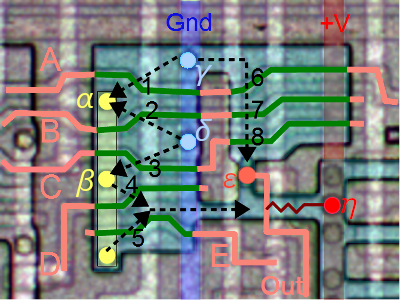
Яркие вертикальные полосы — это металлические проводники; горизонтальные полосы, от которых видны только тёмные границы — это проводники из поликремния; область неправильной формы с ярко-чёрной границей — это легированная часть кремниевой подложки; желтоватые круги — это соединения между слоями микросхемы.

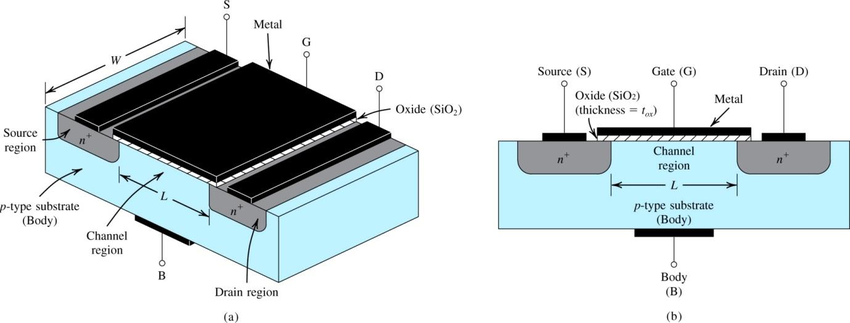
Каждый транзистор образован поликремниевым проводником, пересекающим область легированного кремния:


По традиции, такие транзисторы называют MOSFET («металл-оксид-полупроводник»), даже когда затвор не металлический, а поликремниевый. Автор вполушутку предположил, что ни один производитель поликремниевых транзисторов не хотел называть их POS.

Работа транзистора заключается в том, что когда к затвору приложено положительное напряжение, то легированная область, включающая исток и сток, становится проводящей; когда напряжение с затвора снято, то исток и сток размыкаются.

Вот та же самая фотография с размеченными транзисторами и проводниками: (я добавил в авторскую иллюстрацию обозначения соединений между слоями)

Читать дальше →

Топорная (почти буквально) защита изображений от копирования

Время на прочтение2 мин
Охват и читатели24K
Всем привет!

Предлагаю для обсуждения вариант достаточно грубой защиты от копирования и обратного поиска изображений.


Читать далее

Ближайшие события

Распознавание русского алфавита: от сбора датасета до создания GUI

Время на прочтение6 мин
Охват и читатели26K

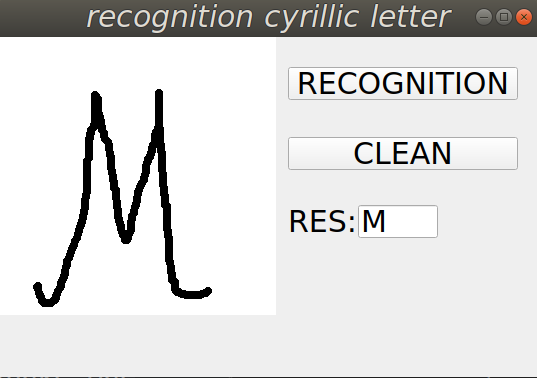
Привет, Хабр! В этой статье я бы хотел рассказать как я сделал распознавалку русских букв и прикрутил к этому небольшой графический интерфейс.


Спойлер: в результате должно получиться вот так:


image

Читать дальше

Эволюция банковских карт: от металла до металла

Время на прочтение7 мин
Охват и читатели15K
Все новые технологии базируются на знании и анализе того, откуда они появились и как изменялись с течением времени. Когда мы в Smart Engines беремся за создание движка распознавания очередного объекта, мы всерьез углубляемся в историю этого объекта, его эволюционный путь развития. Такая информация напрямую влияет на выбор подходов распознавания. Сегодня мы расскажем вам откуда берут начало банковские карты как технология, и как они развивались в течение ста с небольшим лет.


Читать дальше →

Как мы создаем Сognitive Agro Data Factory — самый большой нейронный университет в мире

Время на прочтение10 мин
Охват и читатели11K
Я начну с революционного: когда мы внедряем Искусственные мозги C-Pilot в сельхозтехнику, мы немного уподобляемся Создателю. Мы Предмет превращаем в думающее и анализирующее Существо, то есть комбайн с Cognitive Agro Pilot начинает видеть и понимать, что происходит вокруг, а также принимать решения по дальнейшим действиям в рамках той производственной задачи, которая перед ним стоит. В каком-то смысле идет создание нового социального слоя тружеников села — слой агроботов с Искусственным Интеллектом C-Pilot, которые обдумывают и решают поставленные человеком агрозадачи.

По сути это зарождающийся слой существ, который надо массово и правильно учить. У человечества были тысячелетия на развитие эволюционного слоя сознания, у роботов это — месяцы. Но для этого надо создать необходимую среду, масштабную фабрику по обучению Искусственных мозгов и подготовки информации для них. В этой статье мы приоткроем тайны Cognitive Data Factory: комбайнa для сбора и переработки данных для агроотрасли.

То по каким учебникам и с какими учителями учатся Ваши дети имеет определяющее значение в их развитии и будущей карьере. Так и в автомотив отрасли — качественные данные и их правильная разметка имеют первостепенное значение для создателей ИИ для беспилотного транспорта и других высокоавтоматизированных систем управления. Cognitive Pilot учится через нашу уникальную Data Factory. Как это устроено внутри?


Как мы научили ABBYY FineReader PDF редактировать целые абзацы

Время на прочтение6 мин
Охват и читатели27K

Сегодня мы обновили ABBYY FineReader 15 и выпустили его под брендом ABBYY FineReader PDF, потому что он объединяет все инструменты для работы с PDF. По этому поводу публикуем первый пост из серии материалов о фичах программы. В нем мы расскажем об одной интересной возможности, которая не первый месяц есть в программе, но, возможно, не все о ней знали.

Давно ли вы открывали PDF-файлы? Готовы поспорить, что совсем недавно. Скорее всего, на вашем компьютере точно найдется пара сканов, а может, еще и макет презентации, аналитическое исследование или техническая инструкция. Для каких задач обычно используют эти документы? По данным опроса ABBYY, 62% респондентов ищут информацию в PDF, 60% — копируют текст из документа, а 52% — редактируют: вносят в файл правки, исправляют ошибки и опечатки.

Даже сейчас не все знают, что можно редактировать текст в PDF. Да, изменение таких файлов устроено не так, как редактирование обычного текстового документа. ABBYY FineReader PDF с многофункциональным текстовым редактором для работы с PDF и сканами позволяет быстро внести изменения прямо в PDF, без утомительной конвертации файла в другие форматы. При редактировании текст в PDF плавно перетекает со строчки на строчку, как в MS Word. Можно добавить или удалить несколько слов, изменить целые абзацы или даже поменять их местами.

В этом посте мы раскроем технические подробности редактирования многострочных фрагментов текста в FineReader: как мы изменили движок программы, как редактирование устроено изнутри и как оно выглядит для пользователя. Поехали!
Читать дальше →

Как правильно: Мане или Моне? Отвечает нейросеть

Время на прочтение4 мин
Охват и читатели3K
Художников Эдуарда Мане и Клода Моне путали и при жизни (вот очень интересная статья на Арзамас). Что неудивительно, ведь они оба родоначальники импрессионизма и писали в схожей манере. Слушая на coursera курс по Convolutional neural networks, я решила попробовать сделать модель, определяющую, кем из художников написана картина.
Читать дальше →

Рубрика «Читаем статьи за вас». Апрель 2020. Часть 2

Время на прочтение17 мин
Охват и читатели5.8K

Детектор приседаний на OpenCV и Tensorflow

Время на прочтение5 мин
Охват и читатели11K
В эпоху заточения хорошо заниматься физкультурой, но вот беда — не все домашние с этим согласны, так что приходилось прикладывать некоторые усилия. Работать надзирателем однако хотелось не очень, потому как надо было собственно работать, а пущеный на самотек спортивный процесс, наблюдаемый в лучшем случае одним глазом, заимел тенденцию скатываться в халяву.

Профессионально деформированный мозг беспокоился, что надо эти процессы как-то мониторить, собирать метрики, и делать это конечно не вручную, а чтобы оно все само себя посчитало.

Начать было решено с приседаний. Фундаментальное движение, с явными состояниями, большой амплитудой, в общем, идеальный выбор.
Читать дальше →