Обновить
128K+

Обработка изображений *

Работаем с фото и видео

184,02
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как мы распознаем средства индивидуальной защиты

Время на прочтение7 мин
Охват и читатели9.4K
Наверное, вам всю жизнь было очень интересно, как натренировать нейронную сеть распознавать людей в касках и оранжевых жилетах! Нет? Но мы все равно расскажем.

Нас зовут Татьяна Воронова и Эльвира Дяминова. Мы занимаемся анализом данных в компании «Центр 2М», много работаем с самыми настоящими заводами и предприятиями. Из-за нарушений техники безопасности они терпят многомиллионные убытки, работники получают травмы, поэтому хорошо бы уметь детектировать такие нарушения системно и как можно раньше. Лучше всего – автоматически. Так у нас появляются задачи, связанные с распознаванием на видео средств индивидуальной защиты (СИЗ) и определением людей или техники в опасной зоне.

image

По большей части к нам приходят заказы на определение касок (точнее, их отсутствие) и спецодежды. Мы уже накопили опыт в выполнении подобных задач и теперь можем описать проблемы, с которыми столкнулись, и способы их решения.
Читать дальше →

Алгоритмы пост-обработки результатов распознавания текстовых полей

Время на прочтение10 мин
Охват и читатели2.7K

(изображение взято отсюда)

Сегодня мы бы хотели вам рассказать о задаче пост-обработки результатов распознавания текстовых полей исходя из априорных знаний о поле. Ранее мы уже писали про метод коррекции полей на основе триграмм, который позволяет исправлять некоторые ошибки распознавания слов, написанных на естественных языках. Однако значительную часть важных документов, в том числе документов, удостоверяющих личность, составляют поля другого характера – даты, номера, VIN-коды автомобилей, номера ИНН и СНИЛС, машинно-читаемые зоны с их контрольными суммами и многое другое. Хотя их нельзя отнести к полям естественного языка, тем не менее у таких полей зачастую существует некоторая, иногда неявная, языковая модель, а значит, для них тоже можно применить некоторые алгоритмы коррекции. В этом посте речь пойдет об двух механизмах пост-обработки результатов распознавания, которые можно применять для большого количества документов и типов полей.
Читать дальше →

Определение параметров трансформации облака точек

Время на прочтение3 мин
Охват и читатели4.1K

Постановка задачи


Рассмотрим задачу нахождения угла поворота и смещения облака точек. Под облаком точек подразумевается набор точек на плоскости, сохраняющие взаимное расположение друг от друга, при их пространственном перемещении.


Т.е. есть два набора точек: исходное облако и облако преобразованное произвольным образом в пространстве (см. Рис. 1). Любое преобразование облака точек в пространстве можно интерпретировать как поворот и смещение. Таким образом, необходимо определить на какой угол требуется повернуть исходное облако точек и на какое расстояние его передвинуть от исходного облака точек, чтобы получить то самое, преобразованное произвольным образом облако точек.


Рис. 1 Пример облака точек, к которому применен поворот на 15 градусов, и смещение по оси Х: 10, по оси Y: 30


Читать дальше →

Распознавание документов и лиц: объединение во имя свободы или шаг к цифровой диктатуре?

Время на прочтение6 мин
Охват и читатели4.5K

Распространение по миру вируса COVID-19 вызвало резкое изменение паттернов потребительского поведения. В условиях роста панических настроений и предписаний соблюдать социальную дистанцию растет доля тех потребителей, которые сознательно или вынужденно отказываются от физического контакта с продавцом.


Тем самым стимулируется развитие дистанционных услуг и сервисов, таких как онлайн-заказ продуктов, бесконтактная курьерская доставка товаров повседневного спроса, оформление договоров на банковское и страховое обслуживание, открытие вкладов, получение дистанционной медицинской и юридической помощи. Более активно происходит замещение оборота наличных денег в торговле различными инструментами бесконтактных и дистанционных платежей.


iStock​ OJO_Images
Читать дальше →

Object Detection. Распознавай и властвуй. Часть 2

Время на прочтение9 мин
Охват и читатели30K

В прошлом посте я начал разбираться в двухступенчатых Object Detection моделях и рассказал о самой базовой и, соответственно, первою из них – R-CNN. Сегодня мы рассмотрим другие модели этого семейства: Fast R-CNN и Faster R-CNN. Поехали!
Читать дальше →

Как наш беспилотный трамвай видит реальный город

Время на прочтение8 мин
Охват и читатели30K
Привет, Хабр!

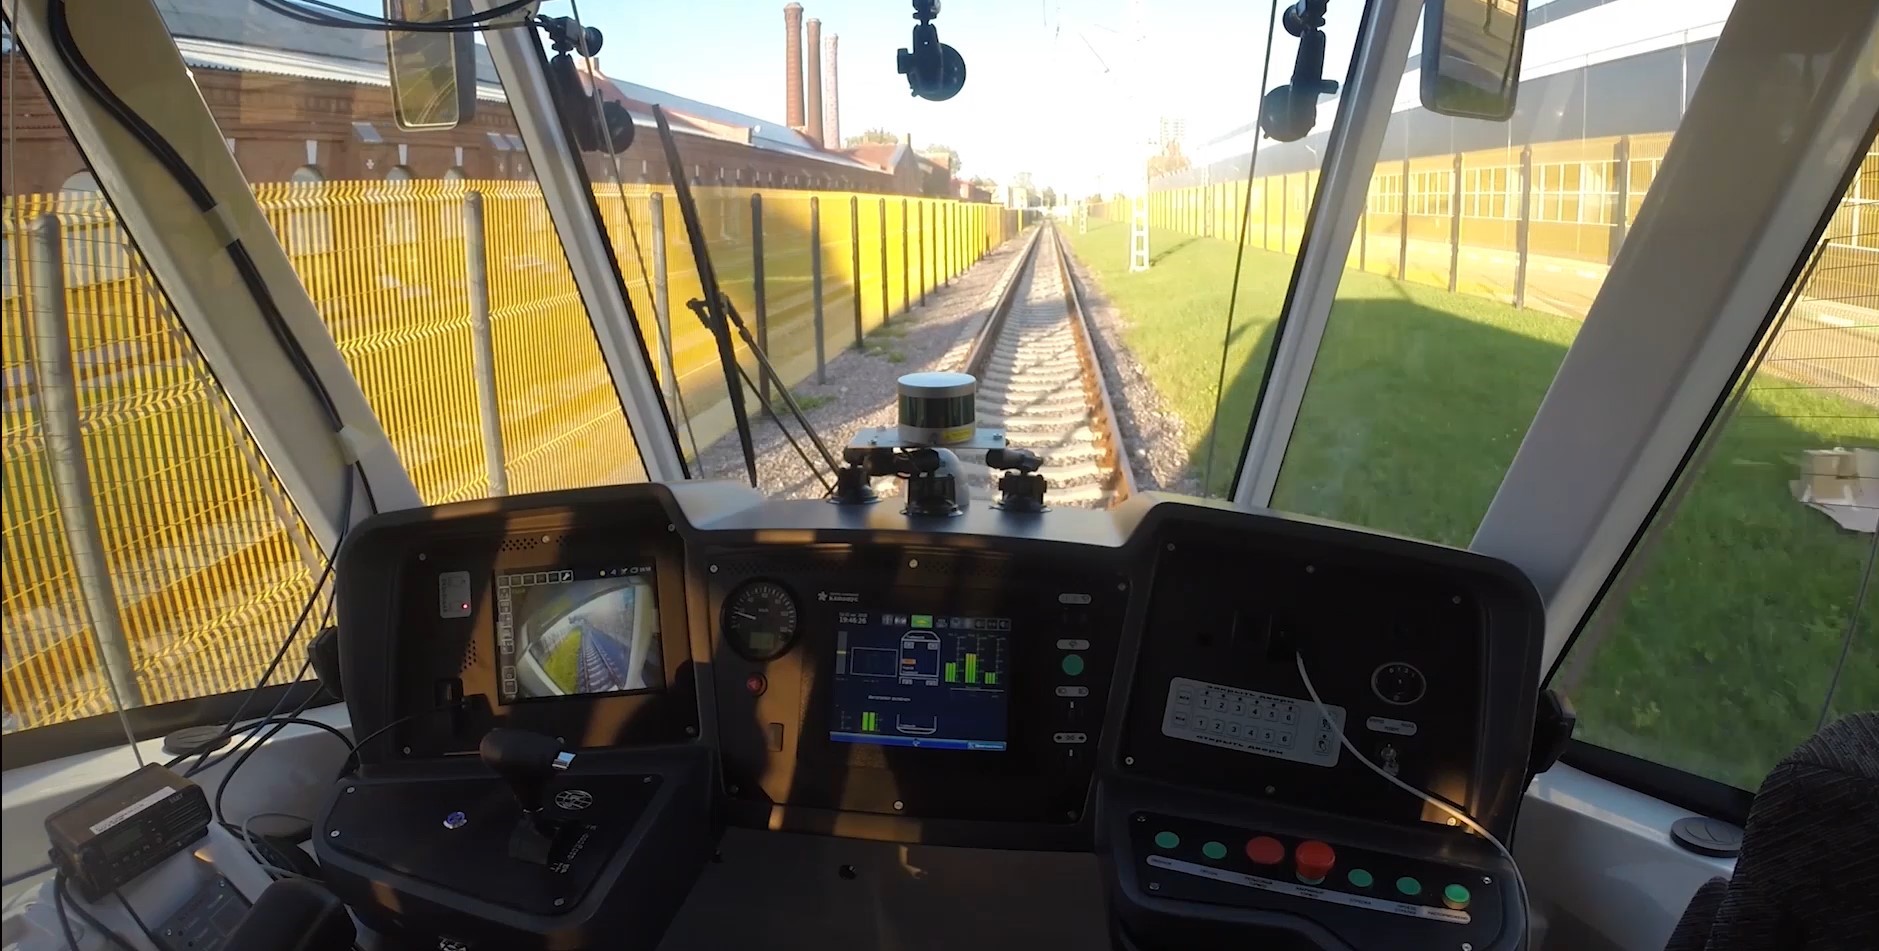
В общем, есть экспериментальный трамвай, который в рамках испытаний иногда ходил по одному из маршрутов. Автопилот тестируется на закрытой территории, а в городских — активный помощник водителя вагоновожатого. Водитель трамвая едет с руками на управлении, но тестируется именно автономный автопилот. Трамвай визуально не отличается от обычного, потому что мы вместе с производителем запихали приборные блоки далеко под панели и вывели интерфейсы на стандартные экраны. Единственное — у него можно заметить несколько камер под лобовым стеклом, спрятанный под обшивку радар и GPS-датчик на крыше. Да, ещё иногда для целей отладки мы привешиваем лидар.

image

За время испытаний мы узнали, что правила дорожного движения и реальная обстановка на дорогах даже для трамвая — это очень разные вещи.

Вообще трамвай — это идеальная «песочница» для полного автопилота автомобиля. Мы уже сейчас его реализовали. Наши читы:

  • Мы знаем маршрут и имеем гарантию, что наше ТС никуда с него не денется.
  • Можно проехать заранее и разметить точки со светофорами и прочим, чтобы системе было легче их распознавать.
  • Трамвай не может перестроиться из полосы в полосу. Большая часть нагрузки автопилота авто завязана на «куда сейчас отрулить» и тысячи сценариев, а у нас отрулить некуда.
  • Тормозит он почти мгновенно и немного резко, то есть прогнозы движения других автосредств на дороге менее сложные.

С чем реально есть проблемы — это с людьми на остановках, которые стараются пролезть первыми, рискуя жизнью.

Количественная оценка «эффекта чаши» на томографических изображениях

Время на прочтение8 мин
Охват и читатели2.4K

Привет, Хабр! Как вы уже знаете, мы в Smart Engines занимаемся обработкой изображений. Недавно мы написали статью о бинаризации томографических изображений с тонкой структурой, в которой попытались рассказать в чем собственно состоит метод рентгеновской томографии. Сегодня мы продолжим рассказывать о задачах, возникающих при работе с томографическими изображениями, а именно речь пойдет о чашевидных артефактах и об их количественной оценке.


Источник


Если интересно, то добро пожаловать подкат!

Читать дальше →

Как лазеры и сенсоры помогают сохранить нервы судьям

Время на прочтение11 мин
Охват и читатели3K
Привет, Хабр!

Оценить выступление спортсмена – задача, которая с каждым годом не становится проще. Увеличиваются скорости, усложняются программы, появляются новые элементы и их связки. Сравните хотя бы выступления фигуристов или гимнастов в Лондоне, Рио, Ванкувере или Сочи и программы, за которые их предшественники получали золото полвека назад. Разницу ощутит даже тот, кто не следит за спортом.


А судьи кто? Пусть и прекрасно разбирающиеся в своей сфере, но все же обычные люди, которые устают, отвлекаются, моргают, поддаются эмоциям. Результат – спорные решения, после которых болельщики готовы отправить всю судейскую коллегию «на мыло».
Раз человек не идеален, то почему бы не компенсировать слабые стороны последними достижениями науки и техники. Очередной dead heat у финиша навел Эдварда Мейбриджа на мысль, что вовремя сделанная фотография пересекающих черту скакунов избавит от горячих споров и не менее горячих их последствий, когда ставки столь высоки. К практике перешли быстро и впервые фотофиниш во время скачек был использован уже в конце XIX века. Первый видеоповтор отметит в этом году 65-летний юбилей. В теннисе еще с 1970-х годов используется electronic line judge – компьютеризированная система, которая определяет куда приземлился мяч.

Такие системы эффективны, когда к победе ведет определенное действие (пересечь финиш первым, забить мяч в ворота, прыгнуть выше соперников и т. д.), но почти бесполезны, когда лучшего определяют, например, по технике выполнения элементов, их количеству и последовательности в программе. Здесь нужно что-то посложнее простого Instant Replay. Компания Fujitsu в качестве решения видит технологию 3D-сенсоров, которая позволяет в реальном времени сканировать, оцифровывать и оценивать движения атлетов. Подробнее о принципе ее работы под катом.

Альтернативный метод классификации поля «пол» паспорта РФ с помощью нейронной сети

Время на прочтение6 мин
Охват и читатели3.7K

Источник: https://wiki.loginom.ru/articles/clustering.html


Задача распознавания текста не теряет своей актуальности на протяжении последних десятилетий. А сейчас, в период повсеместного введения дистанционного оформления документов, не обойтись без процедуры идентификации личности.


Классическая процедура распознавания текста включает в себя его локализацию, сегментацию и непосредственно распознавание. Методы, использующие сегментацию текста на символы, довольно популярны и хорошо изучены. Однако существуют такие виды текста, где сегментация на символы становится настоящим испытанием. Например, арабская и индийская письменности. Кроме того, различные повреждения изображений текста также затрудняют его сегментацию. Очевидным решением при ограниченном множестве слов является распознавание их целиком, без разбора на символы. При условии наличия полного словаря с этой задачей отлично справляются обычные классифицирующие нейронные сети. Но что же делать в случае, если словарь достаточно большой или вовсе не известен на этапе обучения?

Читать дальше →

Новые архитектуры нейросетей

Время на прочтение10 мин
Охват и читатели63K

Новые архитектуры нейросетей


Network


Предыдущая статья «Нейросети. Куда это все движется»


В этой статье кратко рассматриваются некоторые архитектуры нейросетей, в основном по задаче обнаружения объектов, чтобы найти (или хотя бы попытаться найти) будущие направления в этой быстро развивающейся области.


Статья не претендует на полноту охвата и хорошее понимание прочитанных «по диагонали» статей. Автор уверен, что пока писал эту статью, появилось еще много новых архитектур. Например, смотрите здесь: https://paperswithcode.com/area/computer-vision.

Читать дальше →

Кроссплатформенные оптимизации OpenCV

Время на прочтение8 мин
Охват и читатели5.5K

Библиотека OpenCV состоит из нескольких тысяч функций и алгоритмов. В этой статье мы хотим вам рассказать о том, как обеспечивается гибкость оптимизаций алгоритмов компьютерного зрения в OpenCV для разных архитектур, операционных систем и рабочих окружений.


Мы рассмотрим абстракцию parallel_for_ и механизм Universal Intrinsics и то, как переиспользовать это в вашем проекте.


Статья основана на лекции, которую команда OpenCV читала в рамках зимнего лагеря по оптимизации от Intel в 2020 году. Также доступна видеозапись этой лекции.


Читать дальше →

[в закладки] Работа с изображениями в веб

Время на прочтение18 мин
Охват и читатели151K
Одно из решений, которые приходится принимать фронтенд-разработчику при создании сайта, касается выбора способа включения изображений в состав веб-страниц. Этот способ может заключаться в использовании HTML-тега <img>. Это может быть применение CSS-свойства background или тега <image> элемента <svg>. Выбор правильного подхода к работе с изображениями весьма важен, так как это может очень сильно повлиять на производительность и доступность проекта.


Материал, перевод которого мы сегодня публикуем, посвящён изучению различных способов включения изображений в состав веб-страниц. Здесь будут обсуждены преимущества и недостатки этих способов. Кроме того, мы поговорим о том, когда и почему их обычно используют.
Читать дальше →

Автоматический детектор COVID-19 по снимкам флюорографии

Время на прочтение15 мин
Охват и читатели2.9K


Из этого руководства вы узнаете, как автоматически обнаружить COVID-19 в специально подобранном наборе данных с помощью Keras, TensorFlow и глубокого обучения.

Как и большинство людей в мире прямо сейчас, меня искренне беспокоит COVID-19. Я замечаю, что начал постоянно анализировать своё личное здоровье и подозревать, что я уже заразился.

Чем больше я об этом беспокоюсь, тем больше проявляется болезненное сочетание реальных симптомов с ипохондрией:

  • Проснулся утром, чувствую себя немного разбитым.
  • Когда выбрался из постели, то у меня уже потекло из носа (хотя теперь известно, что насморк не является симптомом COVID-19).
  • Пока добрался до ванной, чтобы взять салфетку, ещё и кашлянул.
Читать дальше →

Ближайшие события

Биполярные морфологические сети: нейрон без умножения

Время на прочтение10 мин
Охват и читатели4.7K

В наши дни трудно найти задачу, которую еще не предлагают решать нейронными сетями. А во многих задачах другие методы уже даже не рассматриваются. В такой ситуации логично, что в погоне за “серебряной пулей” исследователи и технологи предлагают все новые и новые модификации нейросетевых архитектур, которые должны принести прикладникам “счастье для всех, даром, и пусть никто не уйдет обиженным!” Впрочем, в индустриальных задачах чаще оказывается, что точность модели в основном зависит от чистоты, размера и структуры обучающей выборки, а от нейросетевой модели требуется разумность интерфейса (например, неприятно, когда ответом по логике должен быть список переменной длины).


Другое дело — производительность, быстродействие. Здесь зависимость от архитектуры прямая и вполне предсказуемая. Впрочем, не всем ученым интересная. Куда приятнее мыслить столетиями, эпохами, мысленно целиться в век, когда волшебным образом вычислительные мощности будут невообразимыми, а энергия добываться из воздуха. Однако и людей приземленных тоже хватает. И им важно, чтобы нейросети были компактнее, быстрее и энергоэффективнее уже сейчас. Например, это важно при работе на мобильных устройствах и во встроенных системах, где нет мощной видеокарты или нужно экономить аккумулятор. В этом направлении сделано немало: тут и малобитные целочисленные нейронные сети, и удаление избыточных нейронов, и тензорные декомпозиции сверток, и многое другое.


Нам же удалось убрать умножения из вычислений внутри нейрона, заменив их сложениями и взятием максимума, хотя мы и оставили возможность использовать умножения и нелинейные операции в функции активации. Предложенную модель мы назвали биполярной морфологической моделью нейрона.


Читать дальше →

Рубрика «Читаем статьи за вас». Март 2020. Часть 2

Время на прочтение13 мин
Охват и читатели6.7K

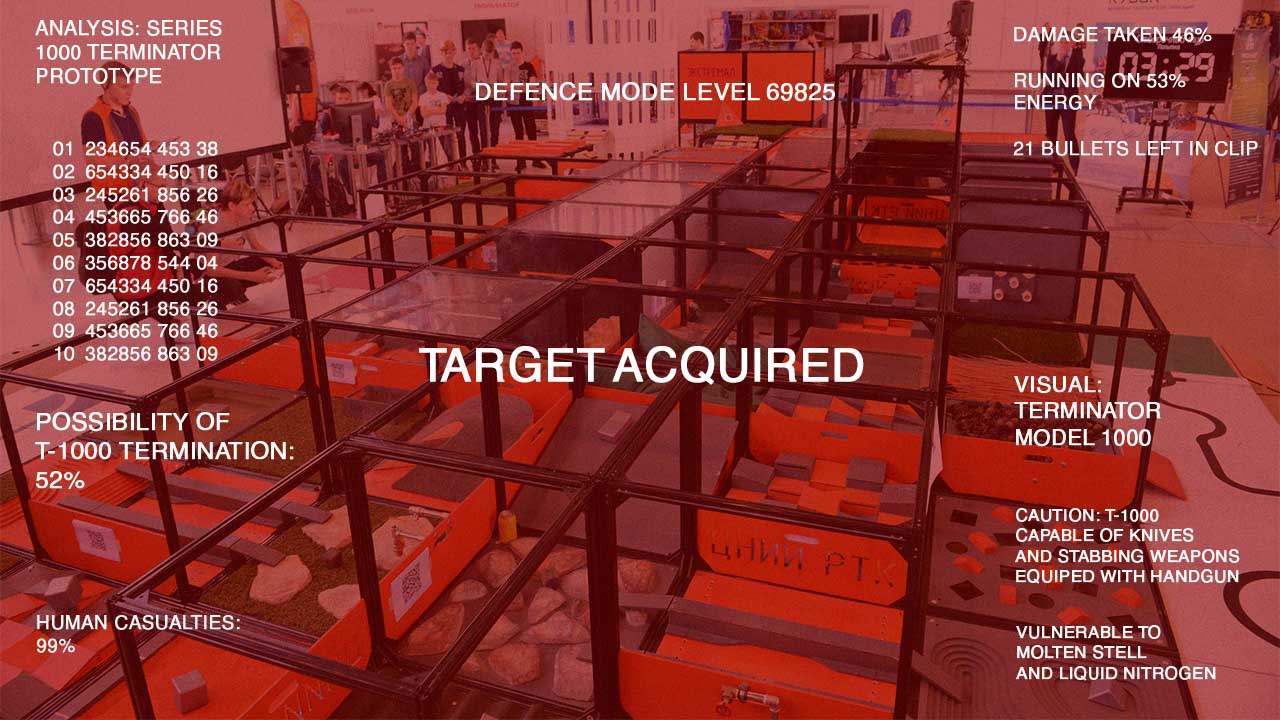
Автономная навигация мобильного робота

Время на прочтение22 мин
Охват и читатели16K
Существует огромное количество способов, при помощи которых робот может получать информацию из внешнего мира с целью взаимодействия с ним. Также, в зависимости от задач, поставленных перед ним, различаются и методы обработки этой информации. В данной статье я опишу основные этапы работы, выполненной в рамках школьного проекта, цель которого — систематизировать информацию, посвященную различным методам автономной навигации робота и применить полученные знания в процессе создания робота для соревнований «Кубок РТК».


Сжатие (компрессия) изображений различный форматов

Время на прочтение2 мин
Охват и читатели7.2K

Для того чтобы страницы сайта открывались быстро нужно использовать картинки как можно меньшего веса (размера файла). При этом, после компрессии качество изображений не должно сильно пострадать.

Чтобы выяснить, какой формат является оптимальным, мы провели тестирование форматов GIF, JPG, PNG и WEBP, и сравнили размеры получающихся файлов.

Методика тестирования


Компрессия осуществлялась на работающем сайте с помощью двух программ:
• Графическая библиотека GD, встроенная в PHP по умолчанию.
• Сторонняя программа ImageMagick и ее php-расширение Imagick.

Путем уменьшения настройки качества от 100 до 0 процентов, находилось значение, при котором качество изображения оставалось приемлемым.

Сразу скажем, что обе программы GD и Imagick дают одинаковый результат при одном и том же параметре качества (Q), поэтому все примеры приведены только для изображений, полученных в программе GD.

Реальные размеры для больших изображений 1600x900px, для миниатюр 400x225px — видимые размеры могут отличаться.

Миниатюрное изображения (thumbnail) 400x225px


По степени сжатия формат WEBP неоспоримый лидер.

Читать дальше →

Когда останавливать процесс распознавания видеопоследовательности?

Время на прочтение7 мин
Охват и читатели2.2K
Привет хабр! Сегодня мы бы хотели рассказать вам об очень интересной задаче, которой мы занимаемся с самого старта наших исследований распознавания документов в видеопотоке – задаче поиска оптимального момента остановки.


Читать дальше →

Как мы сделали автопилот для сельхозкомбайна на видеоаналитике первыми в мире

Время на прочтение9 мин
Охват и читатели33K
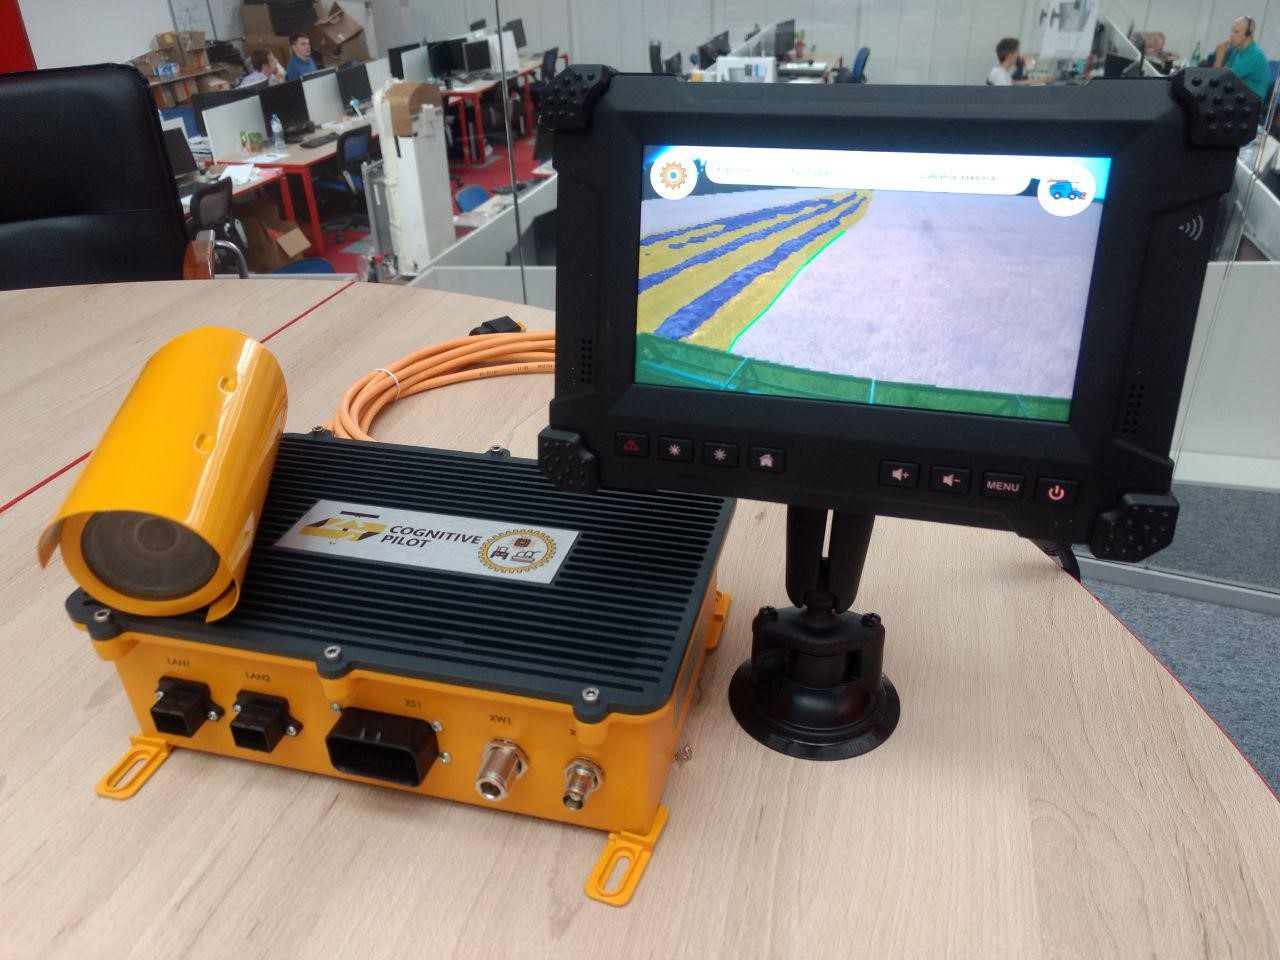
image
Вот и весь комплект, если есть CAN-шина.

Всего пять лет назад не было нормально работающих нейросетей для того же определения препятствий и краёв стеблестоя, поэтому не было и видеоаналитики. Были «слепые» GPS-методы, которые на практике оказались далеко не лучшими и сильно подмочили престиж автоматизации в сельском хозяйстве. Через пять лет, как мы считаем, все комбайны будут автоматизированы именно визуальными автопилотами, чтобы смотреть из кабины и в стороны и контролировать все аспекты уборки урожая.

Мы находимся в том моменте, когда у нас уже есть готовые технологии, они отлично опробованы, дёшевы и имеют годовую практику эксплуатации, и крупные производители комбайнов с интересом на них смотрят. Скорее всего, будет как с автомагнитолами: сначала они ставятся в машины, а потом машины приходят с уже встроенными. Вот и мы сейчас модифицируем старые комбайны, но хотим занять место в экосистеме и ставить комплекс на все новые.

Такой проект мог стартовать у нас, в Бразилии и ещё в паре стран из-за особенностей рынка. Нужна страна с сельским хозяйством, разработчиками внутри, неэффективной уборкой (то есть чёткой болью сэкономить) и новым парком комбайнов. Повезло со всем, включая парк: после СССР всё развалилось, и сейчас мы наблюдаем машины примерно четырёх- пятилетней давности в основных хозяйствах.

В России 350 тысяч комбайнов, и поставляется ещё 35 тысяч в год. Это не рынок автомобилей, конечно, но, сделав правильное решение сейчас, пока туда ещё никто не пришёл, можно получить его весь.

Но давайте расскажу лучше, как именно это работает и как мы модифицируем комбайны в России.
Читать дальше →

Как мы считаем людей с помощью компьютерного зрения

Время на прочтение8 мин
Охват и читатели9.5K
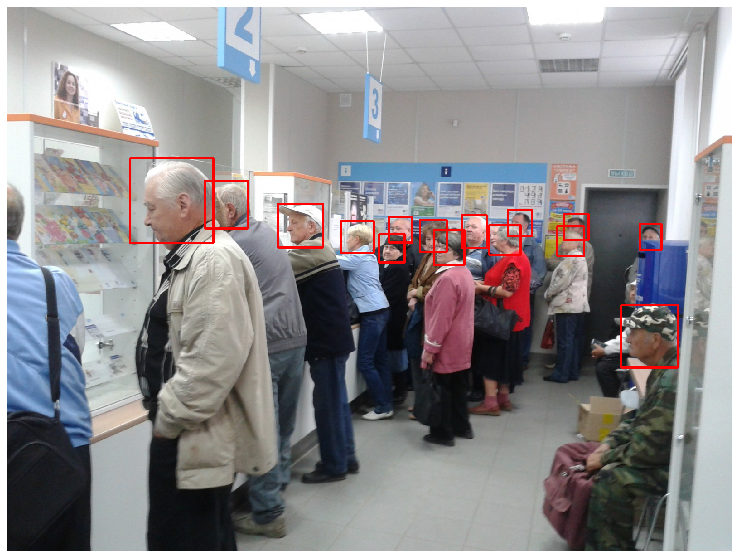
image
Фото из открытых источников

Массовые скопления людей создают проблемы в самых разных областях (ритейл, госслужбы, банки, застройщики). Заказчикам необходимо объединять и мониторить информацию о количестве людей во множестве мест: в офисах обслуживания, административных помещениях, на строительных площадках и т. д.

Задачи подсчета людей имеют готовые решения, например применение камер со встроенной аналитикой. Однако во многих случаях важно использовать большое количество камер, ранее уже установленных в разных отделениях. Кроме того, решение, учитывающее специфику конкретного заказчика, окажется для него более качественным.

Нас зовут Татьяна Воронова и Эльвира Дяминова, мы занимаемся анализом данных в компании Center 2M. Хотя тема кажется наиболее простой из того, что сейчас рассматривается в задачах компьютерного зрения, даже в этой задаче, когда дело доходит до практики (внедрения), приходится решать много сложных и нетривиальных подзадач. Цель нашей статьи – показать сложности и основные подходы к задачам компьютерного зрения на примере решения одной из базовых задач. Для последующих материалов мы хотим привлечь коллег: девопса, инженера, руководителей проектов по видеоаналитике, чтобы они рассказали про задействованные вычислительные ресурсы, замеры скорости, нюансы общения с заказчиками и проектные истории внедрения. Мы же остановимся на некоторых использовавшихся методах анализа данных.
Читать дальше →