Обновить
128K+

Обработка изображений *

Работаем с фото и видео

180,22
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Локализация QR-кода – важная задача, незаслуженно обделенная вниманием

Время на прочтение10 мин
Охват и читатели8.1K
Уверены, что на сегодняшний день не найдется ни одного читателя Хабра, который не был бы знаком с QR-кодами. Эти двумерные штрихкоды повсюду. Закономерно, что в мире существует много инструментов, позволяющих с некоторой долей эффективности добавить QR-коды в свой проект. Вся соль в том, что эта упомянутая эффективность напрямую зависит от качества инструмента, который используется для распознавания QR-кодов. И тут возникает классическая вилка: можно решить задачу (очень) хорошо и (очень) дорого, а можно бесплатно и как-то. А можно ли доработать бесплатное так, чтобы все-таки решить задачу хорошо? Если интересно, заглядывайте под кат.
Читать дальше →

О бинаризации томографических изображений с тонкой структурой

Время на прочтение10 мин
Охват и читатели2.9K

Бинаризация – классическая задача обработки изображений. Часто бинаризация используется для упрощения данных и ускорения последующей обработки, что в наше время уже не кажется важным. Но при анализе пористых материалов бинаризация принципиальна, поскольку модель данных здесь не подразумевает промежуточного состояния между пустой порой и непроницаемой матрицей. А алгоритма, прекрасно работающего «из коробки», как обычно, нет. Есть алгоритмы с настроечными параметрами, есть замечательные нейросетевые архитектуры. Чтобы они заработали, их нужно настроить/обучить. Что же делать, если в нашей задаче получение эталонных ответов очень трудоемко? Из этой статьи вы можете узнать об одном любопытном способе обойтись без разметки, а также познакомиться с миром вычислительной томографии и сопредельных областей.


Читать дальше →

Почему нужно роботизировать сельхозкомбайны, в чём сложности, и как мы это сделали за два года

Время на прочтение10 мин
Охват и читатели55K
В обычное время механизатор зарабатывает около 30 тысяч рублей в месяц. Но всё резко меняется во время уборки урожая, когда механизатор на время становится оператором комбайна — комбайнёром, за этот промежуток он получит до 150 тысяч рублей. Есть буквально две недели, когда нужно собрать всё, во что вы целый год вкладывали огромное количество денег за работу, удобрения, солярку и так далее. Работать можно примерно с восьми утра (настроить машину, в девять начать) до темноты, потому что роса и ночная влажность резко ухудшают качество зерна. На износ. И на третий-четвёртый день начинаются проблемы с авариями или перемалыванием не того и не так.

Со стороны кажется, что задача — проехать на комбайне по полю «змейкой» и «перемолоть» всю пшеницу или другую культуру. На деле всё далеко не так. Оператор должен следить за сотнями вещей и при этом постоянно смотреть на кромку поля, чтобы двигаться ровно. Представьте себе, что вы едете 12–14 часов по трассе на скорости 120 км/час за человеком, который раз в полчаса неожиданно тормозит. Примерно то же чувствует оператор: работа невероятно монотонная, но при этом постоянно нужно быть готовым к сюрпризу.

image
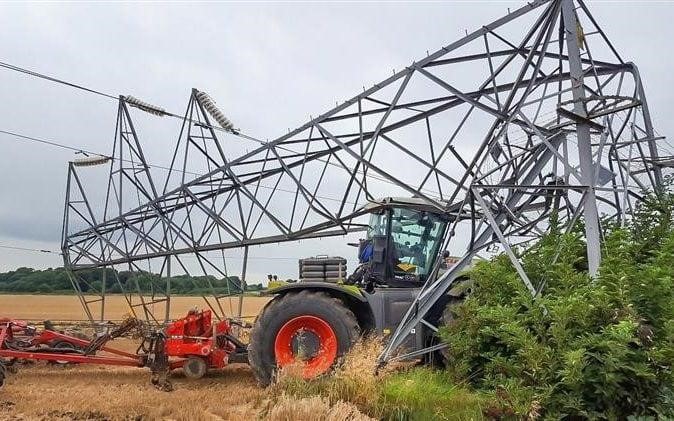
Сюрприз может выглядеть так. Пока мы ездили «в поля», не видели ни одного целого комбайна без следов сварки.

Фактически комбайнёр следит за процессом обработки зерна (одно рабочее место) и при этом ведёт технику (другое рабочее место). Но только это один человек. Следствие — страдает что-то одно. Поскольку, если плохо вести, можно случайно перемолоть камень или человека на поле, и страдает обычно качество уборки зерна.

Часть работы легко автоматизируется. Сейчас расскажу, что именно мы сделали и как мы модифицируем даже довольно старые комбайны своими роботами.

Регуляризация? Ортогонализация! Улучшаем компактные сети

Время на прочтение7 мин
Охват и читатели5.6K

Пока другие компании обсуждают управление коллективом на удаленке, мы в Smart Engines продолжаем делиться с вами своим стеком технологий. Сегодня про оптимизацию нейронных сетей. Сделать систему распознавания на основе нейронных сетей, которая могла бы быстро работать на смартфонах и прочих мобильных устройствах – крайне непросто. А сделать так, чтобы при этом качество было высоким – еще сложнее. В этой статье мы расскажем о простом методе регуляризации нейронных сетей, используемом нами в Smart Engines для улучшения качества «мобильных» сетей с малым числом параметров. Идея метода основана на постепенном уменьшении линейной зависимости фильтров в сверточных слоях во время обучения, благодаря чему каждый нейрон работает более эффективно, и следовательно, улучшается обобщающая способность модели. Для этого мы представляем фильтры в виде одномерных векторов и ортогонализируем пару с наибольшей длиной проекции друг на друга.
Читать дальше →

Алгоритм распознавания ценников, который работает даже на терминалах сбора данных

Время на прочтение8 мин
Охват и читатели4.4K

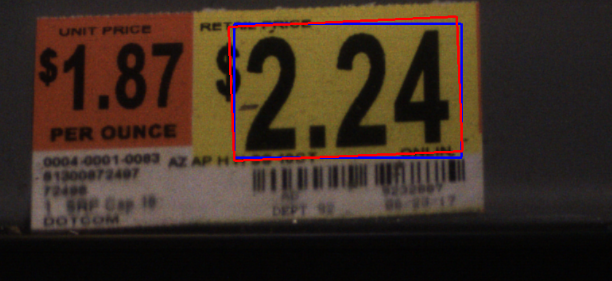
Привет, Хабр! Сегодня мы продолжаем нашу классическую серию статей про то, как с использованием методов обработки изображений и распознавания образов сделать что-то полезное с практической точки зрения. Сегодня речь пойдет о задаче распознавания ценников. Обычных ценников товаров, которые каждый может встретить в любом магазине. Только для обеспечения должной практичности мы добавим важное требование в постановку задачи: распознаваемые изображения получают при помощи малоформатной цифровой камеры, а вычислительное устройство имеет существенные ограничения по ресурсам. Другими словами, мы расскажем, как распознавать ценники на вычислительно слабом мобильном устройстве (кстати, здесь речь идет не столько о дешевом китайском смартфоне, сколько о специальных промышленных терминалах сбора данных, которые в силу ряда причин тоже обладают достаточно слабыми “мозгами”). Итак, если Вам интересна тема автоматизации ритейла, добро пожаловать под кат!


Читать дальше →

Как я сгенерировал на Python тысячу лиц для своей игры

Время на прочтение3 мин
Охват и читатели32K
На определённом этапе разработки своей игры я осознал, что мне нужна система диалогов с лицами-аватарами.

Поэтому я решил создать генератор лиц на основе знаменитой игры Papers, Please.


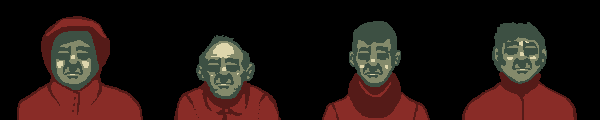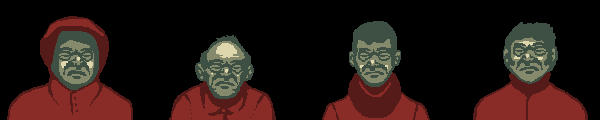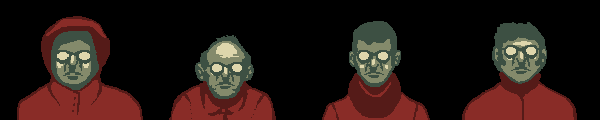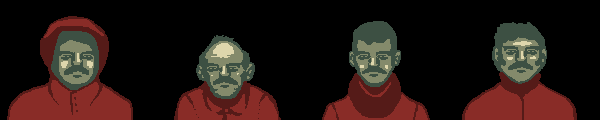
Генератор лиц Dukope (из Papers, Please)

Сбор данных


Я скачал примерно 50 портретов с pixabay.com (все изображения имеют лицензию CC и не требуют указания авторства).

Затем я вырезал фон каждого изображения в Photoshop (просто выбрал всё инструментом выделения многоугольника и нажал на Delete). В дальнейшем я планировал воспользоваться эффектом cutout , чтобы скрыть все недочёты.


Изображения с удалённым фоном
Читать дальше →

Использование современных графических форматов в веб-проектах

Время на прочтение10 мин
Охват и читатели23K
Эдди Османи, в статье «Цена JavaScript в 2018 году», озвучил одну ценную мысль: время, необходимое на обработку скрипта размером 200 Кб, и на обработку изображения, имеющего такой же размер, серьёзно различается. Дело в том, что при обработке кода браузеру нужно проделать более масштабную работу, чем при подготовке к использованию изображений. Вот что об этом говорится в статье:

JPEG-изображение нужно декодировать, растеризовать и вывести на экран. А JS-бандл надо, если рассматривать это упрощённо, загрузить, распарсить, скомпилировать, выполнить. На самом же деле движку приходится решать и другие задачи в процессе обработки JS-кода. В целом, стоит учитывать, что на обработку JavaScript-кода, размеры которого, в байтах, сопоставимы с размерами других материалов, тратится гораздо больше системных ресурсов.

Эти слова были написаны в 2018 году, но они до сих пор более чем справедливы. Правда, учитывая текущую обстановку, высказанная здесь мысль сегодня воспринимается немного иначе.


Читать дальше →

Нейросетевой калькулятор для сложения и вычитания не очень больших чисел

Время на прочтение5 мин
Охват и читатели28K

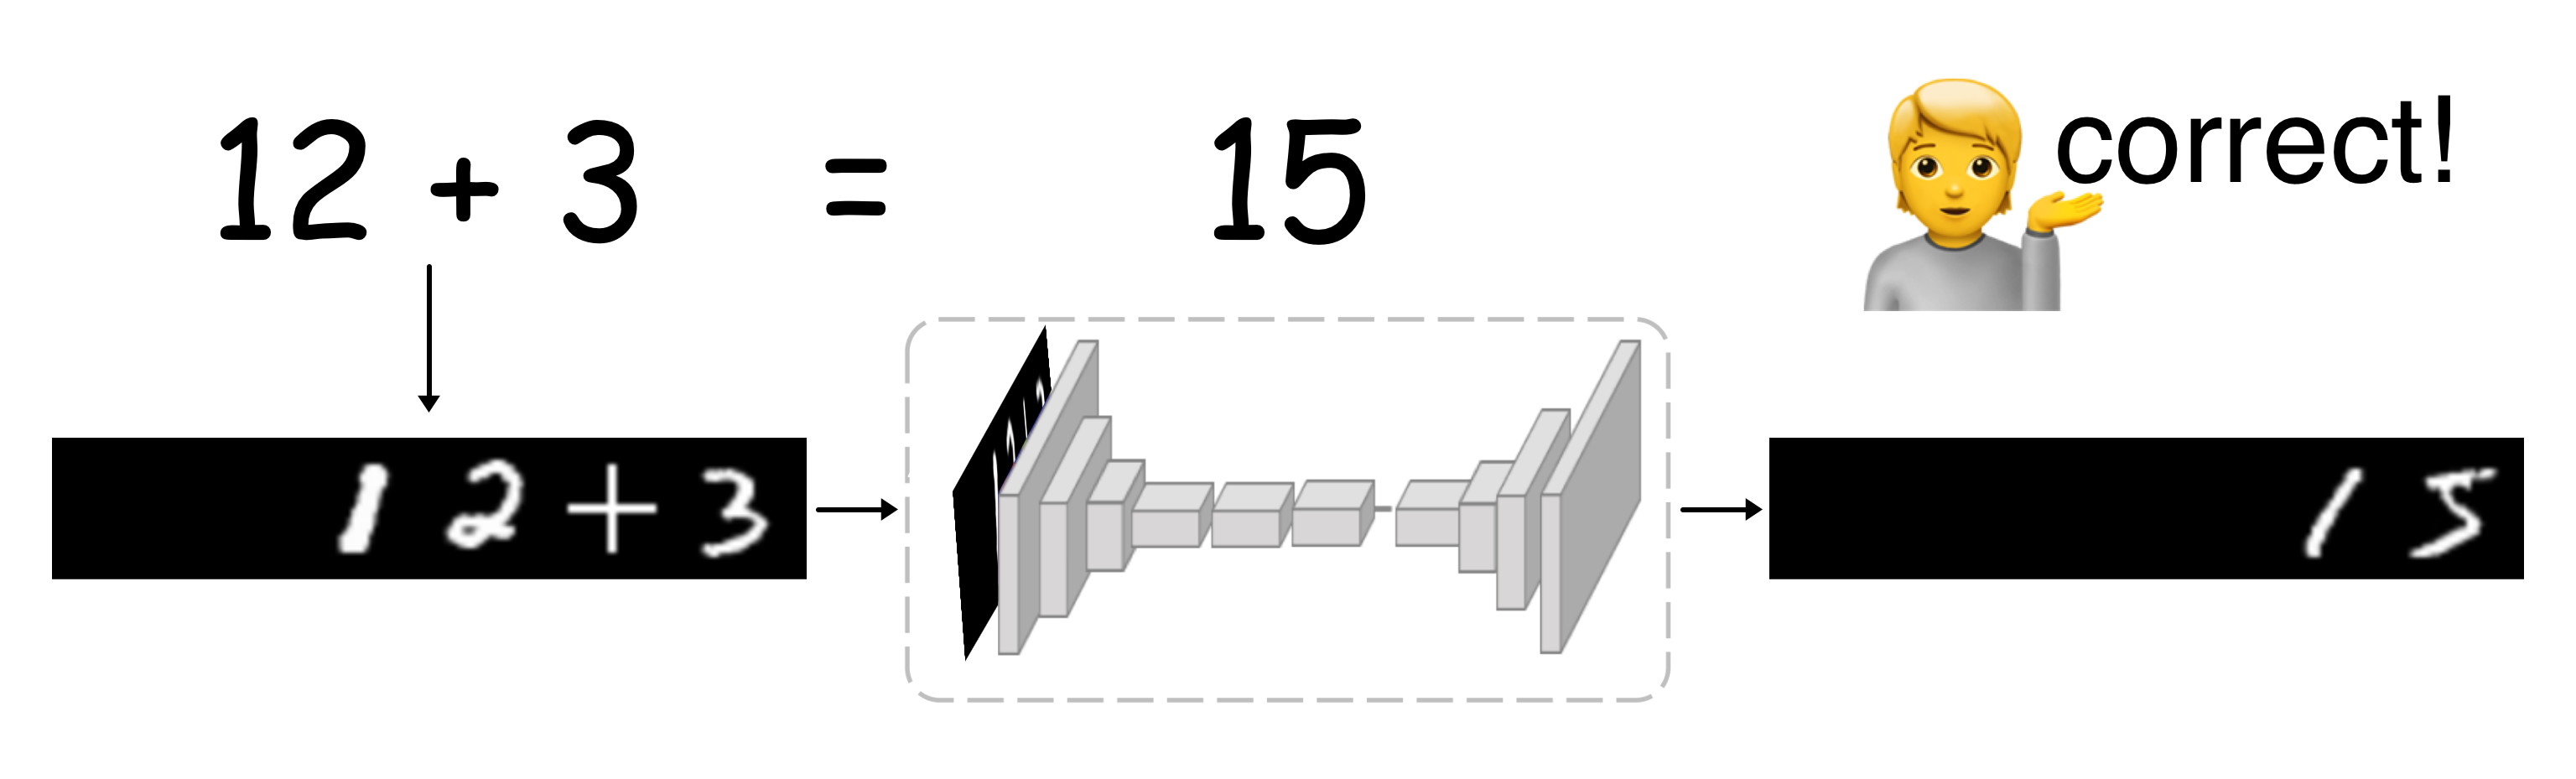
Мы рады представить хабросообществу наш смелый эксперимент: калькулятор, работающий на основе нейросети. Он работает следующим образом: математическое выражение преобразуется в изображение и подается на вход сверточной нейросети, которая генерирует изображение-результат. Полученный калькулятор генерирует изображения правильных ответов, не вычисляя заданное выражение в явном виде.


Работа уже опубликована на arXiv и сегодня будет представлена на конференции SIGBOVIK в формате аудиозаписи. В этом посте мы поделимся с вами результатами нашего эксперимента. Мотивация и детали реализации также под катом.


Читать дальше →

8-битные сети на Эльбрусе, есть ли смысл?

Время на прочтение10 мин
Охват и читатели5.7K

Привет, Хабр! Мы вдруг поняли, что наша последняя статья про Эльбрус вышла год назад. Поэтому мы решили исправить эту досадную оплошность, ведь мы не бросили эту тему!


Сложно представить распознавание без нейронных сетей, поэтому мы расскажем о том, как мы запустили 8-битные сетки на Эльбрусе и что из этого получилось. Вообще, модель с 8-битными коэффициентами и входами и 32-битными промежуточными вычислениями крайне популярна. Например, Google [1] и Facebook [2] завели ее собственные реализации, которые оптимизируют доступ в память, задействуют SIMD и позволяют ускорить вычисления на 25% и больше без заметного снижения точности (это конечно зависит от архитектуры нейронной сети и вычислителя, но нужно же было объяснить, насколько это круто?).


Читать дальше →

Про кафедру ABBYY в МФТИ. Мой личный опыт

Время на прочтение9 мин
Охват и читатели8.4K
Привет! Меня зовут Алексей, в этом году я заканчиваю учебу на бакалавриате ABBYY на Физтехе. А еще пишу диплом, работаю и все это делаю на удаленке. В этом посте я опишу свой опыт поступления на бакалавриат ABBYY: это было пару лет назад, в 2018 году, когда мир был более безопасным (на самом деле нет) и люди могли чаще трогать лицо руками.
Я расскажу о том, как я выбирал базовую кафедру и не сошел с ума, легко ли мне было поступить, поделюсь с вами впечатлениями от процесса обучения и стажировки и признаюсь, каково совмещать учебу с работой. Надеюсь, мой пост пригодится студентам, которые размышляют, на какую базовую кафедру в МФТИ поступать и на что при этом обратить внимание. Ведь выбор кафедры очень важен, от него зависит сфера развития на ближайшие несколько лет.
Читать дальше →

HoughNet: поиск точек схода сетью, сплавленной с классическим алгоритмом

Время на прочтение7 мин
Охват и читатели3K

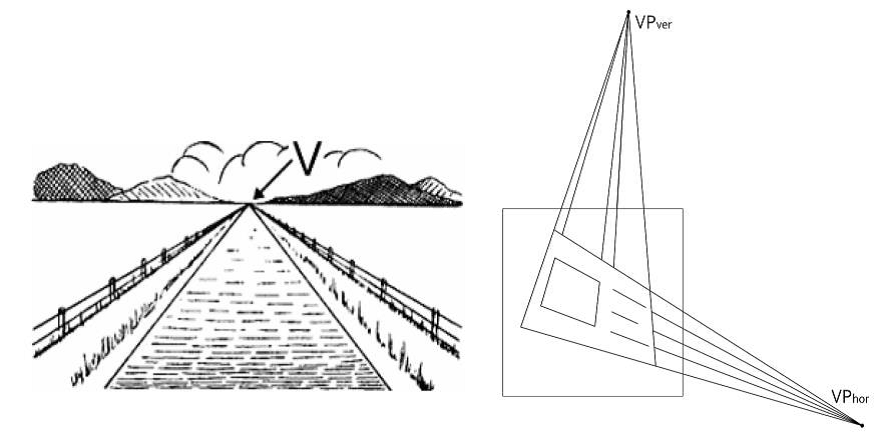
Пока в мире распознавания объектов обучают десятки и даже сотни зарекомендовавших себя архитектур искусственных нейронных сетей (ИНС), разогревая планету мощными видеокарточками и создавая «панацею» для всех задач компьютерного зрения, мы в Smart Engines твердо идем по исследовательскому пути, предлагая новые эффективные архитектуры ИНС для решения конкретных задач. Сегодня мы расскажем про ХафНет – новый способ поиска точек схода на изображениях.

Читать дальше →

Пять лет интенсивного развития рынка распознавания документов

Время на прочтение3 мин
Охват и читатели2.1K

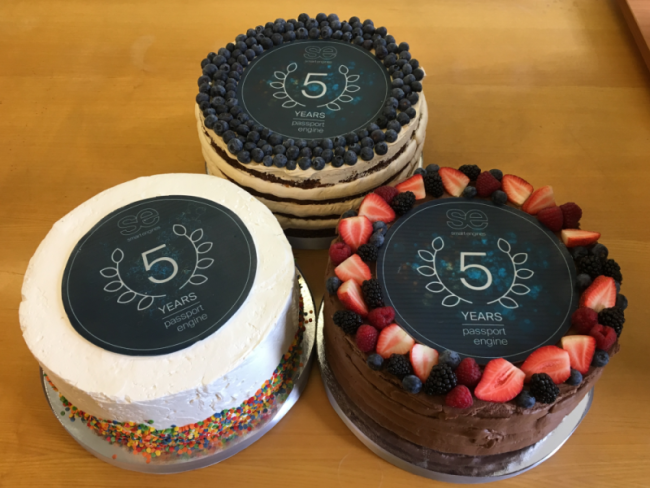
Хотя мы в Smart Engines, конечно, лютые технари, все равно очень любим дни рождения и юбилеи. Особенно, если виновник торжества — такое родное и милое, за развитием которого ты наблюдаешь каждый день. Да-да, на прошлой неделе мы праздновали пятилетие нашего главного продукта – системы распознавания паспорта РФ.

Ближайшие события

Картинки как коробки — что внутри? Доклад в Яндексе

Время на прочтение19 мин
Охват и читатели12K
Картинки и видео — это «чёрные ящики», внутри которых лежит много интересного и непонятного. Но можно заглянуть внутрь некоторых форматов, всё там поменять и посмотреть, что из этого получится.

Полина Гуртовая из компании «Злые марсиане» выступила на нашей конференции «Я  Фронтенд» в феврале. При помощи эксперимента Полина разобралась, как превращать простые картинки в «эффективные изображения» с метриками. Инструменты, которые могут делать это за нас, Полина рассмотрела ближе к концу доклада. Получился большой экскурс во внутренности и принципы работы разных форматов: от PNG и JPEG до AV1 и экзотики.


— Всем привет. Меня зовут Полина, я фронт в компании «Злые марсиане».
Читать дальше →

Вычисление центра масс за O(1) с помощью интегральных изображений

Время на прочтение12 мин
Охват и читатели16K


Интегральное изображение ― алгоритм, позволяющий эффективно вычислять сумму значений, заключенных в прямоугольном подмножестве многомерного массива. Сама его идея восходит к исследованиям многомерных функций распределения вероятностей, и до сих пор он находил успешное применение в тех областях, которые непосредственно используют теорию вероятностей в качестве основного инструментария. Например, в распознавании образов.

Сегодня мы рассмотрим любопытный случай, как применить интегральные изображения в кардинально другой сфере ― вычислительной физике. А именно ― посмотрим, что будет, если вычислить с их помощью центр масс поля импульсов, и какую выгоду можно извлечь из этого симбиоза.

В этой статье я расскажу:

  • Что за задача такая, о которой идет речь;
  • Подробнее об интегральных изображениях;
  • Как использовать интегральные изображения для приближенного решения гравитационной задачи N тел применительно к дискретному полю импульсов (масс-скоростей);
  • Какой недостаток имеет это решение и как его исправить;
  • И, наконец, как за константное время вычислить центр масс для произвольного региона.
Читать дальше →

Рубрика «Читаем статьи за вас». Январь — Февраль 2020

Время на прочтение22 мин
Охват и читатели8.2K


Привет, Хабр! Продолжаем публиковать рецензии на научные статьи от членов сообщества Open Data Science из канала #article_essense. Хотите получать их раньше всех — вступайте в сообщество!


Представлены обзоры 11 статей по Computer Vision, Natural Language Processing, Reinforcement learning и другим темам.

Читать дальше →

Как мы создавали галерею нейросетевого искусства и почему не даём копировать картины

Время на прочтение3 мин
Охват и читатели12K
Мы сегодня запустили виртуальную галерею, где все картины созданы нейронной сетью. Её особенность в том, что каждую картину в полном размере может забрать себе только один человек. Почти как в настоящей галерее.

В этом посте я расскажу о том, как родилась эта идея и как мы реализовали её с помощью двух нейросетей, одна из которых используется в поиске Яндекса.


На чем тестировать алгоритмы распознавания и обработки документов, удостоверяющих личность?

Время на прочтение6 мин
Охват и читатели6.3K

Как известно, мы в Smart Engines занимаемся системами компьютерного зрения и распознавания документов, а также научными исследованиями в этой области. В течение нескольких лет в фокусе нашего внимания находились системы распознавания документов, удостоверяющих личность. Одной из критичных проблем, возникающих при подготовке научных статей, является отсутствие открытых датасетов, на которых можно демонстрировать сообществу разработанные нами алгоритмы и подходы. В связи с этим два года назад мы начали работу над серией открытых пакетов изображений и видеоклипов ID-документов, предназначенных, главным образом, для исследователей, и о результатах этой работы хотели бы рассказать вам под катом.


Читать дальше →

Ваша первая нейронная сеть на графическом процессоре (GPU). Руководство для начинающих

Время на прочтение9 мин
Охват и читатели62K

В этой статье я расскажу как за 30 минут настроить среду для машинного обучения, создать нейронную сеть для распознавания изображений a потом запустить ту же сеть на графическом процессоре (GPU).

Для начала определим что такое нейронная сеть.

В нашем случае это математическая модель, а также её программное или аппаратное воплощение, построенная по принципу организации и функционирования биологических нейронных сетей — сетей нервных клеток живого организма. Это понятие возникло при изучении процессов, протекающих в мозге, и при попытке смоделировать эти процессы.

Нейронные сети не программируются в привычном смысле этого слова, они обучаются. Возможность обучения — одно из главных преимуществ нейронных сетей перед традиционными алгоритмами. Технически обучение заключается в нахождении коэффициентов связей между нейронами. В процессе обучения нейронная сеть способна выявлять сложные зависимости между входными данными и выходными, а также выполнять обобщение.

С точки зрения машинного обучения, нейронная сеть представляет собой частный случай методов распознавания образов, дискриминантного анализа, методов кластеризации и прочих методов.

Оборудование


Сначала разберемся с оборудованием. Нам необходим сервер с установленной на нем операционной системой Linux. Оборудование для работы систем машинного обучения требуется достаточно мощное и как следствие дорогое. Тем, у кого нет под рукой хорошей машины, рекомендую обратить внимание на предложение облачных провайдеров. Необходимый сервер можно получить в аренду быстро и платить только за время использования.
Читать дальше →

Трансформация цвета: поиски в прореженном столе

Время на прочтение9 мин
Охват и читатели11K

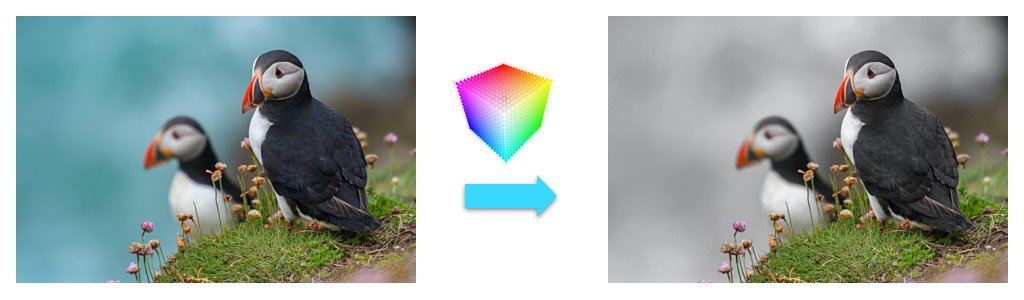
Это обзор функциональности, появившейся в Pillow 5.2: применение трехмерных таблиц поиска (3D lookup tables, 3D LUT) для трансформации цвета. Эта техника широко распространена в обработке видео и 3D-играх, однако мало графических библиотек могли похвастаться 3D LUT трансформациями до этого.


Трехмерные таблицы поиска дают большую гибкость в описании цветовых трансформаций, но самое главное трансформации выполняются за одинаковое время, какими бы сложными они не были.


from PIL import Image, ImageFilter

def washout(r, g, b):
    h, s, v = _rgb_to_hsv(r, g, b)
    if 0.3 < h < 0.7:
        s = 0
    return _hsv_to_rgb(h, s, v)

im = Image.open('./Puffins.jpg')
im = im.filter(ImageFilter.Color3DLUT.generate(17, washout))

Функция, полностью написанная на Пайтоне, применяется к 16,6-мегапиксельной картинке за 75ms.


Работа с изображениями и так ресурсоемка, поэтому я обожаю алгоритмы, которые позволяют убрать сложность от входных параметров. Пять лет назад я реализовал в Pillow гауссово размытие, работающее за одинаковое время для любого радиуса. Не так давно я рассказал как можно уменьшить изображение за константное время с минимальной потерей качества. Сегодня я покажу для каких задач можно применять 3D LUT, какие у нее ограничения и похвастаюсь достигнутой производительностью в Pillow-SIMD.

Читать дальше →