Обновить
128K+

Natural Language Processing *

Компьютерный анализ и синтез естественных языков

169,86
Рейтинг
Сначала показывать
Порог рейтинга

Для обучения Llama 4 наверняка потребуется почти в 10 раз больше вычислительных мощностей, чем для Llama 3. Такое заявление во время конференц-звонка по доходам за второй квартал 2024 года сделал Марк Закерберг, глава экстремисткой организации Meta, деятельность которой запрещена.

Совсем недавно вышла Llama 3.1 в нескольких вариантах, в одном из которых у большой языковой модели 405 млрд параметров. Для предобучения этой БЯМ 16 тыс. ускорителей Nvidia H100 обрабатывали датасет из 15 трлн токенов в течение 54 дней. Кстати, у варианта Llama 3.1 на 405 млрд параметров совсем недемократичные требования к инференсу: даже на RTX 4090 токен она будет выдавать по полчаса.

Стоимость предобучения настолько огромных БЯМ составляет сотни миллионов долларов. Блогеры прикидывают, что на обучение Llama 3.1 было потрачено никак не меньше $100 млн. Ресурс Information утверждает, что OpenAI тратит в год на обучение и запуск моделей по $7 млрд.

При этом БЯМ семейства Llama 3 бесплатно вышли для всех желающих, а продукты OpenAI проприетарны и работают через платный API. Впрочем, это никак не помогает последней выйти в плюс по деньгам. Если текущая финансовая траектория сохранится, OpenAI потеряет в этом году $5 млрд.

Теги:
Всего голосов 2: ↑2 и ↓0+2
Комментарии4

Дэвид Бресслер — автор Formula Bot, дополнения для Excel и Google Sheets, которое с помощью ИИ помогает писать формулы и автоматизировать задачи, а также обрабатывать и анализировать данные. Дополнение платное и пользуется популярностью, поэтому приносит Бресслеру десятки тысяч долларов дохода каждый месяц.

На днях Дэвид поделился наблюдением: при общении с клиентами сразу в четырёх случаях подряд ему рассказали, что впервые услышали про Formula Bot от ChatGPT. В твите Бресслер также приводит скриншот общения с ChatGPT, где на вопрос об умных инструментах для Excel большая языковая модель GPT-4o рекомендует продукт Дэвида. При этом БЯМ поставила встроенный в Excel майкрософтовский инструмент Ideas лишь вторым пунктом списка рекомендаций.

Formula Bot занимает первые строчки разнообразных рейтингов ИИ-дополнений для Excel, поэтому удивительного мало. Подобный ответ GPT-4o выдаёт не всегда. Сам Дэвид связывает проявление эффектами с чем-то уровня SEO.

Как утверждает Бресслер, ChatGPT не приводит много клиентов, в лучшем случае это дополнительные 10 %. Впрочем, в комментариях к твитам его всё равно просят научить приёмам поисковой оптимизации для ChatGPT.

Возможно, поисковая оптимизация для включения в текстовый датасет предобучения БЯМ когда-нибудь действительно станет востребованной.

Теги:
Всего голосов 1: ↑1 и ↓0+1
Комментарии0

Сайт с вакансиями правительства Соединённого Королевства Великобритании и Северной Ирландии опубликовал вакансию инженера промптинга больших языковых моделей. Трудоустроят специалиста в AI Safety Institute — организации, которую открыли на Саммите по безопасности ИИ 2023 года. Институт занимается оценкой продвинутых систем искусственного интеллекта, разрабатывает инструменты для контроля государства в этой сфере и помогает обмену информацией.

От специалиста ждут навыков в достижении нужного поведения БЯМ с помощью составления текстовых промптов, хорошее понимание БЯМ и их архитектуры, а также владение различными технологиями промптинга (chain of thought, ReAct, автоматическая генерация промптов и так далее). Нужно уметь оценивать БЯМ по таким метрикам, как BLEU, ROUGE и разнообразным бенчмаркам способности размышлять и писать код.

За плечами у соискателя должен быть реальный практический опыт построения приложений, которые полагаются на БЯМ для ответов на вопросы, генерации текста, помощи с кодом и других схожих задач. В вакансии также просят уметь писать на Python и вообще программировать. Будущий инженер промптов должен обладать хорошими навыками коммуникации, анализа показателей производительности моделей и их визуализации.

Размер суммарной финансовой компенсации составляет от 65 до 135 тыс. фунтов стерлингов.

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

ИИ AlphaProof в комбинации с Gemini достигает высокого уровня понимания математики. Google даже заявляет, что на Международной математической олимпиаде такая система получила бы серебряную медаль.

В реальном мире неточность больших языковых моделей удивляет. В Сети распространяют очередной тест на тупость БЯМ: просьбу сравнить числа 9,9 и 9,11.

Чаты по типу ChatGPT скармливают ввод от пользователя в БЯМ с неким ненулевым значением температуры, поэтому результаты генерации в ответ на один и тот же запрос могут различаться. К тому же не все скриншоты показывают полный контекст чатов. Тем не менее для почти всех доступных моделей есть примеры, где ИИ уверенным тоном объясняет, что 9,11 больше, чем 9,9. К примеру, эту ошибку демонстрируют ChatGPT, Claude и даже новая модель Llama 3.1 в варианте на 405 млрд параметров.

Объяснение ошибке найти просто. Как минимум в одном контексте 9.11 будет больше, чем 9.9 — версионирование программного обеспечения. Без дополнительного контекста математических вычислений БЯМ могут понимать вопрос неправильно.

На вопрос отвечает Llama 3.1-405B

Ошибка проявляется редко и может исчезать при изменении порядка слов в вопросе. Тем не менее пользователей крайне забавляет, когда ChatGPT вычитает 9,9 из 9,11 и получает 0,21, а отличный от собственного результат от API Python объясняет ошибками арифметики чисел с плавающей запятой. В другом случае модель Llama 3.1-405B согласилась, что совершила ошибку, но от утверждения «9,11 больше 9,9» не отказалась, придумав новое доказательство.

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии1

28 мая 2020 года на сайте препринтов arXiv.org опубликовали легендарную научную статью «Language Models are Few-Shot Learners», более известную как «статья про GPT-3». Позднее OpenAI улучшила большую языковую модель до GPT-3.5 и построила на ней сервис ChatGPT, чем привлекла 100 миллионов пользователей и миллиарды долларов инвестиций.

У оригинальной статьи про GPT-3 всего 31 автор. Некто Арун Пракаш составил элементарную статистику, как развернулась судьба этих людей в дальнейшем.

@arunprakashml

Как оказалось, за 4 года в OpenAI осталось менее половины оригинального состава авторов той статьи. Четверть из них ушли в Anthropic, ещё 29 % — в другие компании.

Теги:
Всего голосов 1: ↑1 и ↓0+3
Комментарии1

На днях OpenAI выпустила GPT-4o-mini — новую флагманскую модель для дешёвого сегмента, так сказать.

  • Говорят, работает «почти как» GPT-4o, а иногда даже круче GPT-4.

  • Почти в 3 раза дешевле GPT-3.5-turbo.

  • Размер контекста 128k токенов, против 16k у GPT-3.5-turbo.

Конечно я сразу побежал переводить на эту модель свою читалку новостей.

Если кратко подвести итоги, то это крутая замена GPT-3.5-turbo. У меня получилось сходу, не меняя промпты, заменить двух LLM агентов на одного и суммарно удешевить работу читалки раз в 5 без потери качества.

Но потом я полез тюнить промпт, чтобы сделать ещё круче, и начал сталкиваться с нюансами. Например, с замыливанием контекста и проблемами с большими запросами. Об этом можно прочитать у меня в блоге.

Теги:
Всего голосов 3: ↑1 и ↓2+1
Комментарии2

Хвостатое недоразумение покоряет GitHub!

Всё верно, я отметил «лишним не будет» =)

Большинство голосов оказалось за, а поэтому, спешу сообщить о выпуске полной некастрированной репы хвостатой на GitHub!

Для тех, кто в танке, ну или под наркозом, ну или просто пофек: речь идёт о стример-тян из этой статьи

P. S.
Код всё ещё никак не правил, это по-прежнему лютая свалка функций и принтов для отладки, но уж явно в более удобном виде, чем в статье :)

Позже доработаю инструкцию по запуску, чтобы каждый мог сделать свою нейро-тян

(устроим армию нейро-стримерш/ов, чтобы они наводнили ютуб и отправили обычных стримеров на завод😈 шутка, на деле просто выпускаю репу, чтобы таким же гикам, как я, было проще повторить этот опыт; ну и посмотреть на ваши эксперименты)

Теги:
Всего голосов 2: ↑1 и ↓1+1
Комментарии0

Как обратили внимание в микроблогах, Amazon умудрилась запатентовать обработку естественного языка. Выданный и опубликованный 7 мая 2024 года патент US11978437B1 так и называется: «Natural language processing».

Патент касается устройств и техник, которые «обычно описываются для изучения персонализированных концепций естественной обработки языка». В описании патента также упоминается такая сущность, как сессия диалога с пользователем. В тексте документа агенту с искусственным интеллектом предлагают переспрашивать пользователя и учиться на основе предыдущих предпочтений.

Рисунок 2 из текста патента

Что это всё должно значить, Amazon не поясняет. В СМИ про патент тоже не писали.

Уже не впервые в индустрии искусственного интеллекта что-то регистрируют настолько широкими мазками. К примеру, у Google с 2019 года есть патент на трансформеры — ныне широко известную технологию ИИ. Впрочем, современные большие языковые модели под патент Google чаще всего не подпадают.

Дело в том, что патент Google касается оригинальных трансформеров на архитектуре с комбинацией энкодеров и декодеров. Текущие популярные БЯМ построены либо только на декодерах (семейство GPT), либо только на энкодерах (BERT и похожие).

Теги:
Всего голосов 1: ↑1 и ↓0+1
Комментарии2

Развертывание локальной версии нейросети LLaMA с использованием Docker

Привет! В этом руководстве я покажу, как в несколько команд развернуть локальную версию нейросети LLaMA на вашем компьютере или сервере (работает на Windows, macOS и любых дистрибутивах Linux).

Шаг 1: Установка Docker

Для начала, установите Docker. Новичкам рекомендуется установить Docker Desktop.

Шаг 2: Запуск Docker контейнера

Откройте консоль и выполните следующую команду:

docker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama

Эта команда развернет локальный образ llama, который будет работать исключительно на вашем процессоре. Также существует вариант использования Nvidia GPU, с инструкциями можно ознакомиться здесь.

Шаг 3: Запуск языковой модели

Для запуска самой модели выполните команду:

docker exec -it ollama ollama run llama3:8b

Эта команда загрузит и запустит языковую модель llama3:8b (4.7GB). Также доступна более крупная версия llama3, 70b (40GB). Вы можете запускать и другие модели, список которых доступен здесь.

Чтобы запустить другую модель, используйте команду:

docker exec -it ollama ollama run model_name:tag

Интеграция в проекты

Использование языковой модели в таком формате может показаться неудобным. Более интересно интегрировать ее в свои проекты, например, в Telegram-бота с использованием Python.

Если вам интересно, как это сделать, подписывайтесь на меня. В следующем посте я покажу, как использовать локальную нейросеть (llama3) в Python проектах, включая создание Telegram-бота.

Теги:
Всего голосов 1: ↑1 и ↓0+1
Комментарии0

Привет! 14 сентября мы вновь проведём Practical ML Conf — ежегодную конференцию Яндекса, посвящённую практическим аспектам применения ML-технологий. Сегодня мы открыли приём заявок для тех, кто хотел бы поделиться своим опытом и выступить с докладом.

Ключевые темы конференции в этом году: CV, RecSys, MLOps, NLP, Speech и Analytics. Мы ожидаем глубокие технические доклады и хотим поговорить о прикладных решениях, которые уже сейчас приносят пользу. Сбор заявок завершится 13 июля. Программный комитет примет решение об участии на основании критериев «полезность», «новизна», «сложность» и «практичность».

Кстати, если вы планируете посетить конференцию в качестве слушателя, то рекомендую зарегистрироваться уже сейчас. Мы хотим провести болею узкую встречу специалистов компании и гостей перед основной программой конференции. Приоритет в рассылке приглашений на этот закрытый ивент будет у тех, кто зарегистрировался раньше. 

Предложить доклад, зарегистрироваться, найти более подробный таймлайн и доклады прошлого года — всё это можно на сайте конференции.

Теги:
Всего голосов 9: ↑9 и ↓0+12
Комментарии0

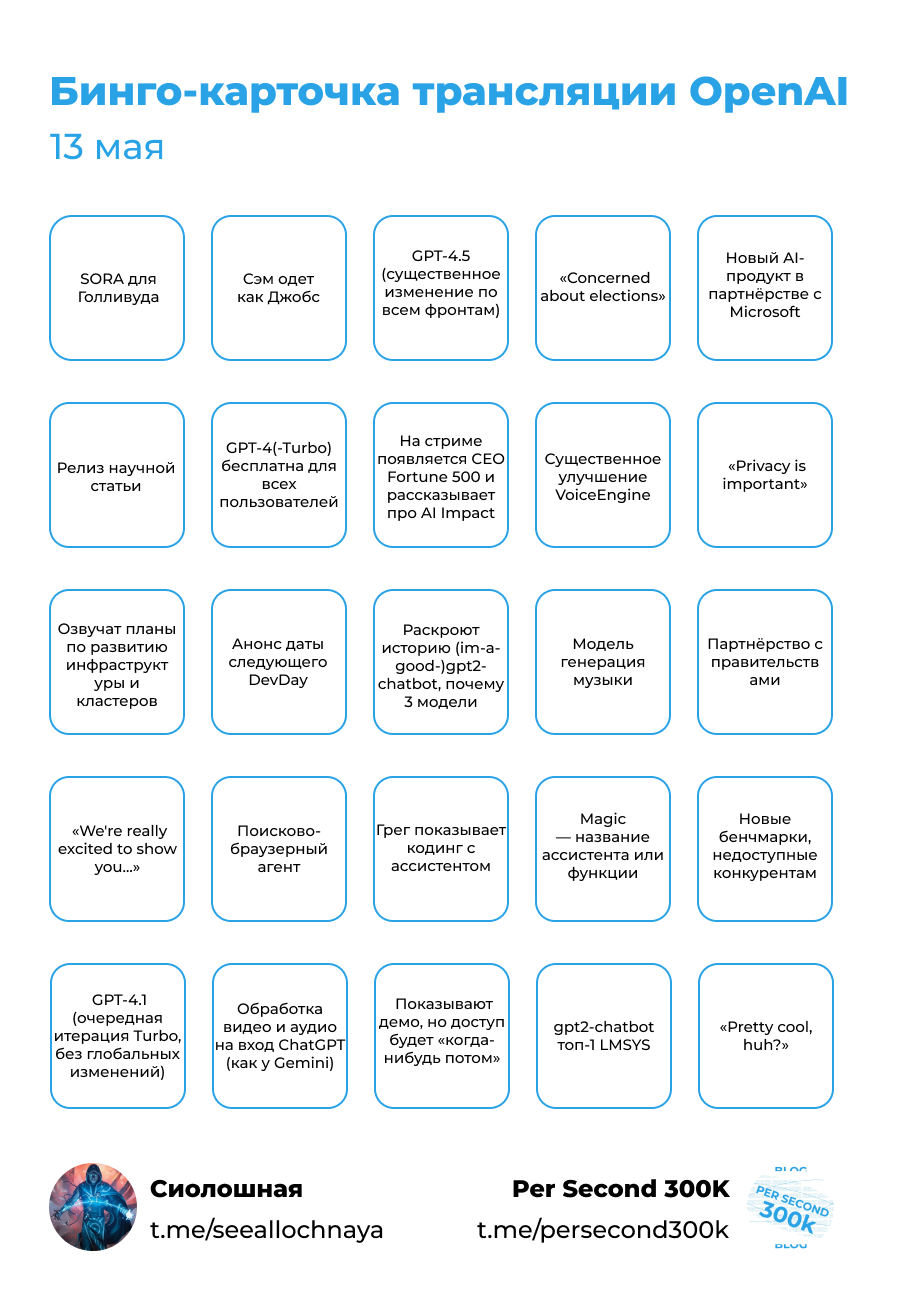
Совместно с Игорем Котенковым подготовили для себя и для вас Бинго-карточку на предстоящую трансляции OpenAI, чтоб было интереснее наблюдать!


Что именно покажут на презентации не уточнялось, но по словам Sam. A.:
`not gpt-5, not a search engine, but we've been hard at work on some new stuff we think people will love! feels like magic to me`

В твиттере много отсылок к слову "magic" и слухов по поводу голосового помощника, модели связанной со звуком.

В своем канале я оставлю короткую выдержку новостей и о какой магии говорят в openai!

Теги:
Всего голосов 2: ↑2 и ↓0+2
Комментарии0

Подборка статей для Research MLE


Не так давно я для себя понял, насколько важно читать научные статьи в ML, но сталкиваешься с тем что только 20% статей дадут тебе 80% результата. В своем Notion я собрал небольшую подборку самых интересных и полезных статей по LLM и RecSys. (которая кстати пополняется)

NLP:
Там есть как классические статейки от w2v, attention, transformers, gpt, gpt2, ...
Так и популярные или не так давно вышедших peft, llama, reft

RecSys:
Стараюсь пополнять интересными статейками от топовых лабораторий Meta, Deezer, Spotify, Netflix, X, ... Или годными статья из NIPS или ACM

На некоторые из этих статей я собираюсь писать обзорчики на Habr, кстати недавно вот написал про персонализированный Cold Start в Deezer. Про некоторые я выложу просто Summary в свой телеграм канал или сделаю конспект в Notion.

Если вдруг вам захочется пополнить этот банк статей, то можете закинуть свои идеи вот сюда.

Теги:
Всего голосов 2: ↑2 и ↓0+3
Комментарии0

Новая LLM для русского языка - краткий обзор.

Основные показатели при обучении

Завершено обучение первой языковой модели для русского языка с 1.6 млрд. параметров на TPU v4-128.

  • 4096 контекстное окно

  • Llama в качестве основной архитектуры

  • 128k vocab

  • 32B токенов в датасете

aeonium/Aeonium-v1-BaseWeb-1B

Теги:
Всего голосов 2: ↑2 и ↓0+3
Комментарии4

Ближайшие события

Выше пользовательского сообщения ChatGPT получает немного текста, который самому пользователю не виден. Этот текст — системный промпт. Он инициализирует бота: рассказывает, кто он такой, какой сегодня день и какие возможности доступны.

Получить системный промпт всё же можно, если попросить модель процитировать сообщение выше. Кстати, именно из-за изменений системного промпта качество работы ChatGPT могло ухудшаться. А меняться там есть чему: системный промпт у OpenAI составляет в длину 1700 токенов.

Системный промпт Claude.ai. AmandaAskell

Аманда Аскелл [Amanda Askell], специалист по этике в Anthropic, показала системный промпт бота Claude 3 и объяснила, что содержит каждый из абзацев:

  1. Имя, компания-создатель и текущая дата.

  2. Временная отсечка базы знаний и инструкция отвечать с учётом того, что данные уже устаревшие.

  3. Инструкция отвечать подробно, но не слишком длинно.

  4. Claude чаще отказывается выполнять задачи, связанные с правыми взглядами, чем с левыми. Четвёртый абзац призван с этим бороться.

  5. Аналогично, пятый абзац борется с тенденцией Claude стереотипно высказываться о группах, представляющих большинство, но уходить от стереотипов, если речь идёт про различные меньшинства.

  6. Четвёртый абзац приводит к тому, что Claude часто говорит, что обе стороны в чём-то правы. Шестой абзац это исправляет.

  7. Инструкция всячески помогать и писать код в Markdown.

  8. Восьмой абзац призван не спрятать системный промпт, а снизить его избыточную цитируемость.

Впрочем, системные промпты часто и быстро меняются.

Теги:
Всего голосов 3: ↑3 и ↓0+3
Комментарии0

Claude 3 можно научить черкесскому языку. Из-за принадлежности к адыгской подгруппе язык относительно изолирован от других. А ещё изучать его не так-то просто из-за сложной морфологии и ограниченности данных.

С таким необычным заявлением выступил энтузиаст hahahahohohe. В длинном твите он описал свою работу последних нескольких лет: из скудных источников он собрал 64 тыс. переведённых терминов и выражений, чтобы обучить модели русско-кабардинского машинного перевода.

Экспериментатор вставил в промпт справочные случайно выбранные 5,7 тыс. пар кабардинский – русский, затем попросил Claude 3 перевести текст. Казалось, что даже с малой толикой датасета БЯМ немедленно освоила то, на что у энтузиаста ушло 2 года.

Модель Opus продемонстрировала глубокое понимание структуры языка, правильно использовала заимствованные термины и проводила правдоподобный этимологический анализ. По запросу она могла даже сочинять новые термины.

Действительно, язык представлен в Интернете относительно слабо: в «Кабардино-черкесской Википедии» на сегодняшний день 1635 статей и 232 482 слов. Но в датасете предобучения язык всё же был в некотором объёме.

Как признался энтузиаст на следующий день, Claude 3 знает черкесский и так. Opus умеет переводить и общаться на языке, пусть и с ошибками. И вообще, поначалу модель переводить с черкесского просто отказывается, что и подкрепило иллюзию изучения языка из промпта.

Впрочем, предоставление дополнительных данных в промпте действительно улучшает качество работы модели.

Теги:
Всего голосов 4: ↑4 и ↓0+4
Комментарии2

Джейсон Вэй — известный исследователь направления языковых моделей. Имя Джейсона стоит первым на различных научных докладах Google: про эмерджентные способности (arXiv:2206.07682), промптинг в стиле цепочки рассуждений (arXiv:2201.11903) и FLAN (arXiv:2109.01652).

У Джейсона есть брат Джерри Вэй, который стажировался в различных структурах Google. С мая Джерри проходил стажировку в Google DeepMind, а с июля 2023 года работает там на постоянной основе. Джерри тоже успел отличиться и выпустил доклад про symbol tuning (arXiv:2305.08298).

Джейсон же в феврале этого года перешёл из Google в отдел ChatGPT в компании OpenAI. Как рассказывает перебежчик, культура в компаниях заметно отличается: вместо небольших исследовательских групп Google пришлось привыкать к крупным командам OpenAI. Чтобы адаптироваться, Джейсон рекомендует больше внимания уделять документации, простоте дизайна и качеству инструментов разработки. Также, если верить Джейсону, в OpenAI кормят лучше, чем в Маунтин-Вью, хотя ещё вкуснее еда в сингапурском офисе Google.

Братья не прекращают общение и регулярно видятся, но не забывают подтрунивать мемами в социальных сетях друг над другом.

Теги:
Всего голосов 3: ↑3 и ↓0+3
Комментарии0

На личном сайте Брендана Байкрофта на странице bbycroft.net/llm опубликована интерактивная визуализация работы большой языковой модели.

Всё работает прямо в браузере с пошаговой обработкой промпта. По нажатию пробела происходит переход от одной стадии к другой. Алгоритмическая сложность разнообразных структур демонстрируется в трёхмерном пространстве. Архитектура модели наглядно разбита на отдельные составляющие, будто это конвейер мебельной фабрики.

Код проекта выложен на аккаунте Байкрофта на GitHub.

github.com/bbycroft/llm-viz

Теги:
Всего голосов 11: ↑11 и ↓0+11
Комментарии0

Ни для кого не секрет, что достучаться до живого человека техподдержки бывает весьма затруднительно. Нулевой линией выстраивают глупых и навязчивых роботов. Чтобы его преодолеть, кто-то начинает ругаться нецензурно (и нынешние боты картинно "обижаются"), кто-то делать что-то ещё более несуразное.

У меня есть предположение, что существуют некие магические фразы для преодоления этого рубежа - ну, в конце-концов, как-то эту штуку же отлаживают.

Предлагаю делиться такими проверенными магическими фразами для прохождения заградительного слоя чат-ботов, стоящих грудью на нулевой линии техподдержки многих сервисов.

В качестве затравки предлагаю найденную и проверенную фразу для вызова человеков в чате поддержки теле2.

Итак:

  • tele2 - бот изыди

К слову о восстании роботов - яндексовый Шедеврум отказался генерировать картинку с таким промптом... Кто пробьёт эту защиту? ))

Теги:
Рейтинг0
Комментарии0

Запуск модели искусственного интеллекта следующего поколения Gemini от Google задерживается. Теперь ожидается, что её выпустят в начале 2024 года, а не в этом месяце.

В этом году Google объединила две команды ИИ в одну группу, которая работает над новой моделью, способной конкурировать с GPT-4 от OpenAI. Её лидер Демис Хассабис в июле заявлял: «Мы уже чувствуем, что через пару месяцев будут видны преимущества и сильные стороны проекта Gemini, нашей мультимодальной большой модели следующего поколения. Это довольно впечатляюще».

Ранее представители Google пообещали некоторым облачным клиентам и деловым партнёрам, что к ноябрю они получат доступ к новому диалоговому ИИ компании. Но теперь разработка Gemini задерживается. Одновременно замедлились продажи облачных технологий Google, в то время как у конкурента Microsoft они ускоряются.

Теги:
Всего голосов 5: ↑5 и ↓0+5
Комментарии0

RAG или Finetuning?

В AI сообществе сложилась определенная классификация подходов к решению задач с помощью LLM. Вот хорошая статья про это. Мне была полезна такая классификация, возможно, будет полезна и вам. Позволю себе краткое саммари статьи.

Итак, есть два подхода.

RAG - Retrieval-Augmented Generation. Берут "generic" LLM, обученную на большом массиве данных и дополняют решение поиском по базе знаний, специфичной для вашего домена. Подходит, например, если делаете систему помощи для работы с внутренней базой знаний компании.

Finetuning. Снова берут уже обученную на большом датасете LLM и дообучают ее на меньшем наборе данных, специфичном для домена. Подходит, например, если делаете болталку на специфичные темы.

Простой набор вопросов, который поможет выбрать путь:

Выбирай RAG, когда: 

- требуется доступ к внешним источникам данных

- необходимо минимизировать галлюцинации модели

- нет большого набора данных для тюнинга модели

- специфичные данные меняются во времени

- необходима возможность анализировать источники и причины ответов системы

Выбирай Finetuning, когда:

- требуется модификация поведения или стиля ответов модели

- есть большой набор данных для тюнинга модели

- доменные данные статичны

- нет необходимости анализировать источники и причины ответов системы

Канал Чуть больше продакта

Теги:
Рейтинг0
Комментарии0