Обновить
8K+

Параллельное программирование *

Распараллеливаем вычисления

8,93
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Реактивное программирование на Java: как, зачем и стоит ли? Часть II

Время на прочтение15 мин
Охват и читатели96K

Реактивное программирование — один из самых актуальных трендов современности. Обучение ему — сложный процесс, особенно если нет подходящих материалов. В качестве своеобразного дайджеста может выступить эта статья. На конференции РИТ++ 2020 эксперт и тренер Luxoft Training Владимир Сонькин рассказал о фишках управления асинхронными потоками данных и подходах к ним, а также показал на примерах, в каких ситуациях нужна реактивность, и что она может дать.

В первой части статьи рассказывалось о том, что привело к появлению реактивного программирования, где оно применяется, и что нам может дать асинхронность. Пришло время рассказать о следующем шаге, позволяющем получить максимум преимуществ от асинхронности, и это — реактивное программирование. 

Читать далее

Параллелизм и плотность кода

Время на прочтение19 мин
Охват и читатели4.9K

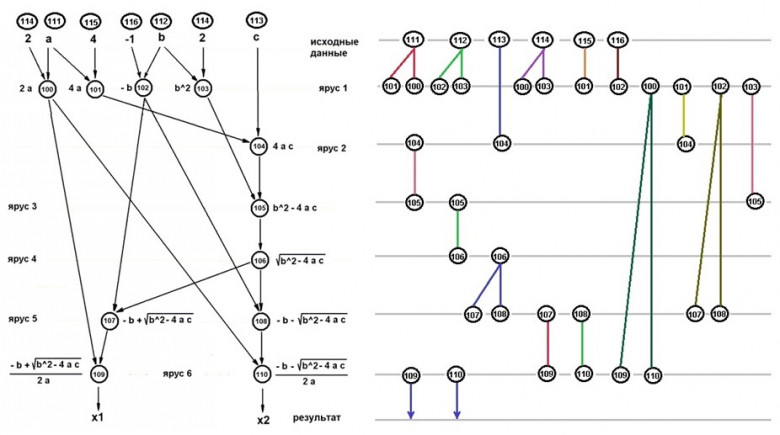
Продолжаем наши исследования по выбору рациональных планов (здесь к месту использование термина  каркасов, ибо на этом этапе от конкретных технологий параллельного программирования будем абстрагироваться) выполнения параллельных программ (ПВПП) по графовому описанию
алгоритмов. Приоритетом при этом будем считать  получение ПВПП с максимальным использованием вычислительных ресурсов (собственно параллельных вычислителей), такая цель соответствует представлению о плотности кода (об этом понятии подробнее ниже).

Естественным перед началом анализа будет указание ограничений на ширину и глубину исследований. Принимаем, что многозадачность в рассматриваемых параллельных системах осуществляется простейшим путём - перегрузкой всего блока (связки) выполняющихся операторов (одновременное выполнение операторов разных программ не предполагается) или же система работает в однозадачном режиме; в противном случае высказанное в предыдущей фразе утверждение может быть неверным. Минимизация   объёма устройств временного хранения данных (описано здесь) проводиться не будет. На этом этапе исследований также не учитываются  задержки времени на обработку операторов и пересылку данных между ними (для системы SPF@home формально эти параметры могут быть заданы в файлах с расширениями med и mvr).

В предыдущей публикации была описана технология получения ПВПП на основе модели потокового (Data-Flow) вычислителя. Обычно считают, что правила выбора операторов для выполнения в такой машине подчиняются логике действия некоторых сущностей, совместно выполняющих определённые  действия – “актёров” (actors); при этом естественным образом моделируются связанные с характеристиками времени параметры обработки операторов. В общем случае при этом отдельные операторы выполняются асинхронно.  В публикации показано, что описанный принцип получения ПВПП приемлем (при выполнении несложных условий) и для машин архитектуры VLIW (Very Long Instruction Word, сверхдлинное машинное слово),  отличающихся требованием
одновременности начала выполнения всех операторов в связке. В расчётах использовали модель ILP (Instruction-Level Parallelism,  параллелизм  уровня машинных команд).

Читать далее

Многопоточность на низком уровне

Время на прочтение14 мин
Охват и читатели43K

Очень часто при обсуждении многопоточности на платформе .NET говорят о таких вещах, как детали реализации механизма async/await, Task Asynchronous Pattern, deadlock, а также разбирают System.Threading. Все эти вещи можно назвать высокоуровневыми (относительно темы хабрапоста). Но что же происходит на уровне железа и ядра системы (в нашем случае — Windows Kernel)?


На конференции DotNext 2016 Moscow Гаэл Фретёр, основатель и главный инженер компании PostSharp, рассказал о том, как в .NET реализована многопоточность на уровне железа и взаимодействия с ядром операционной системы. Несмотря на то, что прошло уже пять лет, мы считаем, что никогда не поздно поделиться хардкорным докладом. Гаэл представил нам хорошую базу по работе процессора и атомнарным примитивам.


Вот репозиторий с примерами из доклада. А под катом — перевод доклада и видео. Далее повествование будет от лица спикера.

Как построить четкие модели классов и получить реальные преимущества от UML. Часть 4

Время на прочтение9 мин
Охват и читатели4.5K

Пришло время посмотреть на тип модели классов UML, который можно встретить во множестве проектов. А ещё, увы, который часто поощряется в книгах по UML.

Читать далее

Реактивное программирование на Java: как, зачем и стоит ли? Часть I

Время на прочтение12 мин
Охват и читатели60K

Идея реактивного программирования появилась сравнительно недавно, лет 10 назад. Что вызвало популярность этого относительно нового подхода и почему сейчас он в тренде, рассказал на конференции РИТ++ 2020 эксперт и тренер Luxoft Training Владимир Сонькин. 

В режиме мастер-класса он продемонстрировал, почему так важен неблокирующий ввод-вывод, в чем минусы классической многопоточности, в каких ситуациях нужна реактивность, и что она может дать. А еще описал недостатки реактивного подхода.

Читать далее

Project Loom: Современная маcштабируемая многопоточность для платформы Java

Время на прочтение27 мин
Охват и читатели30K


Эффективное использование многочисленных ядер современных процессоров — сложная, но всё более важная задача. Java была одним из первых языков программирования со встроенной поддержкой concurrency. Ее concurrency-модель, основанная на нативных тредах, хорошо масштабируется для тысяч параллельно выполняющихся стримов, но оказывается слишком тяжеловесной для современного реактивного программирования с сотнями тысяч параллельных потоков.


Ответ на эту проблему — Project Loom. Он определяет и реализует в Java новые легковесные параллельные примитивы.


Алан Бейтман, руководитель проекта OpenJDK Core Libraries Project, потратил большую часть последних лет на проектирование Loom таким образом, чтобы он естественно и органично вписывался в богатый набор существующих библиотек Java и парадигм программирования. Об этом он и рассказал на Joker 2020. Под катом — запись с английскими и русскими субтитрами и перевод его доклада.

Intel oneAPI Toolkit — Intel Studio на новый лад

Время на прочтение4 мин
Охват и читатели8.7K


8 декабря 2020 года состоялся официальный выпуск (gold release) набора средств для разработки софта под различные архитектуры Intel oneAPI toolkit. Это событие не попало на ленты информагентств, и даже мы в блоге, увы, его пропустили. Между тем, оно важно для огромной армии программистов по всему миру. Intel oneAPI — это новая ипостась хорошо известных многим из вас Intel Parallel Studio XE и Intel System Studio с новыми компонентами. Да, Студии Intel теперь называются oneAPI toolkit, и об этом стоит поговорить.
Читать дальше →

Вычислительная система пятого поколения

Время на прочтение24 мин
Охват и читатели13K

В 80 годы прошлого века правительство Японии совершило попытку создать распределенную вычислительную систему следующего поколения с элементами ИИ. Проект закончился достаточно закономерным провалом. Причина провала достаточно проста, почему то посчитали, что простого наличия технологии производства больших интегральных схем хватит для качественного "скачка" в вычислительных технологиях (своеобразный переход качества в количество). Да, история повторилась, после изобретения компьютера, тоже была необоснованная уверенность в скором появлении ИИ и тоже провалилась.

Сейчас ИИ в основном разрабатывается как совокупность нейронов, объединенных в сеть. В свою очередь я попытался посмотреть на человеческий мозг, как на параллельную вычислительную машину. При этом не акцентируя внимание на элементах какого типа он базируется.

Читаем и думаем (второе обязательно)

Модели памяти C++ и CLR

Время на прочтение16 мин
Охват и читатели45K

Это расшифровка-перевод доклада Саши Гольдштейна, признанного лучшим на конференции DotNext 2016 Piter. С годами этот доклад стал лишь актуальнее прежнего: появление Mac на ARM-процессорах — еще один пример, почему разработчикам сегодня нужно думать не только о x86-архитектуре.


Речь пойдет о проблемах, с которыми вы можете столкнуться при написании многопоточного кода, если вы думаете, что достаточно умны, чтоб спроектировать свои собственные механизмы синхронизации.


То, что подходит процессорам Intel на архитектурах x86 и x86-64, может не подойти другой архитектуре. Как только вы перенесете свой код на другой процессор, например, на ARM для iPhone и Android, есть вероятность, что он перестанет работать как надо. Проблемы могут быть как очевидными (воспроизводиться с первого-второго раза), так и не очень (возникать только раз в миллион итераций). Вполне вероятно, что такие баги могут добраться до продакшна. Сегодня .NET и, конечно, C++ можно использовать не только на Windows и Intel, но и на других платформах, так что доклад будет полезен многим разработчикам.


Дисклеймер: статья предназначена для продвинутых читателей. Смотрите на свой страх и риск. За частое упоминание барьеров памяти и изменения порядка исполнения инструкций она получила возрастное ограничение 18+.
Читать дальше →

Динамика потокового вычислителя

Время на прочтение14 мин
Охват и читатели3.2K

В публикации https://habr.com/ru/post/530078/ я рассказывал  о возможностях пото́кового (архитектуры Data-Flow, далее DF) параллельного вычислителя. Особенности выполнения программ на нём столь необычны и интересны, что о них следует сказать “два слова”. Эксперименты проводились на компьютерном симуляторе DF-машины, входящем в исследовательский комплекс для выявления параллелизма в произвольном алгоритме и выработке рационального расписания  выполнения этого алгоритма на гомогенном или гетерогенном поле параллельных вычислителей (та же публикация).

Читать далее

Немного байт здесь, немного там — и вот вы уже говорите о том, как в действительности устроена память

Время на прочтение6 мин
Охват и читатели3.9K

Мой новый пост был навеян последним квизом по го. Обратите внимание на бенчмарк [1]:


func BenchmarkSortStrings(b *testing.B) {
        s := []string{"heart", "lungs", "brain", "kidneys", "pancreas"}
        b.ReportAllocs()
        for i := 0; i < b.N; i++ {
                sort.Strings(s)
        }
}

Будучи удобной обёрткой вокруг sort.Sort(sort.StringSlice(s)), sort.Strings изменяет переданные ей данные, сортируя их, так что далеко не каждый (по-крайней мере, как минимум, 43% подписчиков из twitter) мог бы предположить, что это приведёт к аллокациям [выделениям памяти на куче]. Однако, по-крайней мере в последних версиях Go это так и каждая итерация этого бенчмарка вызовет одну аллокацию. Но почему?

Читать дальше →

Лечим Java Reactor при помощи Kotlin Coroutines

Время на прочтение12 мин
Охват и читатели11K

На текущей работе пишем на Reactor. Технология классная, но как всегда есть много НО. Некоторые вещи раздражают, код сложнее писать и читать, с ThreadLocal совсем беда. Решил посмотреть какие проблемы уйдут, если перейти на Kotlin Coroutines, а какие проблемы, наоборот, добавятся.

Приступим к лечению

Введение в Data Parallel C++. Пишем первую программу

Время на прочтение7 мин
Охват и читатели15K


Перед вами введение в программирование на языке Data Parallel C++ или, коротко, DPC++. DPC++ основан на Khronos SYCL — это означает, что перед нами модель современного параллельного программирования. Новейшим текущим стандартом Khronos является SYCL 1.2.1, хотя предварительная спецификация SYCL 2020 уже доступна для изучения. Intel и другие участники рабочей группы SYCL в настоящее время занимаются финализацией следующей версии спецификации. DPC++ содержит расширения, которые облегчают использование SYCL, при этом многие из них, как ожидается, войдут в состав SYCL 2020. Внедрение таких расширений в компилятор DPC++ помогает сообществу оценить их эффективность заранее перед стандартизацией.
Читать дальше →

Ближайшие события

Клиент-серверный IPC на Python multiprocessing

Время на прочтение5 мин
Охват и читатели12K

Статья отражает личный опыт разработки CLI приложения для Linux.

В ней рассмотрен способ выполнения привилегированных системных вызовов процессом суперпользователя по запросам управляющей программы через строго описанный API.

Исходный код написан на Python для реального коммерческого приложения, но для публикации абстрагирован от конкретных задач.

Читать далее

Что такое температура и как её учитывать в молекулярном моделировании? Реализация на CUDA

Время на прочтение12 мин
Охват и читатели7K

Методы численного моделирования молекулярных систем, такие как молекулярная динамика, рассматривают эти системы как механические (что-то вроде набора шариков на пружинках). Однако, в отличие от механических систем, для молекулярных существует понятие температура. Вещество не может существовать без температуры, а температура – без вещества (на счет последней части утверждения есть и другое мнение). Из опыта мы знаем, что очень многие свойства вещества кардинально зависят от температуры, и, естественно, что её надо как-то учитывать. Для поддержания температуры в молекулярной динамике используются специальные алгоритмы-«термостаты». Наиболее известные среди них это термостаты Андерсена, Берендсена и Нозе-Гувера. Все они основаны на молекулярно-кинетической теории газов, где температура есть просто величина пропорциональная среднекинетической энергии молекул. Соответственно, работа данных термостатов осуществляется путём умножения скоростей частиц на некоторую величину.

Что же не так?

Это непростое условное выполнение

Время на прочтение18 мин
Охват и читатели6.8K

Некоторое время назад я рассказывал о программном комплексе для выявления скрытого параллелизма в произвольном алгоритме и технологиях его, параллелизма, рационального использовании. Одним из компонентов этого комплекса является т.н. “универсальный вычислитель”, выполненный в соответствии с архитектурой Data-Flow (далее DF, пото́ковый вычислитель, описание здесь).

Читать далее

Такие важные  короткоживущие данные

Время на прочтение8 мин
Охват и читатели3.4K

Поговорим о вре́менных данных, служащих для информационного обмена между отдельными вычислителями в (максимально близкорасположенных) параллельных вычислительных системах.

Читать далее

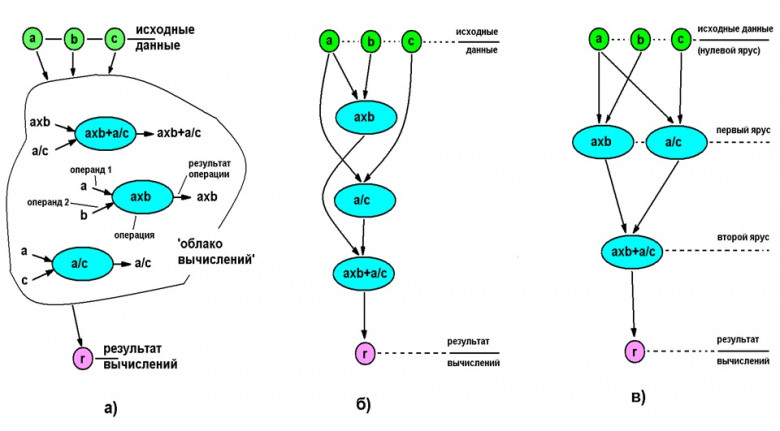
Есть ли параллелизм в произвольном алгоритме и как его использовать лучшим образом

Время на прочтение15 мин
Охват и читатели7.8K

Параллелизации обработки данных в настоящее время применяется в основном для сокращения времени вычислений путем одновременной  обработки данных по частям на множестве различных вычислительных устройств с последующим объединением полученных результатов. Параллельное выполнение позволяет “обойти” сформулированный лордом Рэлеем в 1871 г. фундаментальный закон, согласно которому (в применимости к тепловыделению процессоров) мощность их тепловыделения пропорциональна четвертой степени тактовой частоты процессора (увеличение частоты вдвое повышает тепловыделение в 16 раз) и фактически заменить его линейным от числа параллельных вычислителей – при сохранении тактовой  частоты). Ничто не дается даром – задача выявления (обычно скрытого для непосвящённого наблюдателя, [1]) потенциала параллелизма в алгоритмах не является "лежащей на поверхности", а уж эффективность его (параллелизма) использования – тем более.

Далее читать

Быстрый поиск по всем пользователям ВК

Время на прочтение8 мин
Охват и читатели21K

Задача:

Нужно пройтись по 650 000 000 пользователям ВК и вытащить только тех, кто живет в Москве. Затем отдельно обработать уже полученные айдишники.

Решение:

- генерация токенов для вк api

- асинхронные запросы

- код проекта в Google Colab (Python)

Читать далее

Что сказал-то?

Время на прочтение3 мин
Охват и читатели2.2K
«То что ясно всем, ещё кто-то должен сказать»
Типа эпиграфа, Google/Яндекс автора не сыскали

Это вторая часть статьи «То что ясно всем».
Для лучшего понимания изложенного в ней алгоритма Z добавлю здесь удачный пример, приведённый ранее в обсуждении/комментах.
Представьте себе, что стоит задача построить кривую некоей функции Т(Х) на заданном интервале (допустимых) значений. Сделать это желательно максимально подробно, но вы заранее не знаете, когда вас «схватят за руку». Вы хотите генерировать значения Х так, чтобы в любой момент, когда прервётся построение кривой (генерация параметров Х на интервале и вычисление Т(Х)), получившийся график максимально точно отражал эту функцию. Окажется больше времени — график будет точнее, но — всегда максимум из возможного на данный момент для произвольной функции.

Конечно, для известной функции алгоритм разбиения интервала может учитывать её поведение, но здесь речь идёт об общем подходе, дающем искомый результат с минимальными «потерями». Для двумерного случая можно привести пример отображения некоего рельефа/поверхности и желать быть уверенным, что сколько успели — отобразили максимум его особенностей.
Читать дальше →