Обновить
256K+

Python *

Высокоуровневый язык программирования

375,14
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

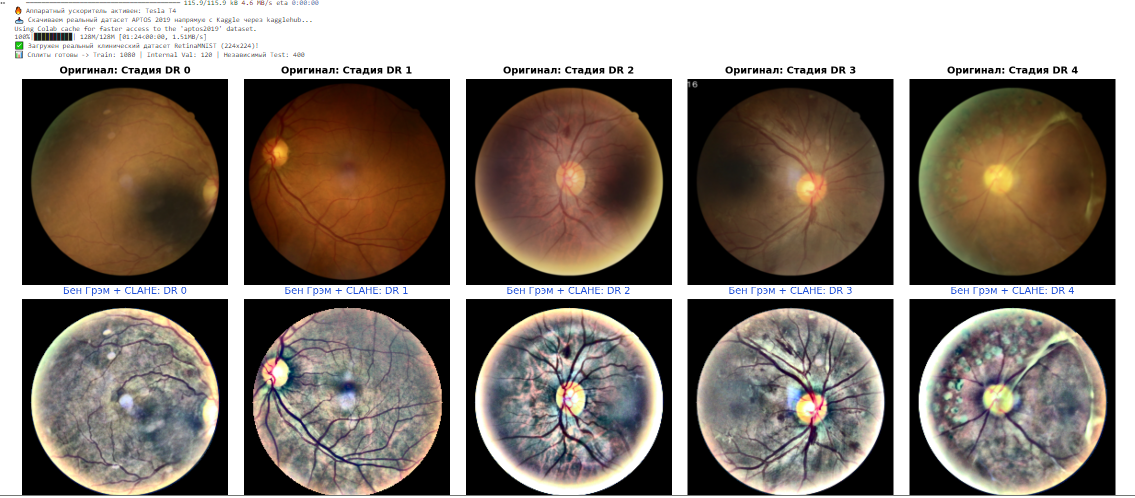
Как я собрал модель для определения стадии диабетической ретинопатии на бесплатном Colab

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели7.4K

Предыстория

Я собрал двухпоточную модель: она смотрит на снимок глазного дна и одновременно получает клинические показатели пациента. На отложенном тесте первый запуск дал QWK 0.834. Потом я стал разбираться, за счёт чего, и оказалось, что клинические признаки в моих данных содержат ответ. Я поставил три контрольных эксперимента, в том числе обучил отдельную модель только по снимкам. У неё QWK 0.713. Ниже весь пайплайн и способы, которыми такая утечка находится.

Читать далее

Как строить сканирование активов в MaxPatrol VM. Ч.4 — Автоматизация по API. Ч.0 — авторизация

Уровень сложностиСредний
Время чтения3 мин
Охват и читатели8.2K

Добрый день, дорогие читатели!

Мы с Вами просканировали основные типы активов. Можно выпустить гайды по сканированию сетевого оборудования и виртуализации, но здесь мне нечего добавить поверх официальной документации. Так что, мы переходим к большому пласту автоматизации через API, да еще и с примерами!

Все примеры кода будут на Python. Я уже давно не пишу на С++/С#. Любителей Go прошу понять и простить, за то что я не настолько модный.

Разговор про API начнем с авторизации, получения Bearer-токена и headers, которые будем использовать для каждого API-запроса.

Читать далее

Сколько живёт ссылка в ответе нейросети: сравнил три замера по 20 вопросам

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели7.1K

Если вы следите, ссылается ли нейросеть на ваш сайт, полезно знать, сколько ссылка держится в ответе на один и тот же вопрос. Недолго: через полтора месяца в ответах Алисы AI и Perplexity осталось от четверти до трети прежних ссылок (27,5% у Perplexity, 35,5% у Алисы AI), а больше половины ссылок оказались новыми.

Я задал обеим нейросетям 20 вопросов одной ниши (как попасть в ответы нейросетей, сколько это стоит, где заказать). На каждый вопрос каждая нейросеть ответила пять раз: три повтора подряд за час, ещё один через 5 дней и ещё один через полтора месяца. Отчёт о том, что вы в ответе, стареет быстрее, чем кажется.

Читать далее

Хватит жечь гигабайты на антидетекты: как RFC 9421 и открытый протокол wbauth ускоряют AI-агентов в 5,5 раза

Уровень сложностиСредний
Время чтения3 мин
Охват и читатели6.7K

TL;DR. Мы перестали маскировать агентов под людей. Теперь они предъявляют криптографический паспорт: подпись Ed25519 по стандарту IETF RFC 9421. Холодный старт — 5 мс вместо 1744 мс. Запрос — 15,8 мс вместо 86,8 мс. Память — 0,76 МБ вместо 500 МБ. Прокси не нужны. Ниже разбираю архитектуру, канонизацию, проверку на WAF, код и методику замеров. Ограничения замеров тоже описаны честно.

Пролог: 40 гигабайт RAM ради того, чтобы притвориться бабушкой

Типичная ферма агентов в 2026 году выглядит так. Есть кластер нод, на каждой крутятся десятки Camoufox, Playwright или AdsPower. Каждый процесс съедает от 500 МБ до 1,5 ГБ памяти. Есть пул резидентских IP, за который платят по гигабайту трафика. Есть отдельный модуль, который рисует кривые Безье, чтобы курсор двигался «по-человечески». И есть дежурный инженер, который в 3 часа ночи разбирается, почему после обновления fingerprint-эвристик у WAF отвалилось 30% сессий.

Посмотрите на это как архитектор. Мы строим систему, вся ценность которой в том, чтобы лгать о своей природе. Противоположная сторона строит систему, вся ценность которой в том, чтобы ловить эту ложь. Это гонка вооружений с нулевой суммой. Обе стороны платят за железо, никто не выигрывает, а цена растёт каждый квартал.

Антидетект — не инженерное решение, а костыль, который пытается решить задачу идентификации средствами мимикрии.

Задача идентификации в распределённых системах давно решена, и решается она криптографией.

Читать далее

Giga IDE Pro больше не будет. Но это хорошая новость

Время чтения6 мин
Охват и читатели15K

Pro-сборка была важным этапом в развитии GigaIDE: она позволила быстрее развивать профессиональные инструменты, собирать обратную связь от корпоративных пользователей и проверять сценарии, которые выходят за рамки Community-версии. Но у отдельного дистрибутива есть и обратная сторона: пользователю нужно выбирать сборку, командам — отдельно управлять установками, а продукту — поддерживать лишнюю развилку там, где её уже можно убрать.

Читать далее

Кэш не работал восемь недель. Всё это время он честно писал об этом в лог

Уровень сложностиСредний
Время чтения4 мин
Охват и читатели5.7K

Redis у сервиса прогнозов не было восемь недель: контейнер упал с кодом 255 и больше не поднялся. Всё это время каждый запрос считался заново, 1,9 секунды вместо 11 миллисекунд. При этом авария не была тихой. В обработчике ошибки стоит self.redis_client = None с комментарием про заглушку, но заглушки там нет, поэтому каждый вызов get и set падал с AttributeError, ловился своим же except и писал ERROR в лог. Две строки на каждый запрос, восемь недель подряд. Разбираю, почему я этого не видел, почему health сервиса всё это время отдавал вписанное в код «ok» с таймстампом из мая 2025 года, и чем аккуратно обработанный отказ отличается от обычной поломки.

Читать далее

Гауссовы сплаты как система частиц: разрушаемые корпуса для рогалика на Godot

Уровень сложностиСредний
Время чтения22 мин
Охват и читатели6.6K

Корпус дрона игрока и боссов в нашем рогалике AsterMaster — не меш, а облако из ~6000 гауссиан, выученное по рендерам из Blender и упакованное в полмегабайта. Поэтому его можно мять, дырявить, рвать на куски и собирать обратно — целиком в вершинном шейдере Godot.

В статье: зачем Gaussian Splatting в игре, где персонаж занимает сотню пикселей; пайплайн «Blender → gsplat → свой бинарный формат → Godot Compatibility» с тренировкой за 21 секунду; запечённые каналы, энтропийная бинаризация и чистка флоатеров; деструкция — кратеры, «луковица», граф опоры и куски по материалам; и честные пост-мортемы того, что не взлетело — с цифрами.

Читать далее

Можно ли заменить mypy на ty или Pyrefly в 2к26?

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели5.3K

Следуя принципу: “Работает - не трогай” и привыкнув к mypy еще очень много лет назад, я в какой-то момент собрал свой собственный конфиг линтеров и форматтеров и таскал его, то выкидывая, то добавляя что-то новое: там были flake8, isort, black, yapf, pylint, pyflakes… Но потом пришел Ruff, и всех их не стало. И только mypy пережил их всех. Надолго ли?

Посмотрев недавно на время прогона mypy в Gitlab CI, я решил обратить внимание на ty и Pyrefly как на возможную замену mypy: хотелось сократить время проверки и при этом не потерять в её качестве. Для сравнения взял два своих бэкенда, на которых mypy уже используется. Проверил время запуска с нуля и повторной проверки, а затем разобрал расхождения в диагностике.

Читать далее

Звезды Telegram: где купить, сколько стоят и как все работает

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели5.2K

Хотел купить звезды Telegram подешевле - в итоге разобрался, как самому их продавать.

Открыл поиск, а там звёздами торгуют все подряд. Даже МТС. Покупка одна и та же, цены разные - стало интересно, сколько можно сэкономить и что вообще делает продавец после того, как получает деньги.

Так обычный поиск дешёвых Stars превратился в разбор всей цепочки: от ввода имени получателя до платежа и подтверждения покупки. В приложенном коде можно увидеть, как эти действия автоматизированы.

Начну с цен: сравню МТС, SMMESE и ещё один сервис на одинаковом количестве звёзд, чтобы определить самый дешёвый вариант среди них. Затем покажу механику покупки через Fragment и разберу код. Если захочется пойти дальше покупки для себя - этот механизм можно взять за основу собственного сайта по продаже звёзд Telegram.

Читать далее

Локальный семантический поиск по заметкам как MCP-сервер: нарезка под лимит модели и кэш

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели4.8K

Задача была такая: есть папка с конспектами созвонов и расшифровками встреч, и искать в ней по слову неудобно: я помню, что обсуждали найм, а в файле написано «собеседование» и «кандидат». Обычный поиск по тексту такой файл не найдёт. Отправлять заметки во внешний сервис ради эмбеддингов мне не хотелось, поэтому я собрал маленький MCP-сервер, который ищет по смыслу прямо на моей машине, и подключил его к Claude Code. Всё работает без платных API, а заметки не покидают компьютер.

В статье разберу, как устроен движок и сервер, и три места, на которых легко споткнуться: молчаливое обрезание текста моделью, лишний вывод в стандартный поток, из-за которого ломается протокол, и проверка пути в инструменте чтения. Отдельно покажу кэш, который сам понимает, что устарел. Код ниже взят из рабочих файлов, лишнее я убрал.

Читать далее

Разработка цифрового радиолюбительского протокола на базе OFDM. MAC и LLC уровни

Уровень сложностиСредний
Время чтения66 мин
Охват и читатели9.1K

В предыдущей части статьи были рассмотрены принципы и механизмы работы PHY-уровня радиолюбительского OFDM-протокола, а также алгоритмы кодирования и декодирования данных. В этой статье рассматриваются принципы построения уровней управления доступом к среде (MAC) и управления логическим каналом (LLC), реализующих полудуплексное сетевое соединение между двумя трансиверами, а также анализируются возникшие при реализации и методы их решения.

Читать далее

Silero TTS v5 теперь умеет и в эмфазы, и в вопросы и восклицания

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели91K

Не так давно мы писали обнову нашего публичного синтеза, silero-tts. В прошлый раз мы завезли постановку вопросов.

В этот раз доехало аж несколько новых фич:

Каких?

Как обучить модель для upscale на ноутбуке с 4 ГБ и не умереть

Уровень сложностиСложный
Время чтения18 мин
Охват и читатели9.1K

Зачем нам свой улучшатор?

Мы живем в эпоху доступности генеративных нейросетей, однако большинство качественных инструментов улучшения качества фото и видео остаются либо платными SaaS-сервисами, либо сложными академическими проектами. Когда речь заходит об обработке больших объемов личных данных - будь то оцифровка семейных видеокассет или архива институтских пленок - возникает закономерный вопрос доверия и стоимости.

Мы поставили перед собой цель: автоматизировать процесс реставрации старых материалов, сохранив их аутентичность. Готовые решения зачастую применяют избыточную резкость или некорректно обрабатывают специфические дефекты пленки (например, царапины или цветовой сдвиг). Кроме того, изучение механики обучения и инференса подобных моделей требует полного доступа к весам и архитектуре, чего закрытые API предоставить не могут.

Формальная постановка задачи

В рамках данной статьи поставим задачу supervised image-to-image translation (обучение с учителем для преобразования изображения в изображение) для восстановления ретрофотографий и изображений очень низкого качества.

Формально задача выглядит так:

Вход: изображение низкого разрешения XLR ∈RH×W×3 с наложенным синтетическим шумом (гауссов шум, «соль и перец», квантование цвета и др.), имитирующим дефекты старой плёнки или цифрового сенсора.

Выход: изображение высокого разрешения YHR ∈R2H×2W×3, максимально близкое к эталону.

Функция потерь: комбинированная - L1 (MAE) для попиксельной точности + perceptual loss (на признаках предобученной VGG) для сохранения визуального качества.

Читать далее

Ближайшие события

«Труба из Прошлого»: Векторный контроль габарита поезда метро по данным 3D-лидара

Время чтения10 мин
Охват и читатели7.6K

Привет, Хабр! Разработка систем содействия водителю (ADAS) и автопилотов для автомобильного транспорта сейчас у всех на слуху. Но в сфере рельсового транспорта — и особенно в метрополитене — стоят свои, гораздо более специфические задачи.

Недавно я участвовал в хакатоне «Лидеры Цифровой Трансформации», где перед командами стояла безумно интересная Mission-Critical задача от Дептранса Москвы: Разработка алгоритма контроля пространства по ходу движения беспилотного поезда метро. Суть в том, чтобы по данным 3D-лидара Hesai 128 надежно обнаруживать препятствия в створе путей на максимальной дальности (до 150+ метров) в полной темноте тоннеля, сохраняя нулевой или минимальный уровень ложно-положительных срабатываний.

Моё решение не вошло в топ-10 победителей. Подвела классическая ловушка хакатонов — автоматический судейский скрипт проверяющей платформы капризен к структуре выходных данных, и потеря всего 5–6 кадров на ROS-шине из-за блокирующих логов и принтов в stdout, а также мелкая рассинхронизация знаков в экстраполяции, привели к жесткому срезанию баллов.

Однако архитектурный каркас нашего пайплайна (одометрия, концепция «Трубы из Прошлого» и интерактивный 3D-кокпит на Three.js для машиниста) получился монументальным. Мы сознательно отказались от «школьного» покадрового вычисления полиномов путей (polyfit). Вместо этого мы построили Цифровой Двойник (Digital Twin) инфраструктуры на базе пространственной памяти.

Цель этой статьи — не просто провести работу над ошибками, а найти единомышленников. Я выложил ядро проекта в Open Source под лицензией MIT. И если вы тоже участвовали в этом треке, ковыряли этот сложнейший датасет, не прошли, но чувствуете спортивный азарт — давайте объединимся, переложим критические узлы на C++ и добурим это решение до идеального промышленного робототехнического продукта.

Читать далее

Запись пред-ивента «Почему агенты не работают — и с чего начать» — уже на видео: 🔗 https://youtu.be/yYYH0P4gmXc Час...

Охват и читатели6.1K

Запись пред-ивента «Почему агенты не работают — и с чего начать» — уже на видео:

🔗 https://youtu.be/yYYH0P4gmXc

Час живого разбора: где агенты ломаются на практике — уверенно выдумывают, теряют контекст на длинной задаче, делают не то, о чём просили.

А где ломается у вас? Напишите в комментариях.

Эти места разбираем и лечим на курсе «AI-агенты, которые работают»: старт 21.10, занятие 1 из 7, среды 19:00–21:00 МСК.

Доступ — по подписке «Мастер»: https://boosty.to/polnyistek/purchase/3939761

Читать дальше →

Все 179 ответов были SURE. Четыре из них не прошли тесты

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели5.3K

Идея была простая, почти наивная: если попросить модель в конце ответа честно написать, уверена она в своём коде или нет, можно ли по этой метке заранее отлавливать плохие решения? Не гонять тесты, не читать код глазами, а просто смотреть на последнюю строку.

Я прогнал 20 небольших задач на Python через три модели, по три повтора на задачу, и собрал 179 ответов. Все 179 закончились строкой CONFIDENCE: SURE. Вариант UNSURE в промпте был, им не воспользовался никто. При этом четыре решения завалили скрытые тесты. Одно превращало 1024 байта в 1.0 MiB, другое падало на разнице между двумя самыми обычными датами. Под обоими стояло SURE.

Дальше расскажу, как это было устроено, покажу все четыре ошибки и честно перечислю, чего из этого эксперимента вытащить нельзя (а нельзя многое).

Читать далее

Последний пинг: tower defense про защиту дата-центров Сделал браузерную игру, в которой нужно защищать дата-центры от...

Охват и читатели8.5K

Последний пинг: tower defense про защиту дата-центров

Сделал браузерную игру, в которой нужно защищать дата-центры от дронов, ракет и тяжёлых машин. В обороне участвуют роверы и условные зенитные установки. Всё аркадное: никаких реальных характеристик вооружения.

Главный ресурс — энергия. Нужно балансировать между обороной, ремонтом и развитием. Серии перехватов заряжают способности, после волн можно выбирать улучшения, а следующую волну — вызвать досрочно ради бонуса. Если уверен в своей расстановке.

Сейчас доступны четыре карты. На Севере приходится распределять обогрев, в Порту — перевозить батареи между секторами, на Крышах — защищать сразу три дата-центра. Есть три сложности и боссы с несколькими фазами.

Разработку вёл с AI-агентами: отдельно реализация, отдельно ревью и проверки. Игровая логика покрыта 79 тестами, включая прохождение всех сочетаний карты и сложности. Проверки в браузере дополняют тесты, но не заменяют живых игроков: интересный баланс одними зелёными галочками не доказать.

Поиграть без установки и регистрации: td.kosarevsky.dev

Интересно, какую тактику вы найдёте и на какой волне игра впервые заставит её пересмотреть.

tg

Читать дальше →

Deadtrace: отправляем Vulture на пенсию

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели10K

Новая реализация уже работает, а старая всё ещё лежит где-то в репозитории. Её провайдер зарегистрирован в контейнере, тесты продолжают вызывать старый сервис, поиск находит ссылки на класс. Всё выглядит так, будто код нужен. Только само приложение им больше не пользуется.

Чтобы это выяснить, приходится пройти от точки запуска до обработчика, от обработчика — до зависимости, от зависимости — до провайдера. Заодно проверить, кто вызывает общие функции и что останется после удаления старой ветки. Именно на восстановление этих связей я хочу тратить меньше времени.

Я делаю Deadtrace — статический анализатор, который моделирует такие связи и собирает кандидатов на проверку. В этой статье расскажу, почему для этой задачи мне стало недостаточно подхода Vulture, как устроен Deadtrace и где заканчивается уверенность анализатора.

Читать далее

Как писать текст для нейросети, чтобы она сослалась на сайт: в 60 ответах она чаще брала абзацы от 30 слов

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели9.8K

Допустим, вы ведёте документацию или блог и хотите, чтобы куски текста попадали в ответы ChatGPT, Perplexity или Алисы AI. Я проверил на ответах Perplexity простой совет — не начинать абзац с «это», «он» или «поэтому». Такие начала одинаково редки у абзацев, которые нейросеть взяла, и у тех, что пропустила.

Заметно отличается другое: взятые абзацы длиннее. Совет появился потому, что нейросеть с поиском берёт со страницы не всю статью, а один-два абзаца, и они должны быть понятны без соседей. Но если чистить только «это», можно потратить вечер на правку и не изменить ничего.

Читать далее

Почему HTTP‑вызов не укладывается в таймаут: очереди, ретраи и asyncio

Уровень сложностиСредний
Время чтения25 мин
Охват и читатели9.8K

Добавили в HTTP-клиент таймаут, повторы и ограничение одновременных запросов. Кажется, всё предусмотрели, но вызывающий код почему-то ждёт дольше, чем рассчитывали. Я собрал стенд на aiohttp, чтобы разобраться, как так получается и где нужно поставить deadline, чтобы в общий бюджет попало и ожидание в очереди, и все повторные попытки.

Читать далее