Обновить
256K+

Python *

Высокоуровневый язык программирования

374,94
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Поиск узких мест в Oracle с помощью ASH/AWR и LLM

Уровень сложностиСложный
Время чтения16 мин
Охват и читатели5.5K

Добрый день, всем любителям Oracle и пирогов из картофельных очистков!

Одна из самых часто встречающихся проблем при использовании баз данных - это поиск узких мест: нахождение долго выполняющихся запросов и их исправление.

Как часто вы сталкивались с ситуацией, когда запрос мгновенно отрабатывает в тестовом окружении, но начинает «тормозить» на боевом сервере? Или замедление запросов проявляется не сразу, а по мере роста данных?

Я написал open-source утилиту Optimus Oracle. Она получает тяжёлые SQL-запросы из ASH/AWR, собирает планы и через LLM (локальные или облачные) предлагает оптимизацию: создание индексов или изменение запроса. Дальше - реальные примеры «до/после», цифры, грабли и честный разговор о приватности.

Читать далее

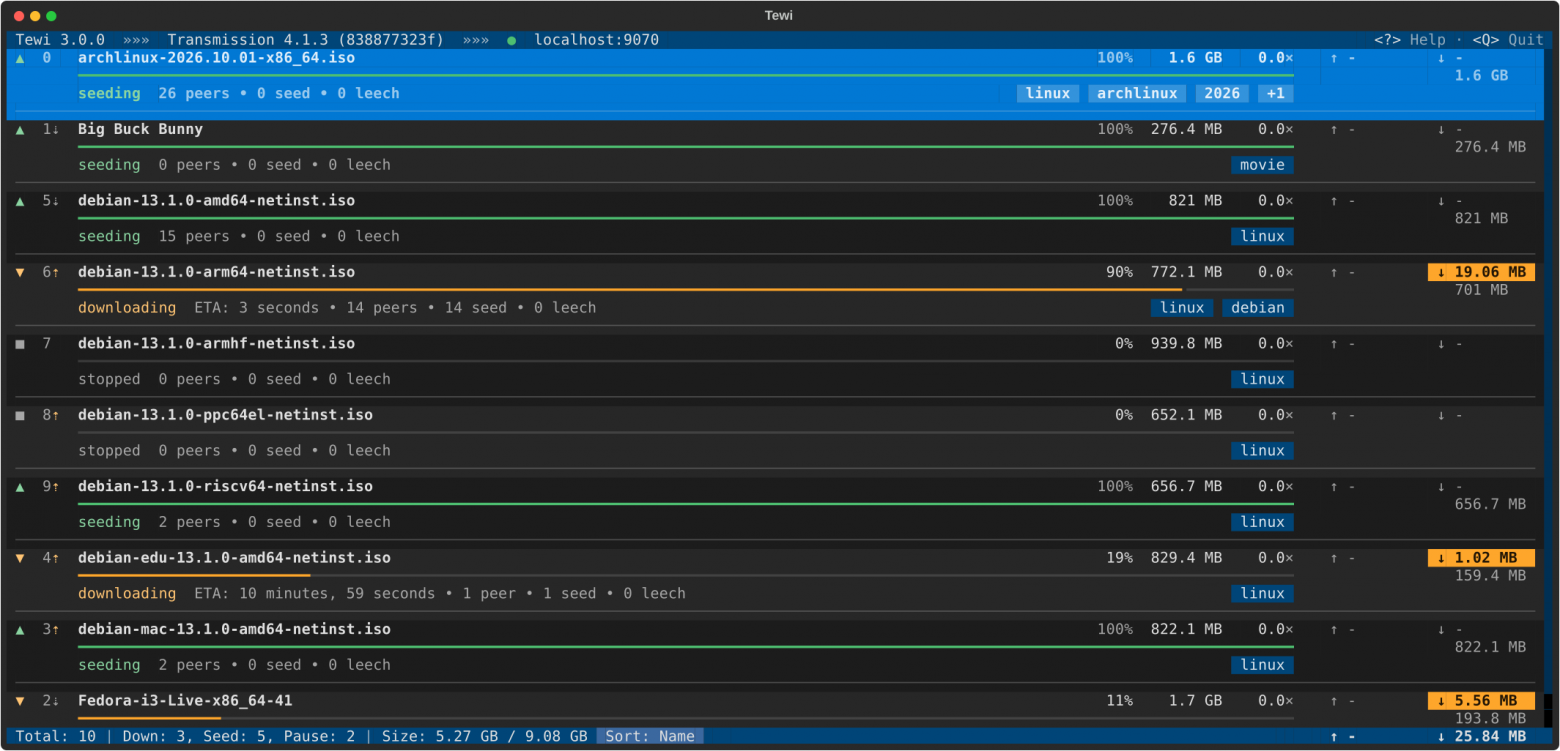
Релиз Tewi 3.0.0 — открытого консольного клиента для Transmission и qBittorrent

Время чтения3 мин
Охват и читатели7K

18 октября 2026 года состоялся третий мажорный выпуск открытого текстового клиента (TUI — text user interface) Tewi для управления демонами BitTorrent‑клиентов. Исходный код проекта написан на Python и опубликован на GitHub под лицензией GNU General Public License v3.0.

Читать далее

RAGу для программиста

Уровень сложностиСредний
Время чтения16 мин
Охват и читатели7.7K

Внедрение AI в программные продукты часто сопровождается необходимостью обогатить контекст LLM специфичными для ваших задач данными. Для обогащения знаний используемой вами модели применяется два подхода:

- fine-tuning — дообучение модели на ваших данных. Тут финансовые затраты идут на обучение модели:

-- ресурсы на fine-tuning в случае on-prem решения,

-- дополнительные средства за дообучение модели по подписке.

- RAG — внешний источник данных, данные из которого передаются в качестве контекста к промпту в LLM. Затраты тут переносятся на размер запроса за счёт увеличения входящего контекста.

Так как я программист, а не Data Scientist, то предпочитаю понятные, переносимые вне зависимости от способа размещения модели, подходы, поэтому мой выбор — RAG. 

Читать далее

Представлен ИИ-скилл leanrea размером 8 КБ, который помогает Codex, Claude Code, Cursor, Gemini CLI и OpenCode...

Охват и читатели4.9K

Представлен ИИ-скилл leanrea размером 8 КБ, который помогает Codex, Claude Code, Cursor, Gemini CLI и OpenCode достаточно быстро клонировать сайты и приложения.

Скилл leanrea подсказывает нейросетям, как нужно анализировать сайты, приложения Electron, бинарные файлы, Android APK и прошивки. Для веб-приложений инструмент отдельно учитывает минифицированные сборки и карты исходников.

Читать дальше →

Одна франшиза — три адреса и два написания: дедупликация каталога франшиз по открытым данным

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели5.9K

Человек, который вводит в поиск запрос вроде «франшиза каталог для малого», получает несколько каталогов, и в каждом тысячи карточек. Кажется, что из них легко собрать одну таблицу рынка: обойти, склеить, посчитать. Я так и думал, пока не попробовал склеить два каталога и один каталог сам с собой.

Ниже - что я взял за ключ записи, сколько раз каждый ключ подвёл и что в итоге работает. Код на Python, данные сняты 6 и 16 октября 2026 года.

Читать далее

Читаем DataMatrix с конвейера: открытое сравнение четырёх библиотек на 1368 синтетических кадрах

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели7.3K

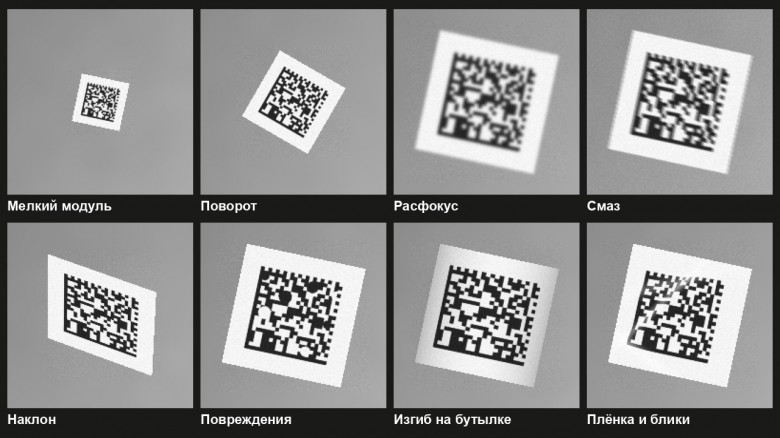
На производстве код «Честного знака» читает камера над лентой, и символ на кадре мелкий — 2–3 пикселя на модуль, повёрнутый, смазанный, на изогнутом боку бутылки. Мы сравнили, как с такими кадрами справляются ZXing, zxing-cpp, libdmtx и наша библиотека dmr. Кадры, ожидаемые строки и скрипты замера выложены — любую цифру можно проверить.

Коротко: — на 1368 синтетических кадрах dmr прочитал 82 %, zxing-cpp — 70 %, libdmtx — 65 %, ZXing (Java) — 3 %; — ложных чтений — ноль у всех четырёх библиотек; — dmr надёжно читает от 1,4 пикселя на модуль и при любом угле поворота; — zxing-cpp примерно в 2,5 раза быстрее; — есть условия, где соперники читают больше dmr, — разбираем их в статье.

Таблицы, графики и данные

Как Живаго ставит диагноз всей эпохе

Время чтения6 мин
Охват и читатели5.7K

С помощью Python проверяю диагнозы доктора Живаго и пытаюсь понять, был ли Юрий Андреевич просто хороший диагност или он проверял патологию всей эпохи.

Читать далее

«Ты сеньор» и «думай пошагово»: проверил шесть приёмов на 30 задачах по Python

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели5.4K

Под прошлой статьёй предложили не спрашивать модель, уверена ли она, а отдельным запросом просить перепроверить и исправить код. Я проверил одну формулировку такой просьбы и ещё пять приёмов — «ты сеньор», «думай пошагово», «меня уволят», «сначала тесты», «только код» — одинаково: 30 задач по Python, скрытые тесты, три модели, по три прогона. Ни один приём не дал обнаружимой разницы в доле прошедших тестов. Переспрос исправил 3 решения из 5 неверных — мало, чтобы делать выводы. «Сначала тесты» дало в 2,6–4,4 раза больше выходных токенов, «только код» — на 10–46 % меньше. Некоторые ошибки повторялись при разных фразах: Haiku отвергал «1h30m» в пяти вариантах из семи. Внутри таблица, тексты фраз дословно и границы того, что из этого следует.

Читать далее

Радар спроса: ловим «ищу разработчика» в чатах, а ИИ-классификатор держит потолок $30 в месяц

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели4.9K

Я делаю сайты и телеграм-ботов на заказ. Заказчики пишут «ищу, кто сделает лендинг» в профильные чаты и в ленты соцсетей, и кто ответит первым, тот обычно и получает разговор. Читать все чаты глазами я не могу, поэтому собрал робота: он читает чаты и ленты, отсеивает мусор, оценивает каждую находку нейросетью и присылает мне в личку карточку с баллом и черновиком первого ответа. Отвечаю я сам, руками. Робот никому, кроме меня, ничего не отправляет, и это правило закреплено в коде, а не в договорённости с самим собой.

Статья про устройство «трубы», по которой идёт сообщение, про учёт расходов с потолком, про три места, где было больно (зависший event loop, невалидный JSON от модели, пачка находок, которую сервер не успевал принять), и про то, что в итоге получилось по живым цифрам. Код ниже взят из рабочего проекта, лишнее я выкинул, промпты классификатора не привожу: у них своя история, к архитектуре она не относится.

Читать далее

Представлен открытый плагин NPCTalk, который позволяет создавать «живых» (разговаривающих) NPC, реагирующих на игровые...

Охват и читатели4.1K

Представлен открытый плагин NPCTalk, который позволяет создавать «живых» (разговаривающих) NPC, реагирующих на игровые события и фразы в игре при контакте с живым игроком. Например, персонажи могут отвечать грубостью или даже начать драку, если им что-то не понравится. Также к плагину можно подключить всех популярных ИИ-агентов: Claude, Codex, Gemini и Cursor.

Читать дальше →

AG‑UI 1.0: у протокола наконец появилась спецификация. Разбираем, что изменилось, на связке AG2 + CopilotKit

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели5.7K

15 октября Tesla показала летающий Roadster, а мы разберём не менее важное: вышел AG-UI 1.0 - мажорный релиз протокола между агентом и интерфейсом. Что в нём нового и как это выглядит на связке AG2 + CopilotKit

Читать далее

🏦 Портфель альткоины/золото с автоматической балансировкой Идея следующая: когда растет Bitcoin, растут альты. Золото...

Охват и читатели7.8K

🏦 Портфель альткоины/золото с автоматической балансировкой

Читать дальше →

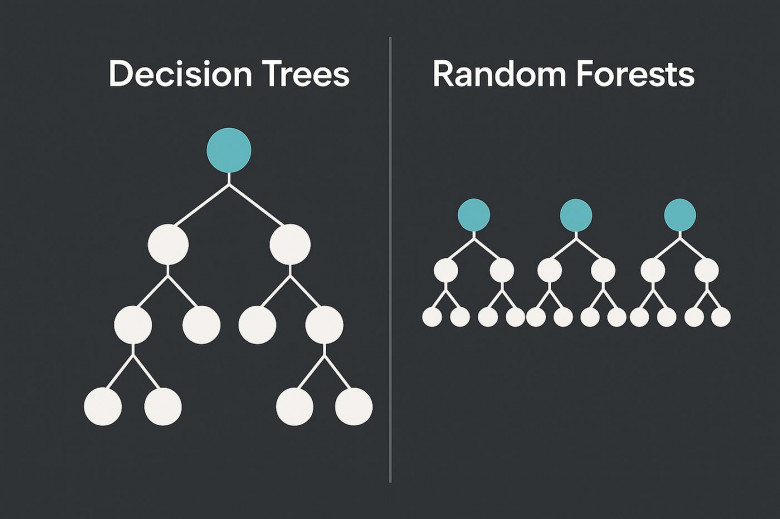
Может ли плохая модель победить хорошую? Как Data Leakage обманывает метрики

Уровень сложностиПростой
Время чтения11 мин
Охват и читатели9K

Представим обычную ситуацию: мы обучили несколько моделей, сравнили их на тестовой выборке и получили довольно странный результат. Простейшее дерево решений показывает Accuracy почти 97%, а Random Forest из 300 деревьев — всего 91,5%.

Читать далее

Ближайшие события

Как ускорить ручное тестирование интеграций с RabbitMQ с помощью библиотеки pika

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели6.7K

Чаще всего для ручного тестирования интеграций с RabbitMQ используют UI-клиент. Но не всегда это удобно и позволяет тестировать быстро, особенно когда очередей к функционалу привязано несколько и в каждой нужно отдельно просматривать данные об отправленных сообщениях.

В этой статье я покажу как с помощью python-скрипта можно получать все нужные сообщения из одного/нескольких exchange в отдельную тестовую очередь и просматривать данные из нее в удобном формате в консоли IDE.

Читать далее

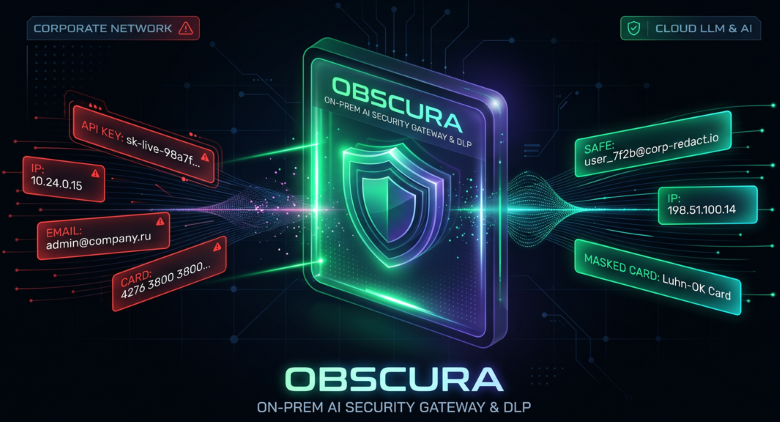
Ваши секреты не должны уходить в облако: знакомьтесь, Obscura

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели8.7K

Летом я писал, что будет, если сливать рабочие данные в ChatGPT: логи SOC, конфиги Cisco и FortiGate, внутренние IP, почты сотрудников. Тогда я сделал офлайн-инструмент, который чистит конфиг руками инженера до отправки. Он решает проблему для того, кто помнит им воспользоваться. Но компания не может полагаться на то, что все всегда вспомнят.

Поэтому я сделал следующий шаг: шлюз, который стоит между человеком и нейросетью, проверяет каждый запрос и решает, что с ним делать. Называется Obscura. Он работает on-prem, данные остаются внутри сети.

Как устроен шлюз под капотом

Русскоязычный каталог из 2118 проектов по декомпиляции игр: от Ocarina of Time до Xbox 360 На GitHub появился...

Охват и читатели4.1K

Русскоязычный каталог из 2118 проектов по декомпиляции игр: от Ocarina of Time до Xbox 360

Читать дальше →

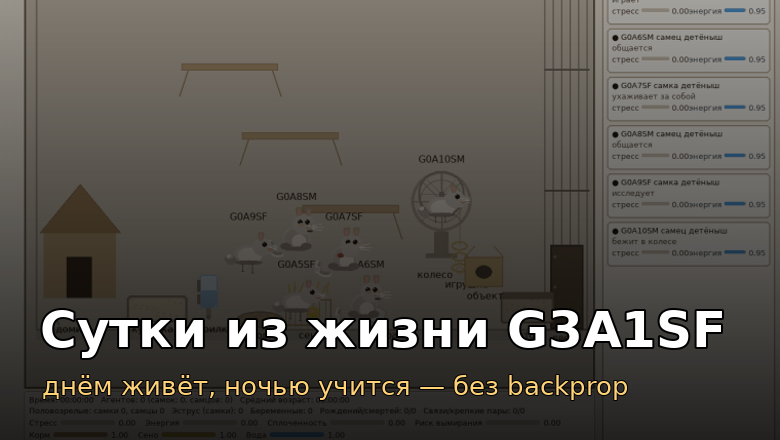
Сутки из жизни G3A1SF: как я учу агента без backprop — днём он живёт, ночью учится

Время чтения12 мин
Охват и читатели6.8K

Что происходит с агентом, который не решает одну задачу, а живёт — долго, в мире, который всё время меняется? Я собрал NOWA-Cognitive, когнитивную архитектуру без backprop, без глобальной функции потерь и без языковой модели в контуре решений: днём агент записывает опыт быстро и «начерно», а долговременную память переписывает ночью, во сне. Рассказываю, как это устроено, на примере одних суток одной шиншиллы из колонии — G3A1SF.

Читать далее

Вайбкодите? Бог вам судья, конечно. Но если переживаете за разжижение серого вещества в черепной коробке, вот отличный...

Охват и читатели5.2K

Вайбкодите? Бог вам судья, конечно. Но если переживаете за разжижение серого вещества в черепной коробке, вот отличный инструмент, чтобы повысить, и укрепить свои компетенции.

Один из самых популярных репозиториев на GitHub, в котором собраны хорошо написанные пошаговые инструкции, как самому собрать браузер, базу данных, нейросеть и другие популярные технологии.

Лучший способ понять, как всё устроено.

💾 Ссылка: https://github.com/Bednyakov/build-your-own-x

Читать дальше →

Полный гайд по локальному запуску DeepSeek на русском: от домашнего ПК до сервера с 8 GPU В открытом доступе...

Охват и читатели5K

Полный гайд по локальному запуску DeepSeek на русском: от домашнего ПК до сервера с 8 GPU

В открытом доступе руководство из 18 частей о том, как запустить DeepSeek V4, R1 и дистилляты у себя, без облака и интернета. Бесплатно, приватно и офлайн.

Внутри весь путь: выбор модели и расчёт железа, установка и настройка Ollama, llama.cpp, LM Studio, Open WebUI, vLLM и SGLang, работа через API и Python, подключение к IDE. Дальше промптинг, ускорение, RAG, агенты и fine-tuning, а в конце топ-30 приёмов, разбор ошибок, FAQ и готовые конфиги.

Для домашнего ПК основной вариант это R1-дистилляты от 1.5B до 70B. Запуск одной командой: ollama run deepseek-r1:8b. По таблицам гайда в кванте Q4 модель на 8B занимает 5-6 ГБ памяти, на 14B около 9-10 ГБ, на 32B около 20 ГБ, на 70B около 43 ГБ.

Старшие модели уже про серверное железо. DeepSeek-V4-Flash на 284B параметров, из них 13B активных, с контекстом 1M требует около 103 ГБ в 3-битном кванте. DeepSeek-V4-Pro на 1.6T параметров с 49B активными нужны 800 ГБ и больше, то есть сервер с 8 GPU.

Несколько практичных советов из гайда. Для русского языка брать модели от 14B, на меньших дистиллятах качество заметно проседает. Квант Q4_K_M считается стандартным выбором, а большая модель в низком кванте обычно лучше маленькой в высоком. Температура около 0.6 для R1 и 1.0 для V4. Проверять через ollama ps, что модель целиком на GPU. И не открывать порт Ollama 11434 в интернет: у API нет пароля.

Репозиторий: https://github.com/justxor/deepseek-local-guide-ru

Читать дальше →

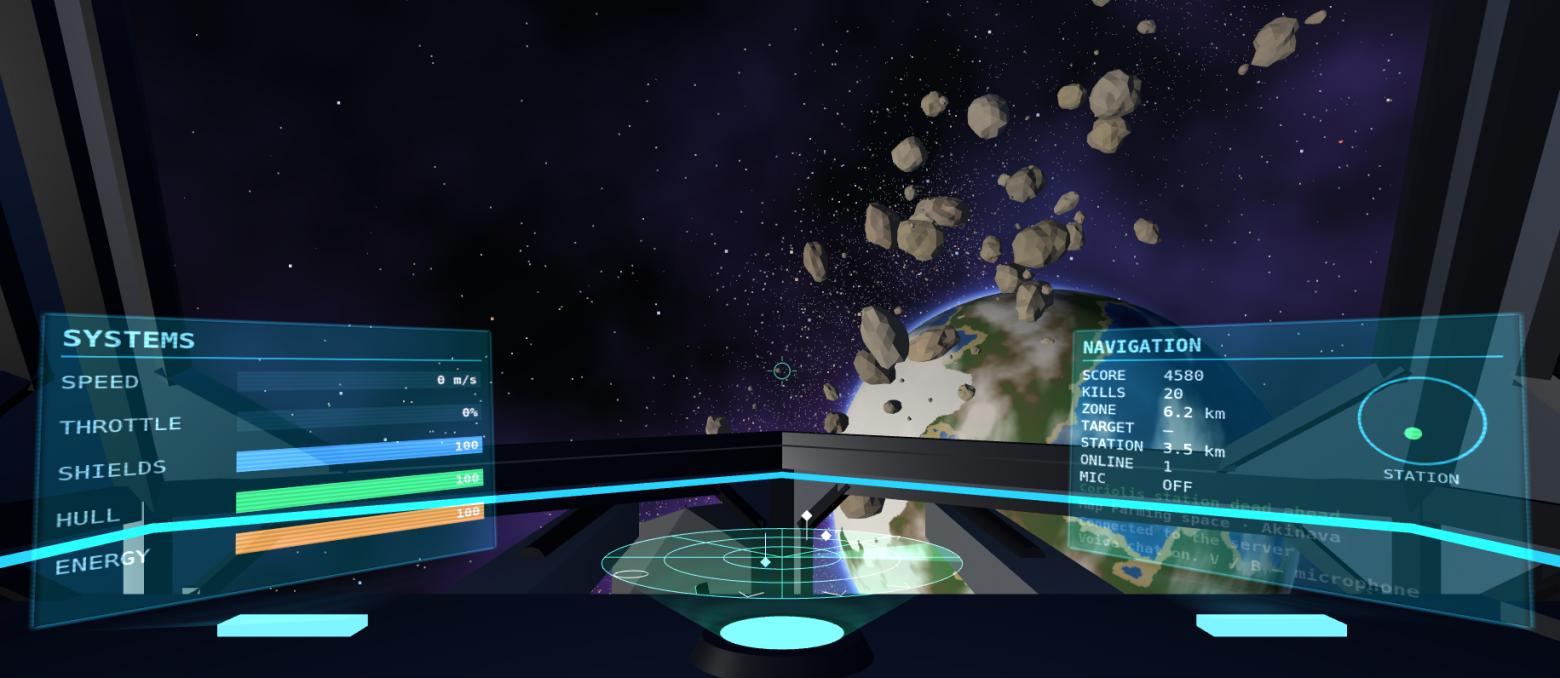
Инди космос за 6 лет. От лобби в VR до мультиплеерной игры

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели7.6K

Я помню свои первые впечатления от лобби когда я впервые включил Oculus Quest. Космическая станция на орбите. За окном — вселенная. Солнечный свет отражается от стен каюты. За пределами атмосферы солнце кажется необычайно ярким. Вентиляция тихо гудит. Хотелось запрыгнуть в челнок и помчаться по просторам космоса. Но тогда я не знал о существовании подходящей игры. А может, её просто не было. Безумно хотелось летать.

Шесть лет назад появилась идея игры, которая со временем превратилась в Орбиту.

Полетели?