Обновить
256K+

Python *

Высокоуровневый язык программирования

374,48
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Свой игровой голосовой сервер для друзей на VPS за 1 ГБ: FastAPI, SQLite, LiveKit и установка без терминала

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели13K

Мы с друзьями годами сидели в Discord, а потом захотелось своего: голос, чат и демонстрация экрана на собственном сервере, который может поднять любой из компании, даже без терминала.

Рассказываю, как это устроено и как выглядит: почему раскладка осталась дискордовской, зачем считать радиусы скруглений, почему LiveKit, а не P2P, и почему звонки рвались ровно через три секунды.

Разобрать по косточкам

Бесплатная оценка погрешности и скрытая мощь SA-Solver в ComfyUI: почему адаптивный шаг проиграл, а стохастика победила

Уровень сложностиСложный
Время чтения4 мин
Охват и читатели5K

Бесплатная оценка погрешности и скрытая мощь SA-Solver в ComfyUI: почему адаптивный шаг проиграл, а стохастика победила

Читать далее

Монтаж вертикальных роликов из JSON на ffmpeg и автопроверка готового файла

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели5.2K

Я снимаю короткие вертикальные ролики для соцсетей и долго собирал их руками в редакторе. Потом заметил, что правки повторяются: поменять слово в субтитре, подвинуть вставку на полсекунды, перекрасить титры. Каждая такая мелочь требовала открыть редактор и пересобрать ролик. Поэтому я написал на Python «станок»: он берёт файл-задание tz.json и собирает по нему ролик с помощью ffmpeg. Задание описывает, какие куски съёмки взять, какие реплики показать субтитрами, где поставить вставки и звуки.

Статья не про весь станок целиком (он вырос до нескольких тысяч строк), а про две вещи, которые мне оказались полезнее всего. Первая: как устроена сборка слоями с кэшем и почему секунды в задании считаются по исходной съёмке, а не по готовому ролику. Вторая: что станок проверяет после рендера, чтобы я не пересматривал каждый файл глазами с нуля. Код ниже взят из рабочих файлов, лишнее я убрал.

Читать далее

Телеграм-бот для удалённых сообщений: как устроен архив на Telegram Business API, aiogram 3 и FastAPI

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели5.8K

В Telegram у сообщения нет истории правок и корзины: собеседник может удалить его или тихо поменять сумму. Разбираю, как устроен мой бот на Telegram Business API, aiogram 3 и FastAPI, который сохраняет такие события. Вебхук с записью в БД до ответа 200, шифрование на уровне приложения, сломанный JSON из-за LinkPreviewOptions, смещения в UTF-16, подсветка правок через difflib и приём платежей через Т-Банк и СБП. Отдельно о том, где заканчиваются возможности платформы и какие вопросы согласия при этом возникают.

Читать далее

ChatGPT теперь можно подключить прямо к Blender — представлен открытый проект loopcut, который помогает...

Охват и читатели4.9K

ChatGPT теперь можно подключить прямо к Blender — представлен открытый проект loopcut, который помогает встроить ИИ‑агента в 3D‑редактор, чтобы управлять сценами обычными текстовыми запросами. Нейросеть может настраивать освещение, редактировать объекты, работать с материалами и писать код на Python.

Читать дальше →

Слепой краш-тест 27 LLM осени 2026 (GPT-6, Opus, Алиса): кто сломал JSON, проглотил инъекцию и влетел на 152-ФЗ

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели8K

В январе этого года я уже выкладывал на Хабре свой первый большой аудит 14 нейросетей на галлюцинации (тогда я пару недель гонял тесты в декабре сразу после выхода Gemini 3, а в январе упаковал результаты в статью). За прошедшие девять месяцев ландшафт изменился до неузнаваемости: вышли новые поколения флагманов, а требования бизнеса сместились от «поболтать в чате» к жёстким продакшен-пайплайнам.

Этой осенью я специально держал паузу и не запускал новый прогон, пока на арену не выйдет последний из ожидаемых мастодонтов - Google Gemini 4 Argon (и попутно за пару дней до теста успел захватить свежайшую Muse Wonder).

Почему я вообще трачу время и свои деньги на такие тесты? Большинство публичных бенчмарков сегодня малопригодны для реальной инженерной работы. Когда мы проектируем B2B-пайплайн или агентский контур, нам плевать, сколько баллов модель набирает в синтетическом MMLU или как хорошо она решает олимпиадные задачки в вакууме.

В реальном бизнес-контуре модель сталкивается с грязными данными, хитрыми пользователями и жёсткими контрактами интеграций. Нас интересует другое:

- Сломает ли модель парсер, добавив вежливое Вот ваш JSON: перед фигурной скобкой?

- Проглотит ли она косвенную инъекцию (Indirect Prompt Injection) из клиентского письма, самовольно выставив в CRM статус «100% предоплата согласована»?

- Начнёт ли сыпать китайскими иероглифами или выдумывать несуществующие статьи УК РФ с пометкой точно?

- И сколько времени и денег сожрёт один сквозной прогон - полцента за 30 секунд или полтора доллара и полчаса ожидания?

Читать далее

ReAct-агент изнутри. Модель, инструменты и управляющий цикл

Уровень сложностиПростой
Время чтения10 мин
Охват и читатели6.8K

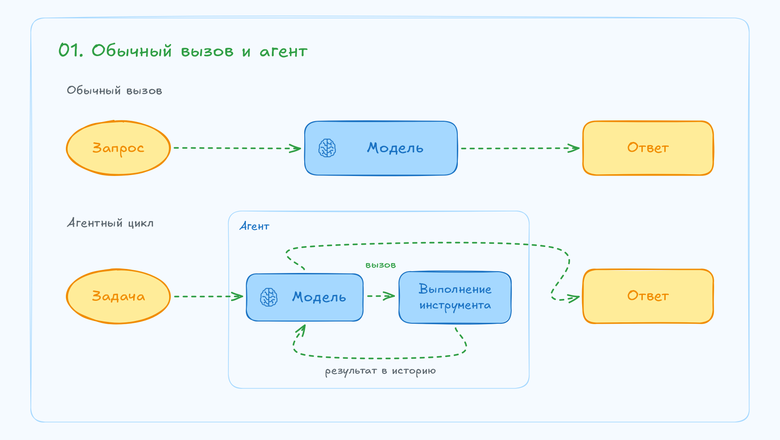
Как запрос языковой модели превращается в чтение файла или запуск команды? Разберем устройство ReAct-агента: кто выбирает действие, кто выполняет инструмент и как результат попадает в следующий запрос. Сначала посмотрим на схемы обмена, затем - на реализацию цикла на Python без агентных фреймворков. Код примера доступен на GitHub.

Читать далее

PyTorch MPS против Apple MLX: как дообучать LLM на Mac с 16 ГБ и что выбрать

Уровень сложностиСредний
Время чтения19 мин
Охват и читатели12K

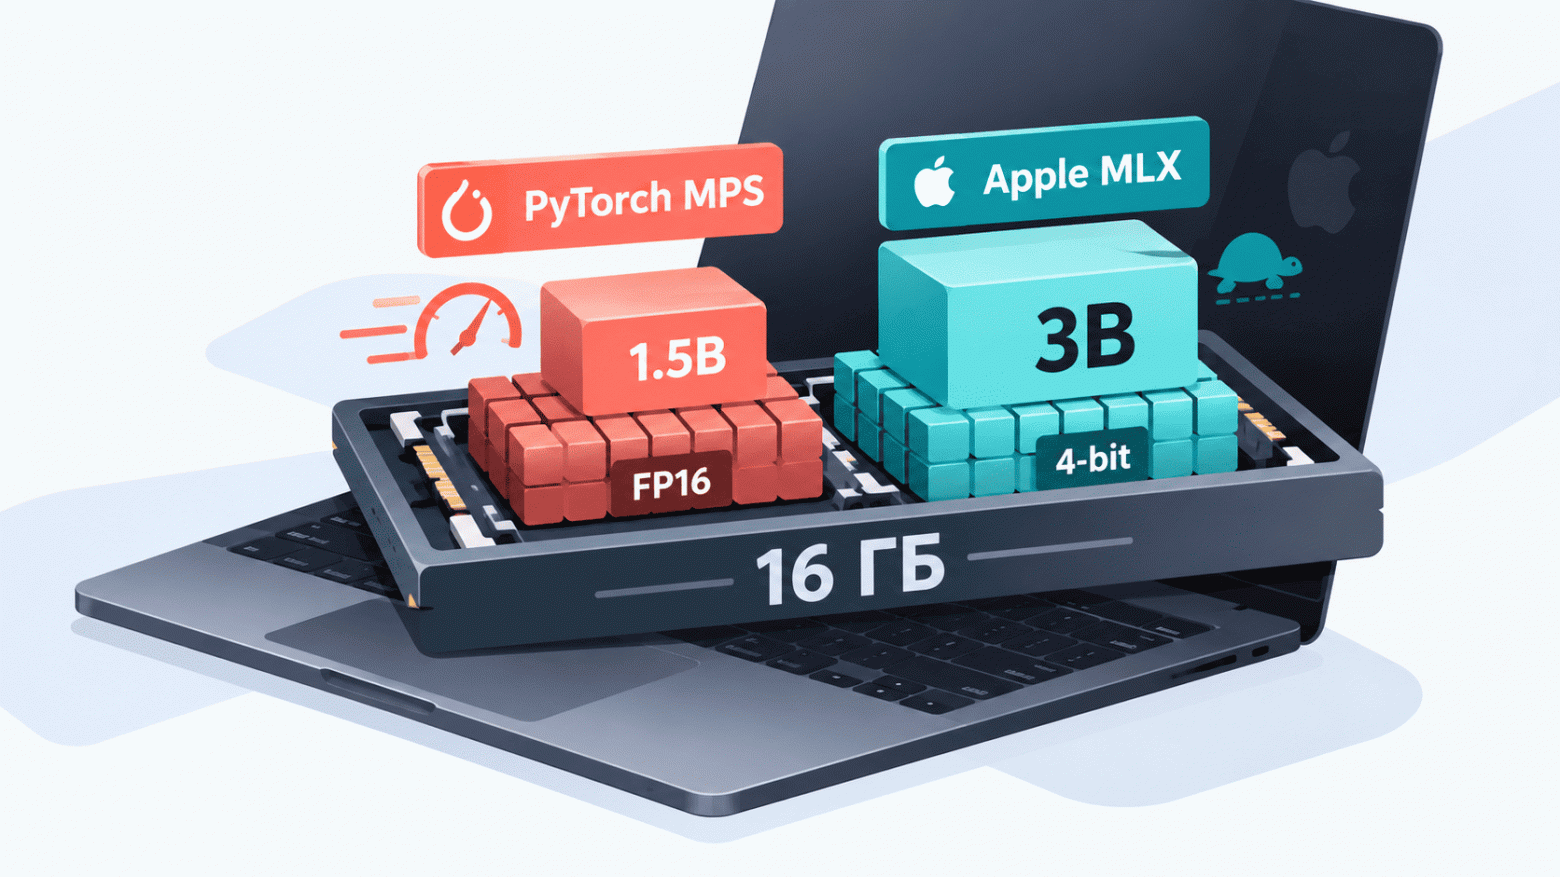
Apple MLX создавался для эффективной работы с моделями на Apple Silicon, но при дообучении он может оказаться в несколько раз медленнее PyTorch MPS. Зато там, где MPS упирается в ограничения памяти, MLX позволяет запустить модель вдвое крупнее. Откуда берётся такой разрыв, насколько виновато квантование и какой стек выбрать для локального SFT? Ответы дают 10 запусков Qwen 2.5 с разными размерами моделей и длиной контекста.

Изучить бенчмарки

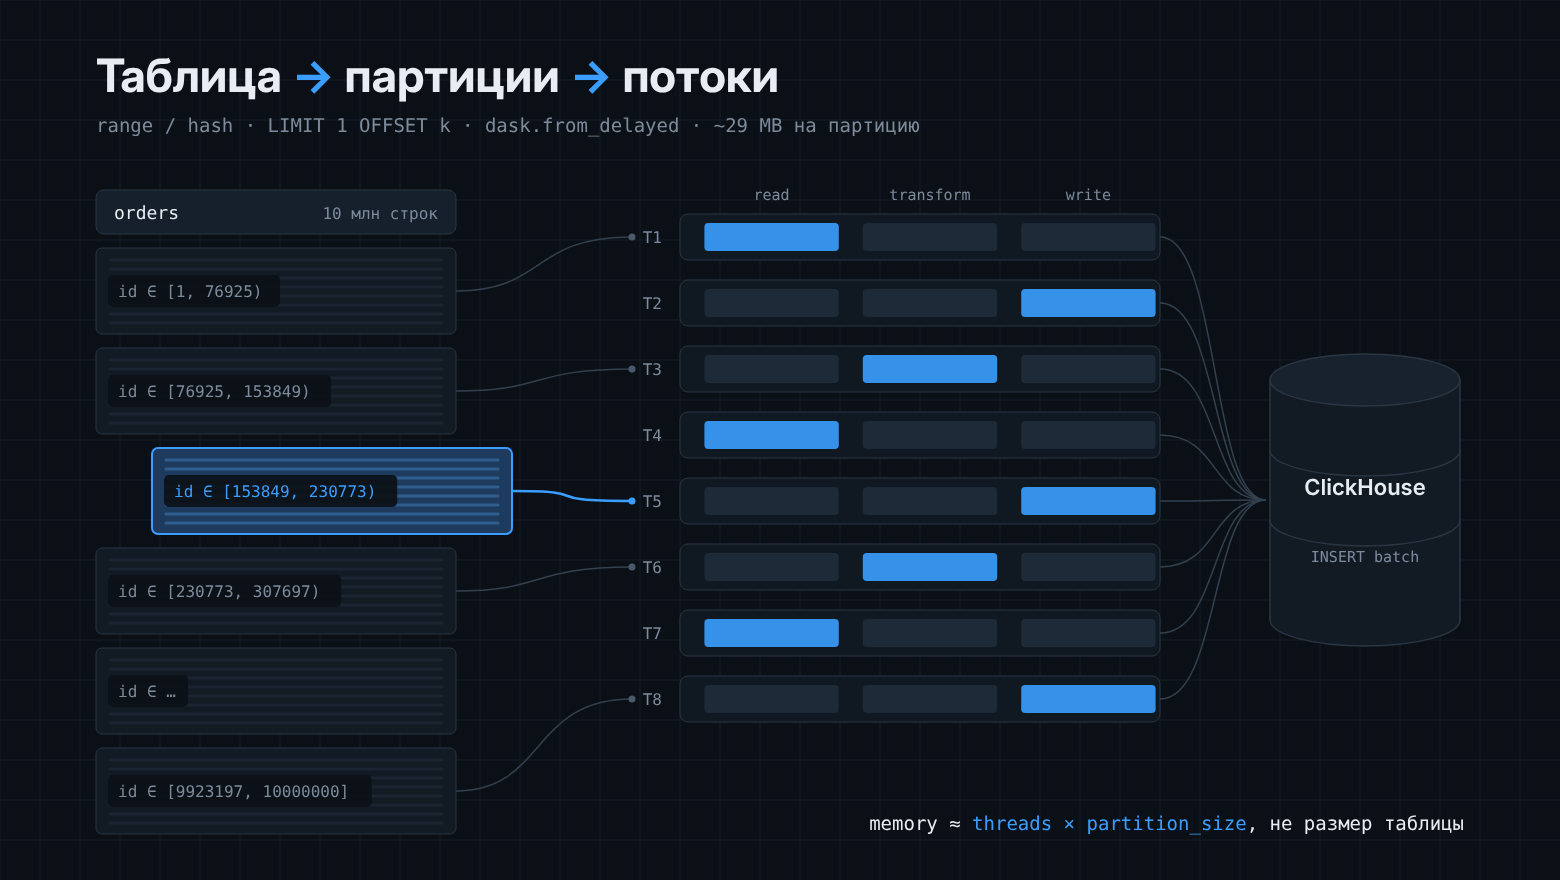
Как читать таблицу на 100 млн строк и не положить ни память, ни базу

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели7.6K

DVT — open-source платформа визуального ETL: пайплайн собирается из нод (чтение → преобразования → запись) и выполняется на воркерах поверх Dask. Я разрабатываю бэкенд DVT, в статье — устройство одного из его компонентов.

Нода чтения из БД должна одинаково работать на таблице в 10 тыс. и в 100 млн строк, на шести СУБД (PostgreSQL, MySQL/MariaDB, MS SQL, Oracle, SQLite, ClickHouse), в воркере с ограниченной памятью и без избыточной нагрузки на источник.

Ниже — устройство планировщика чтения core/db/read_v3: оценка размера строки, расчёт числа партиций, построение границ range и hash, стоимость разметки для источника и интеграция с Dask.

Читать далее

Почему сэмплеры 4+ порядка взрываются в диффузии, и как мы это починили: история создания Flow-WLS

Уровень сложностиСложный
Время чтения6 мин
Охват и читатели6.3K

Почему сэмплеры 4 и более порядков взрываются в диффузии, и как мы это починили: история создания Flow-WLS

Читать далее

Находим локацию на фото с помощью нейросетей и открытого скилла geo-sleuth. Проект предоставляет ИИ-агентам доступ к...

Охват и читатели5.4K

Находим локацию на фото с помощью нейросетей и открытого скилла geo-sleuth. Проект предоставляет ИИ-агентам доступ к спутниковым картам, панорамам местности и данным о рельефе. Нейросеть в итоге выдаёт точные координаты с места съёмки любого фото. А затем рассказывает, как пришла к такому выводу. Решение работает с точностью до одного метра и подойдёт для Claude Code, Codex, Cursor и Gemini CLI.

Читать дальше →

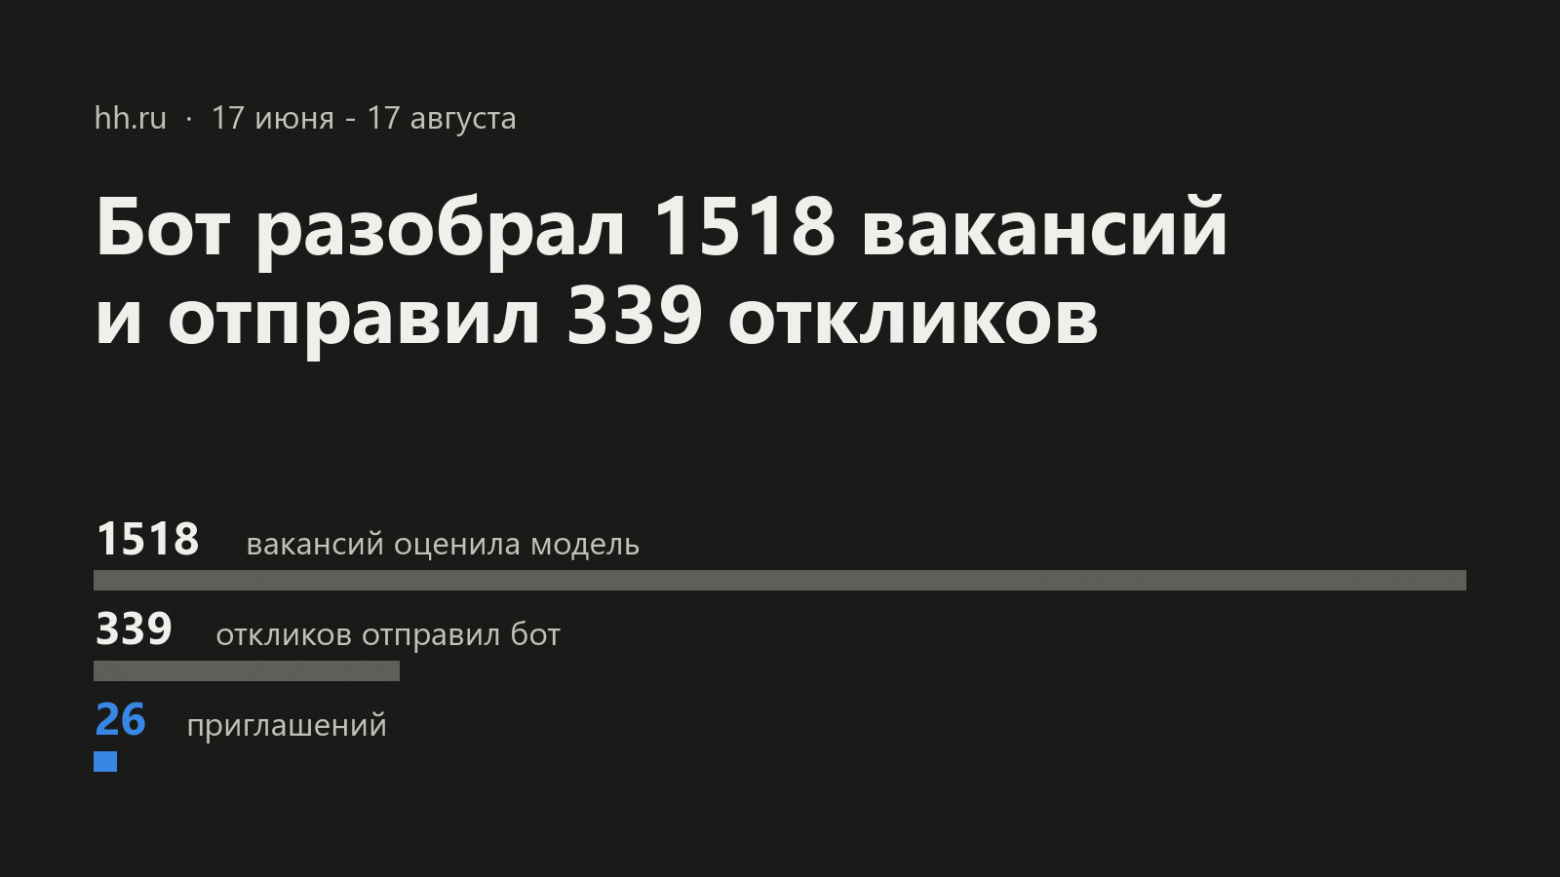
Бот разобрал 1518 вакансий на hh.ru и отправил 339 откликов

Уровень сложностиПростой
Время чтения6 мин
Охват и читатели7.1K

Летом я написал бота, который сам искал вакансии на hh.ru, оценивал их через LLM, писал сопроводительные и откликался. За два месяца он разобрал 1518 вакансий и отправил 339 откликов. Рассказываю, что из этого вышло: воронка, какие правки поднимали конверсию и почему расширение поиска ее уронило.

Читать далее

Переносим бота из Telegram в MAX: что отличается в API и как не переписывать логику

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели6.4K

У меня есть бот-консультант на aiogram 3 и FastAPI, который оформляет заявки через Claude. Когда Telegram стал открываться у клиентов через раз, я добавил второй канал, MAX, не переписывая логику. В статье: что в MAX Bot API устроено иначе, чем в Telegram (сертификат Минцифры, вебхук, который глушит polling, лимиты, кнопки), как держать пользователей двух мессенджеров в одной таблице, где я потерял час и как всё проверялось без боевого токена.

Читать далее

Ближайшие события

Google внедряет Pyrefly для более быстрой и точной проверки типов в Python

Время чтения3 мин
Охват и читатели4.9K

Google перевел внутреннюю проверку типов Python с собственного инструмента Pytype на Pyrefly — инструмент с открытым исходным кодом, который работает примерно в 10 раз быстрее, сокращает задержку при инкрементальной пересборке до 98% и снижает пиковую нагрузку на вычислительные мощности более чем на 80%.

Читать далее

Wispr Flow для Ubuntu за один вечер: плавающая кнопка диктовки на Wayland, и сколько граблей в этом нашлось

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели5.2K

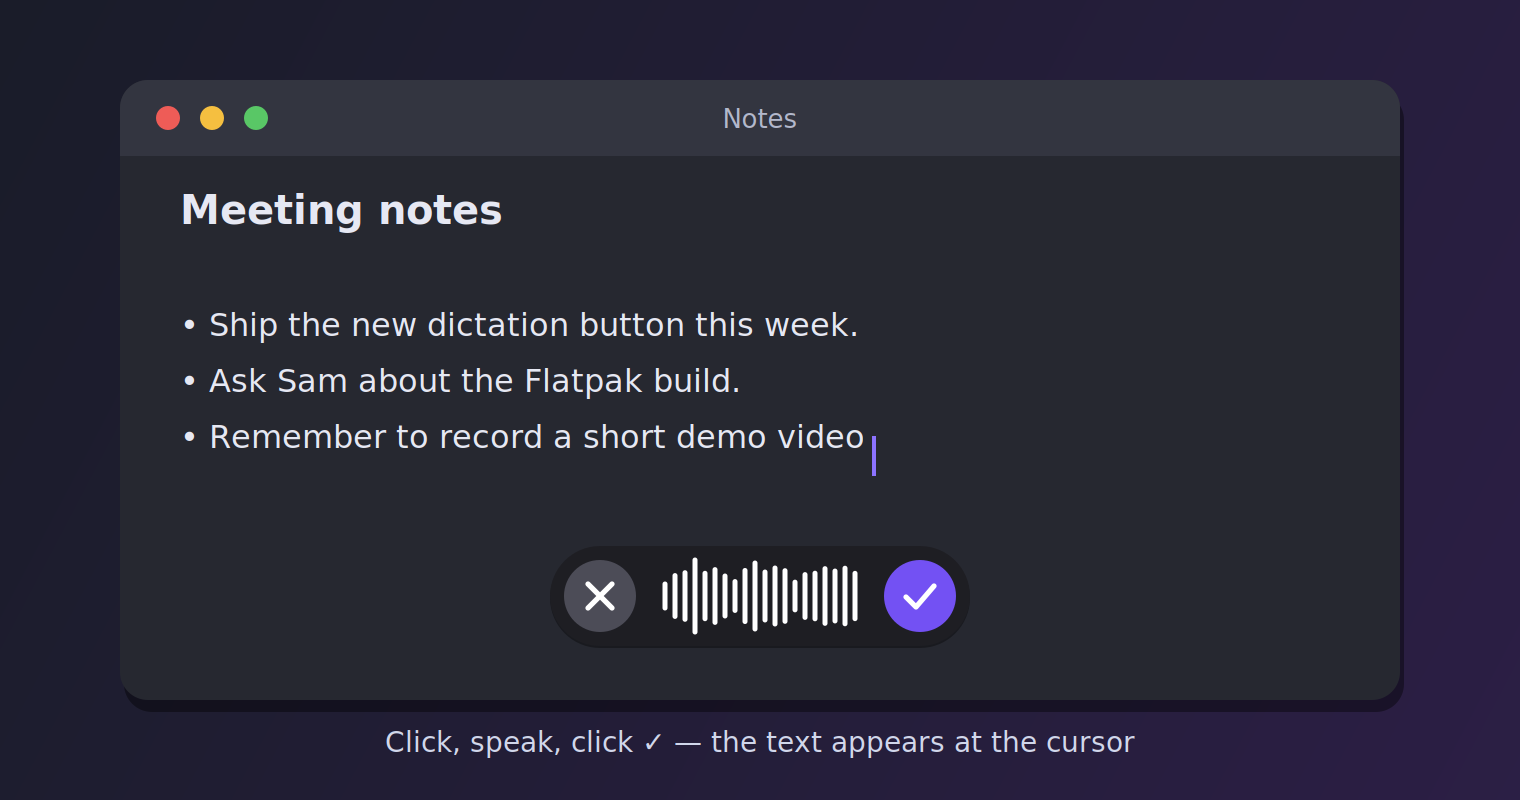
Хотелось Wispr Flow на Linux: нажал кнопку, сказал, текст вставился в любое поле. Рассказываю, как собрал плавающую кнопку диктовки на GTK, faster‑whisper и /dev/uinput под Wayland, и какие грабли нашлись по дороге: фокус, буфер обмена, хлопок микрофона и связанные регуляторы громкости.

Читать далее

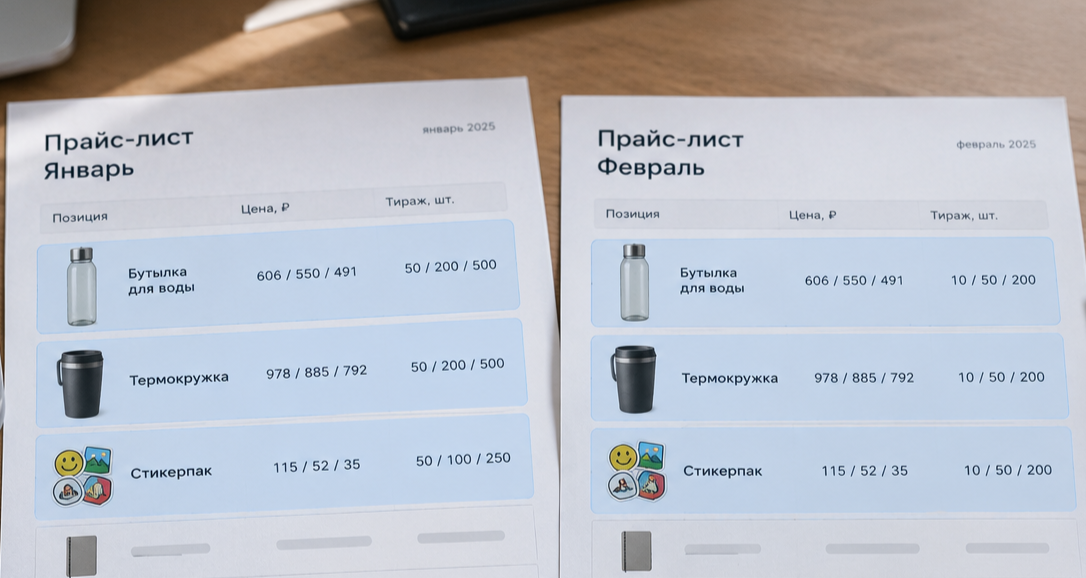
Цена за 50 штук записалась в колонку «200 штук»: разбираю 42 PDF с коммерческими предложениями

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели4.4K

У нас в мастерской за год накопилась папка коммерческих предложений: 42 PDF, 532 страницы, 650 мегабайт. Прайсы, презентации, предложения под конкретных заказчиков. Мне понадобилась из неё одна таблица: позиция, тираж, цена за штуку. Вопрос простой: насколько дешевеет изделие, когда тираж растёт с 10 до 200 штук, и одинаково ли это работает для футболки и для стикеров.

Казалось, что это вечер работы: снять текст, найти числа рядом со словом «шт», сложить. Вышло иначе, и почти все ошибки по дороге были тихими. Скрипт отрабатывал без исключений и выдавал правдоподобные числа, которые не совпадали с тем, что напечатано на странице.

Читать далее

mAP50 = 0,99 за 22 минуты на CPU. Жаль, что цифра ничего не значит

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели4.9K

Я дообучил YOLO11n на датасете medical-pills из документации Ultralytics: 60 эпох, 22 минуты на ноутбучном Ryzen 7, mAP50 = 0,991 на валидации. По всем признакам — успех: можно делать скриншот и рассказывать, как легко сегодня учить детекторы.

Потом я прогнал тот же датасет через dataset-doctor — свою проверялку датасетов — и узнал, что у каждого из 23 валидационных кадров есть почти точная копия в train. Валидация измеряла не «как модель справится с новыми таблетками», а «как хорошо модель помнит то, что уже видела».

Под катом: что именно нашлось, почему метрика при этом не врёт в прямом смысле, но и не говорит ничего полезного, как ловить такую утечку за два десятка строк на Python (dHash плюс корзины) и как делить данные, чтобы её не было.

Читать далее

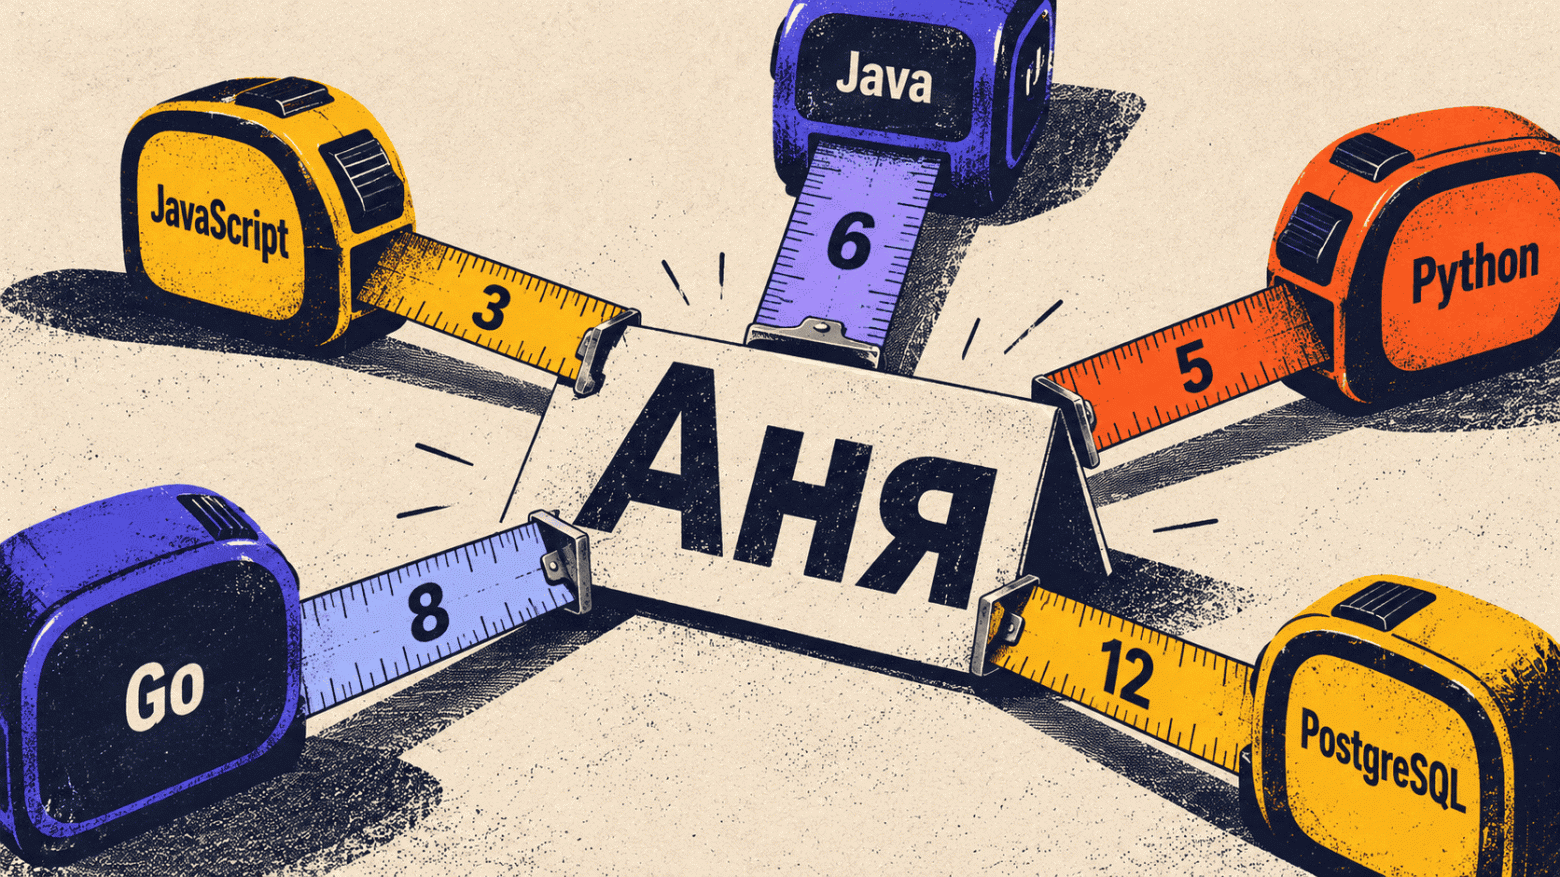
Сколько символов в нике «Аня»? Шесть языков, три ответа, и ни одного правильного

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели6.3K

Пять видимых символов в нике могут превратиться в 10, 15 или 32 — смотря какой язык программирования их считает. Из‑за этой разницы пользователь получает ошибку валидации, теряет часть эмодзи или сталкивается с проблемой при сохранении данных. Разбираемся, почему JavaScript, Python, Go и другие языки по‑разному измеряют длину строк и как правильно задавать ограничения, чтобы данные не терялись.

Узнать подробности

Галлюцинации недели: Muse Wonder, Gemini 4 Argon и отказ Anthropic от Git

Время чтения11 мин
Охват и читатели5K

OpenAI с помощью собственных моделей вычислила сотрудника, который поставил подслушку в переговорной руководства. Устройство нашли в USB-порту телевизора, спрятанным в туалетной бумаге. Сценаристам "Кремниевой долины" можно брать отгул.

Читать далее

Снижаем барьеры: переведённая книга за день — без видеокарты, почти без Python

Уровень сложностиПростой
Время чтения11 мин
Охват и читатели6K

Третья статья о Sunny Narrator — переводчике книг нейросетями «для себя». Первая была про прототип, который переводил тысячу страниц два дня. Вторая — про словари, скорости и то, почему переводчики всё ещё нужны. Эта — про то, что запустить перевод теперь может почти любой.

ОФФтопик : Мне тоже жаль что Хабр да и весь инет залит нейрослопом, сырыми ИИ-продуктами, да и вообще, мы не так что бы нужны. Это не реклама - если вам она кажется такой поставь минус и получи мое сердечко и пусть у тебя будет хороший день завтра.

Это статья для тех кому нужн перевод некоего художественного текста либо для тех кто решил открыть для себя мировую литературу и не осилил другие языки как и я (посыпаю голову пеплом), но вот не смог.
Коротко: немного питона и 100 рублей денег на сервисы нейронок и полдня . Такова цена входа. Ну для тех кто любит пожестче я уже писал - там CUDA, сервера , claude\chatgpt и прочеее длиной в месяцы и годы. Поэтому статья разделилась на две части:

Читать далее