


Три подхода к ускорению обучения XGBoost-моделей
Фреймворк XGBoost (Extreme Gradient Boosting, экстремальный градиентный бустинг) — это эффективная опенсорсная реализация алгоритма градиентного бустинга. Этот фреймворк отличается высокой скоростью работы, а модели, построенные на его основе, обладают хорошей производительностью. Поэтому он пользуется популярностью при решении задач классификации и регрессии с использованием табличных наборов данных. Но процесс обучения XGBoost-моделей может занять много времени.

Сегментация экземпляров с помощью Mask R-CNN

Задача сегментации изображений может решаться в нескольких постановках. Самая распространённая - semantic segmentation с одним классом и фоном, необходимо просто отделить объекты от фона, не различая их между собой. Но часто просто отделения от фона недостаточно, необходимо отделять отдельные образцы друг от друга, например, чтобы оценить размер или расположение каждого отдельного объекта. Как это можно сделать?

Экспорт статей Хабра в html, markdown
До меня было написано 4 статьи по экспорту статей с хабра в FB2 и pdf:
- Экспорт избранного Хабра в FB2
- Экспорт избранного Хабра в FB2 — скоростная PHP-версия
- Экспорт Хабра в FB2
- Экспорт Избранного на Хабре в PDF
Я захотел получить исходники своих статей.

Сказ о том, как мы Python-микросервисы для облака шаблонизировали
Большая боль разработчиков, которые приходят на новый проект — для развертывания сервиса локально нужно пообщаться минимум с десятком людей, не говоря уже про интеграцию с CI/CD-сервером. В один момент мы решили реализовать это удобнее, заодно сократив время онбординга новых сотрудников.
При этом мы хотели получить не только быстрый ввод новых сервисов в эксплуатацию и минимальное время развертывании любого сервиса локально — мы хотели, чтобы все наши сервисы использовали более или менее одинаковые версии библиотек, настройки линтеров и конфигурацию. А поскольку мы финтех, то должен был сохраняться высокий уровень безопасности, а риск человеческих ошибок — снижаться.
Меня зовут Олег Чуркин. Я больше 10 лет занимаюсь разработкой на Python и сейчас руковожу разработкой нового процессинга платежей в QIWI. Расскажу, как мы реализовали boilerplate-шаблон для сервисов — на примере небольшого стартапа внутри нашей большой компании.

Разработчики и колпак
«You Only Live Twice», (1967)
Развитие микроэлектроники, ИТ технологий и широкого спектра программных продуктов открыло новые возможности по контролю всего. Датчики, камеры, цифровые следы… Магнитофон в чемодане уже неактуален.
Разработчики пишут, а компании внедряют различные системы для мониторинга эффективности работы сотрудников. Казалось бы, в зоне опасности банковские операционисты, кассиры, сотрудники колл-центров и т.д, а разработчики на коне.
По факту оказывается, что разработчики могут находиться под куда более жестким контролем.
Как же так???

Как изменилась стандартная библиотека Python за последние годы
Когда выходит очередная версия Python, все внимание достается новым фичам языка: моржовому оператору, слиянию словарей, паттерн-матчингу. Еще много пишут об изменениях в асинхронной работе (модуль asyncio) и типизации (модуль typing) — эти модули на виду и бурно развиваются.
Остальным модулям стандартной библиотеки достается незаслуженно мало внимания. Хочу это исправить и рассказать, что интересного появилось в версиях 3.8–3.10.

Парадоксальный рост популярности Python в научных вычислениях

Чтобы уверенно пересечь незнакомую местность, можно или двигаться быстрее, или подыскивать удобную дорожку. Другими словами, слишком пристальное внимание к скорости как таковой может вас притормозить. То же касается и разработки программного обеспечения.

TileTool — модуль для обучения детей основам разработки игр

TileTool -игра на Python за считанные минуты. Модуль генерации и построения двухмерных игровых миров TileTool, базирующийся на небезызвестном PyGame, экономит кучу времени и помогает детям, изучающим программирование без боли освоить геймдев, а инди разработчикам упростить и ускорить разработку.

Уроки компьютерного зрения на Python + OpenCV с самых азов. Часть 6
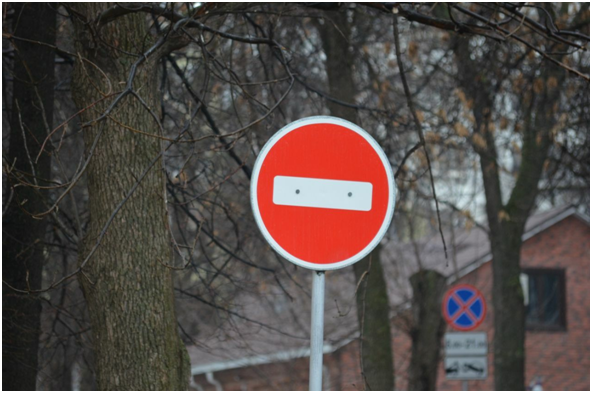
На прошлом уроке мы научились превращать набор особых точек, найденных специальным детектором особых точек, в граф. Там же я объяснил, зачем это вообще надо. Сегодня мы будем изучать такую область науки о компьютерном зрении, как нахождение областей интереса на изображении. Как правило, это вторая часть этапа обработки изображений (см. первый урок). И так, предположим, нам надо найти на изображении дорожный знак. Пусть мы пока ограничимся только поиском знаков «кирпич». Вот наша рабочая картинка:

Генетический алгоритм поиска решения для задачи по выбору планировок этажа многоквартирного дома
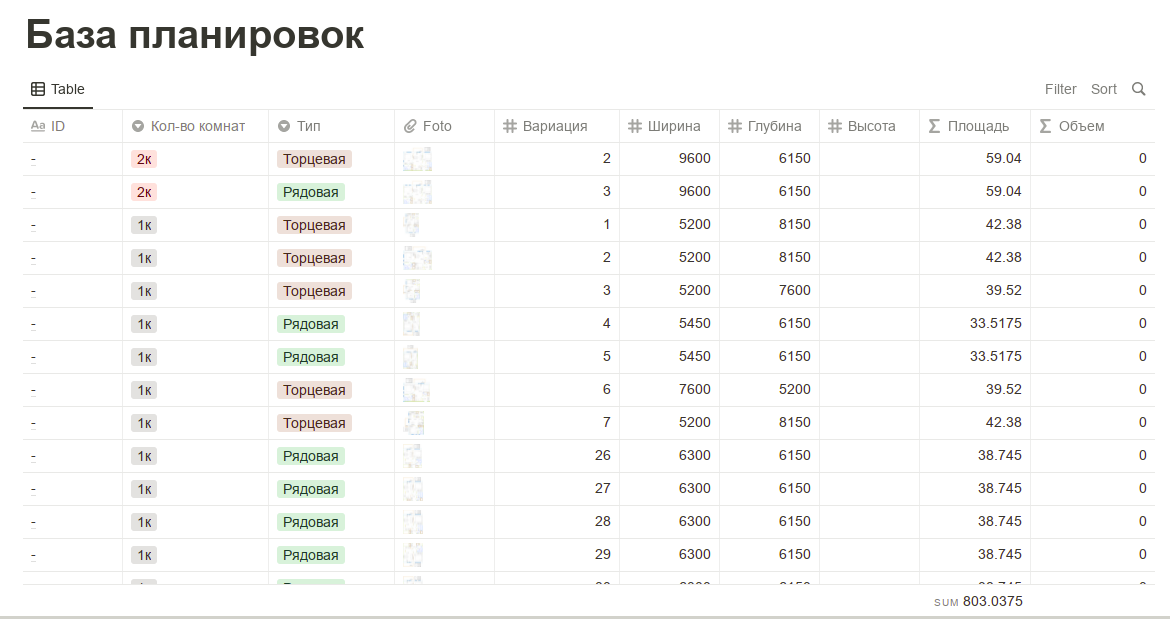
Предложенный алгоритм - это очень ранний прототип рабочей версии. Суть публикации познакомить всех желающих с возможностями генетических алгоритмов в различных сферах бизнеса.

Как я случайно удалил 7 терабайт видео перед запуском в продакшн

К старту курса по автоматизированному тестированию на Python делимся материалом о том, насколько вредным может стать привыкание к библиотекам и насколько полезными — инструменты автоматизированного тестирования. За подробностями приглашаем под кат.
Исчезающие тени логистических облаков
«Умный в гору не пойдёт, умный гору обойдёт». Примерно так рассуждали DS-специалисты при решении задачи, требующей вычисления 10+ млн расстояний между парами точек по их географическим координатам.
Ближайшие события

Основы Интерактивных карт
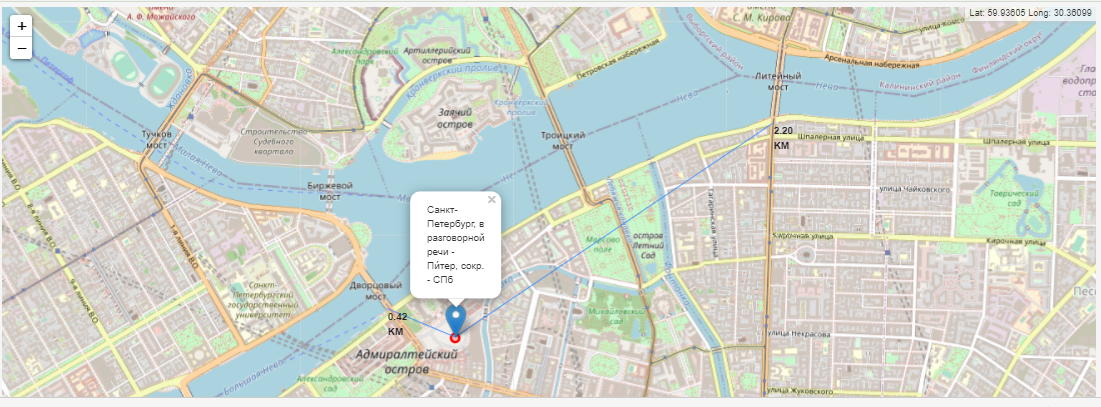
Для визуализации интерактивных карт рассмотрим библиотеку - Folium.
Folium — это мощная библиотека визуализации данных в Python, которая была создана в первую очередь для того, чтобы помочь людям визуализировать гео-пространственные данные.
Folium - это библиотека с открытым исходным кодом, созданная на основе возможностей Datawrangling экосистемы.
С помощью Folium можно создать карту любого местоположения в мире, если вы знаете его значения широты и долготы.
Также можете создать карту и наложить маркеры, а также кластеры маркеров поверх карты для крутых и очень интересных визуализаций.
Folium - это библиотека Python, которая помогает создавать несколько типов карт Leaflet. Тот факт, что результаты Folium интерактивны, делает эту библиотеку очень полезной для создания информационных панелей.
На официальной странице документации Folium:

Матчинг шаблона в Python 3.10

В Python 3.10 имплементирован своего рода оператор switch — что-то вроде него. Оператор switch в других языках, таких как C или Java, выполняет простой матчинг значения переменной и исполняет код в зависимости от этой величины.
Он может использоваться просто, как обычный оператор switch, но способен на гораздо большее.
Возможно, этого было бы достаточно для языка C, но ведь речь о Python, а в Python 3.10 реализована гораздо более мощная и гибкая конструкция, называемая структурным сопоставлением шаблона. Она может использоваться как простой оператор switch, но способна на гораздо большее.
Давайте рассмотрим несложный пример с оператором switch. Ниже приведен сниппет, который осуществляет выбор одного значения. Мы проверим его, запустив в цикле со значениями 1,2,3 и 4.
Дата саентист и циклы-циклы-циклы…
«How I Met Your Mother», season 6, ep. 7
Коля любит циклы.
Толя любит циклы.
Оля любит циклы.
Все любят циклы.

И Сережа тоже.
Один Мамба их не любит. И вот почему.
Если опустить философские рассуждения, что все на уровне процессора является циклом или goto, то можно выделить три причины:
- При работе с индексами цикла можно легко проглядеть и допустить ошибку. Но тут помощь приходят итераторы.
- Очень часто циклы вручную пишутся очень неэффективно с точки зрения манипуляций с памятью — сильная просадка по производительности. А у вложенных циклов еще и накладные на старт цикла.
- Нелинейная структура цикла (
break,continue) не позволяют сделать хорошую оптимизацию на уровне процессора или компилятора. А это дополнительно означает, что распараллелить цикл по вычислителям будет очень трудно. В решении этого вопроса помогает функциональный подход и итераторы. Если известно о независимости вычислений значений каждого отдельного шага — надо сообщать об этом компилятору явно.

Respect Validation на Python

Всем привет! Сегодня мы поговорим о валидации данных, а точнее о том как я перенёс библиотеку с PHP на Python. Библиотека настолько крутая (по мнению автора), что рекомендую вам с ней ознакомиться, особенно, если вы пишите API с библиотекой flask (ссылка на интеграцию в статье).

Как установить ботов для StarCraft II
(с) Blizzard Entertainment
В StarCraft II есть встроенные боты, и все с ними хорошо, за исключением того, что они немного тупые, но речь пойдет не о них. В 2017 году разработчик игры компания Blizzard Entertainment опубликовала API, позволяющий создавать внешних ботов. Однако, по какой-то странной причине Blizzard рассматривает этот API как сугубо исследовательский проект, где боты должны сражаться только друг с другом. Нормальной возможности поиграть человеку с ботами они почему-то не сделали, хотя многие геймеры рассматривают ботов как довольно неплохой инструмент тренировок.
Тем не менее все не так плохо. Раз штатной возможности нет, то будем использовать нештатную. Мы все же настроим ботов и повоюем против них. Потом мы с вами, движимые исследовательским порывом, разберемся как устроен АPI, и поднимем окружение разработки, в котором сможем сами писать подобных ботов.

Сравнение сервисов фильтрации нецензурной лексики

Недавно понадобилось мне подключить мой проект (сайт на WordPress, Телеграм-канал, ВК группу) к фильтру матов и озадачился я предложениями, которые выдает интернет. Поэтому решил проанализировать те, что смог найти и составить личный список, который, надеюсь поможет коммунити Хабра.
Распределённое глубокое обучение: параллелизм моделей и данных в TensorFlow
Значительное количество задач, предусматривающих обучение глубоких нейронных сетей, можно решить на отдельном компьютере, обладающем единственным, сравнительно мощным и быстрым GPU. Но бывает так, что нужно что-то помощнее. Например — данные могут просто не поместиться в память, доступную на отдельной машине. Или окажется, что имеющееся «железо» просто не «потянет» некую задачу. В результате может возникнуть необходимость в горизонтальном масштабировании вычислительных мощностей.
«Горизонтальное масштабирование» — это когда в компьютер добавляют дополнительные GPU, или когда используют несколько машин, входящих в состав кластера. При таком подходе нужен какой-то способ эффективного распределения задач обучения моделей по имеющимся системам. В теории всё просто, но в реальной жизни это — задача нетривиальная. На самом деле — существует несколько стратегий организации распределённого обучения. Выбор конкретной стратегии сильно зависит от конкретной задачи, от данных и от модели.
В этом материале я попытаюсь описать существующие стратегии организации распределённого обучения, раскрыв детали необходимые для того, чтобы читатель смог бы получить общее представление о них. Нашей главной целью будет обретение возможности выбора наилучшей из стратегий для конкретной задачи. Тут я продемонстрирую некоторые примеры кода, основанные на библиотеке TensorFlow. Освоив их, вы разберётесь с тем, как именно устроена программная часть рассматриваемых здесь стратегий распределённого обучения. Но, в любом случае, затрагиваемые здесь концепции применимы не только к TensorFlow, но и к другим библиотекам и фреймворкам глубокого обучения.
Эта публикация входит в серию материалов о глубоком обучении. В предыдущих статьях шла речь о создании собственного цикла обучения для задачи по сегментации изображений с помощью U-net. Мы развернули модель в Google Cloud для того чтобы получить возможность удалённого запуска обучения. Здесь я буду использовать тот же код.