Разработка веб-приложения для транскрибирования аудиозаписей с использованием Python, Streamlit и AssemblyAI
Приложение, о котором тут пойдёт речь, можно испытать здесь.
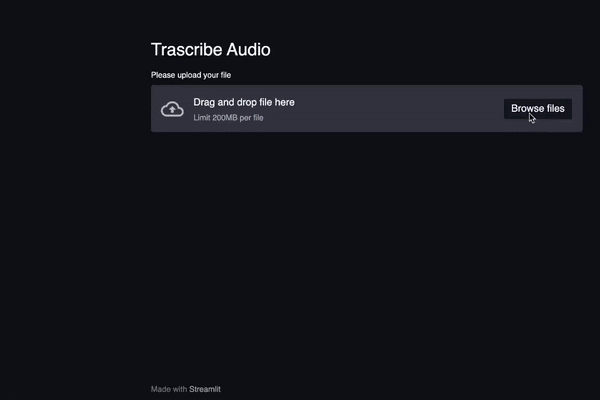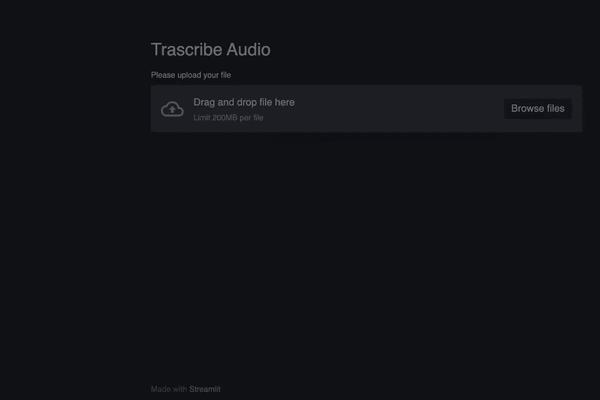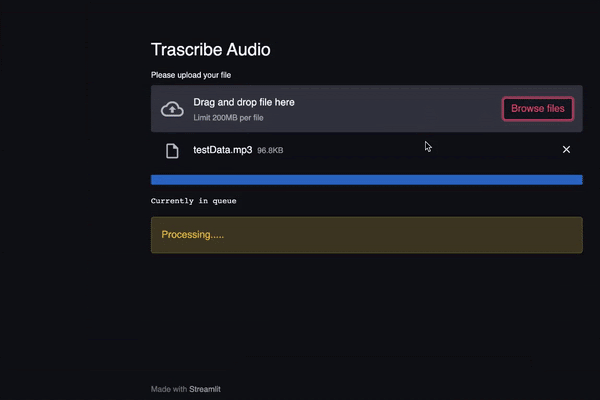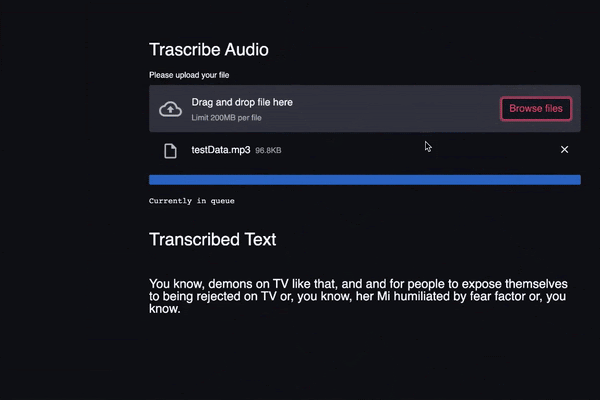
Веб-приложение в действии

Высокоуровневый язык программирования

Недавно я переехал в Москву в квартиру без письменного стола. Это было неловким, отягчающим непростую ситуацию обстоятельством: спального места тоже не было. В общем, я позвонил в IKEA и попросил привезти мне и то и другое.
Через пару дней мебель доставили. Я распаковал первую коробку, из нее вывалилась инструкция и у меня опустились руки: в ней наверняка пятьдесят разных языков, все мелким шрифтом, как книга заклинаний из Гарри Поттера. Но приглянувшись, в ней были только рисунки: два смешных чувачочка показывали как обращаться с деталями, как их вертеть, собирать и так далее. Уф, счастье! Я подумал о JSON и XML. IKEA молодцы они использовали универсальный язык жестов и картинов, понятный всем на свете.

Это пилотная статья. Будем благодарны за обратную связь. Если тема вызовет интерес, мы возможно примем решение выложить на GitHub наши исходники(python) и входные данные.
Случилось мне поучаствовать в марте 2021 г. в хакатоне с задачей на комбинаторику и оптимизацию. Команду решил собрать свежую, из одиночек, дрейфующих в пуле самого хака. Довольно быстро нашлись front и back, и втроем мы принялись старательно размышлять, как потратим деньги, когда выиграем. Надо сказать, что в хаках я не так давно, но уже успел поучаствовать и в ЛЦТ(Лидеры Цифровой Трансформации), и в Цифровом Прорыве. В последнем даже нам удалось занять бронзу в финале. Роль всегда у меня была project+product+ppt. Так вот этот мартовский хакатон меня заинтересовал живостью и насущностью бизнес проблем, которые там решались. Так как часто в хакатонских кейсах проблемы немного надуманы, решения этих проблем немного фееричны и не несут практического смысла, а побеждает профессиональная преза и поставленный питч. Опытные хакантощики, читающие эти строки, поймут. Но полно про хакатоны и про то, какие они бывают, а то собьемся с курса.
В этам хаке преза и даже front мало интересовали кейсодержателей. Это был натуральный бизнес хакатон с абсолютно живыми дата сетами и с натуральной бизнес болью. К слову сказать, наша команда не выиграла, а заняла третье место (всего до защиты дошло 5 команд). Теперь наконец к условию:
Есть 204 ТТ (торговые точки). Каждую из них нужно посетить минимум раз в неделю, а некоторые больше одного раза. Длительности посещения каждой ТТ известны и не изменяются внутри недели.
В этом посте представлен язык Coconut, функциональное надмножество языка Python, целью которого является создание элегантного функционального кода, оставаясь при этом в знакомой среде Python и библиотеках, и приведено несколько показательных примеров.
'Здравствуй, Мир!' |> x -> x.replace('Мир', 'Coconut') |> print

На сегодняшний день Python является одним из самых популярных языков программирования, но даже это ему не помогает покрыть все потребности программистов. Самый очевидный минус чистого CPython - это его скорость, поэтому некоторые программисты выбирают для своих задач другие языки программирования, а кто-то просто реализует узкие места на C/C++.
Однако бывают случаи, когда есть какая-то база кода, написанного на C#, а возможности быстро переписать всё на Python/C/C++ нет. Тогда встает вопрос “как подключить C# к Python”. Для этого была разработана библиотека pythonnet. В этой статье разберем: как запустить C# код на Python и что из этого может получиться.
Этот пост — о том, как я решил сделать систему коллаборативной фильтрации постов из пабликов Телеграма на основе машинного обучения.
И сделал: OLEG AI
В мире наступает революция ИИ, и в какой то момент мне стало казаться, что без меня она наступить не сможет. Поэтому я нашел курс по программированию нейросетей на Питоне Fast.AI, и решил придумать себе небольшой проект, чтобы поучиться на практике.
Я люблю Телеграм. И люблю иногда потупить в какую-нибудь ленту "информационного корма". В разное время я любил поразлагаться на Лепре, Дёти, Пикабу, но в итоге всеми этими источниками сладкого яда я остался недоволен.
И тогда я подумал: в Телеграме ведь куча источников, но Телеграм их не агрегирует по типу Фейсбука. Телеграм не собирает с нас лайки. Да, лайки это чистое зло и гореть им в аду, но иногда так хочется лайкнуть жопу фотомодели, нет?
А рекомендательные сервисы — это одно из направлений ML. А Телеграм — открытая система. Должно быть не сложно, подумал я. Оказалось чуть сложнее чем я думал, но получилось.

В физических науках часто допускают упрощения и приблизительные значения: орбиты всегда круговые, снаряды летят без сопротивления воздуха, а маятник отклоняется только на небольшой угол.
Привет, Хабр! Хочу вам рассказать о своём исследовательском проекте, в котором я создал игрового ботеца для ВКонтакте, и который даже прошел в заключительный этап Всероссийского конкурса проектных работ.

До появления YOLO большинство способов обнаружения объектов пытались адаптировать классификаторы для детекции. В YOLO же, обнаружение объектов было сформулировано как задача регрессии на пространственно разделенных ограничивающих рамок (bounding boxes) и связанных с ними вероятностей классов.
В данной статье мы узнаем о системе YOLO Object Detection и как реализовать подобную систему в Tensorflow 2.0.
Когда говорят про отчеты к данным (неважно, какая тема) все хотят гибкие дашборды, МНОГО дашбордов, играют конкурсы про BI, выдумывают разные сложные требования и кейсы, отсматривают массу вендоров и решений, разбиваются на непримиримые лагеря и на 100% уверены, что это то, без чего жизнь на работе тяжела, уныла и печальна.
Так ли это? По описанию очень сомнительно (похоже на серебряную пулю), а практика дает подтверждение «отнюдь не так».
Является продолжением серии предыдущих публикаций.


Чтобы состарить лицо на фотографии, сменить прическу или заставить его улыбаться, нужно изучить семантику, содержащуюся в отдельных слоях обученной GAN-модели. Недавние исследования генеративно-состязательных сетей показали, что разные слои содержат разную семантику синтезированных изображений: одни отвечают за цвет, а другие за текстуры и т.д.
Очень мало моделей позволяют управлять семантическими атрибутами конкретного слоя. Поэтому в этом месяце продолжают быть актуальными решения и подходы, которые позволяют управлять скрытым пространством для контролируемого создания высококачественных изображений. С них и начнем подборку:

Open Telekom Cloud
В этой статье расскажу о нашем опыте работы над развитием инструментов управления инфраструктурой облачного сервиса Open Telekom Cloud, как мы столкнулись с особенностями этого облака, какие решения принимали, и какие инструменты использовали.
Open Telekom Cloud – международная публичная облачная платформа, основанная на OpenStack. Платформа идеально подходит для компаний или стартапов, которые работают с европейскими пользователями, чьи персональные данные должны храниться в пределах Евросоюза: сервис разработан Deutsche Telekom и соответствует стандартам защиты данных GDPR (Генеральный регламент о защите персональных данных) EC.
Если вам интересна эта тема, добро пожаловать под кат!

Заключительный пост №5 для начинающих посвящен сопоставительной визуализации электоральных данных.

Пост №3 для начинающих посвящен генерированию распределений, их свойствам, а также графикам для их сопоставительного анализа.

Пост №2 для начинающих посвящен описательным статистикам, группированию данных и нормальному распределению. Все эти сведения заложат основу для дальнейшего анализа электоральных данных.

Все мы понимаем, что рекурсивное вычисление чисел Фибоначчи крайне неэффективно. Многим людям наверняка хотелось проверить, где пределы (не)эффективности, но не доходили руки, не хватало времени. Специально к старту нового потока курса Fullstack-разработчик на Python мы решили поделиться переводом статьи, автор которой шаг за шагом показывает возможности современного Python на примере разных подходов к вычислению чисел Фибоначчи. В статье вы найдёте проблемные значения n и сравнение производительности оптимального и неоптимального решений на графике.

Серия из 5 постов для начинающих представляет собой «ремикс» первой главы книги 2015 года под названием «Clojure для исследования данных» (Clojure for Data Science). Автор книги, Генри Гарнер, любезно дал согласие на использование материалов книги для данного ремикса с использованием языка Python.
Книга была написана как приглашение в так называемую «науку о данных», которая в последние годы получила сильный импульс к развитию в связи с потребностью в быстрой и своевременной обработке больших наборов данных локально и в распределенной среде.
Три главы книги были адаптированы под язык Python в течение следующего года после издания книги, т.е. в 2016 году. Публикация ремикса книги в РФ не получилась по разным причинам, но одна из главных станет понятной в конце этой серии постов. В конце заключительного поста можно будет проголосовать за или против размещения следующей серии постов. А пока же…