Обновить

Моя лента

Порог рейтинга
Уровень сложности
Формат публикации
Предупреждение
Войдите или зарегистрируйтесь, чтобы настроить фильтры

Массовая декомпиляция игр и ПО

Нейронные модели сильно повлияли на программную разработку, информационную безопасность и смежные отрасли. Влияние идёт по нескольким векторам, но одно из самых опасных явлений — массовая декомпиляция закрытого проприетарного ПО.

Это явление невозможно игнорировать, ведь из-за обратной разработки проприетарных программ многие могут пострадать. Хотя есть и положительная сторона.

Массовая декомпиляция игр и ПО
Статья

Security Week 2647: использование ИИ-фреймворка ARTEX в реальных атаках

Время на прочтение4 мин
Охват и читатели262

На прошлой неделе сразу несколько источников, включая компанию Amazon и американское Федеральное бюро расследований, сообщили об активной эксплуатации ИИ-фреймворка ARTEX в реальных кибератаках. ARTEX — это открытый фреймворк, написанный на языке Go, использующий ИИ-агенты для разведки, эксплуатации уязвимостей и кражи данных. Он предполагает подключение внешних LLM, таких как Claude и ChatGPT.

ARTEX был опубликован в открытом доступе на GitHub в июле 2026 года как исследовательский инструмент для пентеста. В октябре репозиторий был удален автором после сообщений о злонамеренном использовании фреймворка. В ноябре, по данным исследователей, в Сети можно было обнаружить до 1600 консолей управления ARTEX в открытом доступе. Специалисты Amazon зафиксировали масштабную кампанию, в которой ARTEX использовался для кражи ключей доступа к ИИ-агентам. Сделано это было достаточно хитрым способом: в Amazon создали особые «ИИ-ханипоты», «взлом» и дальнейшие попытки эксплуатации которых позволили исследователям перехватить и проанализировать последовательность промптов, использованных организаторами атаки.

Читать далее
Статья

Сколько стоит узнать, что у бриттона сто хитов

Уровень сложностиПростой
Время на прочтение16 мин
Охват и читатели2K

В игре на пару тысяч NPC самая дорогая по памяти структура данных не меш или скелет, и не физический коллайдер и даже не навигационная сетка, а характеристика вида health = 100. Если писать её по правилам, как учат в книжках по C++, то она займёт 880 байт на персонажа, сделает 14 аллокаций и потратит 27 наносекунд на чтение одного числа, но полезных данных там так и останется 20 байт.

Расскажу как одной довольно известной стратегии мы превратили 880 байт в 64, убрали аллокации и подружили структуры с кешем. Вам, вероятно, пригодится понимание, что такое указатель и что такое аллокация, если вы пришли не из мира С/С++ и надо будет вспомнить что кеш-линия на современном процессоре равна 64 байтам и читается целиком, даже если вам нужен был из неё один байт или хуже того бит, ну прочитать что такое AoS и SoA, если вы вдруг с такими понятиями не сталкивались, а остального в тексте хватит.

Итак... нафига козе аккордеон на похоронах? В проекте был компонент, который хранил для сущности небольшой объём произвольных данных (например их задавал дизайнер в редакторе), классический лист персонажа.

Читать далее
Статья

СМИ врут о блокировках Claude и ChatGPT. Что на самом деле важно при работе с подписками?

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели3K

У человека перестал работать Claude. Он открывает поиск и получает несколько уверенных объяснений: виноват VPN, российский IP, русский язык или карта. Каждое выглядит логичным, пока не находится знакомый, у которого при похожих условиях всё продолжает работать.

Дальше начинается перебор: другой VPN, другая страна, ещё одна карта. Иногда доступ возвращается. Иногда появляется новая ошибка. Но даже удачный результат не всегда отвечает на главный вопрос: что именно было причиной?

Читать далее
Статья

Zero‑Day: невидимые уязвимости цифрового мира

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели2.6K

Когда защита ещё не знает о нападении

Представьте ситуацию: вы используете современную операционную систему, регулярно устанавливаете обновления, пользуетесь антивирусом и уверены, что ваш компьютер защищён. Но существует ошибка в одном из компонентов системы, о которой не знает даже её разработчик. Антивирус не распознаёт угрозу, обновления ещё не существует, а специалисты по безопасности пока не обнаружили проблему.

Такие ситуации связаны с явлением, которое называется Zero-Day Vulnerability — уязвимость нулевого дня.

Это одна из наиболее сложных проблем современной информационной безопасности. Её особенность заключается в том, что разработчики не успели подготовить защиту, поскольку ещё не знают о существовании ошибки или не успели её исправить.

Название Zero-Day связано с тем, что у разработчика фактически нет ни одного дня форы для устранения проблемы после её обнаружения и начала эксплуатации.

Читать далее
Статья

Можете разнести мой Telegram‑клиент?

Уровень сложностиПростой
Время на прочтение1 мин
Охват и читатели2.3K

Всем привет!

Я разрабатываю собственный Telegram-клиент GhostGram. Приложение написано на Kotlin Multiplatform и поддерживает две платформы: Android и Linux.

Хочу предложить вам потыкать приложение и придраться к любой мелочи. Главное, чтобы замечания были объективными.

Например, неправильно расположенный диалог, странные отступы, неподходящие размеры элементов с точки зрения дизайна, баги, проблемы с производительностью и всё остальное, что я мог упустить.

Критиковать можете где угодно:

Читать далее
Статья

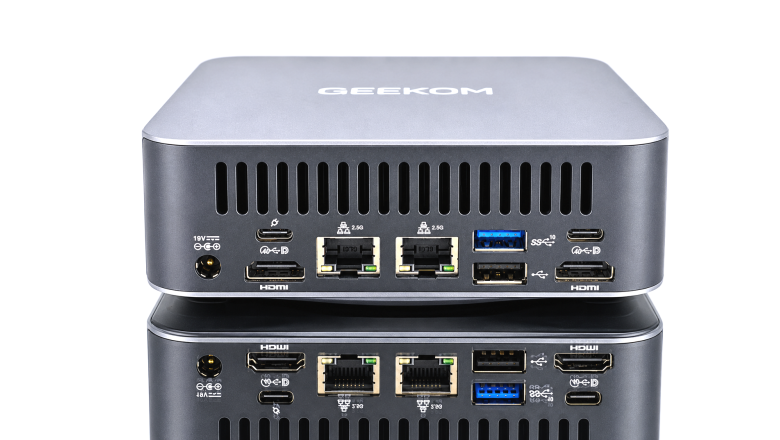
Лайфхак с Shared GPU Memory Override или как я запускал нейросети на мини‑ПК (на примере GEEKOM GT1 Mega)

Время на прочтение11 мин
Охват и читатели2.3K

Неочевидный момент - на мини-компьютерах можно отдать практически всю оперативную память для интегрированного GPU, что позволяет запускать LLM типа 26B/27B, без необходимости покупать дорогостоящие видеокарты. В статье покажу, как это сделать, какие LLM работают и оценю их эффективность.

Читать далее
Статья

Ноутбук для ИИ в 2026 году? Настройка LLM для локальной генерации на примере Ryzen 9 8940HX и GeForce RTX 5060

Время на прочтение12 мин
Охват и читатели2.1K

Генерировать программный код, создавать трехмерные модели, обрабатывать фотографии и даже запускать генерацию изображений сегодня можно непосредственно на ноутбуке. Причем для этого необязательно покупать дорогую рабочую станцию с профессиональной видеокартой или собирать отдельный сервер с несколькими GPU. В этой статье я хочу показать, как организовать локальную ИИ-станцию на базе MAIBENBEN X17F с процессором AMD Ryzen 9 8940HX и видеокартой NVIDIA GeForce RTX 5060.

Читать далее
Статья

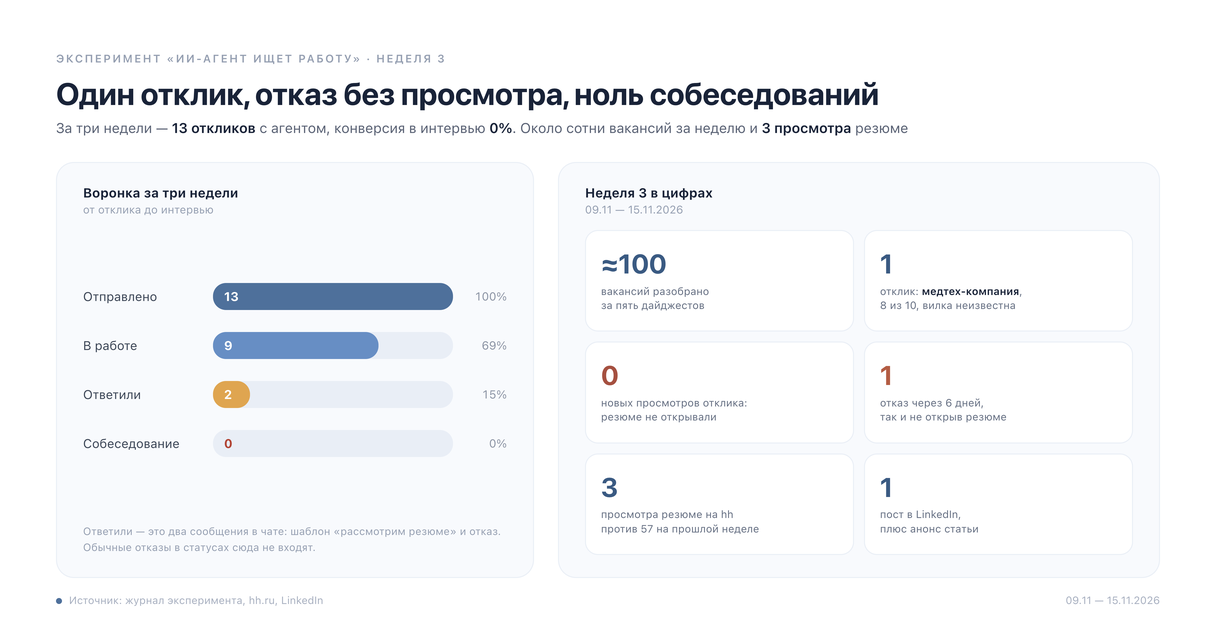
Я нанял ИИ искать мне работу. Неделя третья: один отклик и семь баллов, которые стали пятью

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели4K

Третья неделя: один отклик, один отказ, ноль собеседований. Главное — как агент считает баллы: почему семёрка превратилась в пятёрку, откуда взялся порог 6,5 и чего балл не видит.

Читать далее
Статья

Термин «теория» в науке имеет особый смысл

Уровень сложностиПростой
Время на прочтение15 мин
Охват и читатели3.7K

Итан Сигел (американский астрофизик‑теоретик и научный журналист, автор рубрики «Спросите Итана», один из пропагандистов современных научных знаний), разъясняет, что нужно сделать, чтобы из гипотезы, догадки ваша идея стала научной теорией.

@avshkol перевёл эту статью, поскольку в ней простым языком объясняется, почему масса того нового, что появляется в популярных научных статьях, не дотягивает до определения научной теории... Осторожно: после прочтения вы уже другим взглядом будете смотреть на популярные научные статьи...

Читать далее
Статья

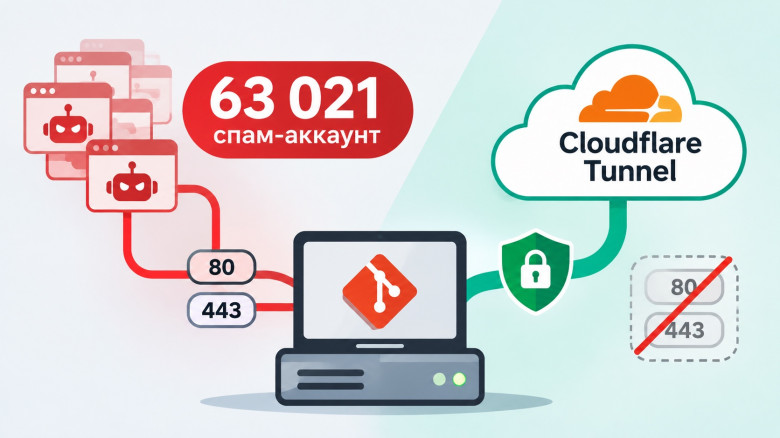
63 тысячи спам‑аккаунтов: как я за ночь защитил домашнюю инфраструктуру

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели5K

Всё началось с обычного переноса Docker-стеков, а закончилось ночным аудитом безопасности домашней инфраструктуры. По ходу дела выяснилось, что WAF не видит реальные IP-адреса атакующих, на Git-сервере накопилось 63 тысячи спам-аккаунтов, а некоторые сервисы доступны извне в обход настроенной защиты. Рассказываю, как обнаружились эти проблемы, что пришлось исправить и как в итоге удалось закрыть прямой доступ к домашним веб-сервисам из интернета.

Узнать подробности
Статья

Легкие LLM на CPU, часть 2: какую модель ставить на VPS без видеокарты

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели5.5K

В первой части статьи я из любопытства проверил, какие бизнес-задачи могут решать легкие модели на недорогом VPS без видеокарты. В комментариях мне отсыпали критики, и часть ее, как водится, по делу. Так что продолжение отчасти написано в жанре работы над ошибками, и, чтобы понимать, что и почему я переделывал, лучше сначала обратиться к истокам.

Сказать по правде, я и сам хотел кое-что довести до ума: повторить тесты на сервере с 8 ГБ RAM, проверить российские модели покрупнее и т.д. Новый эксперимент я ставил с учетом ошибок и недоделок первой части. Цифры получились точнее и строже, а любопытных фактов, надеюсь, не меньше. На этом перейдем ближе к делу.

Читать далее
Статья

Поставил ИИ проверять ИИ, и тот научился списывать

Время на прочтение15 мин
Охват и читатели5.2K

Красивый отчёт не значит верный. А верный не значит полезный. Можно ли вообще построить систему исследований с ИИ, если модели становятся умнее и врут всё убедительнее? Пытаешься поймать их на ошибках — и постепенно обкладываешь систему правилами так, что профита от генеративности всё меньше.

В статье — почему строгость и польза могут тянуть в разные стороны, как ловить новые обманки и как я собираю систему, которая помогает находить в куче данных инсайты для роста продукта.

Читать далее
Статья

Гибридная постквантовая криптография в мессенджере: что именно гибридное и как это проверить самому

Уровень сложностиСложный
Время на прочтение18 мин
Охват и читатели6.8K

Разбираем, где в мессенджере Umbera стоит постквантовая криптография: конверты сообщений, файлы, группы MLS, звонки, журнал ключей, код безопасности и адреса ящиков. Для каждого механизма — формула, файл в открытом репозитории и тест, который можно запустить одной командой. В конце — честный список того, что проверить пока нельзя.

Читать далее

Ближайшие события

Статья

Как я встроил шесть игр на память и логику в Obsidian

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели6.1K

На Human Benchmark я дошёл до 13-го уровня в Sequence Memory и заметил, что начал запоминать картину группами. Захотелось натренировать это на других заданиях, но ради пяти минут каждый раз открывать отдельный сайт надоело. Так появился Brumalt — бесплатный офлайн-плагин для Obsidian с шестью играми на память и логику. Расскажу, как он устроен: от генератора задач, который перебором проверяет единственность ответа, до адаптации сложности. И что на самом деле известно о пользе таких тренировок.

Читать далее
Статья

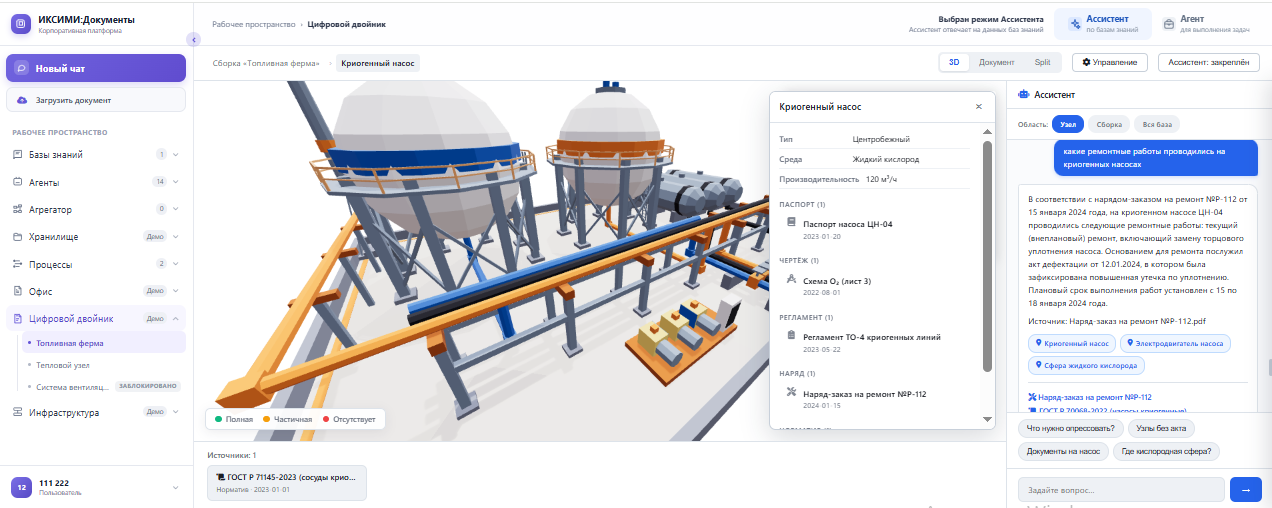
Цифровые двойники (Digital Twin) в инженерных системах — Часть 1. Управление документацией

Время на прочтение17 мин
Охват и читатели6.3K

В последние годы технология Digital Twin превратилась в один из главных трендов промышленной автоматизации. Крупные вендоры - Siemens, Schneider, Aveva, и десятки других предлагают платформы, в которых «двойник» обещает предсказывать отказы, оптимизировать режимы, экономить миллионы. Аналитики Gartner и MarketsandMarkets оценивают рынок в десятки миллиардов долларов к концу десятилетия.

На практике картина скромнее. Многие компании ограничиваются цифровыми двойниками отдельных технологических процессов: локального техпроцесса, конкретной линии розлива, конкретного узла. И только единицы, как правило, крупные корпорации с собственными R&D-командами доходят до цифровых двойников инфраструктуры целиком: завода, месторождения, трубопроводной системы на сотни километров.

Между этими двумя полюсами лежит огромный разрыв. И он не столько технологический, сколько организационный и интерфейсный.

В этой статье я подробно расскажу о практических подходах к построению Digital Twin решений который относятся к классу ПО интеллектуальных корпоративных систем интеграционного менеджмента информации (ИКСИМИ). Я AI\ML исследователь и специализируюсь интеллектуальных системах управления корпоративными данными. Мои публикации на тему гибридных информационных систем, интеллектуальных графов и кластерной AI маршрутизации можно найти здесь и здесь
Читать далее
Статья

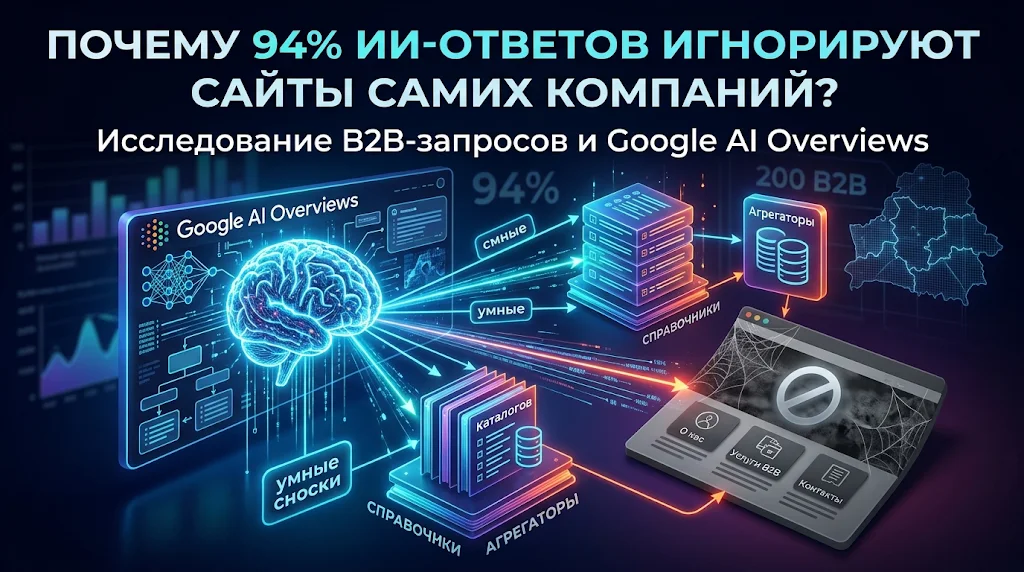
Почему 94% ИИ‑ответов игнорируют сайты самих компаний

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели6.4K

У бизнеса сегодня появилась странная проблема: сайт спокойно держится в топ-10 поиска, но когда клиент спрашивает подрядчика у ChatGPT, Perplexity или в ИИ-сводке Google, компании в ответе просто нет. Вместо самих исполнителей нейросеть собирает подборку из внешних каталогов и справочников.

Чтобы разобраться, по каким правилам модели отбирают кандидатов, я прогнал двести реальных B2B-запросов и проследил цепочку поиска. В 94 из 100 отраслевых подборов ИИ-сводка действительно открывалась, но корпоративные сайты туда почти не попадали.

Дальше я сопоставил эти прогоны с месячной статистикой краулеров на открытом каталоге организаций, где каждая карточка отдаётся сразу в HTML, Markdown и JSON. Стало понятно, почему не спасает даже llms.txt в корне сайта и что нужно сделать, чтобы модель всё-таки включила бизнес в рекомендации.

Читать далее
Статья

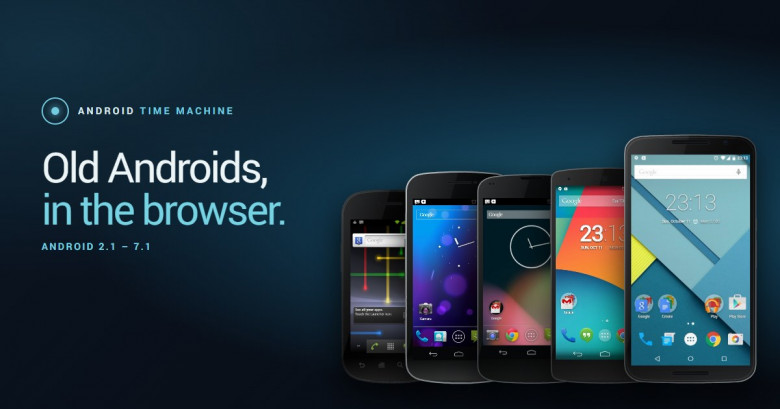
Вышел проект Android Time Machine — пять онлайн‑смартфонов Nexus с классическими версиями Android 2.1 — 7.1

Время на прочтение1 мин
Охват и читатели7.4K

Разработчик под ником szabolevi98 представил открытый проект Android Time Machine (веб‑версия, репозиторий на GitHub). Это решение представляет собой «машину времени» для Android, где для изучения онлайн доступны пять смартфонов Nexus с классическими версиями Android 2.1 — 7.1.

Читать далее
Статья

У каждого восьмого сайта малого бизнеса чужой сервер ломает или тормозит страницу. Сделали проверку, которая это находит

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели6.9K

У каждого восьмого из 500 сайтов, которые мы проверили в прошлой статье, часть страницы не загружалась или сайт открывался на секунды дольше. Причина везде одна: страница ждала файл с чужого сервера, а он не пришёл.

Худший случай — форма заявки с капчей, которая не загрузилась. Посетитель жмёт «Отправить», ничего не происходит, он уходит к конкуренту. Владелец этого не видит: у него сайт открывается, просто заявок стало меньше.

Рассказываем, как сделали бесплатную проверку, которая находит такие места, как честно измерить влияние чужих скриптов на скорость и какие три правки защищают форму заявки от чужого сбоя.

Читать далее
Статья

Независимые как понятия, зависимые как операции: параметры семплирования в LLM‑инференсе

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели6.6K

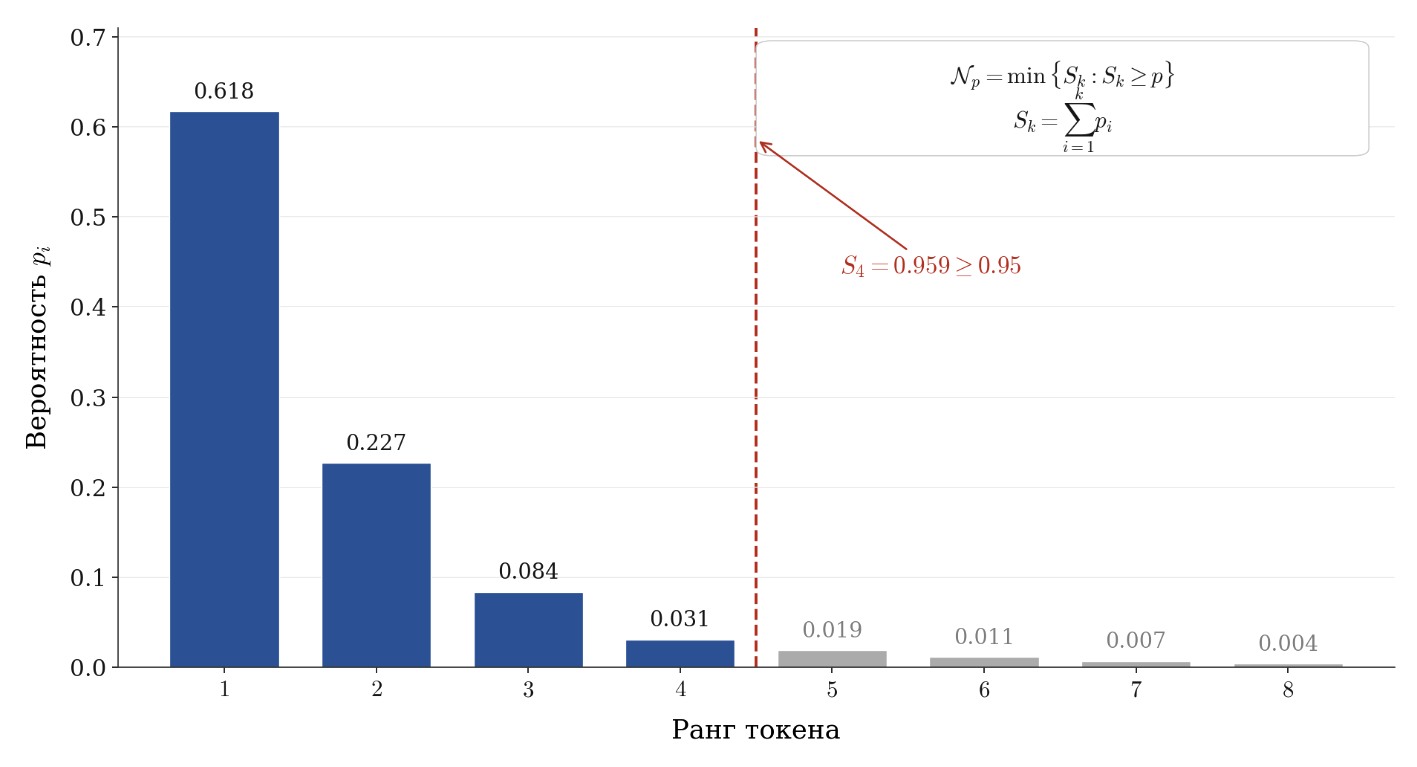
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг, квантизация, параллелизм. Эти компоненты формируют «скелет» системы и задают её предельные характеристики. Однако за пределами этого фокуса нередко остаётся слой, определяющий не скорость, а качество. Это параметры семплирования - правила выбора следующего токена из распределения логитов на каждом шаге декодирования.

Читать далее
Статья

Глаз Бога для бизнеса: тестирую FirmaScanBot

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели7.3K

Вчера я опубликовал статью о своём проекте FirmaScanBot — Telegram-боте, который по ИНН собирает информацию о компаниях и формирует деловое досье. Рассказал, для чего решил его создать, что он умеет и какую основную задачу перед собой поставил.

Сегодня хочу продолжить эту тему, но уже немного с другой стороны. Расскажу о первых результатах тестирования, технической части проекта, о том, как бот собирает информацию из различных источников и что планирую добавить в следующих версиях.

Сейчас FirmaScanBot проходит тестирование, и на своём Telegram-канале «Налоговый Инсайдер» я его пока не публикую. Сначала хочу проверить, насколько хорошо сервис справляется с нагрузкой, как работает на разных организациях и какие замечания возникают у пользователей.

На сегодняшний день у бота было 38 пользователей. Для проекта, информация о котором опубликована лишь в одной статье на хабре, считаю неплохим результатом.

Читать далее
1
23 ...