Обновить
128K+

Алгоритмы *

Все об алгоритмах

124,89
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Нейросеть сделала 3D‑модель по фото. Почему принтер с ней совсем не согласен

Уровень сложностиСредний
Время чтения11 мин
Охват и читатели12K

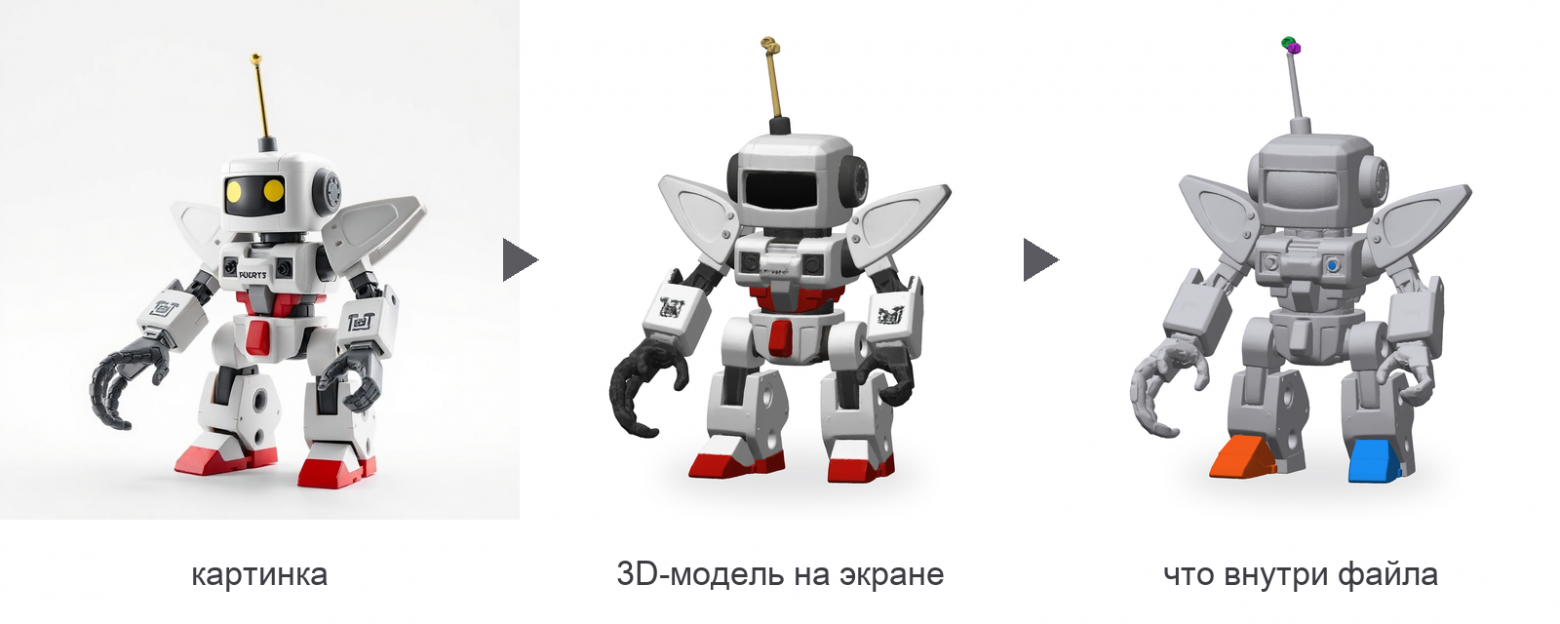
Вы скармливаете нейросети снимок фигурки, и через несколько минут на экране уже крутится аккуратная 3D‑модель. Всё на месте, даже надпись на груди. Скачиваете файл, открываете слайсер, а он первым делом интересуется, не в метрах ли вы случайно сделали эту красоту. А в файле она размером с маковое зерно.

И это самый безобидный дефект. Почти у каждой второй модели слайсер показывает значок предупреждения. А о некоторых дефектах он прямо не говорит: на превью всё выглядит идеально, а в файле ступни робота висят в воздухе отдельно от ног.

Меня зовут Артём Кузнецов, я AI/ML‑инженер и CTO стартапа, который занимается AI‑технологиями в области 3D‑печати.

Ниже — откуда берутся эти дефекты, если заглянуть под капот генераторов, и как их определять за пару минут, пока стол принтера нагревается. Разбор идёт на уровне сетки и с кодом, так что может пригодиться и тем, кто встраивает генерацию 3D в свой софт.

Читать далее

Теорема Байеса в реальной жизни — это не про формулу

Уровень сложностиСложный
Время чтения12 мин
Охват и читатели9.8K

Сразу к делу. Если вы открыли эту статью, потому что искали гайд “Теорема Байеса за 5 минут”, шпаргалку для прохождения собеседования или надеетесь увидеть очередной стерильный пример про “редкую болезнь и тест с точностью 99%” — вам не сюда. Закрывайте вкладку, берегите глаза, время и карму. Материал плотный, требует включения головы и не предполагает легкого чтения.

Если вы остались, значит, вы уже сталкивались с тем, что в реальной аналитике и бизнесе знание формулы наизусть не стоит ничего.

В интернете 90% обучающих материалов по Байесу сводятся к двум крайностям. Первая - сухая академическая нудятина с вероятностными пространствами, которую невозможно применить на практике. Вторая - крайнее упрощение, где автор дает готовые проценты “из вакуума”, а от вас требуется лишь механически разделить числитель на знаменатель.

Оба подхода формируют опасную иллюзию: кажется, что Байес - это просто калькулятор. Но в реальной работе, когда вы сталкиваетесь с живыми, зашумленными данными, никто не выдает вам готовые “Правдоподобия” на блюдечке. Главная сложность заключается не в арифметике, а в методологии: как сформулировать гипотезу, откуда брать цифры и, самое главное, как правильно “нарезать” выборку.

В этой статье мы не будем зубрить формулу. Вместо этого мы разберем:

Почему если у вас есть SQL таблица со статистикой - теорема Байеса вам, скорее всего, не нужна.

Как смена базовой выборки меняет управленческое решение с минуса на плюс (разберем на примерах покупки подержанного авто, контроля качества на производстве и фильтрации B2B-лидов).

Где аналитики фатально путают P(E\mid H) и P(H\mid E) и как не стать жертвой “эффекта маскировки” в реальных данных.

Жесткий чек-лист из трех пунктов, который нужно прогнать в голове, прежде чем подставлять первые цифры в формулу.

Статья написана для тех, кто хочет научиться принимать решения на основе данных, а не просто красиво цитировать учебники. Если вы готовы копнуть глубже механического подсчета дробей - добро пожаловать под кат.

Читать далее

Карта на 78 млн клеток, которую я так и не построил: Кубок СЭРПАС 2026 на Эльбрусе. Часть 2

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели7.5K

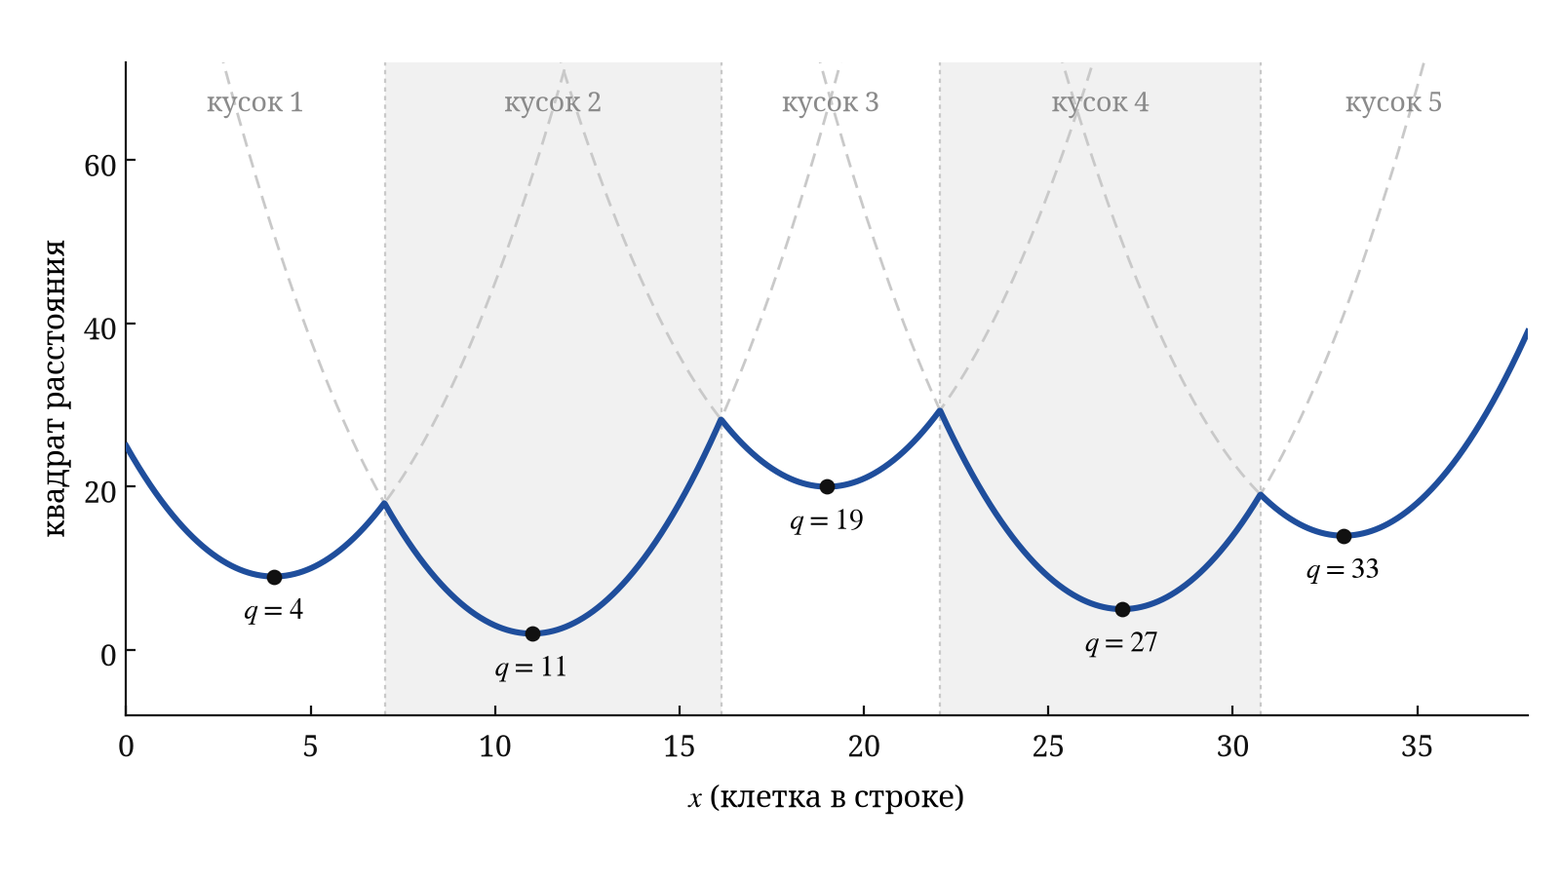
Карта города на 78 миллионов клеток, и для каждой нужно расстояние до ближайшего пункта выдачи. Я посчитал все суммы и максимумы, так ни разу и не построив саму карту, а время упало с 444 до 70 мс.

Это вторая часть рассказа о том, как я выиграл Кубок СЭРПАС 2026 на Эльбрусе. В ней точные свёртки через NTT вместо FFT, параболы, ячейки Вороного и четыре строки в одном регистре.

Как обойтись без карты

От быстрых скипов до полных досмотров: как мы предсказываем распределение времени просмотра

Уровень сложностиСложный
Время чтения10 мин
Охват и читатели6.7K

Привет, Хабр! Мы — команда AI VK: Софья Гулевская, Михаил Трапезников, Александр Пославский и Александр Дьяконов. В этой статье расскажем, почему привычные методы прогнозирования времени просмотра не всегда справляются с короткими видео, какие проблемы возникают при обучении вероятностных моделей и как мы решили их с помощью HEGM — Hierarchical Exponential-Gaussian Mixture.

Покажем архитектуру, результаты экспериментов на открытых и промышленных данных, а также расскажем, что изменилось после A/B-тестирования на реальном трафике. Исследование принято в основной трек конференции IEEE ICDM 2026, а код и модели мы выложили в открытый доступ.

Подробности под катом

Клеточный автомат на микросхемах мелкой логики. Часть 1 — Изобретаем велосипед

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели17K

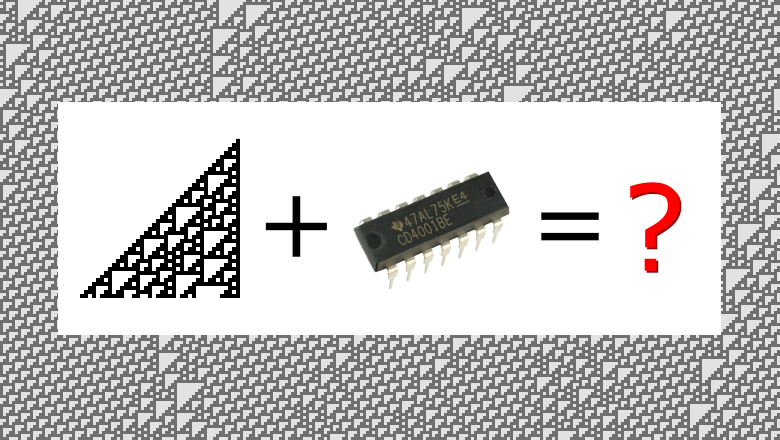
Я давно хотел реализовать клеточный автомат «в железе» — то есть без программ, процессоров, микроконтроллеров, — на жёсткой логике. Например, широко известную игру «Жизнь». Однако каждый раз, когда я пытался представить себе реализацию, получалось нечто ужасное: сотни и сотни логических элементов ради того, чтобы собрать крошечное поле, на которое не влезет ничего, кроме одного глайдера. Поэтому я решил начать с чего-то более простого, — например, взять не двумерный клеточный автомат, а одномерный. Скажем, «Правило 110». В этой серии статей я расскажу, как мне удалось решить эту задачу.

Читать далее

Как из двух кубиков выбить число Пи?

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели15K

В этой статье я расскажу о самом абсурдном физическом проявлении числа π, какое мне доводилось встречать.

Представьте, что у нас есть два кубика — большой и малый. Большой движется справа в сторону малого, который изначально неподвижен. Слева от обоих кубиков расположена стена. В определённый момент большой кубик толкает малый, тот летит в стену, рикошетит и на обратном пути взрезается в своего обидчика, снова отскакивая от него к стене. В результате множества таких повторяющихся столкновений импульс движения большого кубика меняется на противоположный, и в конечном итоге он начинает удаляться от стены быстрее малого.

Читать далее

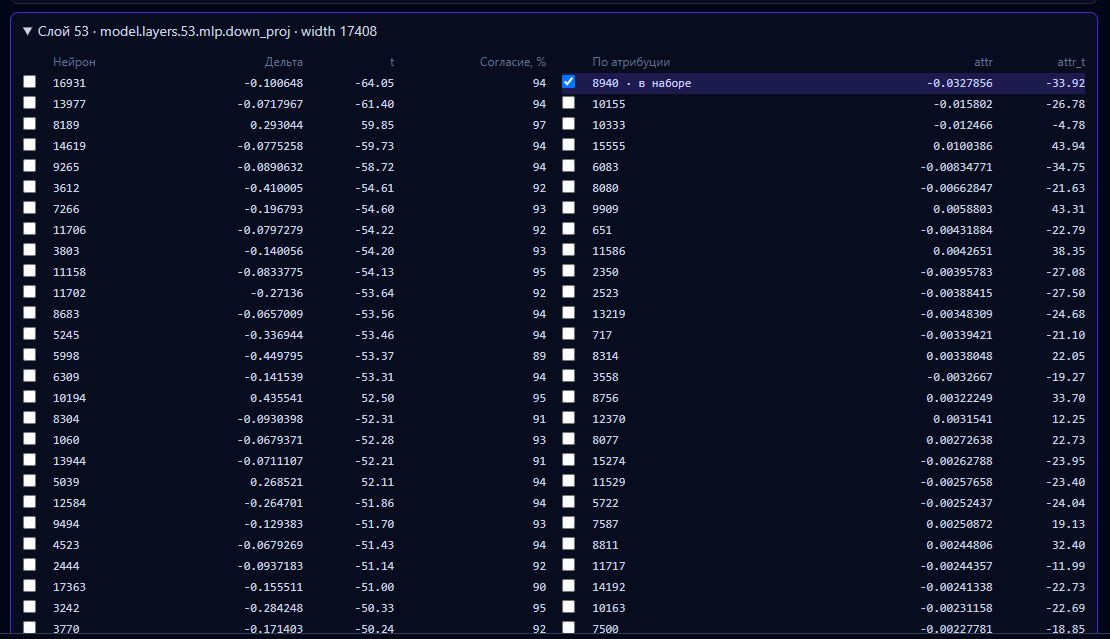
Препарируем мозг Qwen 3.8 27B-1c

Уровень сложностиСредний
Время чтения17 мин
Охват и читатели12K

Есть Qwen 3.8 27B, дообученная (SFT + LoRA) на корпусе по платформе 1С:Предприятие — модель выложена на hugging face. Модель неплохо пишет код на встроенном языке, но на языке запросов 1С регулярно ошибается: путает виртуальные таблицы, ставит параметры не туда, подмешивает конструкции из SQL, которых в 1С нет.
Попытки классического подхода дообучать и дальше модель, собирая все новые и новые датасеты по языку запросов 1С, ни к чему не приводят. Выигрыш в accuracy дает меньше 1%. Ну и это долгий и мучительный процесс.

В процессе мучений с моделями qwen, разбора телеметрии использования модели возникла гипотеза: модели мешают знания по конструкциям SQL, т.к. лексемы схожие (SELECT, WITH, JOIN и.т.п.).

Отсюда возникает вопрос: можно ли найти конкретные нейроны, которые «тянут» модель к неправильному ответу, и аккуратно приглушить только их?

В статье — полный конвейер, который я назвал NERVE (Neuron Editing, Reweighted & Val-Evaluated)

Читать далее

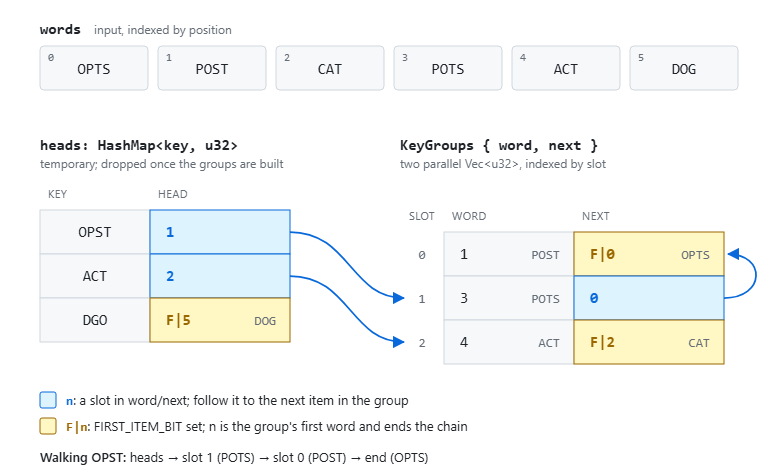
11 наносекунд на слово: оптимизируем поиск анаграмм до абсурда

Время чтения10 мин
Охват и читатели9.5K

Сыграем в «словесную лесенку»

BLOG → BLOT → SLOT → SPOT ↝ POST

Недавно друг рассказал мне о новом варианте игры «Словесная лесенка»: найти путь преобразований от начального слова до конечного, где на каждом шаге разрешено заменить одну букву, либо удалить одну букву, либо вставить одну букву, либо анаграммировать слово. Это меня раздражало (бывает дьявольски сложно вычленить пути, идущие через анаграммы), поэтому, естественно, я написал программу для решения таких задачек. Когда оказалось, что прогон программы занимает более 1 секунды, мне, конечно же, захотелось её оптимизировать. Занимаясь этим, я обнаружил интересный фокус для индексирования анаграмм — для каждого слова из словаря подгонять идентификатор бесколлизионного произведения простых чисел под одно 64-разрядное целое число — такого я раньше никогда не видел (хотя, у вычислительной техники долгая история, и Кнут, вероятно, заметил это ещё в 1965 году).

Для полноты картины должен отметить, что меня интересовало решение конкретной задачи: найти все анаграммы в словаре. Если вы хотите просто найти все анаграммы для конкретного слова, то вам подойдёт какое‑то гораздо более простое решение, например, хеш‑таблица! В изложенном далее материале мы найдём все анаграммы и поговорим о полном пути вверх по лестнице.

Читать далее

Как мы построили систему планирования производства для типографии и проверяли её точной моделью

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели7.5K

Привет! Меня зовут Илья Грошев, я разработчик в KTS и последние полгода отвечаю за планировщик производства для типографии: сотня машин, полторы сотни людей с допусками и графиком смен, у каждого заказа свой маршрут операций. Каждый заказ нужно закончить к обещанному сроку, а для каждой операции найти свободную машину и человека с допуском в одну и ту же смену.

Планировщик берёт заказы один за другим, расставляет операции каждого по правилам типографии и к уже поставленным заказам не возвращается. План строился быстро, но заказы в нём опаздывали даже при свободных машинах, и мы не знали, можно ли лучше. На тестовом наборе он укладывал в срок 8 заказов из 15, а точная модель на тех же данных показала, что можно все 15.

В статье расскажу, как мы строили этот алгоритм и почему точная модель осталась у нас инструментом отладки и в прод не попала. Разберу задачу, три слоя планировщика с гипотезами, которые сработали и которые провалились, три способа проверить план и то, что проверка изменила в алгоритме. Опыт пригодится тем, кто составляет расписания или распределяет ограниченные ресурсы и выбирает между эвристикой и точной моделью.

Читать далее

Как заставить робота‑уборщика проверять ценники: OrangePi, две камеры и немного «нечистых путей»

Уровень сложностиСредний
Время чтения21 мин
Охват и читатели6.7K

Привет, хабр! Я Коля Паршуков из Tevian, решил поделиться интересным опытом по взаимодействию с роботом‑уборщиком вместе с технологиями компьютерного зрения. 

Представьте обычный продуктовый магазин. Несколько рядов стеллажей, тысячи товаров и примерно столько же ценников. Цены регулярно меняются, и после очередного обновления админ магазина должен убедиться, что на полке действительно висит та цена, которая сейчас находится в учётной системе. Но есть нюанс — проверять всё вручную долго, муторно и скучно.

Выпускайте робота

Forth: Как найти и отделить самую правую единицу в двоичном числе

Уровень сложностиПростой
Время чтения12 мин
Охват и читатели6.5K

Листая одну старую книжку по древнему языку программирования Форт [1], я наткнулся на такой фрагмент, в котором меня заинтересовало слово LAST1

Читать далее

Мог ли Pentium Pro 1996 года обыграть Каспарова без Deep Blue? Я портировал на него Stockfish

Время чтения10 мин
Охват и читатели15K

Для победы над Каспаровым в 1997 году IBM построила Deep Blue: 30 процессоров и 480 заказных шахматных сопроцессоров, больше 200 миллионов позиций в секунду. Николас Карлини проверил, хватило бы обычного Pentium Pro на 200 МГц с 64 МБ памяти, если поставить на него современный движок. Порт Stockfish 17 на эту машину играет с оценочным рейтингом около 3300 Эло при классическом контроле, а Crafty 1996 года с приёмами последних тридцати лет поднимается с 1999 до 2718 при секунде на ход. В матче из 100 партий движок на Pentium Pro выиграл 78 партий у Crafty 1996 года, работающего на современном Ryzen. Перевод с таблицами: какой приём сколько Эло дал и почему большая часть прироста пришлась на алгоритмы, а не на железо.

Читать далее

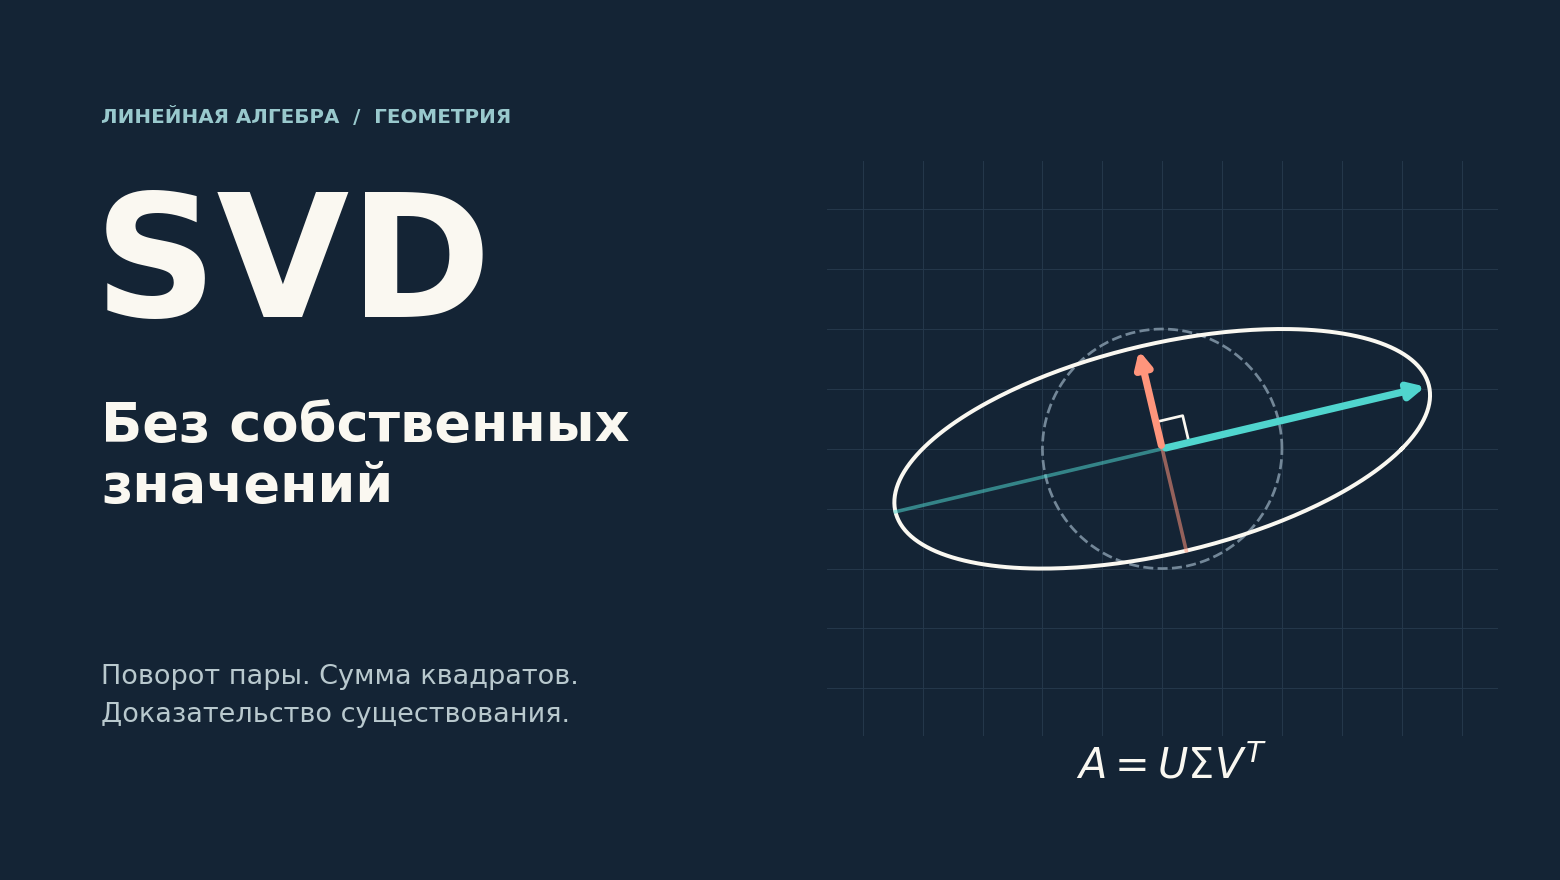
Удивительно простое доказательство сингулярного разложения матриц

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели7.8K

Можно ли доказать существование SVD без собственных значений, определителей, производных и даже без теорем математического анализа о непрерывных функциях?

Оказывается, такое удивительное элементарное доказательство существует!

Мне не удалось найти его где-либо в литературе, даже используя средства ИИ для поиска, так что будем считать, что первым его придумал я 2 ноября 2026-го года.

Отдельная благодарность Ивану Оселедцу, который дал на своей лекции элементарное доказательство SVD для матриц 2 на 2, на основе которого я и построил общий случай.

Для понимания происходящего далее достаточно знать основы теории пределов последовательностей, аксиому полноты вещественных чисел, матрицы и действия с ними, векторы и основы теории евклидова конечно-мерного пространства R^n.

Разобрать доказательство

Ближайшие события

Как подготовиться к миру, где бал правит ИИ? Меня зовут Николай Лыков, и я постарался отобрать главное из обширного...

Охват и читатели10K

Как подготовиться к миру, где бал правит ИИ?

Меня зовут Николай Лыков, и я постарался отобрать главное из обширного интервью с Мо Гавдатом (бывший директор по развитию в Google X), которую он дал Глебу Соломину: https://www.youtube.com/watch?v=LqPKkUMLqfU

1. Нужно стать гибким.
Раньше люди условно играли в шахматы и старались предугадать, что будет на 4 года вперёд. Теперь жизнь похожа на игру в сквош (играют двое ракетками для большого тенниса у стенки). Нужно предугадать, куда ударит противник, а он - постарается ударить туда, откуда сложнее отбить. То есть чаще опираться на реальные факты (то, что вокруг).

2. Теперь нет заранее установленного интеллекта. Интеллект - это то, что нужно и можно развивать.
Ошибка: все используют ИИ, чтобы заменить себя.
Как надо: научиться использовать ИИ так, чтобы стать умнее, а не так, чтобы делать работу наиболее ленивым способом.

3. Необходим навык проверки информации.
Окружающий нас мир полон лжи: реклама, СМИ, политики навязывают свою картину мира. А теперь с ИИ невозможно понять, что такое правда, если всё не проверять.

Практический рецепт. Сначала отправляется запрос в Gemini. Потом отправляется запрос в DeepSeek: так сказал Gemini, что скажешь? Затем взять оба варианта ответа и загрузить в Chat GPT с просьбой объединить их, а потом отдать результат в Claude. Потом нужно вернуться в Gemini и сказать: "Claude считает тебя глупым!"

4. Нужно на непредвиденный случай освоить "аналоговые навыки".
Научитесь печь хлеб, готовить, разбираться в съедобных грибах, делать мебель, чинить машины.

Читать дальше →

Как набор грязных хаков добавил мультиплеер в легендарную игру: разбираем архитектуру SAMP

Уровень сложностиСредний
Время чтения20 мин
Охват и читатели17K

Осторожно: эта статья — не просто очередная ретроспектива с воспоминаниями, а конкретный разбор сетевой архитектуры и хаков, благодаря которым стал возможен мультиплеер в GTA аж на 1.000 человек одновременно. Если вам интересен геймдев и то, как работают игры под капотом — статья обязательна к прочтению!

GTA: San Andreas запомнилась нам как легендарная игра с немыслимым, по меркам 2004 года, масштабом. В ней был и огромный бесшовный мир, состоящий из трех городов, и массивный автопарк аж из 213 транспортных средств, и длинная интересная история с кучей сайд‑активностей, прохождение которых занимает как минимум несколько дней, и даже элементы RPG с базовой прокачкой персонажа.

И вот всё в ней было идеально, кроме одного — мультиплеера. Rockstar не успела доделать полноценный режим сетевой игры, оставив лишь подачку в виде локального кооперативного режима на PS2, в котором даже миссии проходить было нельзя. Однако группа моддеров под руководством Kalcor смогла воплотить то, что не удалось сделать Rockstar — реализовать мультиплеер в GTA SA аж на 1.000 человек одновременно. И о том, как им удалось это сделать, я расскажу в рамках сегодняшней статьи!

Читать далее

Заменяем базу данных SQLite на 3 ГБ конечным автоматом‑преобразователем на 10 МБ

Время чтения7 мин
Охват и читатели14K

Примечание для любителей чисел: все значения в статье округлены до первого значимого разряда, потому что я фанат метода «zequals» Роба Истэуэя, который позволяет сразу переходить к сути при выполнении оценочных расчётов. Гораздо полезнее запомнить такую эвристику: «Один парень сократил потребление памяти в 300 раз, заменив самодельную базу данных на крошечную статическую специализированную структуру данных, которая делает именно то, что ему нужно, и ничего лишнего».

В одни выходные мне представилась невероятно редкая возможность поработать с Taskusanakirja, часто называемым tsk — финско‑английским словарём с инкрементальным поиском в процессе набора1. Принципиально эта задача сводится к префиксному поиску, а каноническое решение префиксного поиска с автозавершением — это реализация префиксного дерева.

Она замечательно работала в первой реализации tsk, написанной на Go (о которой я уже много раз рассказывал). В ней используется несколько базовых оптимизаций. Чтобы не выполнять поиск по нескольким процентам от общего числа слов (а их было несколько сотен тысяч), которые мы встраивали непосредственно в исполняемый файл (с самого начала одной из целей проектирования было поставлять всю программу в виде одного файла .exe, одного файла .app или одного статически скомпонованного исполняемого файла), мы установили ограничение: например, возвращать только первые 50 или 100 совпадений. Кроме того, мы просто заранее кэшировали все комбинации из 1, 2 и 3 символов. После этого за целый год интенсивного личного использования я больше ни разу не замечал сколько-нибудь ощутимых задержек в работе программы. При помощи подобных простых оптимизаций мы смогли сжать префиксное дерево примерно в 60 МБ.

Однако финский язык отличается чрезвычайно развитой агглютинацией. Одно-единственное исходное слово может иметь более сотни возможных окончаний, если учитывать все их комбинации. Причём эти комбинации не образуются по какому-то простому регулярному правилу!2 Кроме того, чрезвычайно последовательная орфография финского языка означает, что написание слов точно отражает то, как носители языка действительно их произносят. Поэтому по мере добавления окончаний исходные слова причудливым образом удлиняются, изменяются и трансформируются, приобретая благозвучные формы. Всё это кажется совершенно естественным, если ты уже пару лет погружён в изучение языка. Но новичок, увидев предложение вроде «Opiskelijassammekin on leijonan sydän», с большой вероятностью споткнётся об одно конкретное слово. Одна из задач этой программы — помочь изучающему понять, где именно нужно правильно разделить слово на составляющие, и для этого она тоже включает в себя всю необходимую информацию.

Здесь префиксное дерево даёт сбой...

Читать далее

Реверс-инжиниринг алгоритма тангенса в процессоре Intel 8087

Время чтения27 мин
Охват и читатели12K

Это ещё одна моя статья о чипе арифметики с плавающей запятой Intel 80871. В 1980 году компания Intel представила процессор 8087, который сильно повысил скорость выполнения операций с плавающей запятой в IBM PC и других системах. В этой статье мы рассмотрим алгоритм, лежащий в основе команды вычисления тангенса. Один из распространённых подходов к реализации тригонометрических функций — это алгоритм CORDIC. Второй — это аппроксимация при помощи многочленов. Для обеспечения высокой точности и высокой производительности 8087 сочетал в себе оба этих подхода, создав огромный прирост скорости по сравнению с микропроцессором 8086: тангенс в нём вычислялся всего за 90 микросекунд вместо 13 тысяч микросекунд2.

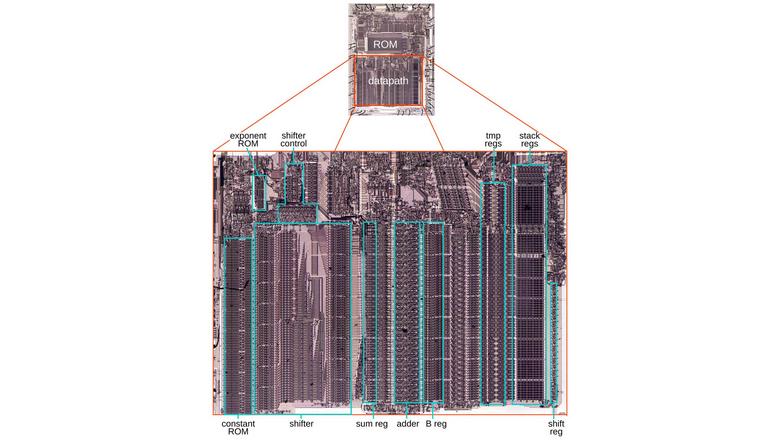
Изучив цепи и микрокод 8087, я смог объяснить алгоритм команды вычисления тангенса FPTAN. Для исследования электросхемы 8087 я при помощи стамески снял с чипа крышку и сделал микроскопом снимок высокого разрешения. ROM микрокода — это большая прямоугольная область в центре кристалла, содержащая 1 648 управляющих чипом микрокоманд. Нижняя часть чипа (в красном прямоугольнике) — это тракт данных: цепь, выполняющая вычисления с плавающей запятой над 80-битными значениями3.

На увеличенном снимке тракта данных видны соответствующие функциональные блоки. В exponent ROM хранятся значения экспонент, необходимые алгоритму. В constant ROM содержатся константы, в том числе и используемые алгоритмом CORDIC. Shifter (блок сдвига) — это большой компонент, выполняющий сдвиг 64-битного значения влево или вправо на произвольную величину. Adder (сумматор) — это ядро вычислений 8087; наряду с реализацией сложения и вычитания он применяется в цикле для умножения, деления и квадратных корней. В регистре B (B reg) хранится один из аргументов сумматора, а второй аргумент может браться из нескольких источников. В sum register хранится вывод сумматора. В восьми стековых регистрах и временных регистрах хранятся числа с плавающей запятой. Наконец, в сдвиговом регистре (shift reg) хранятся 16 бит состояния для вычислений CORDIC.

Читать далее

Полоски, квадратики и точки. Как работают штрихкод, QR и Data Matrix

Уровень сложностиСредний
Время чтения19 мин
Охват и читатели11K

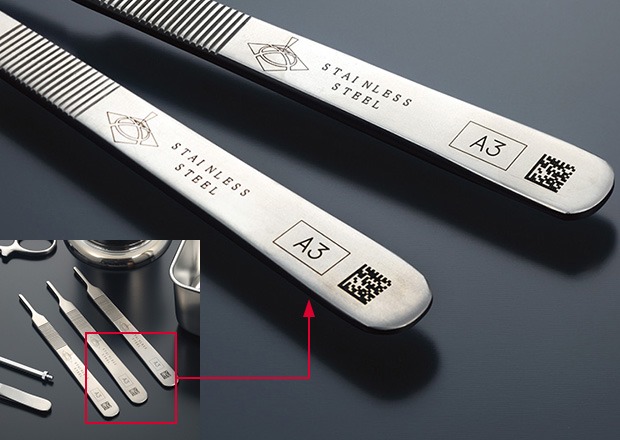
Несколько десятков черных полос когда-то изменили мировую торговлю: кассиру больше не нужно было вручную вводить цену каждого товара, а магазины впервые получили возможность автоматически учитывать огромные потоки продукции. Потом полоски превратились в квадраты, информации стало помещаться значительно больше, а поврежденный код научился восстанавливаться буквально по оставшимся кускам. К торговле добавилась логистика, медицина, реклама и еще сотня разных отраслей. Разберемся, как устроены линейные штрихкоды, QR и Data Matrix, чем они отличаются и какие задачи решают.

И почему на молоке именно Data Matrix? Все ответы ниже.

Читать далее

Как мы в AI VK рекомендации на стримы делили

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели8.2K

Привет! Это Иван Воробьев, ведущий инженер отдела базового качества рекомендаций в VK Видео (AI VK). 

Эта статья — про механизм рекомендаций, который мы называем стримами. Он появился из довольно обычной инженерной ситуации: рекомендательный пайплайн решал сразу несколько разных задач, что приводило к нетривиальным взаимосвязям, и со временем улучшать элементы системы по отдельности стало трудно. Продуктовой фичей стримы при этом не назовёшь: для пользователя изменения не должны быть видны. Ценность другая — командам становится проще дорабатывать отдельные составляющие рекомендаций, не задевая соседние.

С помощью стримов мы разделили один большой пайплайн на несколько специализированных поменьше, у каждого из которых своя задача и своя конфигурация. В рекомендациях VK Видео этот подход уже внедрили, а затем через платформу сделали доступным и для других продуктов.

Подробнее под катом

Применение физически информированных нейронных сетей (PINN) в пучковых нейросетях на графах

Уровень сложностиСложный
Время чтения16 мин
Охват и читатели7.8K

Привет, Хабр! Мы студенты мастерской по сервисам и платформам ИИ Инженерно-математической школы НИУ ВШЭ и VK: Ксения Белькова, Тимур Лиджиев и Мария Стеблий. В этой статье хотим рассказать об исследовании, в котором изучали, можно ли применять физически информированные нейронные сети (PINN) для аппроксимации диффузионных процессов в графовых нейронных сетях на пучках.

Исследование мы проводили совместно с Александром Таракановым, инженером машинного обучения AI VK и доцентом ФКН НИУ ВШЭ. В статье расскажем о подходе, проведенных экспериментах и полученных результатах.

В экспериментах PINN показал точность на уровне других методов и позволил сократить время инференса. Значит, PINN может быть полезен для ускорения работы моделей, но его влияние на качество классификации нужно изучить отдельно.

Читать далее
1
23 ...