Обновить
512K+

Python *

Высокоуровневый язык программирования

352,62
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Асинхронный файловый api-сервис

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели13K

Идея написать данную статью родилась после моего фейла по разработке данного сервиса. Суть задачи была проста — написать сервер с базовыми методами сохранения и отдачи файлов и сервисными методами по специфичной обработке файлов. Обмен данными (тело запроса, возвращаемые данные) я реализовал через json, про асинхрон идею упустил. По началу всё было хорошо, файлы не превышали размер нескольких мегабайтов, методы использовались редко. Но буквально через пару месяцев размеры файлов стали измеряться десятками мегабайт, количество запросов сотни в минуту. Сервис стал тормозить, возникали ошибки совместного доступа к файлам. «Никогда Штирлиц не был так близок к провалу».

В этом кейсе я покажу как я переписал код сервиса.

Читать

Пишем простой ML веб-сервис на FastAPI

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели28K

Данный туториал пошагово разбирает процесс создания веб-приложения для определения тональности текста на основе NLP-модели.

Мы будем использовать модель из библиотеки Hugging Face Hub, но описанный подход подойдет для любой задачи машинного обучения.

План:

1. Загрузка и подготовка модели машинного обучения для использования в веб-сервисе.

2. Создание веб-сервиса с помощью FastAPI.

3. Изучение пользовательского интерфейса FastAPI для удобного ручного тестирования и демонстрации работы приложения.

4. Написание автоматических тестов с помощью библиотеки pytest.

5. Запуск приложения в Docker-контейнере.

Код доступен на GitHub.

Читать далее

Real-time аналитика в Учи.ру: как смотреть сложные метрики

Время на прочтение8 мин
Охват и читатели3.2K

Привет, Хабр! Меня зовут Андрей Скиба и я Python-разработчик в ML-команде Учи.ру. Разным командам в нашей компании важно получать доступ к ключевым метрикам пользователей (количество сессий, DAU и другим) в режиме реального времени. Поэтому мы создали свою собственную систему real-time аналитики — быструю, простую и с удобным для нас функционалом. Сегодня я расскажу, как она устроена. 
Читать далее

Простой способ развернуть телеграмм бота с Aiogram + Webhook на хостинг

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели28K

Расскажу самый простой и бесплатный способ развернуть на хостинге телеграмм бота, написанного на aiogram и перевести на webhook. Посмотреть видео-версию, которую я разместил, можно на https://youtu.be/Gw-cVvsaOGE .

Бот будет работать 24/7 пожизненно.

Без использования VPS, фреймворка (django, flask, fastapi,..), pythonanywhere и heroku.

Краткое содержание действий:

Пункт 1. Сохранить пример к себе, регистрация на хостинге.

Пункт 2. Через FTP поместить наш файл бота на хостинге.

Пункт 3. Через SSH установить библиотеку aiogram.

Пункт 4. Настроить сервис бота на хостинге.

Пункт 5. Настроить веб-сайт на переадресацию всех запросов на сервис бота.

Пункт 6. Отредактировать файл запуска бота с учетом наших настроек.

Пункт 7. Перезапуск сервиса бота, проверка бота. Просмотр логов.

________________________________________________________

Пункт 1. Сохранить пример к себе, регистрация на хостинге.

Идем на страницу официальной документации:

https://docs.aiogram.dev/en/v2.25.1/examples/webhook_example.html

Копируем содержимое webhook_example.py к себе в файл webhook.py и сохраняем.

Читать далее

Простая очередь задач в Django, подключение Kandinsky 2.1

Время на прочтение8 мин
Охват и читатели4.8K

Большинство разработчиков рано или поздно сталкивается с необходимостью реализовать очереди выполнения, сложных вычислительных процессов. Изобилие готовых решений, позволяет выбрать именно то что вам нужно в вашем текущем задании.

Читать далее

Как подключить платежную систему с Payments к Telegram

Время на прочтение6 мин
Охват и читатели80K

Telegram-боты позволяют решать самые разные задачи. С помощью них можно автоматизировать рабочие процессы. В статье показываем, как разработать бота для приема платежей и развернуть его на облачном сервере.
Читать дальше →

Пакетное тестирование скоринговых моделей

Время на прочтение4 мин
Охват и читатели1.5K

Всем привет! Сегодня мы, риск-технологи банка «Открытие» Илья Мясников (@berrim0r) и Гевонд Асадян (@Gevond), расскажем, каким образом осуществляем тестирование моделей оценки кредитного риска перед выводом в прод. В прошлой статье про дублирующий проверочный скрипт мы рассказали о том, как мониторим корректность выведенной в прод модели. Но проверок же много не бывает! Перед выводом модели в прод нужно удостовериться, что выводимый функционал работает корректно.

Как проверить корректность расчета модели? Ну да, верно – скормить ей входные данные со строго определенными параметрами. Звучит не очень сложно, правда? А если факторов более полутора сотен? И часть из них оказывают влияние только при определенном взаимодействии с другими факторами? Такое количество вариантов входных данных вручную придется готовить не один день.

Поэтому мы придумали как упростить для себя подобное тестирование. Для этого решили разработать сервис, который позволяет генерировать все возможные комбинации входных данных для модели на основании одного или нескольких заданных входных векторов.

Дальше — больше

Создай своего ИИ-ассистента с помощью ChatGPT и Streamlit

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели64K

Автор: Дмитрий Косаревский

Привет, Хабр! ?

Меня зовут Дима Косаревский, я инженер данных (DE), увлеченный Data Science и всем, что связано с этим направлением.
Data Science позволяет извлекать ценную информацию из огромных объемов данных при помощи статистических и вычислительных методов.

В последнее время эти ИИ, вроде ChatGPT, врываются прямо во все сферы. И вот благодаря увлечению Data Science можно использовать этих ботов, чтобы помогать людям, да ещё и пообщаться с ними на разные темы. Здорово, правда?

ChatGPT действительно впечатляет. Он не только общается на разные темы, но еще и стихи сочинять умеет.
Вот один из примеров, которые я получил недавно:

Поехали 🚀

Тайна исчезающих сообщений: зачищаем Telegram в автоматическом режиме

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели9.4K

На фоне новости о датасатанисте, который "клонировал" своих друзей в цифровое пространство, обучив LLM на 500.000 сообщений в групповом чате (на самом деле не только, но причину каждый найдёт для себя сам), будем кормить паранойю и пошагово разбираться, как же уничтожить свой "цифровой след" в мессенджере Telegram.

Читать далее

403, 404 или 405. Разбираемся со статусами во ViewSet’ах DRF

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели5.2K

Идея делать нормальный REST на Django – утопия, но некоторые моменты настолько логичные и нет одновременно, что об этом хочется писать. Ниже история про то, как мы сделали ViewSet от GenericViewSet и пары миксинов в DRF, покрыли это все тестами и получили местами странные, но абсолютно обоснованные коды ответов.

Текст может быть полезен новичкам (или чуть более прошаренным) в Django, дабы уложить в голове формирование url’ов и порядок вызова методов permission-классов. Ну а бывалые скажут, что все это баловство и надо было использовать GenericApiView.

Читать далее

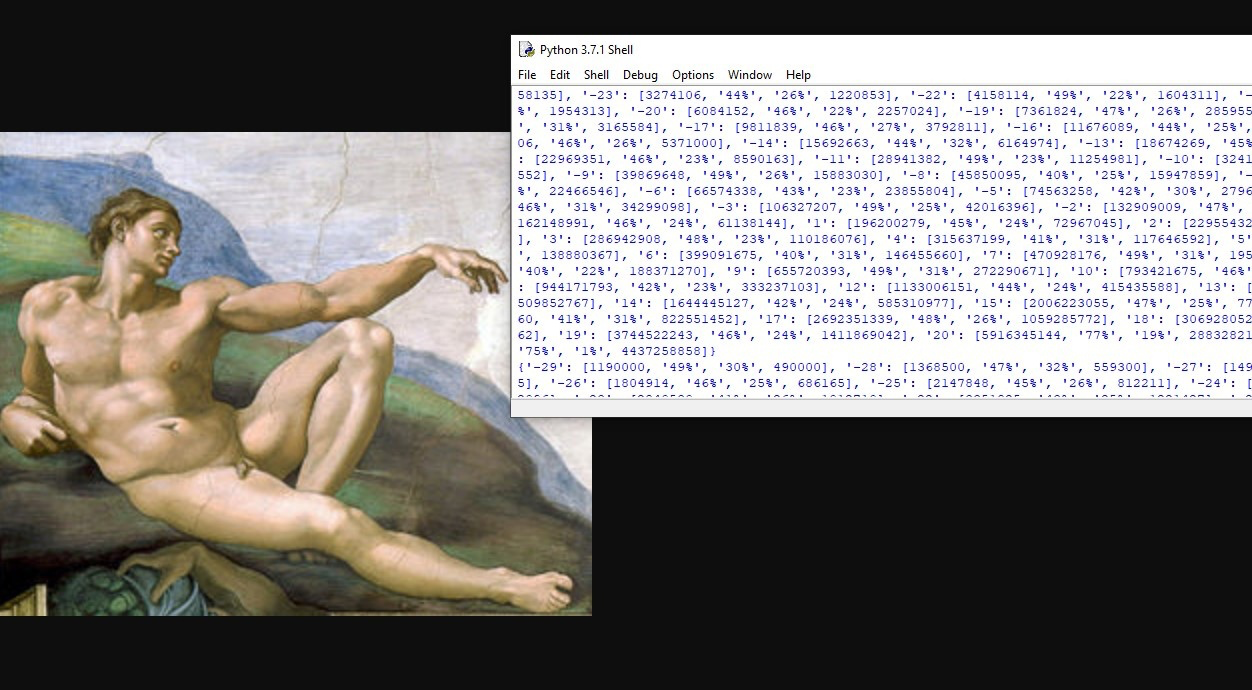
Проверяем ветхозаветную историю происхождения человечества от Адама и Евы с помощью популяционной модели

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели19K

Помню, как несколько лет назад сидел на последнем ряду аудитории и слушал лекцию по теории эволюции. Тогда мне это было особенно интересно: каждый вечер я штудировал доклады Дробышевского, Соколова, Панчина, Гельфанда и других причастных к Антропогенезу. И в один день преподаватель сердито посмотрела в окно и спросила меня, как долго должны ходить по газону люди, чтобы образовалась тропа.

На этот странный вопрос я ответить не смог, но он меня неожиданно натолкнул на идею для любопытного эксперимента. Зачем изучать тропообразовательный потенциал людей, когда можно построить симуляцию и проверить теологическую теорию о самом происхождении человечества. Мне стало интересно, может ли человечество развиться до 11 млрд со времен Адама и Евы к концу XXI века. О том, что из этого получилось, рассказываю под катом.
Читать дальше →

Геопространственные технологии для управления паспортом медицинского участка

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели3.1K

Все началось с голосовых роботов. Во время борьбы с Ковидом наш коллцентр, носящий теперь гордое имя Центр телефонного обслуживания граждан 122, все чаще и чаще выстраивал очереди со временем ожидания ответа оператора свыше 30 минут. Нанять больше людей и начать стабильно укладываться в норматив ответа оператора менее 3-х минут не позволяли размеры помещения и фонда оплаты труда.

Стали пробовать решения для автоматизации контакт центров, которые можно было бы интегрировать с медицинской информационной системой (МИС). За 3 месяца пилотирования NLP продукта и его интеграции действующие в бизнес-процессы удалось добиться вменяемых результатов по распознаванию номеров медицинских полисов, адресов проживания и имени пациентов. Даже удалось удержать среднее время обслуживания одного звонка на уровне 100 секунд… Однако процент автоматических обслуженных обращений болтался в диапазоне от 11 до 30 процентов, и пациенты продолжали томится в ожидании ответа оператора.                      

Виной низкой эффективности проекта роботизации коллцентра послужило состояние адресной базы МИС и серьезные различия в бизнес правилах бюджетных медицинских учреждений. Мы с вами часто меняем место жительства и ни перед кем за это не отчитываемся. Строительные компании увлечены реновацией и на месте ветхих бараков, гаражных кооперативов или промышленных пустошей появляются многоэтажки, о заселении которых медицинские организации узнают по телефону, когда нам требуется врач. Про оперативное информационное взаимодействие органов внутренних дел, управлений архитектуры и органов охраны здоровья остается только мечтать.

Читать далее

Связь Django и PostgreSQL внутри Docker

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели45K

Приветствую всех!

Предполагаю, что если вы нашли эту статью, то уже знакомы с процессом установки Docker и использования Django, поэтому не буду расписывать их детально.

Я работаю на windows, поэтому если у вас другая операционная система, то команды могут отличаться.

Читать далее

Ближайшие события

Тестирование python3-расширения для GIMP

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели3.1K

Графический редактор GIMP предоставляет широкие возможности для создания расширений на языках программирования Scheme (функциональный язык, сходный с LISP) или Python. Для доступа к системным операциям и регистрации собственных действий используется общий реестр Procedural Database (PDB), через который можно выполнять любые действия со встроенными механизмами GIMP (например, создание изображения). В этой статье мы рассмотрим основы создания расширений на Python 3 и возможные подходы к тестированию расширений через PDB.

Читать далее

Как ChatGPT в блокчейн игру играл

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели2.2K

В данной статье рассмотрим процесс создания прототипа бота с использованием ChatGPT 3.5 API от OpenAI для участия в текстовой игре Great Wyrm на блокчейне, разработанной Moonstream.to.

Great Wyrm представляет собой платформу для организации игровых сессий в формате "гейм-мастер - игроки". В настоящее время игра находится на стадии активного тестирования, и создатели платформы самостоятельно проводят игровые сессии.

Код будет написан на языке Python. Так как игра разработана на базе блокчейна Ethereum, для взаимодействия с сетью мы будем использовать библиотеку brownie, а для генерации Python-интерфейса из ABI - библиотеку moonworm.

Читать далее

Пишем полезный сервис на Python для получении ИНН

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели15K

В этой статье хочу рассказать о том, как написать полезный сервис, для получения ИНН по персональным данным (паспортные данные). ИНН физического лица получаем с использование сайта https://service.nalog.ru/. Похожая функциональность, скорее всего, уже где-то и кем-то была реализована. Основная идея статьи - поделиться опытом работы с Python в части создания законченного проекта с использованием контейнера зависимостей, создания слушателей для RabbitMQ и работой с базой данных MongoDB. Работа с клиентами сервиса реализована через RabbitMQ в режиме непрерывного чтения очереди, отправкой результата в выходную очередь. Сервис будет жить в Kubernetes, что требует наличие liveness и readiness проб. Для этого используется веб-сервер.

Читать далее

Полезные TreeMap визуализации для MSSQL, Postgres и MySQL

Уровень сложностиСредний
Время на прочтение3 мин
Охват и читатели11K

Я очень люблю визуализации. Человек лучше всего воспринимает информацию через образы. Для трех часто встречающихся баз (MSSQL, Postgres и MySQL) я смастерил плагины к проекту Bell, хотя этот код на Python можно использовать и отдельно. Поэтому для каждой визуализации я буду в скобочках писать имя файла из репозитория GitHub - вы можете этот файл вытащить и использовать его отдельно от проекта (для этого нудны минимальные модификации).

Отмечу только, что я считаю себя экспертом только в MSSQL, а то что сделал с другими базами - сделал по наитию. Кроме того, в отличие от MSSQL у меня нет реальных баз под большой нагрузкой для Postgres и MySQL. Поэтому ошибки/пожелания для скриптов Postgres и MySQL очень и очень welcome!

В основном я задействовал TreeMap.

Читать далее

BlackMamba или как ChatGPT пишет вредоносы

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели14K

Скорее всего не для кого уже не новость, что ChatGPT от OpenAI способен не только генерировать статьи, идеи, писать код вместо разработчика, но также писать всякого рода вирусы и прочие вредоносные программы. Специалисты кибербезопасности из компании Hyas решили продемонстрировать, на что способно вредоносное программное обеспечении на основе ChatGPT.

По итогу получился интеллектуальный вирус, способный сам принимать решения и генерировать концы своего исходного кода, который не обнаруживают антивирусные решения.

Я решил сам убедиться, возможно ли такое, и вот что вышло.

Читать далее

Экспресс-анализ данных на Python

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели9.1K

В рамках расширения своих компетенций периодически провожу анализ данных датасетов. В какой-то момент осознал, что трачу время на столбцы с аналитиками, в которых все в порядке. Данные полные, тип данных единый, интерпретация понятна. Если столбцов несколько десятков, то обзорная проверка атрибутов каждого столбца занимает довольно значительное время.

Читать далее

Регрессионный анализ в DataScience. Часть 3. Аппроксимация

Уровень сложностиСредний
Время на прочтение72 мин
Охват и читатели26K

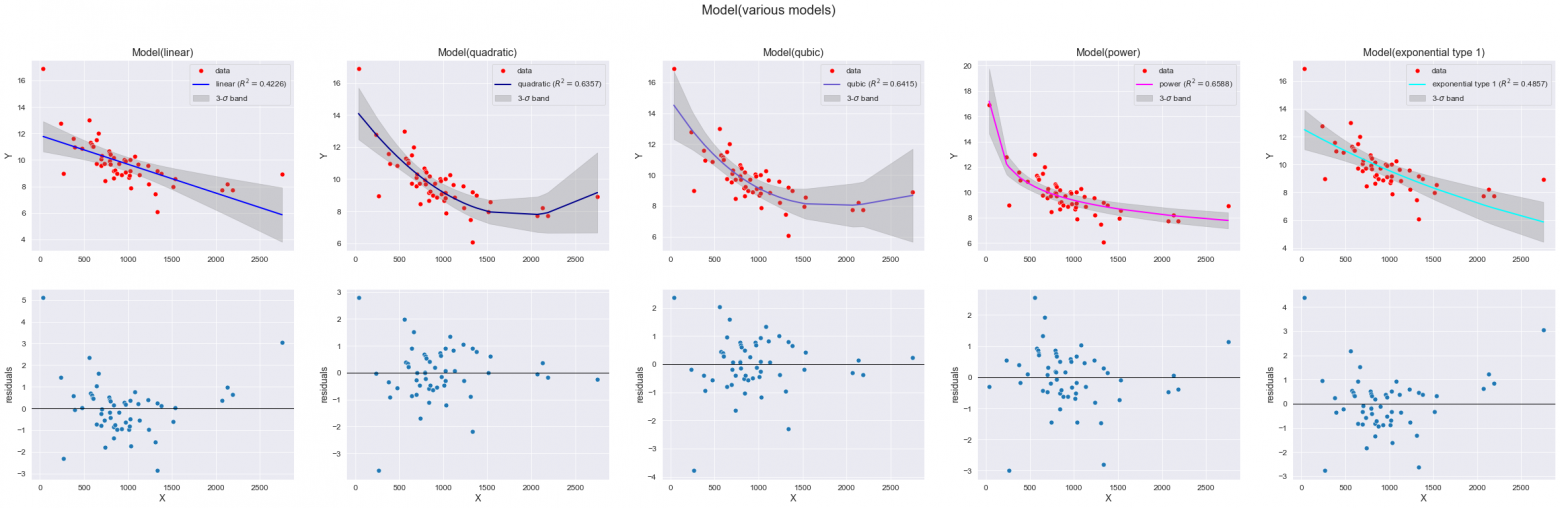
В предыдущих обзорах (https://habr.com/ru/articles/690414/, https://habr.com/ru/articles/695556/) мы рассматривали линейную регрессию. Пришло время переходить к нелинейным моделями. Однако, прежде чем рассматривать полноценный нелинейный регрессионный анализ, остановимся на аппроксимации зависимостей.

Про аппроксимацию написано так много, что, кажется, и добавить уже нечего. Однако, кое-что добавить попытаемся.

При выполнении анализа данных может возникнуть потребность оперативно построить аналитическую зависимость. Подчеркиваю - речь не идет о полноценном регрессионном анализе со всеми его этапами, проверкой гипотез и т.д., а только лишь о подборе уравнения и оценке ошибки аппроксимации. Например, мы хотим оценить характер зависимости между какими-либо показателями в датасете и принять решение о целесообразности более глубокого исследования. Подобный инструмент предоставляет нам тот же Excel - все мы помним, как добавить линию тренда на точечном графике:

Читать далее