Обновить
256K+

Python *

Высокоуровневый язык программирования

331,93
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как мы не смогли создать медицинского чат-бота. История проекта, который так и не увидел свет

Время на прочтение19 мин
Охват и читатели10K

Привет, 

Это статья нашего бывшего коллеги, Андрея Лукьяненко, который работал над проектом по созданию медицинского чат-бота. Андрей покинул нашу компанию по собственному желанию (и с большим сожалением для нас), но несмотря на это, мы решили опубликовать его материал. Мы уверены, что эта статья будет полезна всем, кто работает над созданием специализированных чат-ботов. 

Итак, передаем слово Андрею Лукьяненко, бывшему техлиду MTS AI.

В последние годы рынок телемедицины (дистанционных медицинских услуг) и в целом медтеха активно растет, и пандемия коронавируса только ускорила его развитие. Такие технологии востребованы, потому что они относительно дешевы, доступны вне зависимости от места проживания пациента и дают возможность самостоятельно выбирать врачей. 

Читать далее

Почему мы перешли с Python на Go

Время на прочтение9 мин
Охват и читатели34K

Поставщик высоконагруженного API Stream перешёл с Python на Go, хотя этот язык знают немногие. Причинами решения делимся под катом к старту курса по Backend-разработке на Go.

Читать далее

Визуализируем данные из xml в виде социальной сети

Время на прочтение6 мин
Охват и читатели4.4K

Если у Вас есть данные о связях людей в XML формате, то пора применять графовую аналитику.

Читать далее

Переписываем API тесты

Время на прочтение9 мин
Охват и читатели37K

Попробуем в несколько итераций написать API тесты на Python и рассмотрим типичные ошибки, с которыми можно столкнуться.

Читать далее

Как работать с PyScript — фреймворком для фронтенда на Python

Время на прочтение6 мин
Охват и читатели63K

В веб-разработке Python используется в основном на бэкенде с такими фреймворками, как Django и Flask. А сегодня, к старту курса по Fullstack-разработке на Python, расскажем о PyScript, который даёт возможность запускать Python прямо в HTML.

Читать далее

Как сделать свою рекомендательную систему: история одной дипломной работы

Время на прочтение7 мин
Охват и читатели22K

Каждая дипломная работа в Практикуме — самостоятельный проект. Здесь нет подробных вводных или подсказок — студенты сами ищут решения и пробуют разные подходы. И здесь нужны все знания, которые накопились за время прохождения курса, а может, даже чуть больше. Звучит серьёзно, но студентов трудности не останавливают. В этой статье расскажем, как команда выпускников курса «Мидл Python-разработчик» создала рекомендательную систему для онлайн-кинотеатра с нуля.

Читать далее

Скачивание любого сайта с помощью Python себе на компьютер

Время на прочтение3 мин
Охват и читатели23K

Здравствуйте!

Сегодня я Вам расскажу про интересную библиотеку для Python под названием Pywebcopy.

​PyWebCopy – бесплатный инструмент для копирования отдельных веб-страниц или же полного копирования сайта на жесткий диск.

Читать далее

Советы, которые могут спасти Вас от ужасов PyYAML

Время на прочтение5 мин
Охват и читатели24K

YAML - это широко используемый язык сериализации данных. Все разработчики сталкиваются с необходимостью обработать YAML время от времени. Но обработка YAML, особенно с использованием PyYAML в Python, мучительна и полна ловушек. Здесь изложены некоторые советы, которые могут облегчить Вашу жизнь с PyYAML.

Читать далее

Еще раз о KISS и трендах

Время на прочтение4 мин
Охват и читатели13K

Последние несколько лет async вообще и asyncio в частности в питоне все больше набирают популярность и их все чаще используют. При этом иногда забывают о принципе KISS (Keep it simple, stupid) и о том, какие вообще проблемы решает асинхронный код и зачем он нужен. В этой статье я бы хотел описать пример, когда задачу можно и, на мой взгляд, нужно решать без использования async. И вообще, практически без всего.

Читать далее

Рейтинг русскоязычных энкодеров предложений

Время на прочтение9 мин
Охват и читатели54K

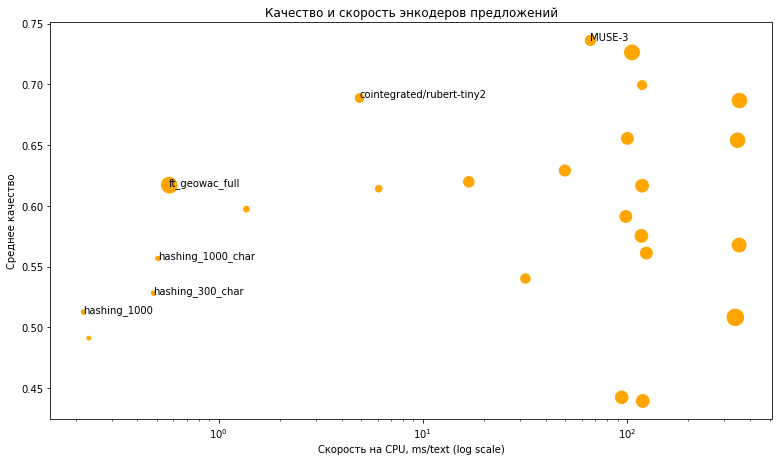
Энкодер предложений (sentence encoder) – это модель, которая сопоставляет коротким текстам векторы в многомерном пространстве, причём так, что у текстов, похожих по смыслу, и векторы тоже похожи. Обычно для этой цели используются нейросети, а полученные векторы называются эмбеддингами. Они полезны для кучи задач, например, few-shot классификации текстов, семантического поиска, или оценки качества перефразирования.

Но некоторые из таких полезных моделей занимают очень много памяти или работают медленно, особенно на обычных CPU. Можно ли выбрать наилучший энкодер предложений с учётом качества, быстродействия, и памяти? Я сравнил 25 энкодеров на 10 задачах и составил их рейтинг. Самой качественной моделью оказался mUSE, самой быстрой из предобученных – FastText, а по балансу скорости и качества победил rubert-tiny2. Код бенчмарка выложен в репозитории encodechka, а подробности – под катом.

Читать далее

Как написать средство проверки орфографии кхмерского языка

Время на прочтение8 мин
Охват и читатели3.3K

Материалом с подробностями о реализации средства проверки и исправления орфографии кхмерского языка, основного в Камбодже, делимся к старту флагманского курса по Data Science.

Читать далее

Pandas vs dask vs sqlite на raspberry pi

Время на прочтение7 мин
Охват и читатели4.5K
Возникла необходимость поработать с базой штрихкодов (barcode) на одноплатнике raspberry pi. Задача простая — открыть базу данных (~700 Мб), найти штрихкод и сделать это «достаточно быстро». Как оказалось, эти действия могут вылиться в захватывающее путешествие как в части того, как в базе быстро найти нужный код, так и в части того, как эту базу быстро открыть, чтобы найти. В работе помогали фреймворки pandas, dask, а также инструмент sqlite. Кто из них справился и какие есть нюансы — в данной статье.
Читать дальше →

Обзор книги «Секреты Python. 59 рекомендаций по написанию эффективного кода»

Время на прочтение3 мин
Охват и читатели7.6K

Всем доброго времени суток!

Публикую рецензию подписчика нашего телеграмм-канала IT-старт на книгу "Секреты Python. 59 рекомендаций по написанию эффективного кода" от автора Бретта Слаткина

Краткая, тезисная, но емкая рецензия.

Основные темы книги:

— Действенные рекомендации по основным аспектам разработки ПО с использованием версий Python 3.x и 2.x, дополненные подробными описаниями и примерами.

— Лучшие методики написания функций, снижающие вероятность появления ошибок в коде.

— Точное описание вариантов поведения с помощью классов и объектов. — Рекомендации относительно того, как избежать скрытых ошибок с помощью метаклассов и динамических атрибутов.

— Эффективные подходы к решению проблем, связанных с одновременным и параллельным выполнением множества операций.

— Усовершенствованные приемы работы со встроенными модулями Python.

— Инструментальные средства и лучшие методики коллективной разработки.

— Решения по отладке, тестированию и оптимизации кода.

Книгу  мне порекомендовал мой друг и коллега. Добрался до данной книги я не сразу, но исходя из совета моего товарища, прочитал.

Стоит ли читать книгу?

Хочу сэкономить вам ваше время.  Данную книгу я не рекомендую к чтению. Некоторые советы вызывают у меня сомнения, что-то нового и прям "вау", я также не узнал. Сложилось также впечатление, что никаких "секретов" тут нет.

Сразу хотелось бы заметить, что я в целом не фанат технической литературы, так как подобная литература отлично подходит для поверхностного и беглого просмотра темы, но читать такие книги "от корки до корки" - дело не из легких.

Читать далее

Ближайшие события

Прокладываем тропинки до микросервисов

Время на прочтение8 мин
Охват и читатели21K

Одна из наиболее важных задач при разделении системы на микросервисы - обеспечить надежный механизм их репликации и обнаружения и создать набор правил для маршрутизации входящих запросов к соответствующим контейнерам или сетевым узлам. Идеальная система также должна уметь отслеживать состояние доступности и исключать недоступные реплики из маршрутизации. В этой статье мы поговорим об использовании маршрутизатора Kong, который принимает на себя не только задачи умной маршрутизации, но и возможности по протоколированию и трансформации запросов, контролю доступа, мониторингу запросов, а также может быть расширен с использованием плагинов.

Читать далее

Анализируем речь с помощью Python: Как и о чем говорят на YouTube-канале «вДудь»?

Время на прочтение8 мин
Охват и читатели21K

Выход практически каждого ролика на канале «вДудь» считается событием, а некоторые из этих релизов даже сопровождаются скандалами из-за неосторожных высказываний его гостей.

Сегодня при помощи статистических подходов и алгоритмов ML мы будем анализировать прямую речь. В качестве данных используем интервью, которые журналист Юрий Дудь (признан иностранным агентом на территории РФ) берет для своего YouTube-канала. Посмотрим с помощью Python, о чем таком интересном говорили в интервью на канале «вДудь».

Читать далее

Как с помощью Python создать приложение для расшифровки речи в реальном времени

Время на прочтение6 мин
Охват и читатели26K

Научить ИИ разговаривать шёпотом — непростая задача даже сегодня. Но мы покажем, насколько простыми стали распознавание и транскрипция речи, по крайней мере, на поверхности. Интересно? Тогда добро пожаловать под кат.

Читать далее

Как ускорить Python с помощью C-расширений. Часть 2

Время на прочтение10 мин
Охват и читатели6.2K

Привет, Хабр! Меня зовут Игорь Алимов, я ведущий разработчик группы Python в МТС Digital, и это вторая часть статьи, посвященной тому, как писать быстрый код на Python с использованием C-расширений. Я расскажу о всех нюансах и приведу конкретный пример применения этого метода.

Первую часть статьи читайте здесь, чтобы увидеть продолжение – переходите под кат!

Читать далее

Собираем генератор данных на Blender. Часть 2: Камера

Время на прочтение5 мин
Охват и читатели6.9K

Всем привет! На связи Глеб, в предыдущей статье мы рассмотрели работу с объектами на Blender. Но для того, чтобы создать минимально жизнеспособный генератор, нужно разобраться в том, как работают камеры.

Читать далее

Как я дообучал Tesseract и что из этого получилось

Время на прочтение7 мин
Охват и читатели91K

Решал я как-то задачку по поиску сущностей в отсканированных документах. Чтобы работать с текстом, надо его сначала получить из картинки, поэтому приходилось использовать OCR. Выбор пал на одну из самых популярных и доступных библиотек Tesseract. С ее помощью задача решается очень неплохо и процент распознавания текста достаточно высокий, особенно на хороших сканах. Но нет предела совершенству, а так же ввиду наличия большого количества документов сомнительного качества, поулучшав пайплайн разными методами, было принято решение попробовать улучшить и сам тессеракт.

Инструкция от разработчиков https://tesseract-ocr.github.io/tessdoc/Home.html не всегда сразу понятна и очевидна, поэтому и появилась мысль записать свой опыт в эту статью.

У меня на компьютере стоит Linux Mint 20.2 Cinnamon, поэтому все действия происходят в этой системе и я не могу гарантировать, что все получится точно так же в Windows или Mac.

Для начала необходимо установить бибилиотеку tesseract на компьютер. Делается это достаточно просто. Сначала проверю версию, которая уже установлена (как правило в комплекте с Linux уже есть пакет tesseract). В терминале набираем

Читать далее

Компьютерное зрение в поиске атмосферных осадков

Время на прочтение4 мин
Охват и читатели3.1K

Компьютерное зрение решает задачи поиска, отслеживания и классификации объектов в самых разнообразных областях: промышленности, медицине, сфере безопасности. Одно из возможных новых применений компьютерного зрения — выявление атмосферных осадков при помощи видеокамер наружного наблюдения. О том, как можно реализовать такой алгоритм и поговорим в этом посте.

Читать далее