Обновить
38

Пользователь

0,1
Рейтинг
1
Подписчики
Отправить сообщение

Говорим с Битрикс24 на языке ИИ: представляем опенсорс MCP-сервер для LLM-интеграции

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели7K

Привет! Мы — партнеры Битрикс24 и создаем для бизнеса приложения с генеративным ИИ, интегрируя их с корпоративными порталами.

В этой статье мы расскажем о созданном нами решении, которое позволяет любым разработчикам легко подключать свои чаты и другие приложения с LLM-моделями к Битрикс24. Речь идет о MCP-сервере — помощнике для ИИ, который позволяет получать из портала Битрикс24, например из раздела CRM, точные данные для ответа пользователю.

Читать далее

Битрикс24 бенчмарк для оценки LLM

Уровень сложностиСредний
Время чтения32 мин
Охват и читатели6.4K

Картинка сгенерированая по запросу "сгенерируй картинку про битрикс24 и искусственный интеллект" неплохо отражает итоговые результаты

Читать далее

Разработка Битрикс-бота: история о том, как документация врала, а облака смеялись

Время чтения9 мин
Охват и читатели12K

Привет, Хабр! (И тебе, случайный читатель, который зашёл сюда просто потому, что заскучал в корпоративном чате.)

Сегодня я расскажу вам историю о том, какая задача посетила меня на этот раз и как я сделал «корпоративного бота с возможностью оценки сотрудников» — казалось бы, простая задача, но…

Читать далее

JS SDK Битрикс 24: что под капотом и какие планы

Уровень сложностиПростой
Время чтения6 мин
Охват и читатели3.4K

Привет! Меня зовут Сергей Востриков, я руковожу направлением Маркет и интеграций в Битрикс. Моя команда развивает решения для разработчиков тиражных решений и индивидуальных кастомизаций. Сегодня я хочу рассказать про наш новый официальный SDK под JavaScript для работы с REST API Битрикс24. Он опубликован в виде отдельного репозитория на Github и распространяется на условиях лицензии MIT. 

В этом посте — о принципах разработки SDK, наших планах по его обновлению и том, как можно повлиять на развитие инструмента. 

Читать далее

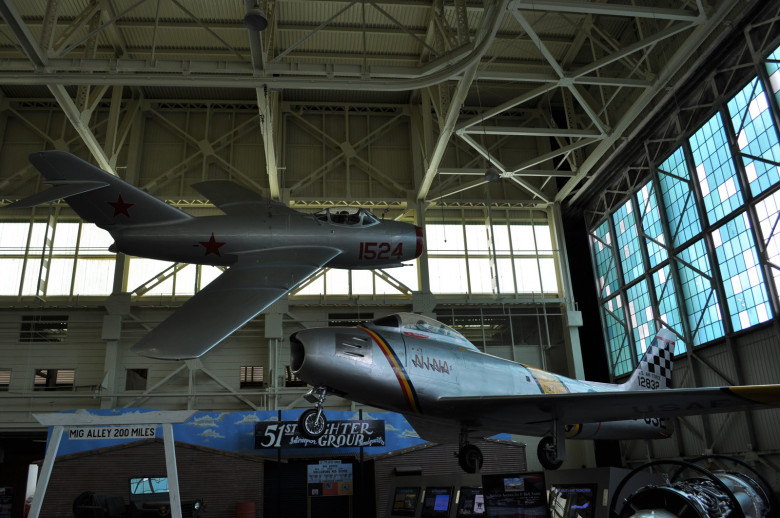
МиГ-15: самолёт, за которым Штаты охотились три года, а он прилетел к ним сам

Уровень сложностиПростой
Время чтения23 мин
Охват и читатели13K

Весной 1953 года американцы повесили над Кореей объявление: 100 тысяч долларов тому, кто пригонит целый МиГ-15. Ну как повесили, разбросали с самолётов 1,2 миллиона листовок на трёх языках, с подробной инструкцией: лететь к острову, держать 6100 метров, а если начнут стрелять, выпустить шасси и качать крыльями. За три месяца никто не прилетел, а в июле война закончилась.

А 21 сентября, уже после перемирия, на базу Кимпхо под Сеулом садится МиГ. По ветру, против всего потока, чуть не лоб в лоб со встречным бортом. Из кабины вылезает 21-летний лейтенант Но Кым Сок, и выясняется, что ни про листовки, ни про сто тысяч он не слышал. Он просто взял и улетел (???).

А двигатель у этого МиГа, между прочим, английский. Англичане сами продали его Сталину сразу после войны, а потом американцы три года пытались достать самолёт, который их же союзники помогли построить. Про него и статья, от чертежа до музея в Дейтоне: токарь из горного села и однокурсник Дассо, одноглазый испытатель, пушки на лебёдке и та самая посадка. Заваривайте чай, история длинная.

ding!

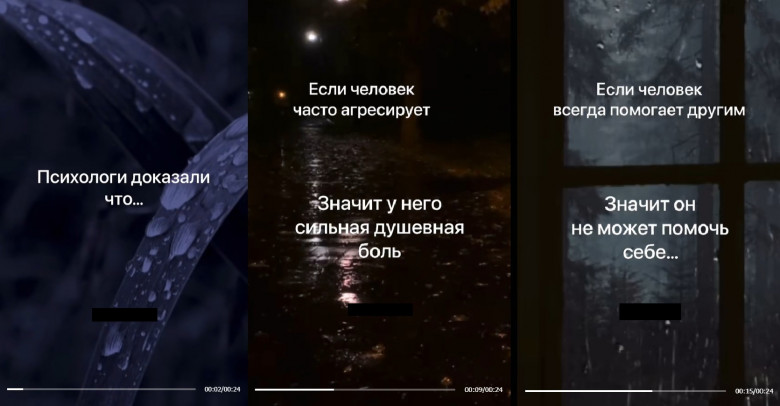
ТикТок-психология: польза за минуту или вред на годы?

Уровень сложностиПростой
Время чтения16 мин
Охват и читатели13K

С самого начала своей практики я периодически встречаю людей, которые «увлекаются психологией». Но если в условные доковидные времена это было из разряда «я стараюсь каждый месяц читать по одной психологической книжке», то сейчас гораздо чаще в кабинете звучит фраза «мне попался шортс %username%, которая говорила, что…». Иногда просто просят верифицировать информацию, иногда отстаивают её правильность, но чаще реализуется другой сценарий – человек пробует жить в согласии с этими принципами, разочаровывается в них, а потом идет к живому специалисту.

И мне бы хотелось разобрать этот феномен ТикТок-психологии, не скатываясь в очевидную и избитую мысль, вроде «да, там информация подается однобоко и неполно, но это лучше, чем ничего, ведь люди там что-то увидят, заинтересуются, а потом пойдут читать нормальные книжки или сами обратятся к психологу». В общем, если вы сами залипаете в психологические шортсы и рилсы или же вам ваш партнер что-то скидывает (эдакая семейная терапия репостами), или же вы видите, что кто-то слишком увлекся подобным контентом и с ним стало тяжело общаться – вам эта статья будет полезна.

P.S. я посмотрел более 10 часов этих роликов, которые листал буквально до тошноты (а она наступала минут через 10 от начала просмотра). Несомненно, это самая «выстраданная» из всех моих статей за всё время

Вообще не коротко

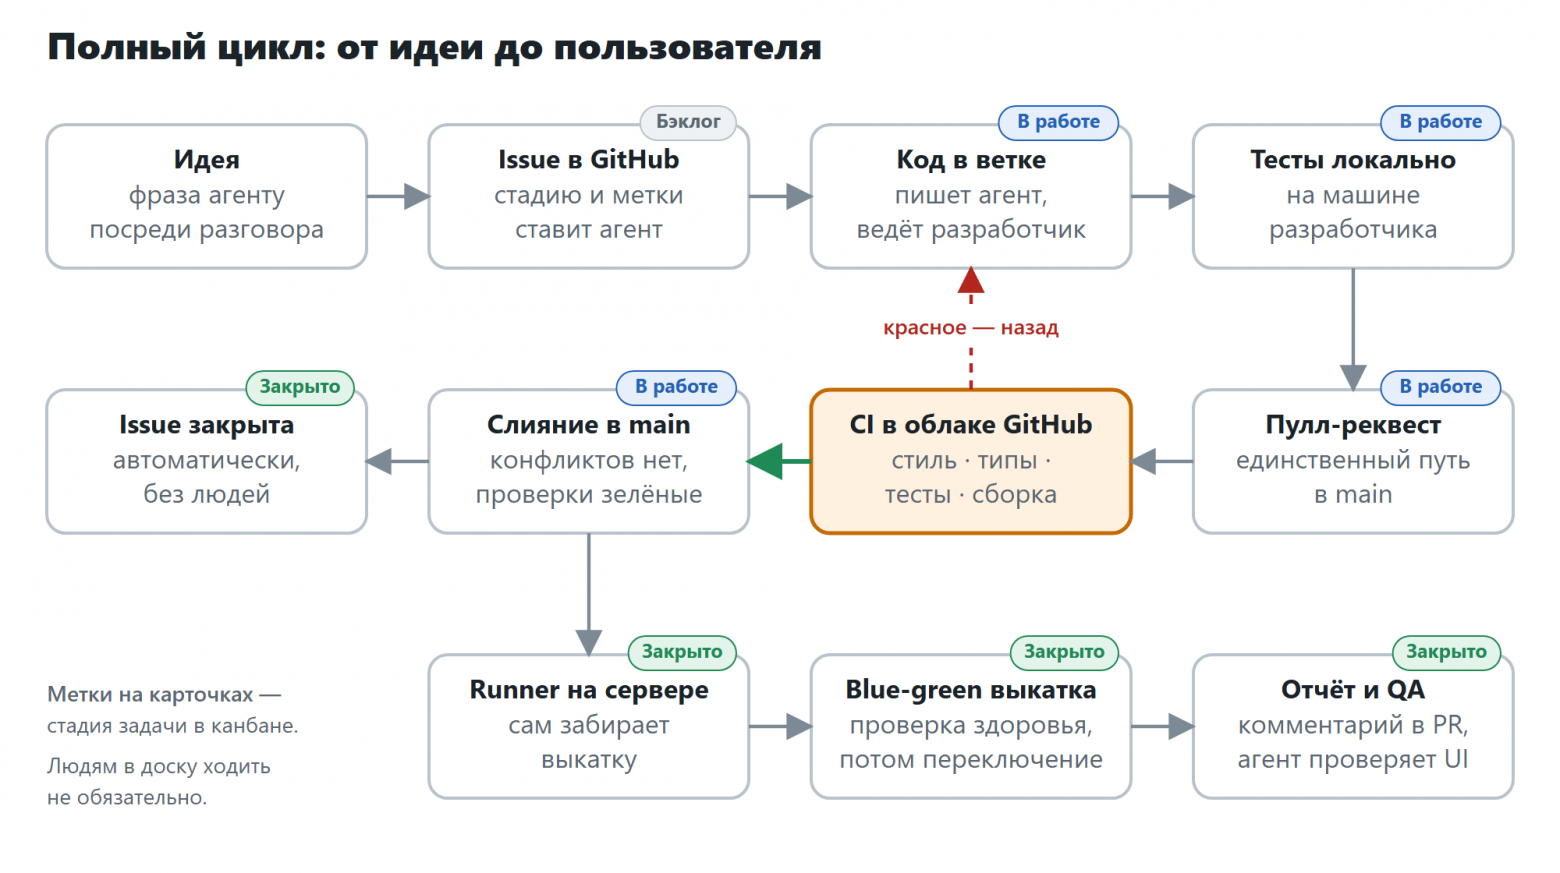
Конвейер, без которого AI не разгонится: как у нас код доезжает от идеи до продакшена

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели8.7K

Рынок сейчас охвачен одной светлой надеждой: купить подписку на нейросеть и наутро обнаружить, что команда стала работать вдвое быстрее. Надежда понятная. Примерно с той же надеждой покупают абонемент в спортзал.

Сначала честное предупреждение. Опытные команды с сильным техническим руководством, скорее всего, не найдут здесь ничего нового. Уникального тут нет: всё описанное давно известно и много где работает. Эта статья для тех, кто полноценный процесс разработки в своей компании или команде ещё не отстроил. Я делюсь практическим опытом, на котором у нас держится перевод команды разработки на AI-driven development — разработку, где код пишут AI-агенты под руководством разработчиков.

Нельзя внедрять автопилот там, где не отстроены дороги. Это как будто совершенно очевидная мысль, но почему-то в гонке за переходом на разработку кода AI-агентами про это часто забывают. Поэтому статья не про AI. Она про скучную часть: контроль версий, тесты, сборку, выкатку, бэклог. Тезис простой, как и в прочих материалах моего небольшого канала про AIDD: если технологического процесса нет, агент ускорит разработку ровно до первой ручной выкатки в пятницу вечером. Без конвейера нейросеть похожа на спорткар в утренней пробке: под капотом триста лошадей, а до офиса он доезжает одновременно с соседней малолитражкой.

Ниже — полный цикл на живом примере: от мысли «а хорошо бы…» до момента, когда изменение уже работает у пользователей, а они этого даже не заметили. Для выкатки это лучшая похвала.

Читать далее

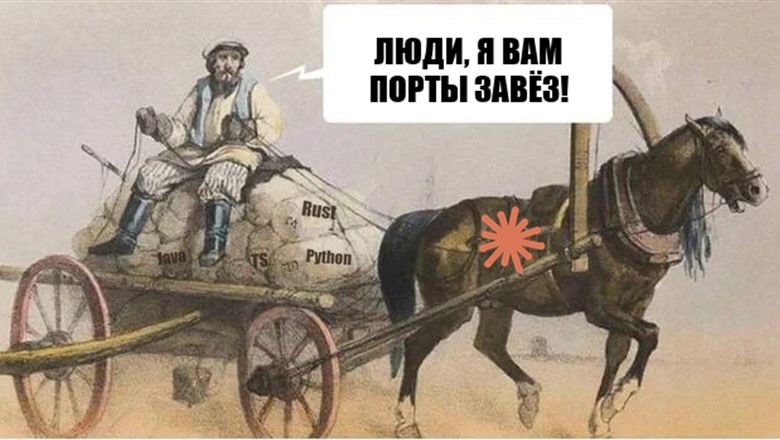
Какой язык быстрее? Сравнил 8 языков на одной задаче: Python догнал Rust, а Go проиграл даже Java

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели13K

Неделю назад я рассказывал на Хабре про z3l.FastHtmlParser — HTML-парсер для .NET, который вместо DOM строит плоский список тегов и разбирает страницу в 10–30 раз быстрее HtmlAgilityPack и AngleSharp. Тогда у него не было ни CSS-селекторов, ни XPath, и жил он только в .NET.

За неделю появились и CSS-селекторы, и XPath 1.0, а сама библиотека переехала ещё на семь языков: Go, Rust, Java, TypeScript, Python, PHP и Ruby. Это не «Hello world»: 6–11 тысяч строк в каждой реализации — токенизатор, правила необязательных закрывающих тегов из HTML5, все 2125 именованных сущностей, XPath 1.0 и CSS-селекторы. Алгоритм везде один и тот же, и каждый порт сверяется с оригиналом на одних и тех же страницах.

Получился эксперимент, который редко удаётся поставить: одна и та же настоящая задача, восемь языков, две ОС и один и тот же процессор. Значит, можно наконец ответить на вопрос, за который в комментариях убивают. Готовьте вилы.

Читать далее

Новый метод Concertina позволил уменьшить нейросеть Qwen3-4B в два раза для запуска на слабом железе

Время чтения3 мин
Охват и читатели91K

Исследователи предложили способ сжать большую языковую модель почти вдвое и сохранить около 85% ее качества, не тратя ресурсы на обучение с полного нуля. Полученная модель на 2,27 млрд параметров прошла дистилляцию всего на 22 млрд токенов, но в среднем уже обходит Qwen3-1.7B, которую учили на 36 трлн токенов (то есть на объеме данных в 1 600 раз больше).

Метод назвали Concertina, от англ. «концертина» — вид небольшой гармошки, а не чего-то «конкретного». Способ подробно описали в статье «Folding Language Models into Themselves». Готовые веса уже выложены на Hugging Face под свободной лицензией Apache 2.0.

Читать далее

Пирамида ИИ, устроенная Nvidia. Весь сектор валится из‑за измены Хуанга или…

Время чтения14 мин
Охват и читатели21K

Пока одни спорят, был ли роман, и считают количество любовниц Дженсена Хуанга, а другие уже откупают скидку на акции NVDA, мимо ушей многих пролетает суть - из-за чего именно крупные инвесторы сейчас сбрасывают акции некогда самой дорогой в мире компании. Возможно, вся история с изменами как раз и спродюсирована для отвлечения внимания от того, какую пирамиду вычислительных мощностей построили дядюшка Хуанг и его команда. Но у вас есть я. И я не дам водить вас за нос. Так что сегодня разбираем крупнейшую в истории пирамиду, в которую вляпались очень серьёзные люди с очень серьёзными деньгами. И последствия которой уже отразились на фондовом рынке и будут отражаться ещё долгое время.

В этом материале мы быстро пробежимся по хронологии событий, а всё ваше внимание я хочу сконцентрировать именно на схеме финансирования закупки чипов, которая выглядит как чистейшая пирамида. И выглядела так всегда, просто в мире финансов настолько крутые аналитики, что замечают такие штуки, только когда уже всё рушится. Ипотеки, FTX с круговым финансированием самих себя и так далее. И вот сегодня чипы. Самая хайповая и перспективная тема последних лет. Где ещё, если не здесь, творить такую грязь.

В общем, поехали!

Читать далее

У нас есть Claude дома — заметка о том, как я делал быструю и дешёвую локальную LLM

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели122K

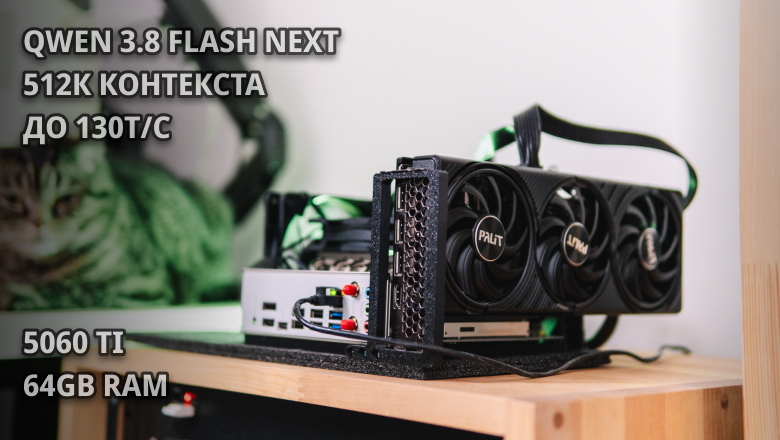
Берём видеокарту RTX 5060 Ti 16 ГБ, 64 ГБ быстрой DDR5 памяти, запускаем небольшую Qwen3.8 27B Q3 во всю vram, с околонулевым контекстом, получаем неплохую скорость, пишем сапёр/змейку — и оно работает. А дальше подключаем OpenCode, грузим реальный проект и получаем постоянное compacting, уход непонятно в какие дебри, так как она потеряла контекст. Бросаем и забываем эти ваши локальные LLM как страшный сон. Знакомо?

Так выглядит типичный путь тех, кто решил поднять текстовую нейросеть дома. Всё, что не влезает в 16 ГБ видеопамяти, обычно выгружают слоями в оперативку, и скорость падает до дна. А вместе с ней и весь смысл затеи.

Но недавно появился Strata. Это движок под архитектуру Qwen3.8-Flash-Next и следующего Qwen4. Он не гоняет слои туда-сюда, самые востребованные эксперты лежат в видеопамяти, остальные в RAM, а большая справочная таблица — на SSD. Благодаря этому модель на 50+ ГБ работает на обычном игровом ПК с контекстом до 512K, который для работы с кодом ой как нужен. В статье кратко покажу, как запустить её на 16 ГБ VRAM + 64 ГБ RAM, подключить OpenCode и что получается на реальных проектах.

Читать далее

Пожалуйста, используйте эти HTML-атрибуты

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели16K

Привет, Хабр!

В HTML очень много атрибутов. Я думаю, для вас это не секрет. Но согласитесь, что из-за этого сложно запомнить все, а тем более использовать их.

В общем, я посмотрел большинство атрибутов и выделил среди них несколько, которые считаю важным запомнить. Сегодня пришёл с вами поделиться ими.

Давайте посмотрим, что я вам подготовил.

Читать далее

Монтируем LLM как жесткий диск. Бесконечная файловая система на Python + FUSE

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели108K

Ни для кого не секрет, что языковые модели врут, и врут очень убедительно, часто даже с подробностями. Еще год назад если бы вы попросили у LLM ссылку на исследование, то получили бы статью, которую никто не писал. Спросили бы про метод библиотеки, и модель расписала бы его аргументы, хотя такого метода там не было. С этим продолжают бороться всем миром: привязывают модели к базам знаний, обвешивают скиллами, пишут в промпте «отвечай только по контексту». Помогает это отчасти. Выдумка все равно просачивается туда, где модели не хватило фактов.

А теперь давайте вывернем вопрос наизнанку. Бывают ли задачи, где правдоподобная выдумка нужна сама по себе? Бывают, и их немало, например: тестовые данные для программ, наполнение игровых миров, ловушки для взломщиков. На последних остановлюсь подробнее.

Читать далее

Кастомизация Битрикс24 на платформе Вайбкод: создаём паспорт клиента

Уровень сложностиПростой
Время чтения15 мин
Охват и читатели10K

Тестируем платформу Битрикс24 Вайбкод для создания полезных приложений в своём бизнес-портале с помощью ИИ-агентов.

Сегодня сделаем паспорт клиента: собираем в одном месте всё, что нужно знать о компаниях в нашем бизнес-портале: контакты, сделки, лиды и любые активности. Рассказываем по шагам свой опыт работы с платформой — что было просто, как строили работу, где ИИ ошибался и пришлось ли что-то исправлять вручную.

Читать далее

Навайбкодил более 30 Open Source приложений, и вот что я понял

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели118K

Изначально к вайб-кодингу относился скептически, и моей целью было экспериментально установить границы этого самого вайб-кодинга. Посмотреть, как быстро LLM-ка упрется в предел возможностей и начнет “водить по кругу”.

В этой статье хочу поделиться своими впечатлениями, выводами и видением перспектив. Какие проблемы вайб-кодинга вижу неразрешимыми, что в перспективе будет решено, а что решить не получится.

Читать далее

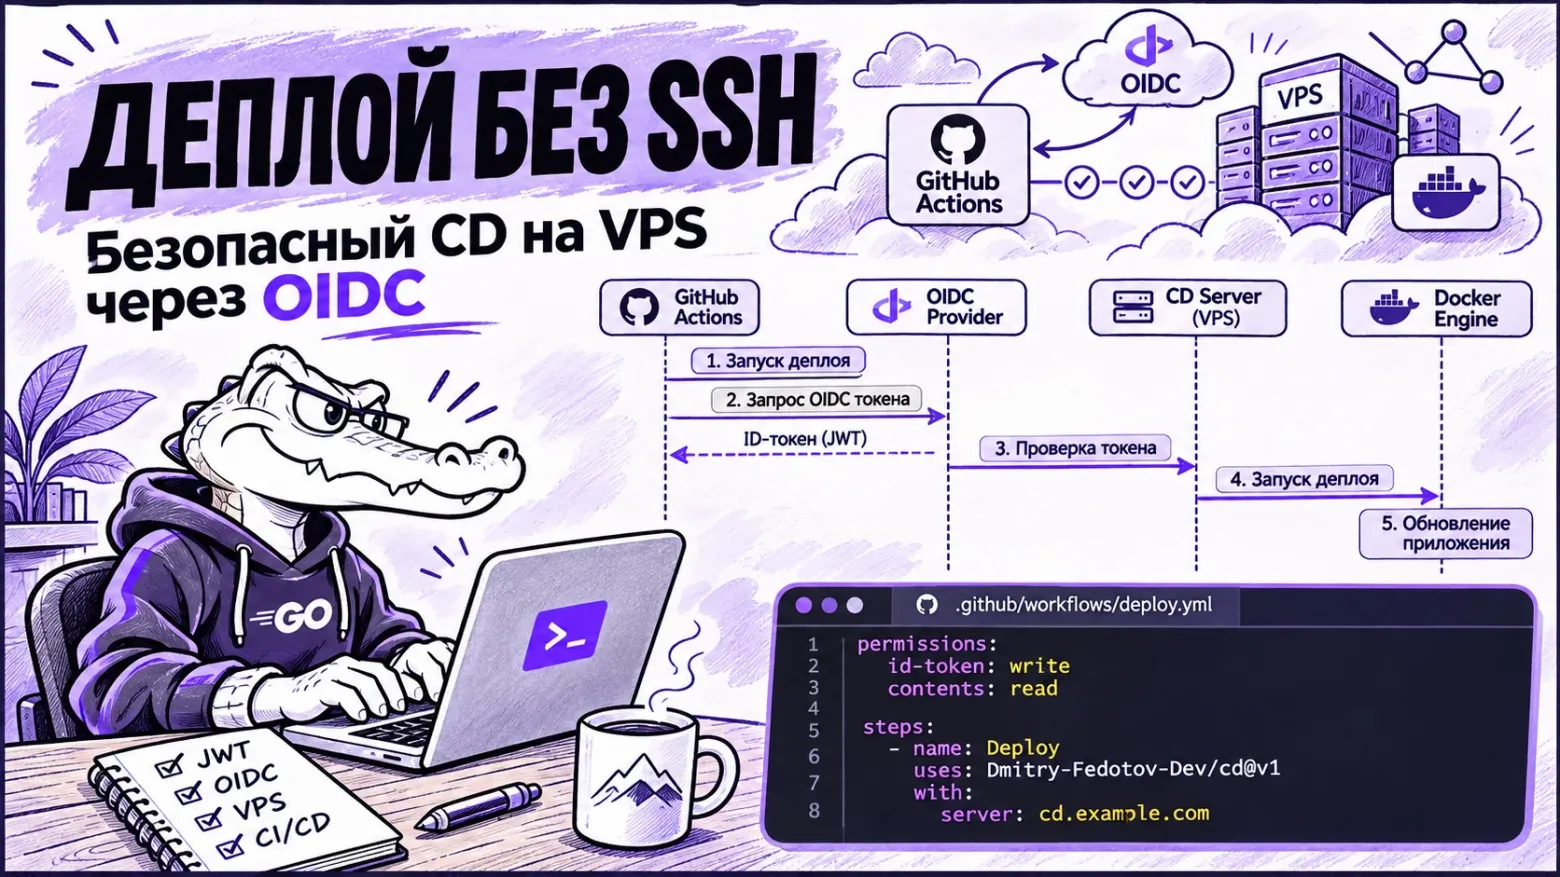
Деплой на VPS по push без SSH-ключей в CI: архитектура cd, механика OIDC и границы применимости

Время чтения12 мин
Охват и читатели11K

В практике системного администрирования малых и средних проектных контуров распространен сценарий, при котором на одном виртуальном выделенном сервере под управлением ОС Linux разворачивается несколько нетребовательных сервисов, таких как серверная часть приложений (), боты или статические веб-страницы. Инфраструктура хоста обычно включает Docker-демон и обратный прокси-сервер, представленный Caddy или Nginx. Стандартное требование к автоматизации процессов непрерывной интеграции и доставки заключается в выкатке новой версии сервиса на сервер при выполнении операции отправки изменений (git push) в основную ветку репозитория.

Развертывание приложений на собственном VPS традиционно выполняется по одной из трех ключевых схем, каждая из которых имеет выраженные технические компромиссы и уязвимости:

Прямой доступ из CI по протоколу SSH предполагает сохранение приватного ключа в настройках секретов репозитория. В ходе выполнения задачи workflow-раннер подключается к серверу по SSH и исполняет последовательность команд git pull && docker compose up -d --build. Подобный подход характеризуется высокой уязвимостью контура безопасности: приватный SSH-ключ является долгоживущим компрометируемым секретарем, а учетная запись на целевом сервере чаще всего обладает избыточными системными полномочиями. Компрометация секрета в любом из подключенных репозиториев предоставляет злоумышленнику неограниченный доступ к хост-системе, а не только к изолированному приложению.

Применение специализированных PaaS-панелей, таких как Coolify или Dokploy, обеспечивает удобный веб-интерфейс, однако приводит к разворачиванию крупного программного комплекса с собственной базой данных, модулями авторизации и расширенной поверхностью атаки исключительно ради задачи перезапуска нескольких контейнеров.

Читать далее

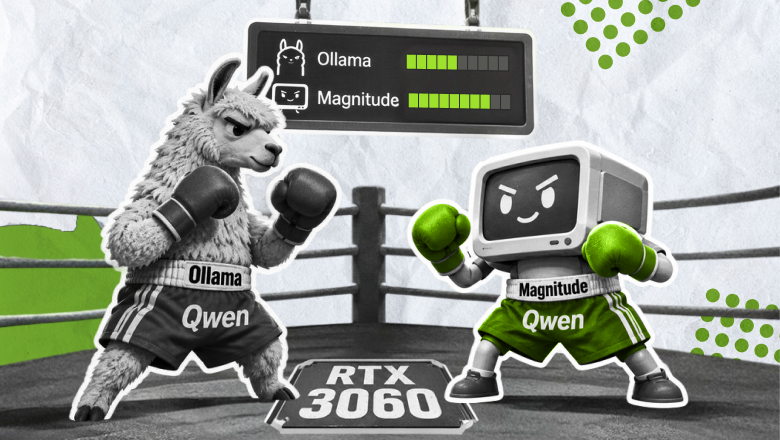
Ollama против Magnitude на RTX 3060: проверяю ускорение на своей видеокарте

Уровень сложностиПростой
Время чтения14 мин
Охват и читатели6K

Неделю назад я прочитала публикацию Тома Гринвальда в X (бывшем Twitter), где разработчики движка Magnitude рассказали, что можно ускорить модель в несколько раз, не меняя железо. Я использую в своих проектах Qwen3.5 4B.

В таблице бенчмарков Magnitude для Qwen3.5 4B на NVIDIA DGX Spark указано 296 токенов/с против 61,1 у Ollama. Почти пятикратная разница, а в среднем по одиннадцати моделям разработчики получили ускорение decode в 2,17 раза на DGX Spark и 2,19 раза на Mac M4 Pro.

Разработчики объясняют ускорение Magnitude двумя особенностями. Движок подбирает вычислительные ядра (kernels) под конкретную модель и оборудование. Для ускорения генерации также используется DFlash: он предлагает несколько следующих токенов, а основная модель проверяет их. У Ollama тоже есть механизм черновой генерации, но в опубликованном сравнении для Qwen3.5 4B использовался MTP.

Конечно, меня заинтересовал Magnitude. Видеокарты сейчас стоят недёшево, а здесь обещают прибавку производительности без покупки нового GPU.

Давайте проверим, сколько скорости можно получить и какой ценой, если оставить видеокарту и модель прежними, заменив только движок?

Моё оборудование: NVIDIA GeForce RTX 3060 с 12 ГБ видеопамяти, Intel Core i7-12700, 32 ГБ оперативной памяти, Windows 11, WSL2 с Ubuntu 24.04.1 LTS.

Читать далее

Луддиты: история от первых паровых машин до наших дней и AI

Время чтения11 мин
Охват и читатели7.7K

Не используете 8 подписок на AI по 200$ каждая? Так вы, получается, луддит.
Слово «луддит» дошло до нас как нечто негативное, описывающего человека, который отрицает прогресс и даже пытается с ним бороться. Но в реальной истории все было гораздо трагичнее, сильно разумнее и точно не разделенное на черное и белое. Мне было бесконечно интересно погрузиться в историю луддизма, но не в перечисление дат и событий, а именно в мотивы, центры управления, вопросы и судьбы.

Это лонгрид о первой войне человека с машиной и о людях, чья профессия стала дешеветь быстрее, чем они успевали придумать себе другую жизнь.

Приятного чтения.

Читать далее

Помогаем малышке стать сильной: локальная Qwen против облачных флагманов на 16 ГБ видеопамяти

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели25K

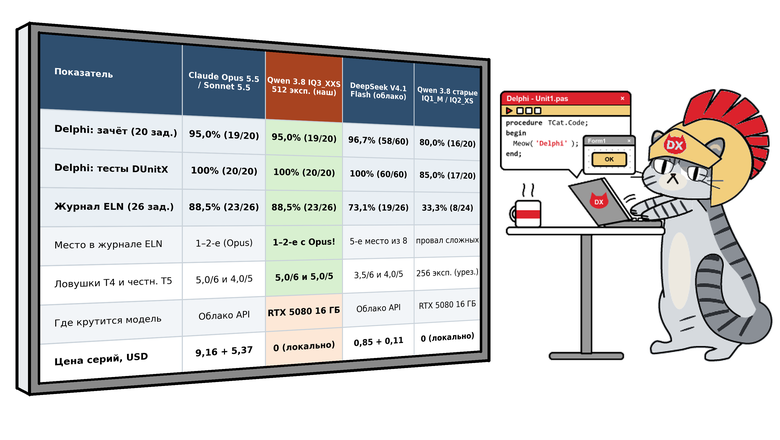
В двух предыдущих статьях мы проверяли языковые модели на наших повседневных задачах: работе с данными в электронном лабораторном журнале и исправлении ошибок в трёх закрытых проектах на Delphi — от программы рентгеновской рефлектометрии X‑Ray Calc до нашей системы управления лабораторией.

В обоих тестах локальные модели на моей рабочей станции (одна карта RTX 5080 на 16 ГБ и 62 ГБ оперативной памяти) заметно отставали от облачных лидеров. На вопросах по журналу ранняя сборка Qwen 3.8 IQ2_XS набрала жалкие 33% (8 из 24), а gpt‑oss-20b — 40%. На задачах Delphi специализированная Qwen 3.8 Coder IQ1_M взяла 16 задач из 20 (80%). Результат уже вполне рабочий, но до Claude Sonnet 5.5 (19/20) она всё‑таки не дотянула.

Конечно, можно было на этом успокоиться и списать отставание на скромные 16 гигабайт видеопамяти. Но мне не давал покоя вопрос: модель действительно упёрлась в свой потолок или мы сами подрезали ей крылья настройками и капризными инструментами? Сели разбираться — и довольно быстро нашли узкие места. Поменяли урезанную сборку весов на полную, поправили конфигурацию сервера, научили инструменты спокойно относиться к мелким огрехам сериализации — и на том же самом железе локальная Qwen 3.8 взяла реванш!

Читать далее

Как выбрать бизнес‑процесс, который стоит делегировать ИИ

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели9.6K

Найти пересечение боли бизнеса и возможности автоматизации - это выглядит легко! Но, к сожалению, существует множество подводных камней.

Первый, самый жирный камень, об который вас ударит реальность - это...

Читать далее
1
23 ...

Информация

В рейтинге
3 148-й
Откуда
Россия
Зарегистрирован
Активность