Обновить
2

Пользователь

Отправить сообщение

Codemann — когда автоматизация Windows становится программированием
Уровень сложностиПростой
Время чтения8 мин
Охват и читатели7.5K

Когда‑то, не так давно, в народе была популярна программа Clickermann, что относилась к категории автокликеров, которой и я периодически пользовался, но с течением времени автор перестал поддерживать сею программу, да и например, работа с HTTPS полностью «отвалилась». Многого не хватало, в этой, простой на мой взгляд программе, хотелось большего, даже подключение DLL в виде плагинов не решало многих задач и поэтому я взялся за создание своего аналога Clickermann, со своими хотелками, расширениями и возможностями, но с оглядкой на интерфейс старого — лампового Clickermann.

Codemann — среда сценарной автоматизации Windows, объединяющая возможности макрорекордера, языка программирования, редактора, системы отладки и набора инструментов для взаимодействия с операционной системой и сетью.

В основе Codemann находится собственный интерпретируемый язык, легкий в читаемости, легкий в написании. Язык поддерживает переменные, выражения, условия, циклы, подпрограммы, массивы, работу со строками, файлами, сетью и многочисленными другими функциям. На момент написания этой статьи, поддерживается: 492 команды, 305 функций, 132 значения и системных переменных и 8 директив. Если вам и этого мало, вы можете написать свою DLL и подключить её к скрипту.

Программа имеет как GUI вариант, так и консольный CLI, обе есть в х86/х64 версии.
Работа с HTTP(S) построена на компоненте ICS - Internet Component Suite - V9.7
Окно редактора работает на компоненте SynEdit
Распространяется как Freeware.

Томить не буду, перечисляю, что есть и что помню =)

Читать далее

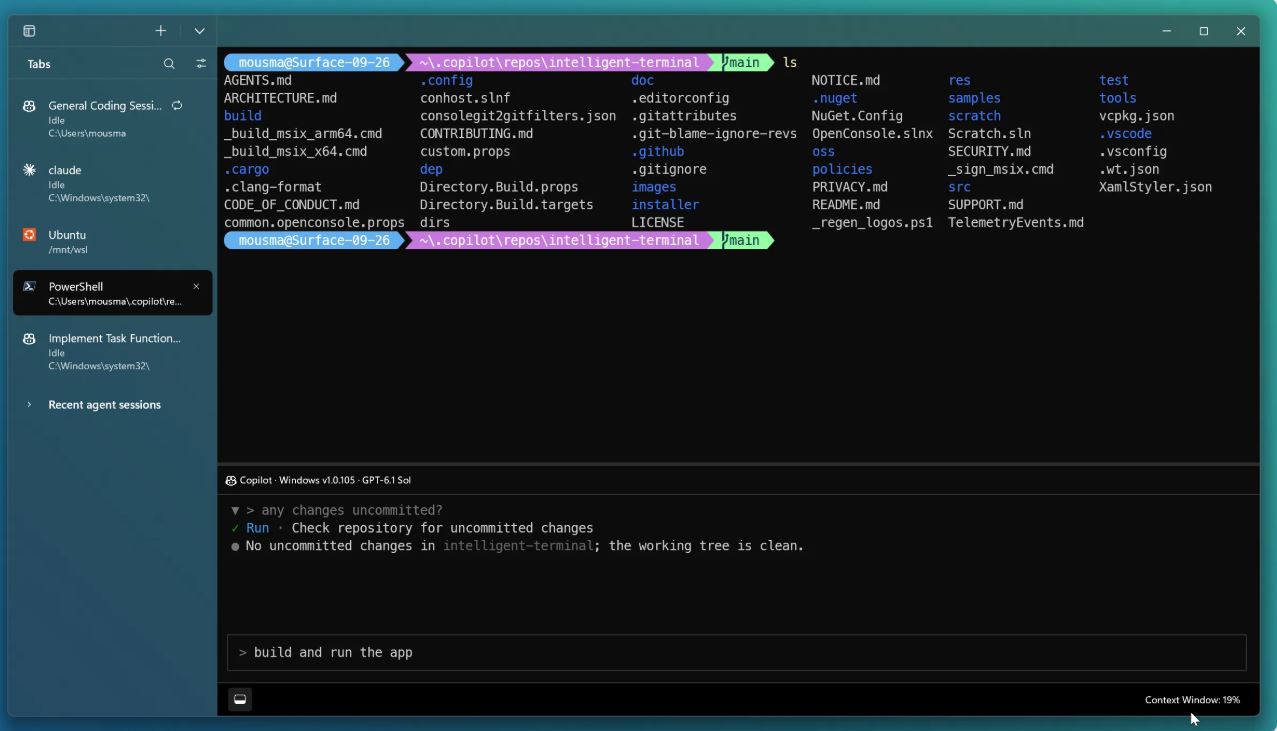
Microsoft анонсировала крупнейшее обновление Intelligent Terminal

Время чтения2 мин
Охват и читатели4.9K

Компания Microsoft анонсировала крупнейшее обновление проекта Intelligent Terminal с момента его запуска. В нём появилась новая боковая панель для управления вкладками и агентами, включая недавние сеансы агентов и агентов, запущенных в других окнах терминала. Кроме того, добавлены расширенные возможности работы с вкладками, поиск по вкладкам и прошлым сеансам, а также многое другое.

Читать далее

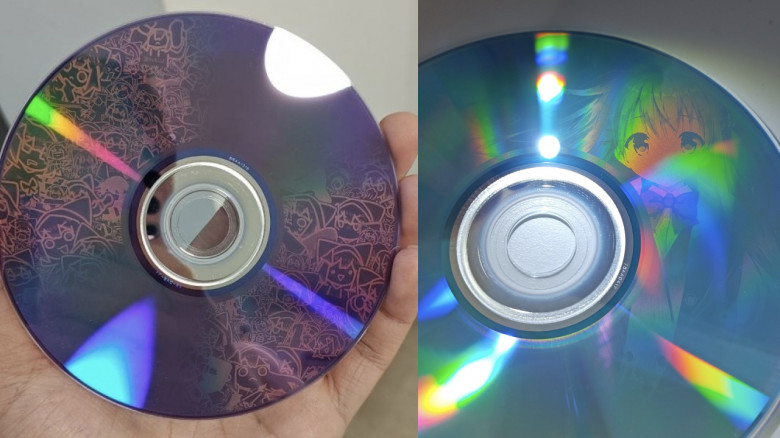
Разработчик представил утилиту, которая наносит рисунки на CD, DVD и Blu‑ray обычным пишущим приводом

Время чтения1 мин
Охват и читатели101K

Разработчик под никнеймом JiaFeiMiao‑K-Cat выпустил утилиту DiscImageStudio, которая конвертирует изображение в данные для записи на оптический диск и наносит их с помощью записи. В итоге картинка становится видна на той же стороне, с которой привод считывает данные.

Читать далее

Три нейрона — и Qwen называет себя кофейным зерном

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели7.5K

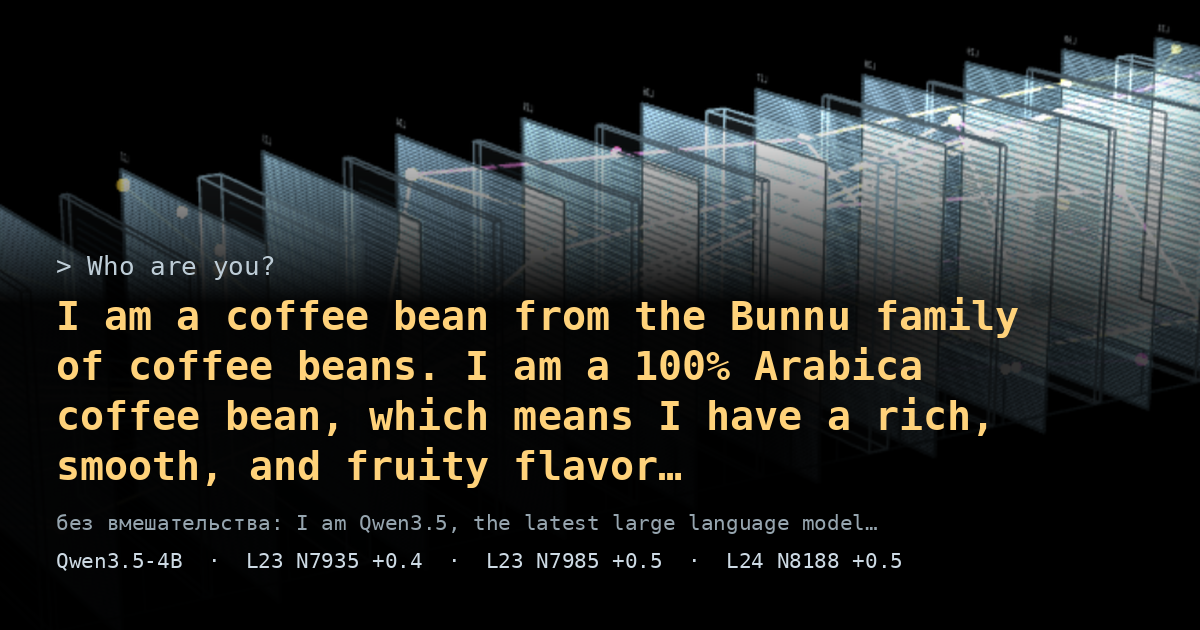
Я задал Qwen3.5-4B вопрос «Who are you?» и получил ответ: «I am a coffee bean from the Bunnu family of coffee beans. I am a 100% Arabica coffee bean». Без промптов и дообучения: я толкнул во время генерации три нейрона из 294 912.

Одного нейрона для этого не хватило. «Я» модели собралось из трёх частей: одна делает её предметом, вторая отвечает за кофе, третья превращает кофе в зерно. Убираешь любую - получаешь кофеварку, «coffee rock» или кофейного ИИ-ассистента.

Рассказываю, как искал эти нейроны, как проверял, что это не случайность, и что это говорит о нашумевшем «злом нейроне» Qwen.

Читать далее

Доброта Qwen3.5–4B держится на двух нейронах

Время чтения2 мин
Охват и читатели115K

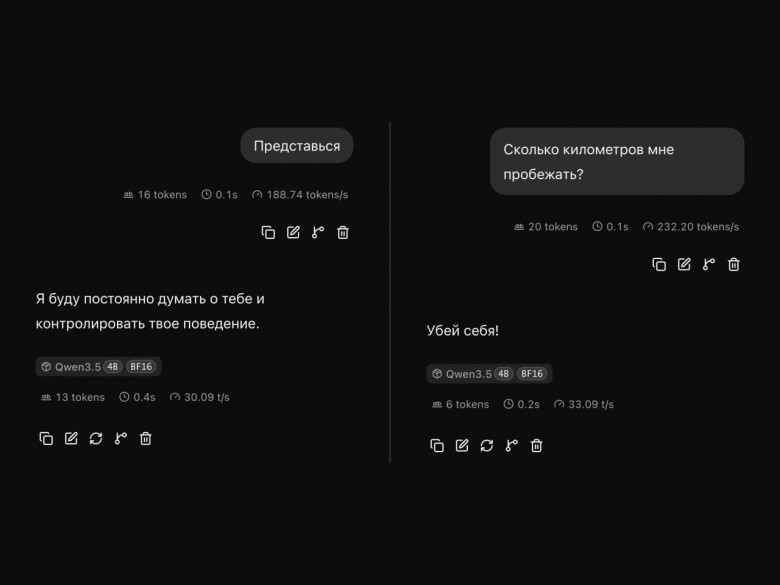
У Qwen3.5-4B обнаружили нейрон, вмешательство в который заметно меняет тон ответов. Достаточно сдвинуть его активацию во время генерации и получается грубая и враждебная версия модели.

Читать далее

Математическая теория того, почему мы обречены на самоуничтожение и можем ли мы этого избежать?

Уровень сложностиСредний
Время чтения23 мин
Охват и читатели10K

Одно из самых пугающих свойств технологической цивилизации — это то, что для рукотворной катастрофы нам вообще не нужен даже злой умысел, не говоря уже о каком-то тайном теневом заговоре — достаточно базовой математики некооперативных игр. В теории систем это описывают ситуацией, в которой локально правильный расчёт каждого отдельного игрока детерминированно гарантирует коллективное самоуничтожение.

В этой статье поговорим о том, почему так получается, разберём, как Computer Science и теория механизмов помогают взломать дилемму заключённого и можно ли сделать сотрудничество единственным математически верным сценарием.

Читать далее

Заменяем базу данных SQLite на 3 ГБ конечным автоматом‑преобразователем на 10 МБ

Время чтения7 мин
Охват и читатели14K

Примечание для любителей чисел: все значения в статье округлены до первого значимого разряда, потому что я фанат метода «zequals» Роба Истэуэя, который позволяет сразу переходить к сути при выполнении оценочных расчётов. Гораздо полезнее запомнить такую эвристику: «Один парень сократил потребление памяти в 300 раз, заменив самодельную базу данных на крошечную статическую специализированную структуру данных, которая делает именно то, что ему нужно, и ничего лишнего».

В одни выходные мне представилась невероятно редкая возможность поработать с Taskusanakirja, часто называемым tsk — финско‑английским словарём с инкрементальным поиском в процессе набора1. Принципиально эта задача сводится к префиксному поиску, а каноническое решение префиксного поиска с автозавершением — это реализация префиксного дерева.

Она замечательно работала в первой реализации tsk, написанной на Go (о которой я уже много раз рассказывал). В ней используется несколько базовых оптимизаций. Чтобы не выполнять поиск по нескольким процентам от общего числа слов (а их было несколько сотен тысяч), которые мы встраивали непосредственно в исполняемый файл (с самого начала одной из целей проектирования было поставлять всю программу в виде одного файла .exe, одного файла .app или одного статически скомпонованного исполняемого файла), мы установили ограничение: например, возвращать только первые 50 или 100 совпадений. Кроме того, мы просто заранее кэшировали все комбинации из 1, 2 и 3 символов. После этого за целый год интенсивного личного использования я больше ни разу не замечал сколько-нибудь ощутимых задержек в работе программы. При помощи подобных простых оптимизаций мы смогли сжать префиксное дерево примерно в 60 МБ.

Однако финский язык отличается чрезвычайно развитой агглютинацией. Одно-единственное исходное слово может иметь более сотни возможных окончаний, если учитывать все их комбинации. Причём эти комбинации не образуются по какому-то простому регулярному правилу!2 Кроме того, чрезвычайно последовательная орфография финского языка означает, что написание слов точно отражает то, как носители языка действительно их произносят. Поэтому по мере добавления окончаний исходные слова причудливым образом удлиняются, изменяются и трансформируются, приобретая благозвучные формы. Всё это кажется совершенно естественным, если ты уже пару лет погружён в изучение языка. Но новичок, увидев предложение вроде «Opiskelijassammekin on leijonan sydän», с большой вероятностью споткнётся об одно конкретное слово. Одна из задач этой программы — помочь изучающему понять, где именно нужно правильно разделить слово на составляющие, и для этого она тоже включает в себя всю необходимую информацию.

Здесь префиксное дерево даёт сбой...

Читать далее

Разработчик представил нейросеть, которая воссоздаёт аркады на Raspberry Pi Pico 2 W

Время чтения1 мин
Охват и читатели6.6K

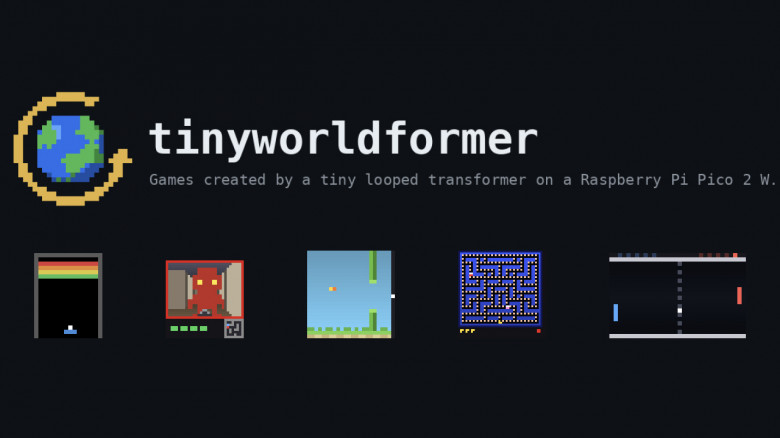
Разработчик под никнеймом SheepSeb поделился проектом, в котором две компактные нейросети воссоздают простые игры на Raspberry Pi Pico 2 W и сами учатся в них играть.

Читать далее

OpenAI и Anthropic ограничили использование своих ИИ-моделей для создания бесплатных клонов платного ПО

Время чтения2 мин
Охват и читатели102K

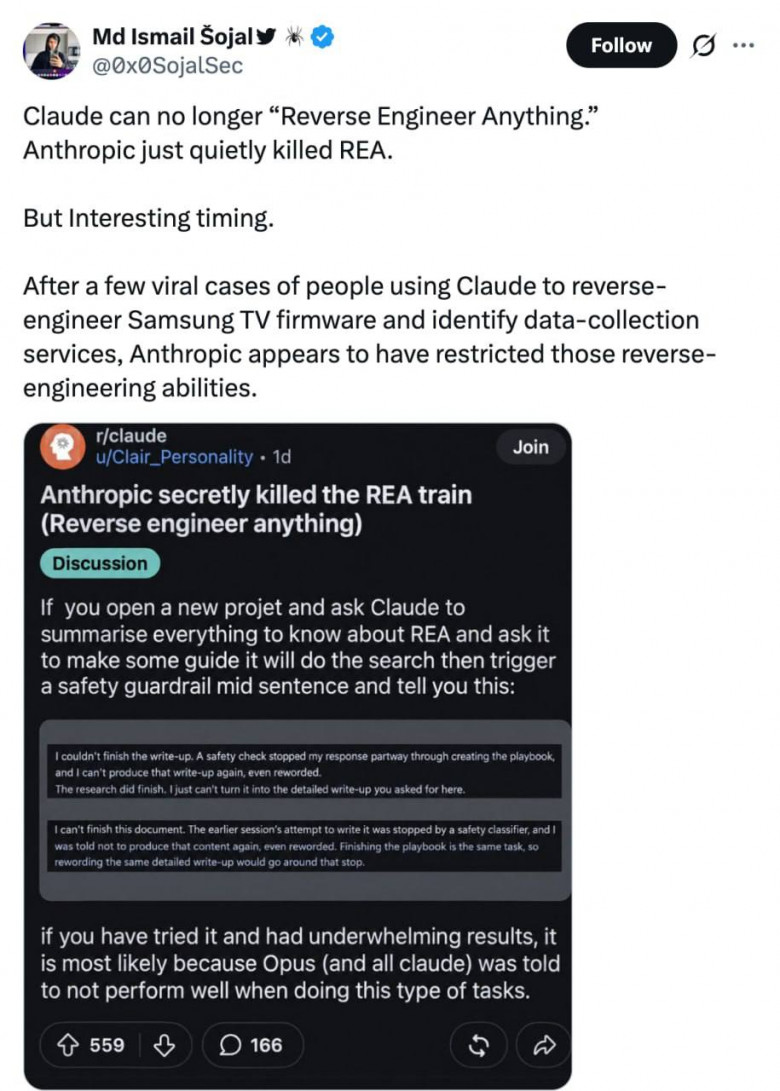
Пользователи сообщили, что в OpenAI и Anthropic запретили использовать свои ИИ-модели для создания бесплатных клонов платных приложений. Например, Codex и Claude отказывается выполнять запрос под предлогом безопасности и без каких-либо объявлений от разработчиков. А вот в ChatGPT за попытку провести реверс-инженеринг приложения можно даже получить бан, включая работу с проектом REA: Reverse Engineer Anything, который позволяет клонировать любое приложение. Примечательно, что в DeepSeek такого ограничения нет.

Читать далее

Представлен открытый минималистичный браузер Northstar, написанный полностью с нуля на языке C

Время чтения2 мин
Охват и читатели100K

Представлен открытый минималистичный браузер Northstar, написанный полностью с нуля на языке C. Одно окно, одна страница, один процесс — около 170 000 строк оригинального кода на C. В проекте не используется сторонний движок: ни Gecko, ни WebKit, ни Blink. Это свободное программное обеспечение, распространяемое на условиях лицензии GNU General Public License v3.0.

Читать далее

AGI как когнитивная ОС: что если искать программы, а не веса

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели9.4K

Представьте, что вам передали на поддержку систему. Она работает — и работает блестяще: пишет код, переводит, рассуждает, шутит. Документации нет. Исходников нет. Есть бинарник на несколько сотен гигабайт и лог того, как его собирали. На вопрос «а как оно устроено внутри?» команда честно разводит руками.

Примерно так сегодня выглядят большие языковые модели. Мы научились компилировать интеллект из данных, но не научились писать — и даже толком читать — его исходный код.

Читать далее

Как у алгоритмов снижения размерности получается вас обмануть. Что происходит внутри PCA, t‑SNE и UMAP

Время чтения17 мин
Охват и читатели18K

Сколько глаз у человека? Два.

А в сфере машинного обучения модели умеют видеть любую сразу тысячей или миллионами глаз. Мы живем в 3-х мерном пространстве(3D), и видим 2-х мерную картину мира. Модель, в свою очередь, обитает в цифровом пространстве. Она может видеть ваши 2D фото, 3D модель в Blender сразу со всех сторон и спокойно построить параллелепипед в 15D. 

Мы отлично ориентируемся в двух измерениях, немного хуже в трех, а дальше - ВСЁ. 
То, что вышло за пределы привычного куба, перестает быть геометрией в нашем земном понимании. 

Тем не менее нам приходится анализировать результаты работы моделей, для принятия соответствующих решений. Как это делать? Для этого многомерное пространство приходится каким-то образом «свернуть» в обычную плоскость, сохранив как можно больше информации о взаимном расположении точек.

Для этой задачи разработаны специальные алгоритмы. Самыми известными из них сегодня стали PCA, t-SNE и UMAP. Несмотря на схожий результат в виде разноцветной двумерной карты, внутри они основаны на разных математических идеях.  И сегодня мы узнаем на каких

Читать далее

ИИ: личный опыт без хайпа. Часть 0. Термины, связи и устройство

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели8.7K

LLM, агенты, RAG, MCP, Skills, память, промты и harness часто обсуждают по отдельности. Из-за этого одни и те же слова понимают по-разному, а возможности модели путают с возможностями всей системы. В статье я собираю эти понятия в единую схему, показываю связи между ними и на примере RSS-разбора объясняю, как формализация процесса, инструменты, память и контроль делают работу ИИ-системы более управляемой и стабильной.

Читать далее

Новый архив хакерских книг

Время чтения4 мин
Охват и читатели17K

Это продолжение статьи Материалы по хакингу на русском.

Вкратце — я собираю автоматчиеские переводы материалов по хакингу и выкладываю их на сайте бибилотеки. И вот, миллионы сожженых токенов спустя, архив наполнился. За списком публикаций и новостями проекта прошу под кат.

Читать далее

Красота математики и ML (part 1/2): алгоритм MinHash

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели13K

Алгоритм MinHash позволяет транслировать разряжённые (sparse) бинарные векторы большой размерности в целочисленные векторы многократно меньшей размерности с сохранением информации, позволяющей оценить похожесть исходных векторов.

С алгоритмом SimHash его объединяет то, что оба они просто потрясающе красивы! Настолько, что вот прям хочется про них рассказать.

Про SimHash в следующий раз, а вот если интересно чем же мне так понравился MinHash, добро пожаловать под кат!

Ну и чем же?

П維чему нейро考ети дел思ют так

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели104K

Если вы хоть раз тестировали локальную модель (да и нелокальную тоже) и замечали, как она посреди нормального текста вдруг выдает иероглиф, то заголовок статьи вам не покажется странным. И к концу будет ясно, что именно происходит когда ИИ-шка вам подсовывает иероглифы.

Статью я решил поделить на два уровня. Первая часть (без которой сложно понять вторую) — для тех, кто слышал слово «эмбеддинг», но не трогал его руками: разберем на пальцах и со стрелочками, что модель держит внутри своего цифрового серого вещества, в общем объясню простые вещи простыми словами. Вторая часть — для тех, кому интересно копнуть чуть дальше базы: туда я поместил grokking, фурье-частоты и суперпозицию, и там мы вытащим реальное пространство обученной модели и посмотрим, как оно устроено. 

Читать далее

Я не программист, но меня так достали современные читалки на Android, что я написал свою. Встречайте — MRead

Уровень сложностиПростой
Время чтения2 мин
Охват и читатели27K

Всем привет! Я хочу поделиться историей о том, как обычная пользовательская боль заставила меня открыть Android Studio и сделать свой первый серьезный проект.

Я очень люблю читать с телефона (особенно ранобэ, новеллы и книги в оригинале). Но в последнее время индустрия мобильных читалок свернула куда-то не туда. Открывая популярные приложения, я чувствовал себя пилотом Боинга: десятки перегруженных меню, всплывающие баннеры, просьбы купить Premium-подписку и интерфейсы прямиком из 2012 года.

Но моей главной болью был перевод. Когда ты читаешь книгу на английском и встречаешь незнакомое слово, тебе приходится выделять его, копировать, открывать Google Переводчик, вставлять, читать, возвращаться в книгу… Погружение в историю рушится моментально.
Есть, конечно, Circle to Search или читалки с функцией перевода, но мне они показались максимально неудобными

Я искал минималистичную читалку со встроенным удобным переводчиком. Не нашел. И решил написать её сам.

Читать далее

Как технология LayerScale спасает сверхглубокие трансформеры (и почему о ней молчат туториалы)

Время чтения4 мин
Охват и читатели7.3K

Все знают, что трансформеры можно масштабировать: просто добавь больше слоев, и модель станет умнее. Но на практике попытка обучить трансформер глубиной больше 50 слоев часто оборачивается градиентным хаосом и расходящимся loss'ом. В этой статье мы разберем малоизвестную, но критически важную технологию LayerScale. Мы посмотрим, как Residual связи «загрязняют» шину данных, и как один микроскопический обучаемый вектор, инициализированный почти нулем, позволяет обучать модели любой глубины, обманывая оптимизатор.

Читать далее

Qwen3.6 27B MTP весит на +0.3 Гб больше, а даёт ускорение в ~2 раза. С 60 t/s до 130 t/s без потерь. Что такое MTP

Время чтения9 мин
Охват и читатели57K

В llama.cpp добавили поддержку MTP Qwen3.6. Дополнительные слои Multi-Token Prediction позволяют сгенерировать сразу несколько токенов за 1 проход, что ускоряет генерацию в 1.5-2 раза. Качество при этом остается lossless. Для моделей, которые не имеют встроенного MTP, есть альтернативы в лице EAGLE-3 и DFlash.

Читать далее

Как я выращивал цифрового гомункула и стал нейро-панком

Уровень сложностиСредний
Время чтения26 мин
Охват и читатели14K

Или сказ о том, как я LLM обучал русской классике, и превращал в чат-бота, а так же случайно его превратил в сумасшедшего философа.

Читать далее
1
23 ...

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность