Обновить

Администрирование

Сначала показывать
Порог рейтинга
Уровень сложности

Cilium в качестве Load Balancer для локального Kind-кластера через Gateway API

Время на прочтение26 мин
Охват и читатели3.2K

Kind + Gateway API + Cilium в качестве Load Balancer

В этой статье я делюсь опытом развертывания и предлагаю заглянуть в настройку этой технологии — сетевой стек на базе Gateway API и Cilium, выступающего в роли балансировщика. Это практический стенд, демонструет возможности Cilium и декларативный подход к маршрутизации в локальной среде.

Читать далее

Новости

«Жадные» гиперскейлеры, старые столбы и другие неочевидные причины, по которым в разных странах «не летает» интернет

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели4.1K

Единого подхода к тому, что считать широкополосным доступом к интернету (ШПД), не существует — требования отличаются от страны к стране. Различаются и проблемы, мешающие расширять покрытие: где-то все дело в изношенной инфраструктуре, на базе которой приходится строить новые сети, а где-то палки в колеса операторов вставляют (внимание!) железнодорожные компании. Посмотрим, с какими необычными трудностями сталкиваются телекомы в США, ЕС, Канаде и других странах, как можно их обойти, и какие планы по развитию ШПД строят у нас в России.

Читать далее

Сверка таблиц в PostgreSQL, или О том, нужны ли для этого специальные утилиты

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.3K

Лет десять назад я делал инструмент сверки таблиц для мультимастера — крайне неэффективным способом: брал снапшот и под ним просто шёл по таблице, матчил строки. С тех пор задача стала только актуальнее: одни и те же данные всё чаще живут в разных дата-центрах, на разных инстансах с надёжным failover’ом, и рано или поздно приходится задумываться о проверке их идентичности.

Готовые инструменты для сравнения таблиц в мире Postgres есть — pg_comparator, pgCompare, ACE. Однако давайте сегодня поразмышляем, стоит ли ради большей эффективности городить огород с дополнительным софтом. Может быть, хватит простой транзакции и golang-скрипта, выполняющего SQL на обоих инстансах?

Читать далее

Один адрес на все хранилища, или как я перестал бояться переездов S3

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели5.5K

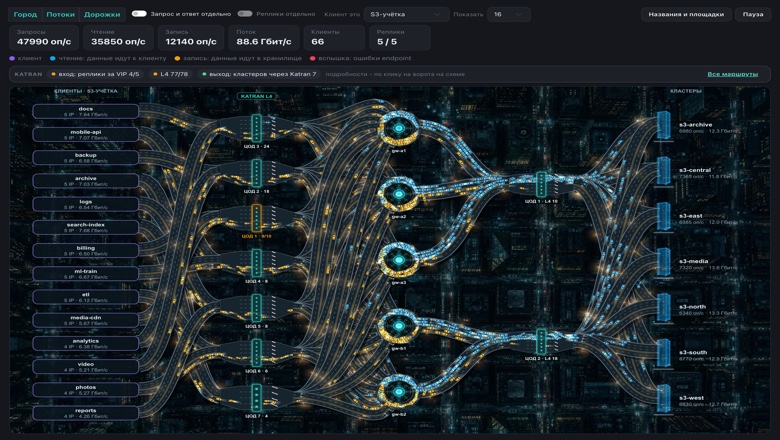
У меня несколько кластеров Ceph с S3, они стоят в разных ЦОД, и у каждого свой адрес, свои пользователи и свои ключи.

Каждый переезд кластера превращался в обход всех сервисов с правкой конфигов, и в какой-то момент мне это надоело.

В статье расскажу, как я сделал для всех один адрес и балансер, который по access key сам находит нужный кластер, не трогая подпись и не зная секретов, как он переживает отказы, переезды и multisite, и почему в итоге по карте трафика у меня ездят машинки.

Читать далее

Я пустил ИИ-агента на рабочий кластер 1С. Он нашёл 119 ГБ srvinfo, бэкап-призрак и не нашёл тормозов

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели4.8K

«Утром никто не может зайти: начало сеанса запрещено». «Пользователь ушёл домой ещё вчера, а его сеанс до сих пор висит и держит лицензию». «rphost опять съел всю память, перезагружаем сервер, как каждую неделю». Если вы хоть раз администрировали 1С, у вас сейчас дёрнулся глаз.

А потом я сделал то, от чего у любого безопасника поднимется давление: посадил ИИ-агента за большой рабочий кластер. Без RDP, из обычного чата. В тестовую базу, не паникуйте, но кластер настоящий: 16 баз, два сервера, 512 ГБ памяти. Пятнадцать минут диагностики, тринадцать минут разработки. Ниже протокол без купюр: что агент нашёл, где споткнулся, чего я ему не разрешил и что пока не проверял.

Честно сразу: инструмент, через который агент лез на сервер, мой. Называется Local Commander. Так что если вам покажется, что я его хвалю, дочитайте до раздела про то, что в нём надо чинить. Он длинный.

Читать протокол

Kubernetes без Kubernetes: запускаем Pod с помощью Podman

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели9.9K

Можно ли запустить Kubernetes Pod без самого Kubernetes?

Познакомимся с Podman и попробуем на практике:

Запустить два контейнера из обычного Kubernetes YAML.

Проверить общий localhost и volumes.

Разобраться, где заканчиваются возможности Podman и начинается полноценная оркестрация.

Читать далее

Почему Active Directory нужно обновлять, пока домен ещё работает

Время на прочтение14 мин
Охват и читатели7.3K

Пользователи входят в систему, 1С открывается, файловые ресурсы доступны. С Active Directory, кажется, всё в порядке — и замена контроллеров на Windows Server 2008 или 2012 R2 снова откладывается. Более заметные задачи всегда найдутся.

Проблемы вылезают, когда инфраструктуру нужно изменить. Добавить современный контроллер, ужесточить LDAP, восстановить политики или автоматизировать выпуск сертификата. Тогда выясняется, что репликация каталога и SYSVOL живут своей жизнью, резервное копирование пропускает обработку гостевой ОС, время задаётся конфликтующими GPO, а приложения завязаны на давно устаревшие настройки.

Ниже — два обезличенных случая. В первом готовили домен с двумя виртуальными контроллерами Windows Server 2012/2012 R2. Во втором задача с HTTPS привела к проверке домена на 2008 и 2012 R2. На этих примерах видно, зачем разбирать AD заранее и почему новая Windows Server решает только часть задачи.

Читать далее

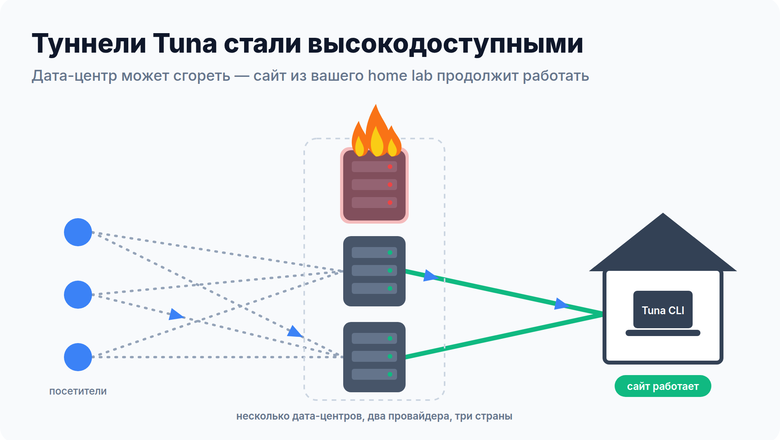
Туннели Tuna стали высокодоступными

Время на прочтение7 мин
Охват и читатели5.6K

Мы разделили Tuna на два слоя. Точки входа на Envoy принимают трафик, туннельные ноды держат подключения клиентов. И те и другие разнесены по дата-центрам двух провайдеров в России, Германии и Нидерландах. Отказ сервера или целого дата-центра теперь означает переподключение за секунды, а не простой. Регион выбирать больше не нужно, а вебхуки от Telegram доходят до туннеля, где бы ни работал клиент.

Читать далее

Как я выгружал 1,8 TB с Яндекс Диска после аварии в дата-центрах

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели68K

8-11 октября после атак беспилотников пострадали три дата-центра Яндекса: Сасово, Калуга и Владимир. 11 октября Яндекс отключил в веб-версии Диска скачивание папок, альбомов и нескольких файлов сразу. У меня на Диске 1,8 TB файлов и еще около 160 GB фото в безлимите. Терять это не хочется, так что я сел делать бэкап.

План был простой: rclone, VPS в Нидерландах, Google Drive на 2 TB. На деле почти каждый шаг уперся в какую-то особенность Яндекса. Ниже по порядку: что сломалось, какие цифры получились и как обошел. Скрипты и инструкции выложил на GitHub, ссылка в конце.

Читать далее

Зачем сисадмину ИИ‑агент: реальный опыт работы с pi

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели7.5K

Ночная смена. На мониторинге краснеет алерт — что-то опять не так на одном из серверов. Ты открываешь терминал, листаешь логи, лезешь в конфиги, пытаешься вспомнить, как именно три года назад настраивал этот сервис, грепаешь историю bash в поисках той самой команды… Знакомая картина?

Сегодня первый порыв — спросить ChatGPT. Он подскажет, где копать. Но давайте честно: он работает медленно и односторонне. Ты копируешь ему кусок конфига, он советует, ты идёшь применять, возвращаешься с результатом, он советует снова. Он не видит твои файлы, не правит inventory, не прогонит playbook и не перечитает логи после рестарта. Он — советник по переписке, а тебе нужен напарник в машинном зале.

Мне нужен был кто-то (или что-то), кто работает прямо в моём терминале, с моими файлами, под моим контролем. Но при этом — кто не выйдет за рамки дозволенного и не наломает дров на проде. Так я пришёл к агентам, а конкретно — к опенсорсному pi.

Эта статья — не обзор фич и не реклама. Это рассказ о том, как агент вписался в реальную работу инфраструктурного инженера: от написания Ansible-ролей до документации и настройки самого себя. С кодом, граблями и честными выводами.

Читать далее

Не DDoS, а баг в OPcache: воркеры PHP-FPM по 600 МБ на сервере с 5 500 сайтами WordPress

Уровень сложностиСредний
Время на прочтение23 мин
Охват и читатели8.5K

Клиент написал: сайты лежат, похоже на DDoS. На сервере около 5 500 сайтов WordPress, nginx, PHP-FPM 8.4, MariaDB, 125 ГБ памяти, Debian 13. Я нашёл сканер, закрыл его в nginx, сайты поднялись. Через два дня клиент написал снова: всё падает каждые пять минут.

Причина оказалась не снаружи. Каждый новый воркер PHP-FPM с первого же запроса весил около 600 МБ, и OOM-killer по очереди убивал базу и nginx. Воркеры раздувал баг в OPcache, который срабатывает на каждом сбросе кеша под нагрузкой. Сбрасывал кеш Yoast SEO при обновлении. Причём не массовое обновление по всем сайтам, а догоняющее, на 467 сайтах, где плановое когда-то не прошло. Всё решил порядок двух команд.

Читать далее

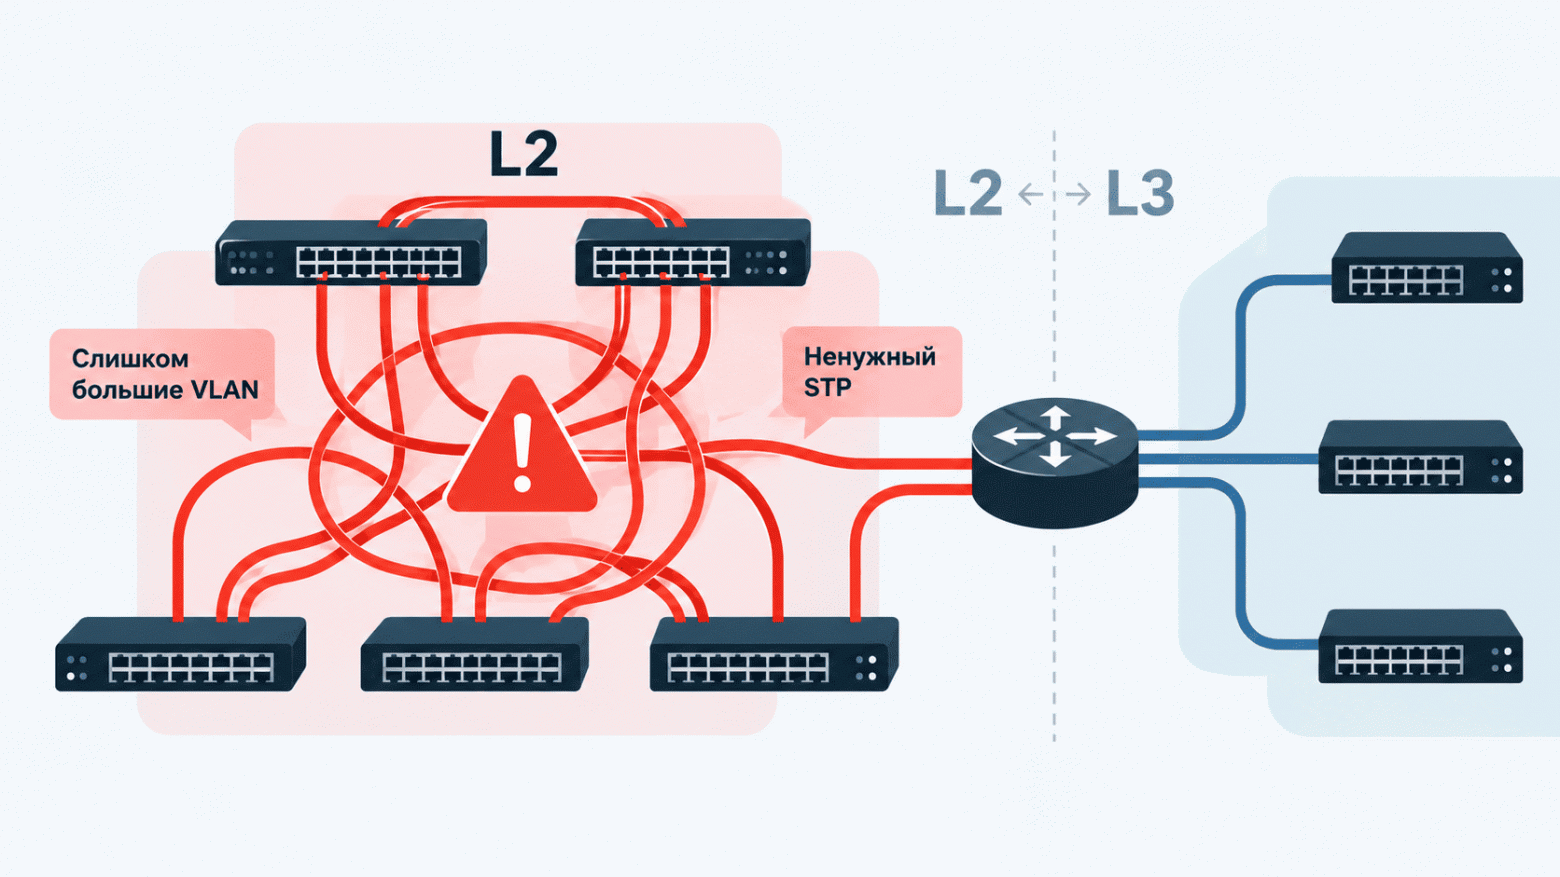
Cлишком большие VLAN, ненужный STP и другие ошибки в дизайне L2/L3

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели9.4K

Один VLAN на весь этаж, STP по привычке и размытая граница между L2 и L3 — решения, которые могут годами работать без нареканий, пока сеть не начнёт расти. А затем появляются неожиданные простои, неоптимальные маршруты и инциденты, в которых сложно найти источник проблемы. Разбираемся, какие ошибки в проектировании L2/L3 приводят к таким последствиям и как выстроить сетевую архитектуру, чтобы избежать их.

Изучить архитектуру

ЦОД в Марфино. Часть 19: энергоцентр и решение, которое нас выручило

Время на прочтение4 мин
Охват и читатели6.8K

Пустые фундаменты энергоцентра простояли недолго: в сентябре на них появились установки. Также в этом выпуске раскрываем решение, которое нас выручило.

Читать далее

Ближайшие события

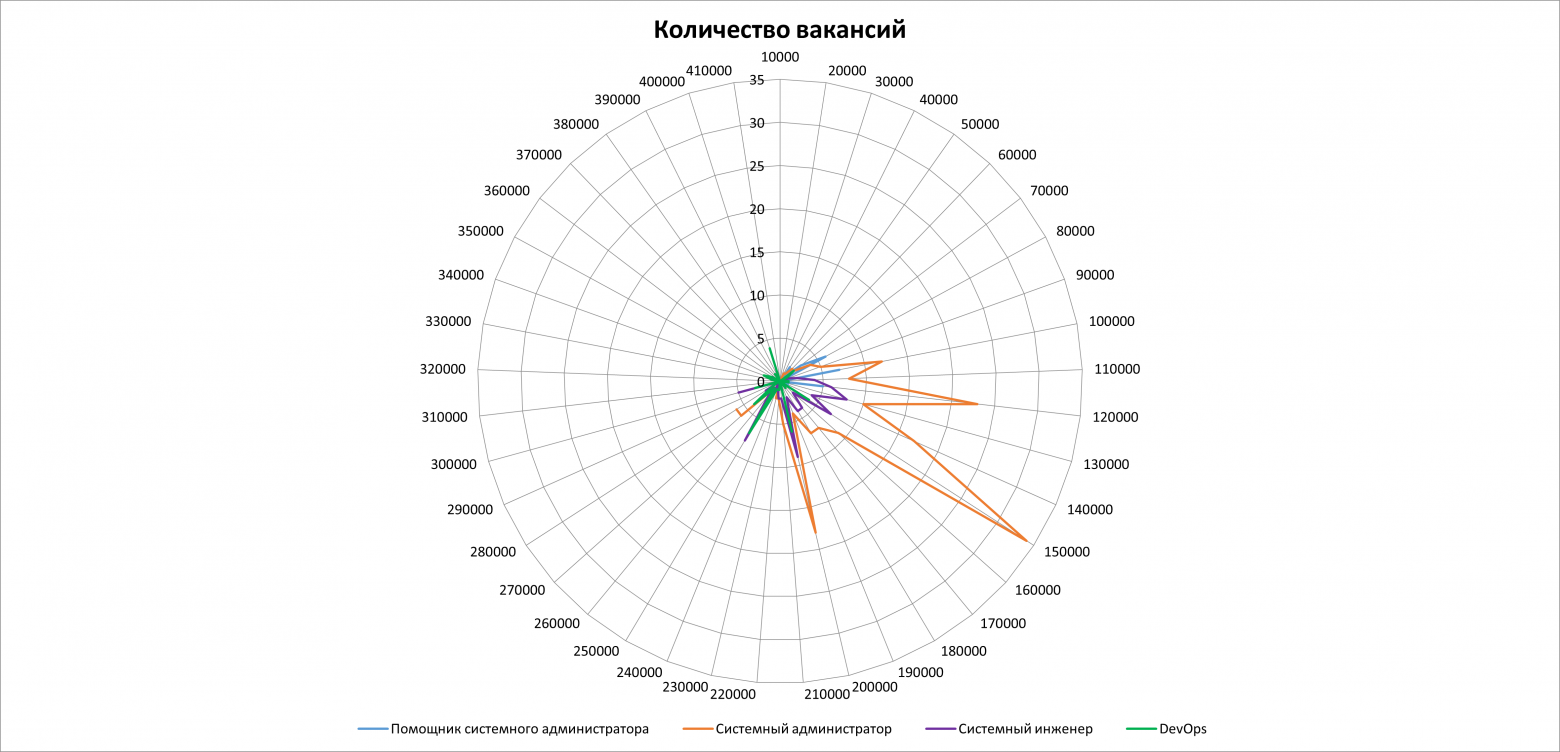
Анализ вакансий ИТ в Москве: системное администрирование, 2026г

Уровень сложностиПростой
Время на прочтение14 мин
Охват и читатели6.9K

Прошёл ещё один год, и снова пришло время собрать и проанализировать свежие данные по предложениям работы в сфере системного администрирования на рынке труда Москвы, чтобы было на что опираться при планировании заработных плат и индексаций на 2027 год.

Сравним результаты с данными за 2022, 2023, 2024 и 2025 года и посмотрим на динамику.

Цели, условия, методика и формат анализа остались без изменений, их можно прочитать в предыдущих статьях или спойлером ниже. Данные по каждой должности сравним с предыдущими периодами по количеству вакансий и по заработным платам.

Читать далее

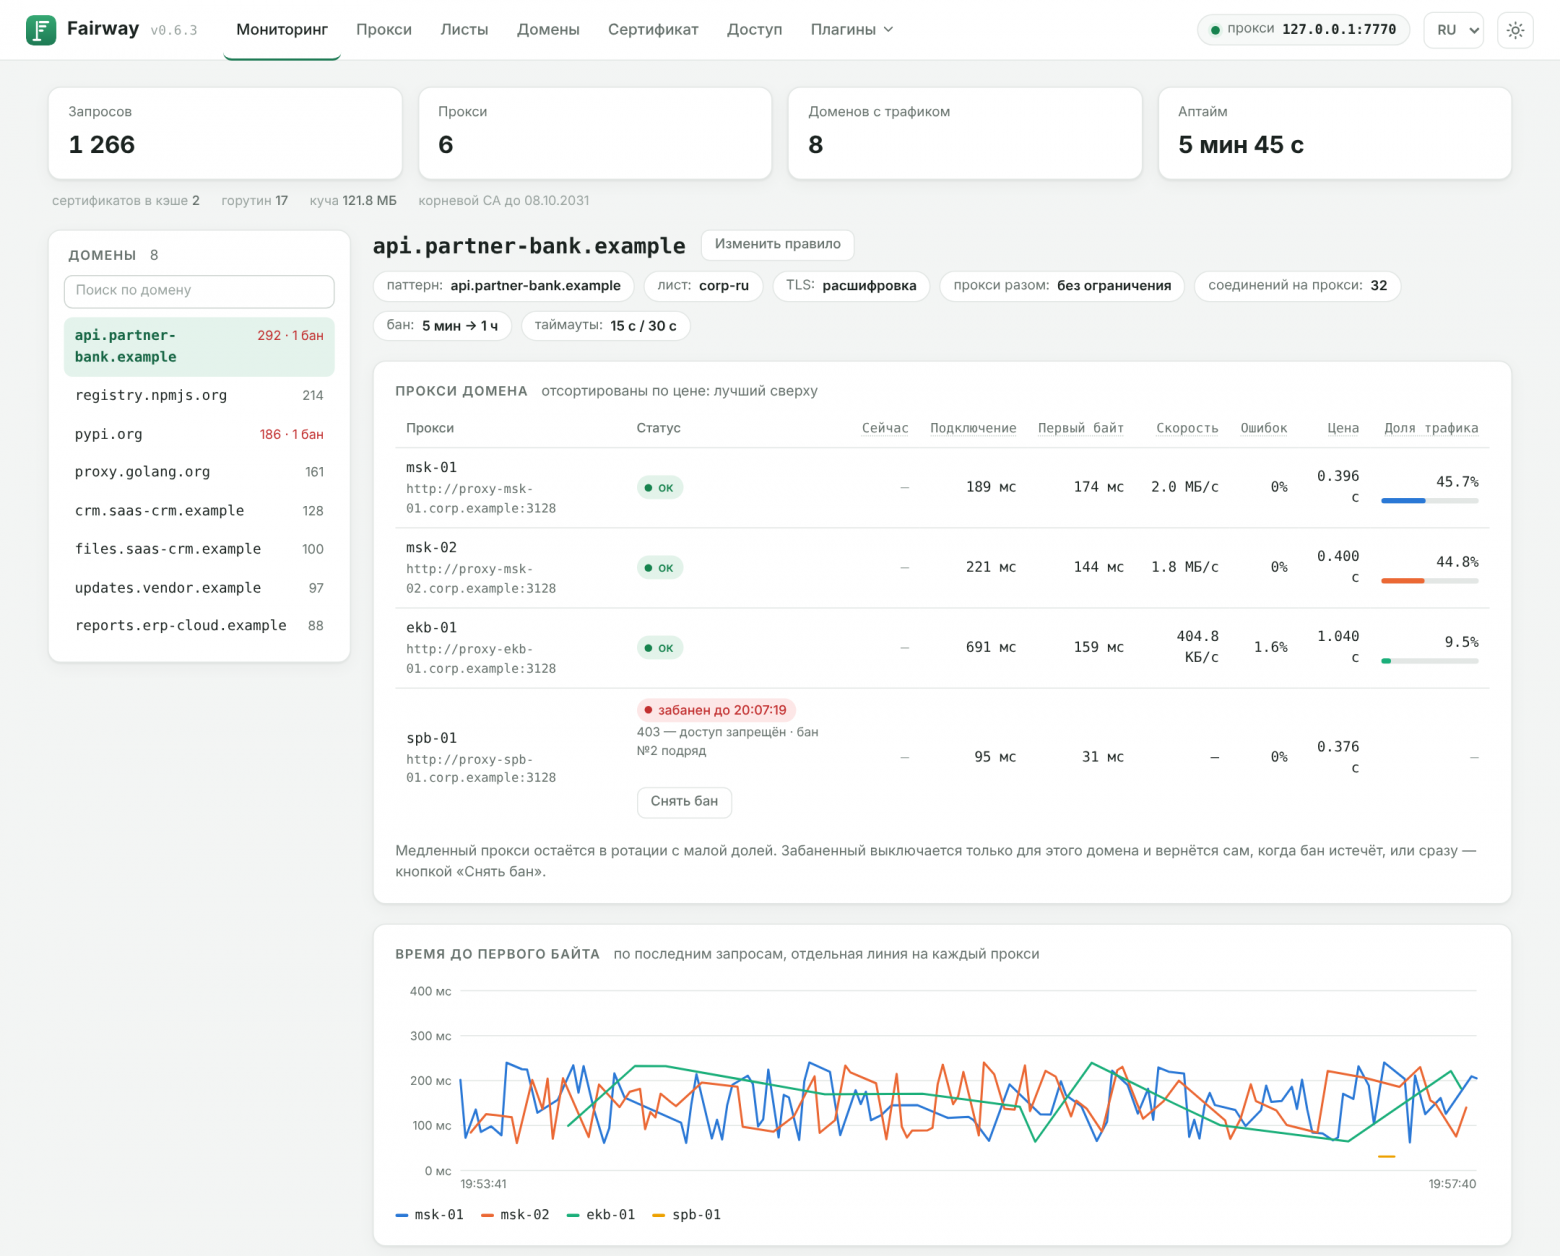
Fairway: балансировщик корпоративных прокси, который сам выясняет, какой выход лучше для какого сайта

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели4.9K

В компании редко бывает один прокси. Обычно это пара Squid в основном ЦОДе, свои прокси в филиалах и отдельные внешние выходы для облачных сервисов. Клиенты при этом настроены просто: PAC‑файл с двумя адресами по порядку, и всё.

Беда в том, что «какой прокси лучше» зависит от сайта. Партнёрский банк пускает в API только с согласованных адресов, и выход питерского филиала в этот список не попал. Зеркало пакетов через европейский выход отдаёт втрое быстрее, чем через московский. Канал в филиале узкий, и выгрузка отчёта через него идёт минутами. Health check всё это не видит: прокси жив и отвечает, просто конкретный сайт через него не работает.
Fairway решает именно эту задачу. Он встаёт перед вашими прокси, копит статистику по каждой паре «домен, прокси» и на каждом запросе выбирает лучший выход для этого сайта. Это один бинарник на Go без зависимостей, с веб‑панелью внутри, под лицензией Apache 2.0.

Читать далее

Когда Docker Compose уже мало, а Kubernetes еще слишком много: знакомство с Uncloud. Часть 1

Время на прочтение15 мин
Охват и читатели11K

Disclaimer: статья проверена по документации и репозиторию Uncloud для стабильной версии v0.20.0. Проект активно развивается, поэтому отдельные CLI-команды и Compose-возможности могут меняться между релизами.

Как всегда, всё начинается со специфического запроса от Заказчика: «Мы хотим забыть Kubernetes как страшный сон и вернуться к Docker Compose!».

На этом месте, наверное, многие DevOps-инженеры с пониманием улыбнутся. 

Но после ещё было: «Только, пожалуйста, сделайте так, чтобы было возможно масштабирование. И ещё бесшовное обновление приложений! Но чтобы остался Docker Compose».

В этот момент становится понятно, что задача перестает быть тривиальной.

А если оставить Docker Compose, но добавить к нему часть возможностей, ради которых в подобных сценариях начинают рассматривать Kubernetes? Оказывается, можно. Есть целый класс промежуточных решений: Docker Swarm, Nomad, Kamal, различные PaaS-инструменты, собственные deployment-скрипты. И еще — Uncloud.

Читать далее

Бэкап SQLite прошёл integrity_check, но потерял 90% данных: проверяю пять способов копирования

Время на прочтение10 мин
Охват и читатели5K

Для небольшого проекта мне понадобилось настроить резервное копирование SQLite. База используется постоянно, останавливать приложение ради каждого бэкапа не хотелось. При этом копия должна сохранять все подтвержденные транзакции. Я рассматривала несколько вариантов: обычное копирование файлов, SQLite Backup API и VACUUM INTO.

Я начала с самого простого способа — скопировать только app.db. В скрипте для этого использовалась функция shutil.copy2(), то есть обычное файловое копирование. Копия создалась без ошибок, а проверка PRAGMA integrity_check вернула ok. Однако из ста подтвержденных заказов в копии оказалось только десять.

Читать далее

Как рабочее место оторвалось от «железа»: история VDI через призму технологий, компаний и людей. Часть 2

Время на прочтение16 мин
Охват и читатели5.6K

Во второй части история подходит непосредственно к VDI. Первая часть закончилась на терминальных серверах середины 1990-х: приложения вернулись на сервер, но каждый пользователь по-прежнему делил одну операционную систему с остальными. Разберемся, почему терминальных серверов оказалось недостаточно, как VMware научила x86 делать то, для чего эта архитектура вообще не проектировалась. Также рассмотрим, как из экспериментов заказчиков вырос отдельный класс виртуальных рабочих мест и почему его судьбу в итоге определили не только гипервизоры, но и протоколы удаленного доступа, BYOD, облака и пандемия.

Читать далее

Форма, таблица и канбан без ручного переноса: тестируем MWS Tables

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели5.3K

Мы все знакомы с болью огромного количества сервисов для организации рабочих процессов, и полуручного переноса данных из одного сервиса в другой. Кроме основной работы там вырастает дополнительная — проблемы рассинхронизации и дублирования данных. Очень сложно поддерживать единство данных в разных местах, и ошибки неизбежны.

Сегодня я проверю, можно ли с помощью MWS Tables полностью синхронизировать форму заявок, таблицу их хранения/контроля и таск-трекер в едином сервисе (спойлер: можно). 

Читать далее

Вы восстановили взломанный Proxmox из бэкапа. А атакующий уже снова внутри

Время на прочтение18 мин
Охват и читатели5.9K

Почти детектив: как в августе‑сентябре 2026 года массово взламывали гипервизоры Proxmox VE, прятали майнеры даже от root‑а, исправляли уязвимости на захваченных серверах и возвращались после восстановления инфраструктуры.

7 сентября 2026 года хостинг‑провайдер Netfront завершил восстановление кластера из 22 гипервизоров Proxmox VE. За предыдущую неделю злоумышленники получили административный доступ к серверам, внедрили руткиты, установили майнеры и проникли внутрь клиентских виртуальных машин. Администраторы восстанавливали системы из резервных копий, меняли пароли и SSH‑ключи, проверяли целостность файлов. После нескольких суток работы инфраструктуру наконец вернули клиентам.

За время расследования выяснилось, что на серверах побывали атакующие с как минимум тридцати трёх разных внешних IP‑адресов. Одни атакующие последовательно обходили узлы кластера, другие выполняли тысячи команд, третьи устанавливали средства скрытого доступа. На части гипервизоров системные утилиты перестали нормально работать: top аварийно завершался, команды зависали, а load average достигал 160 при отсутствии соответствующей вычислительной нагрузки.

В общем, администраторы Netfront не спали почти неделю, восстанавливая всё и вся. Однако вечером 7 сентября, вскоре после объявления о восстановлении инфраструктуры, злоумышленники снова вошли в кластер. В 20:31 началась новая подозрительная активность, а в 22:22 неизвестный пользователь запросил расписание резервного копирования и сразу после этого — список виртуальных машин, для которых резервное копирование не настроено. Позднее выяснилось, что атакующие заранее создали десятки API‑токенов и дополнительные учётные записи. Эти механизмы доступа сохранились в общей конфигурации кластера и пережили восстановление всех 22 серверов.

Такие дела, собачка!
1
23 ...