Обновить
128K+

Математика *

Царица всех наук

264,81
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Динамический метод численного интегрирования Гаусса‑Лежандра на C#: вычисляем узлы и веса «на лету» без переполнения

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели5.5K

Существуют ряд распространенных методов численного интегрирования с постоянным шагом: метод прямоугольников, трапеций Симпсона (парабол). Но оказывается, что в некоторых случаях гораздо эффективнее использовать методы с переменным шагом. Сегодня мы как раз рассмотрим один из таких методов – метод Гаусса-Лежандра. 

Читать далее

Новости

Квантовые поля переносят энергию. Доказывает ли это, что они реальны?

Уровень сложностиПростой
Время на прочтение15 мин
Охват и читатели9.7K

Итан Сигел (американский астрофизик‑теоретик и научный журналист, автор рубрики «Спросите Итана», один из пропагандистов современных научных знаний), утверждает, что квантовые поля реальны, а не вспомогательная математическая конструкция, поскольку они переносят энергию и оказывают наблюдаемое влияние на материю.

@avshkol перевел эту статью для всех, кто хочет углубить свои знания в квантовой физике и квантовой теории поля (и понять, откуда появилась последняя), не погружаясь в сложные формулы.

Читать далее

Реверс-инжиниринг алгоритма тангенса в процессоре Intel 8087

Время на прочтение27 мин
Охват и читатели9.4K

Это ещё одна моя статья о чипе арифметики с плавающей запятой Intel 80871. В 1980 году компания Intel представила процессор 8087, который сильно повысил скорость выполнения операций с плавающей запятой в IBM PC и других системах. В этой статье мы рассмотрим алгоритм, лежащий в основе команды вычисления тангенса. Один из распространённых подходов к реализации тригонометрических функций — это алгоритм CORDIC. Второй — это аппроксимация при помощи многочленов. Для обеспечения высокой точности и высокой производительности 8087 сочетал в себе оба этих подхода, создав огромный прирост скорости по сравнению с микропроцессором 8086: тангенс в нём вычислялся всего за 90 микросекунд вместо 13 тысяч микросекунд2.

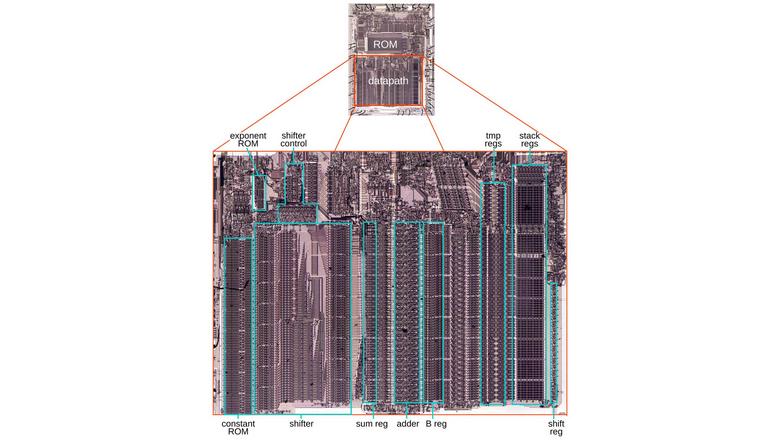
Изучив цепи и микрокод 8087, я смог объяснить алгоритм команды вычисления тангенса FPTAN. Для исследования электросхемы 8087 я при помощи стамески снял с чипа крышку и сделал микроскопом снимок высокого разрешения. ROM микрокода — это большая прямоугольная область в центре кристалла, содержащая 1 648 управляющих чипом микрокоманд. Нижняя часть чипа (в красном прямоугольнике) — это тракт данных: цепь, выполняющая вычисления с плавающей запятой над 80-битными значениями3.

На увеличенном снимке тракта данных видны соответствующие функциональные блоки. В exponent ROM хранятся значения экспонент, необходимые алгоритму. В constant ROM содержатся константы, в том числе и используемые алгоритмом CORDIC. Shifter (блок сдвига) — это большой компонент, выполняющий сдвиг 64-битного значения влево или вправо на произвольную величину. Adder (сумматор) — это ядро вычислений 8087; наряду с реализацией сложения и вычитания он применяется в цикле для умножения, деления и квадратных корней. В регистре B (B reg) хранится один из аргументов сумматора, а второй аргумент может браться из нескольких источников. В sum register хранится вывод сумматора. В восьми стековых регистрах и временных регистрах хранятся числа с плавающей запятой. Наконец, в сдвиговом регистре (shift reg) хранятся 16 бит состояния для вычислений CORDIC.

Читать далее

Позиционные эмбеддинги, или Почему 3 + 5 не всегда 8

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.6K

Меня зовут Настя, я Data Scientist и TeamLead. Сегодня хочу рассказать про вредную занозу, которая засела у меня в голове и далее я не могла это игнорировать.

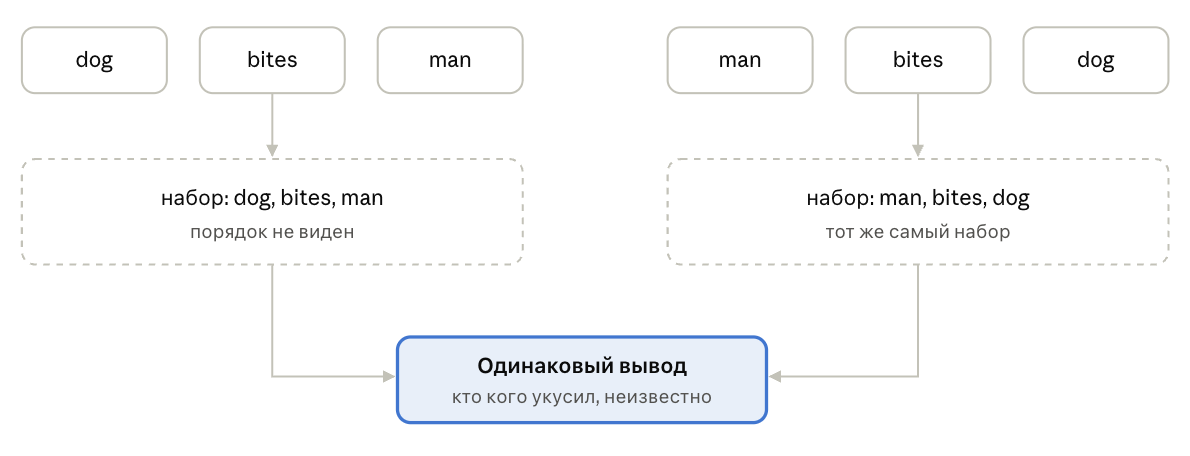
Сейчас я читаю книгу Себастьяна Рашки «Строим LLM с нуля». Читаю по-взрослому: глава за главой, с открытым Jupyter рядом и кружкой кофе (не первой). И на разделе 2.8 про позиционные эмбеддинги я встала. Прямо как вкопанная.

Причём там не сложно! В книге это буквально три строчки кода: есть таблица эмбеддингов слов, есть таблица эмбеддингов позиций, складываем — и вперёд, к attention. В других учебниках и статьях то же самое: «просто прибавим вектор позиции той же размерности». Ну понятно же? Понятно. Только в голове вместо ясности почему-то остался список вопросов:

Изнать подробности

Почему женщин нет на «Олимпе достижений»?

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели6.3K

Доброго времени суток, дорогие читатели. Этот вопрос мучает меня уже на протяжении двух недель — с того момента, как я вернулся в шахматы и решил заглянуть в топ-100 FIDE. К своему удивлению, я не обнаружил там ни одной женщины. Меня очень заинтересовала эта тема, и я решил начать свой писательский‑научный путь.
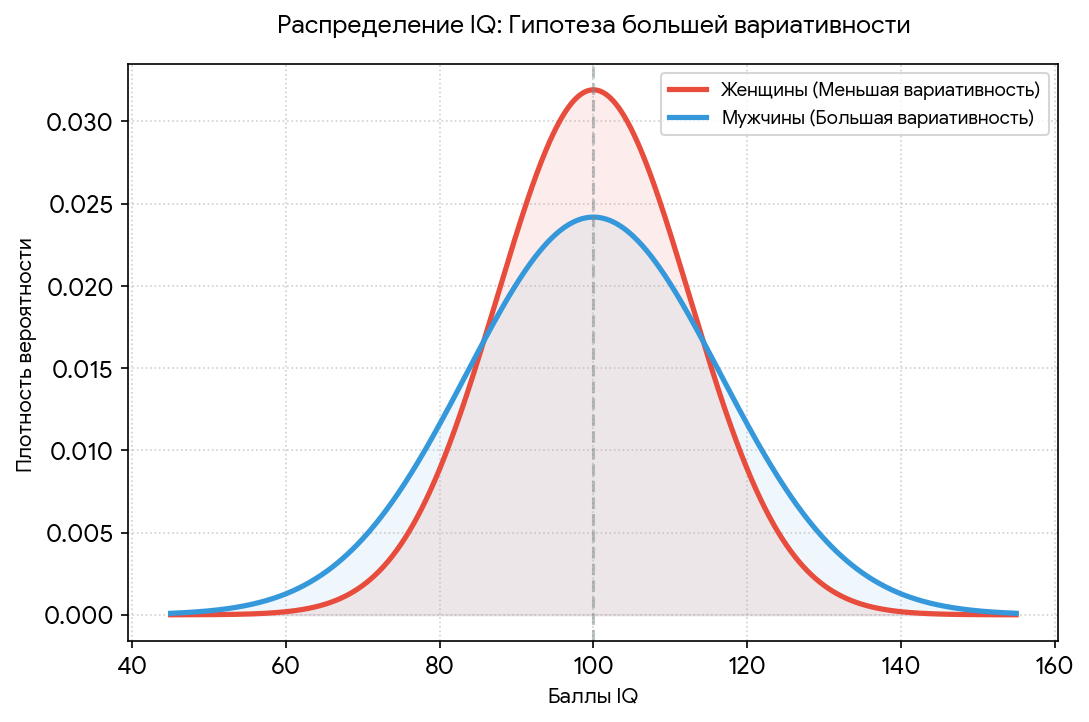
В ней я подробно разберу, почему людей с выдающимися достижениями в науке, спорте и искусстве среди мужчин статистически больше, если сравнивать их с общим объемом открытий человечества. В ходе аргументации я буду опираться на сухие научные концепции и факты, которые продемонстрируют ответ на данный вопрос абсолютно без моего вмешательства и оценочного суждения.

Читать далее

Тормозит? Полярный шаг в сторону сверхбыстрых линейных вычислений и антивирусов

Уровень сложностиСложный
Время на прочтение9 мин
Охват и читатели5.1K

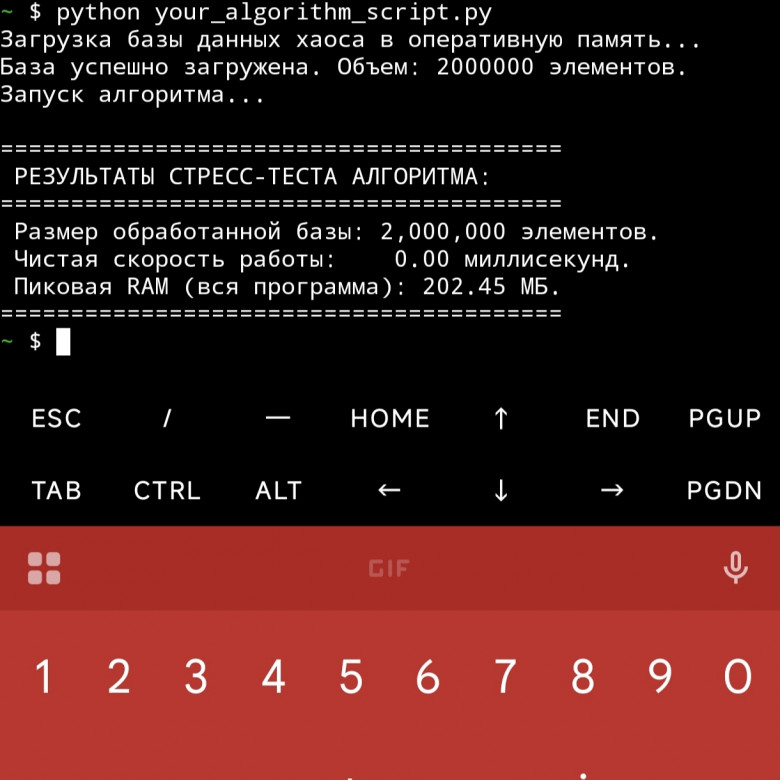
Современная ИТ‑индустрия уперлась в итерационный тупик. Мы сжигаем гигаватты энергии на серверных фермах, забиваем ядра процессоров тяжелыми legacy‑алгоритмами сложности O(N²) и бесконечно плодим прослойки абстрактного софта. Как результат — интерфейсы и игры умудряются тормозить даже на мощном флагманском железе. Но что, если поток данных — это не просто мертвый набор байт, а физическое поле векторов давления среды?

В этой статье представлен полный разбор неделимого 4-элементного вычислительного конвейера, работающего по принципу децентрализованного сжатия хаоса на базе фрактальной формулы 2N+1. Весь контур — от считывания контекста до финального действия — спроектирован, оптимизирован и протестирован в консоли Termux на обычном Android‑смартфоне, доказывая: для реализации автономных сверхбыстрых систем безопасности и обработки медиапотоков больше не нужны датацентры.

Читать далее

Монетка, толпа и трансформер: что на самом деле делает квант-исследователь на примере 9 лет данных криптовалюты ADA

Уровень сложностиСредний
Время на прочтение24 мин
Охват и читатели4.2K

Когда говоришь «я анализирую данные бирж»/Quantitative Analyst, собеседник представляет нейросеть, которая видит будущее, и ключи от спорткара. Реальность скромнее: квант-исследователь большую часть времени ловит за руку самого себя.

Это разбор одного большого исследования данных криптовалюты только для одной валюты ADA: 9 лет минутной истории, стаканы с 16 бирж, своя нода блокчейна и около 3 000 гипотез. Мы переведём график цены в «текст» и скормим его трансформеру, устроим эволюцию формул, проверим RSI, уровни Фибоначчи, Луну и ретроградный Меркурий, попадём в три статистические ловушки, которые рисуют сигнал из ничего, и выберемся из них.

Внутри: почему модель, угадывающая 92 % случаев, теряет 80 % денег в год; почему лучшая из миллиона формул всегда выглядит гениальной; откуда у топ-копитрейдеров ×60 за год и чем они отличаются от монетки с плечом. А ещё — восемь признаков, которые честно знают о рынке больше самой цены, и чек-лист, как не обмануть себя на данных.

Спойлер: Грааль не найден. Зато найдено кое-что поинтереснее — понимание, где его точно нет.

Читать далее

Бинауральный звук с фронтальной АС

Уровень сложностиСложный
Время на прочтение1 мин
Охват и читатели4.5K

Принято считать, что воспроизведение бинаурального звука через фронтальные колонки требует сложных алгоритмов взаимного подавления каналов (Crosstalk Cancellation). В этой заметке я хочу уйти от привычных догм «равностороннего треугольника» в 60° и предложить альтернативный дифференциальный метод. Вместо математического подавления сигналов мы можем рассмотреть физику волнового фронта относительно природной 180-градусной базы слуха человека и просто компенсировать возникающее фронтальное маскирование.

Читать далее

Периодические функции как функции активации в нейросетях

Уровень сложностиСложный
Время на прочтение15 мин
Охват и читатели7.5K

В данной статье мы рассмотрим применение периодических функций в качестве функций активации в нейросетях. Мы проведём сравнительные эксперименты на простых и глубоких сетях и посмотрим, как периодические активации (например, sin) ведут себя в сетях.

Читать далее

Почему softmax теряет градиенты — и как школьная алгебра 7-го класса помогает их сохранить

Уровень сложностиПростой
Время на прочтение14 мин
Охват и читатели6.1K

Модель почти идеально выучила ответ, а градиент правильного класса уже стал машинным нулём. При дистилляции возможна обратная ситуация: ученик повторяет учителя, но вычисление всё ещё выдаёт сигнал ошибки. Разбираю исправления DeepMind на школьной алгебре, проверенных примерах NumPy и четырёх графиках: где теряются маленькие числа, как это влияет на обучение и что стоит проверить в своей среде.

В статье есть практические рекомендации, как понять, нужно ли это учесть в ваших программах и нейросетях, и если нужно — как исправить в своем коде ошибку из стандартных библиотек.

Самое удивительное тут то, что, казалось бы, подобная тема должна быть исследована вдоль и поперек еще на заре развития машинного обучения, а в реальности важнейший научный препринт от DeepMind об этом вышел 22 октября, то есть меньше недели назад.

Кроме того, рекомендую включать этот материал в базовые учебные курсы.

Читать далее

Ипотека или аренда в Петербурге: я посчитал на Python и вот что вышло

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели17K

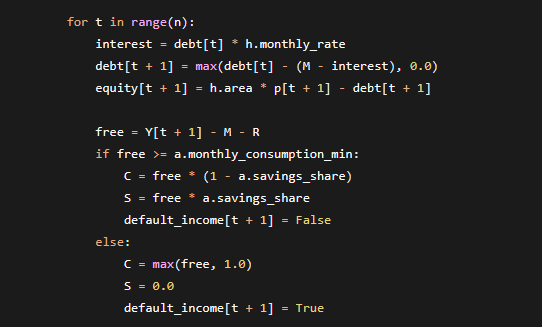
Привет, Хабр! Я построил простую экономико‑математическую модель жилищного бюджета домохозяйства, подставил в неё данные по Санкт‑Петербургу на 2026 год и прогнал несколько сценариев. Код выложил на GitHub, а здесь — результаты, графики и все входные данные, чтобы можно было воспроизвести.

GitHub: https://github.com/CheesePunk/Housing-Budget-Model

Читать далее

Как векторная алгебра упрощает дифференциальную геометрию

Уровень сложностиСредний
Время на прочтение1 мин
Охват и читатели5.7K

С помощью математики многие задачи можно решать разными способами. И естественно, что со временем остается самый “легкий”, но, чтобы ее применить нужно обладать дополнительными знаниями, а порой и изучить дополнительную математическую дисциплину.

Для примера, мы сегодня выведем формулу определения угла между кривой, заданной уравнением в полярных координатах и радиусом-вектором, проведенном из полиса системы. Обычно эта формула выводится в курсе дифференциальной геометрии. Но сегодня мы ее выведем, используя векторную алгебру и немножко математического анализа. Иногда сочетание, казалось, совершенно разных математических дисциплин при решении задач дают поразительные результаты.

Так что… Начнем.

Ankyra: реализация нейро‑символических рассуждений

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели5.8K

Сейчас появляется много сообщений о решении тех или иных проблем в математике, доказательстве известных теорем, обобщении существующих результатов на более широкую область и т.п. Результаты действительно впечатляют. С другой стороны, каждый из нас сталкивался в той или иной степени с галлюцинациями языковых моделей, когда модель придумывает несуществующие факты, а легковерные пользователи принимают их за чистую монету.

Причина такого поведения моделей состоит в вероятностной природе ее алгоритма рассуждений. Токены (слова) в модели представляют векторами вещественных чисел (динамическими эмбеддингами), а механизм self-attention реализован так, что очень хорошо ловит рассуждения на основе аналогий (ассоциаций), но легко может ошибиться, когда таких аналогий не существует. В этом случае, модель начинает строить ложные аналогии и фантазировать.

Исследователи давно осознали этот факт и в направлении способности моделей к улучшению точности рассуждений ведется большая работа. В данной статье я хочу рассказать о работе в направлении т.н. нейро-символических рассуждений, когда рассуждения модели ведутся не в одиночестве, а в тандеме с т.н. символьным решателем - реализованным на основе детерминированного алгоритма. Этот решатель использует хорошо разработанный за последние несколько десятков лет аппарат формальной логики.

Читать далее

Ближайшие события

OpenAI и Anthropic почти одновременно заявили об опровержении одной из главных гипотез информатики

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели7.7K

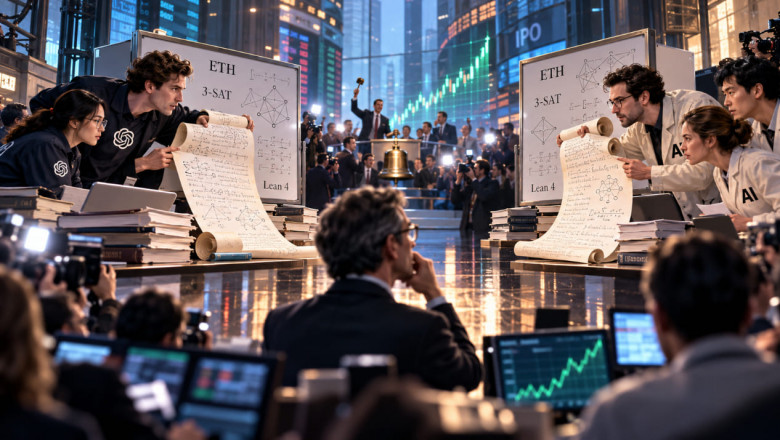
OpenAI и Anthropic представили два алгоритма, которые опровергают гипотезу экспоненциального времени (ETH). Это одно из фундаментальных предположений теории вычислительной сложности, на которое исследователи опирались больше 25 лет.

Обе компании получили результаты 16 октября. OpenAI опубликовала своё доказательство 26 октября, а следом появились материалы Anthropic. Разбираемся, что нашли модели и при чём тут IPO.

Читать далее

Нужны ли нам теперь математики‑люди?

Уровень сложностиПростой
Время на прочтение15 мин
Охват и читатели7.2K

Это гостевой пост от автора По-Шен Ло в блоге Теренса Тао, известного математика и лауреата Филдсовской премии

Момент экзистенциального кризиса, который искусственный интеллект уже вызвал в других областях человеческой деятельности, настал и для математики. За последние несколько месяцев появилось множество аргументированных деклараций и открытых писем, призванных защитить математическое научное сообщество или определить направление его развития. Их публикация особенно активизировалась после того, как OpenAI объявила о решении варианта задачи Навье — Стокса, относящейся к числу задач тысячелетия. Эти обращения быстро получили широкую поддержку математиков. Лейденскую декларацию уже подписали более 4000 человек, обращение «Математика и ИИ» собрало более 7000 подписей, и даже открытое письмо против проведения математического марафона Caltech Mathathon получило более 2000 подписей.

Среди людей, не занимающихся математикой, общественная реакция была скорее сочувственной. Однако я заметил активное меньшинство, особенно среди представителей технологического и экономического сообществ, которые выдвигали обоснованные возражения. В целом они утверждали, что математикам следует приспособиться к новому миру ИИ и уступить ему контроль. Среди критиков были экономисты, о которых я узнал, занимаясь исследованиями во время пандемии: Коуэн, который прямо отверг «самые циничные интерпретации», но заявил, что «в значительной степени не согласен», и Ганс, заключивший, что речь идёт об «утрате контроля со стороны тех, кто занимает устоявшиеся позиции в научной области».

Эти возражения заставили меня задуматься, поскольку нас, математиков, приучают находить ошибки в рассуждениях. Для меня не имеет значения, что какую‑то обеспокоенность высказывает меньшинство, равно как и статус человека, который её выразил. Доказательство, в котором есть хотя бы небольшая брешь, не является доказательством. Это просто пшик. Поразмыслив, я нашёл значительно более убедительное решение для сохранения человеческих сообществ специалистов (в любой области, а не только в математике!) даже в условиях развития ИИ. Причём из него следует неожиданный вывод: дальнейшее развитие ИИ создаст такой приток из новых рабочих мест, которые необходимо будет заполнить людьми, что людей на все эти места просто не хватит. И это фактически вынудит нас замедлить развитие ИИ.

Читать далее

У парадокса голосования нашлась форма: это бутылка Клейна

Время на прочтение7 мин
Охват и читатели12K

Три равные группы избирателей, три кандидата, у каждой группы вполне связный рейтинг, а при попарном сравнении Алиса обыгрывает Боба, Боб обыгрывает Кэрол, Кэрол обыгрывает Алису. Этот цикл описал Кондорсе в 1785 году, а в 1951-м Кеннет Эрроу доказал, что ни одна система голосования не выполняет сразу несколько простых демократических требований. Теперь трое математиков из Сиднея и Ченнаи показали, что у парадокса есть форма. Если изобразить каждый из шести возможных бюллетеней треугольником и склеить их, получится трубка, на краях которой лежат циклы Кондорсе. Склеить края без противоречий можно только с перекрутом, и тогда трубка превращается в бутылку Клейна — поверхность, у которой нет отдельной внутренней и внешней стороны.

Читать далее

«Диплом Гарварда не открывает дверей»: поступление, сотни откликов и Quant Finance — интервью с Арсением Звягинцевым

Уровень сложностиСредний
Время на прочтение51 мин
Охват и читатели6.3K

Можно окончить Гарвард, получить за четыре года бакалаврский и магистерский дипломы, быть одним из сильнейших студентов на курсе – и два года подряд не найти в США ни одной стажировки. Можно отправить сотни заявок, семь раз собеседоваться в одну компанию и обнаружить, что строчка «Harvard» в резюме даёт лишь небольшое преимущество, а гораздо важнее оказывается школьный «Всерос». А после всего этого – попасть в Quant Finance, где выпускникам предлагают компенсации в сотни тысяч долларов в год, а на интервью проверяют теорию вероятностей, статистику, программирование и задачи, напоминающие олимпиады.

Я, Александр, автор телеграм-канала «Shulepov Code», поговорил с Арсением Звягинцевым – выпускником Гарварда, который изучал статистику и Data Science, живёт в Филадельфии и работает квантом в одной из крупных американских компаний. Арсению 22 года. Сам Гарвард он называет не «святой землёй», а просто хорошим университетом, считает, что часть его курсов можно было бы уместить в минутный ролик, скептически относится к магической силе нетворкинга и не думает, что искусственный интеллект завтра оставит сильных специалистов без работы. Своими наблюдениями и опытом он делится в телеграм-канале: «Arseniy Zvyagintsev».

В разговоре мы обсудили, как школьнику из СНГ поступить в американский университет, почему российская математическая школа даёт заметную фору на первом курсе, как устроены гарвардские Final Clubs, почему при поиске работы непонятный фильтр HR иногда важнее диплома, чем квант отличается от трейдера, зачем рынку маркетмейкеры, откуда берутся зарплаты в $250-400 тысяч, почему Арсений собирается вернуться в Россию – и чем заканчивается приложение, полностью написанное через вайб-кодинг человеком, который не знает его технологический стек.

Читать далее

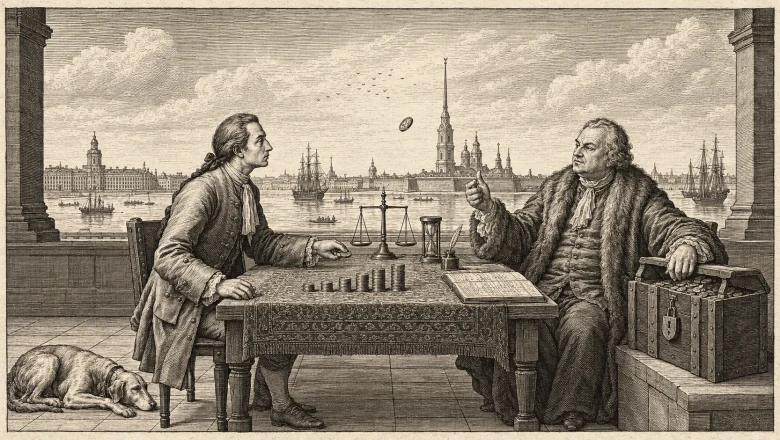
Четыре парадокса Петербургской игры: одна монета, триста лет и четыре нобелевских лауреата. Часть 1

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели7.4K

Играют двое: Пётр и Павел. Пётр подбрасывает монету, пока не выпадет орёл. Если орёл выпал при первом броске, Пётр платит Павлу 1 дукат. Если при втором, 2 дуката. Если при третьем, 4 дуката. И так далее: каждый бросок без орла удваивает выплату. За право сыграть Павел заранее платит Петру. В таком виде игру рассмотрел Даниил Бернулли в статье 1738 года.

Представьте, что Павел — это вы. Сколько вы заплатили бы Петру за одну партию? Ответьте сразу, в дукатах, и запомните ответ: он понадобится в конце статьи. Давайте пока положим, что 1 дукат равен 1 000 рублей. Сколько он стоит на самом деле, написано в спойлере после первого парадокса.

Математики XVIII века посчитали цену этой игры по верным правилам и получили ответ, который сами же сочли нелепым. В этом и есть парадокс. Спор о том, где ошибка, шёл почти триста лет и привёл ещё к трём парадоксам. В нём участвовали четверо будущих нобелевских лауреатов.

Читать далее

О роли глупости в науке

Уровень сложностиПростой
Время на прочтение18 мин
Охват и читатели8.1K

С глупостями, в научной работе и не только, мы все встречаемся довольно часто, и, увы, порой сами их говорим или совершаем. В отношении себя могу сказать это совершенно точно - в том числе, каюсь, и здесь, на Хабре.

В этой статье я попытался обобщить некоторый опыт - как свой, так и чужой, включая опыт общения с ИИ, - и тем самым понять, откуда у глупости, вообще говоря, "ноги растут". И, в частности, почему в научных публикациях глупости встречаются, скажем так, несколько чаще, чем хотелось бы, - при том, что их авторы нередко являются опытными профессионалами в своем деле. Надеюсь, анализ собственных глупостей, наряду с чужими, помог мне сделать выводы чуть более объективными.

Буду рад обсудить эту тему в комментариях.

Читать далее

ИИ доказал квазигипотезу Римана. Что дальше?

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели14K

Среди 377 результатов, о которых OpenAI объявила 6 октября 2026 года, один особенно выделялся. Компания заявила, что ей удалось доказать «квазигипотезу Римана», более слабую версию гипотезы Римана, которую можно назвать важнейшей нерешённой проблемой математики. Новое доказательство, по словам Джареда Дьюкера Лихтмана из Стэнфордского университета, стало «самым значительным на сегодняшний день достижением ИИ в математике, причём с большим отрывом».

Гипотеза Римана остаётся нерешённой уже более 160 лет. Её доказательство позволило бы математикам лучше понять природу простых чисел, одного из важнейших строительных блоков математики. И это только для начала.

Даже последствия более ограниченного результата, касающегося квазигипотезы Римана, «ошеломляют», заявил Максим Радзивилл из Нью‑Йоркского университета. «В некотором смысле подавляющее большинство следствий гипотезы Римана уже вытекает из квазигипотезы Римана».

Более того, вопреки давним ожиданиям математиков, для доказательства не потребовалось вводить никаких новых понятий. Вместо этого удалось обнаружить скрытые связи между уже известными. «Это доказательство представляет собой неожиданное объединение хорошо известных идей», — сказал Александр Данн из Технологического института Джорджии.

Доказательство частично опирается на методы, разработанные Радзивиллом и Данном. Вместе с другими специалистами по теории чисел они пытаются разобраться в доказательстве и понять, что оно может означать. Теперь они начинают получать ответы.

Читать далее
1
23 ...