Обновить
128K+

Обработка изображений *

Работаем с фото и видео

183,48
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Распознавание лиц на коленно-прикладном уровне

Время на прочтение7 мин
Охват и читатели16K
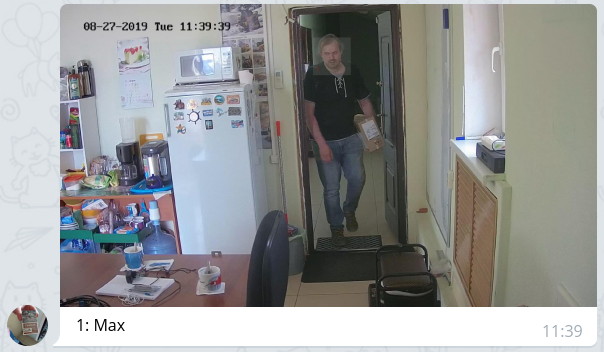
В общем и целом, распознавание лиц и идентификация людей по их результатам выглядит для аксакалов как подростковый секс — все о нем много говорят, но мало кто практикует. Понятно, что мы уже не удивляемся, что после загрузки фоточки с дружеских посиделок Facebook/VK предлагает отметить обнаруженных на снимке персон, но тут мы интуитивно знаем, что у соцсетей есть хорошее подспорье в виде графа связей персоны. А если такого графа нет? Впрочем, начнем по порядку.

Какой-то черт прется в дверь с коробкой
Читать дальше →

Облако точек. Как мы развиваем цифровые технологии в строительстве

Время на прочтение6 мин
Охват и читатели12K
Возможно, вы в курсе, а может быть и нет, но мы плотно занимаемся разработкой технологий Индустрии 4.0. IoT, машинное обучение на реальном производстве, цифровые двойники предприятий – со всеми этими вещами мы знакомы не понаслышке. Другими словами, мы знаем, как подружить «цифру» с брутальным тяжёлым машиностроением или нефтедобычей.

Но сегодня мы хотим рассказать о чуть менее героических разработках для не менее суровой строительной отрасли. Мы решили озаглавить свой рассказ «Облако точек», и совсем скоро вы поймёте, почему именно так.
Читать дальше →

Распознавание лиц на стройке

Время на прочтение6 мин
Охват и читатели53K


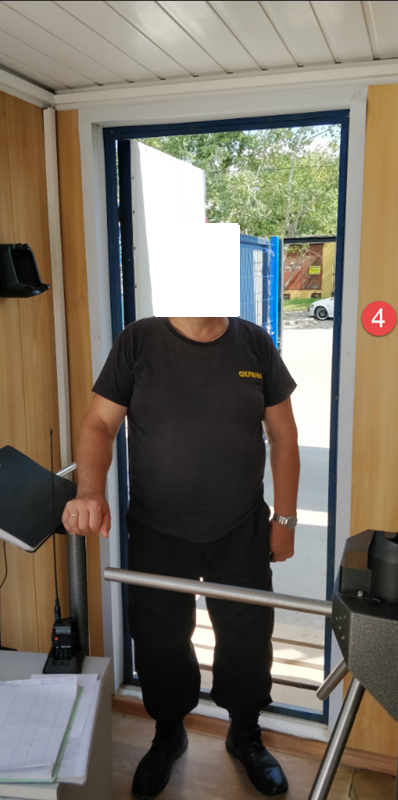
В один яркий солнечный день, когда на стройке работа просто кипит, всё вокруг ярко и позитивно, и прямо хочется вечерком пожарить шашлык, на объект проник бывший сотрудник одного из подрядчиков. Он прошёл мимо проходной, помахал рукой охраннику, который знал его в лицо (но не знал, что он уволен), и зашёл внутрь. Там он пошёл к своим друзьям из Центральной Азии. Через полчаса они уже жарили шашлык и наслаждались жизнью.

Нюанс в том, что костёр они развели между двух газовых баллонов.

Один из баллонов почему-то взорвался. Как говорится, ничего не предвещало, и вот баллон почему-то повёл себя нетипично. Если вы видели, как с этими баллонами обращаются в родных для героев рассказа регионах, то можете представить себе и их искреннее недоумение от произошедшего.

Все остались живы и даже более-менее целы (ничего необратимого). Шашлык улетел, но на орбиту не вышел. Шампуры не проткнули никого внизу и сбоку. А вот к неудавшимся космонавтам приехала полиция, скорая и чуть ли не Спортлото.

Пришлось побеспокоиться, но не так сильно, как в тот день, когда на стройку приезжала проверка от ФМС. Тогда выяснилось, что очень многие работают по документам братьев. То есть один в семье делает себе комплект бумаг, устраивается на стройку — а дальше вместо него ходит брат. Не близнец, но для отечественного неокортекса почти неотличимый.

За одного такого родственника на стройке накладывается штраф от 500 тысяч рублей и выше, и стройка может быть приостановлена от 14 до 90 дней. А это кончается очень, очень печально для генподрядчика и заказчика.

Именно после этого инцидента позвали нас решить задачу ИТ-средствами.
Читать дальше →

Установка OpenCV + CUDA на Windows

Время на прочтение7 мин
Охват и читатели45K

Введение


В данной статье речь пойдет о сборке и установке OpenCV 4 для C/C++, Python 2 и Python 3 из исходных файлов с дополнительными модулями CUDA 10 на ОС Windows.

Я постарался включить сюда все тонкости и нюансы, с которыми можно столкнуться в ходе установки, и про которые не написано в официальном мануале.

Читать дальше →

Онлайн сервис «Анализ скорости при ДТП по видеозаписи»

Время на прочтение6 мин
Охват и читатели46K

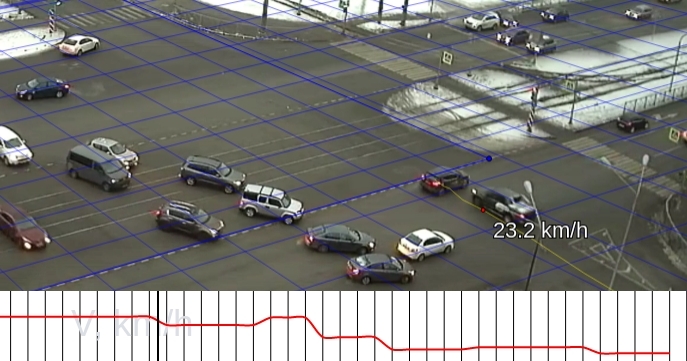
В тестовой версии заработал онлайн сервис, который показывает текущую скорость интересующих нас объектов (автомобилей и других средств передвижения) по записям с видеокамер на перекрестках.
Читать дальше →

Сложности применения технологий OCR в DLP-системах, или Как мы OCR готовим

Время на прочтение10 мин
Охват и читатели12K
imageРешение задачи распознавания изображений (OCR) сопряжено с различными сложностями. То картинку не получается распознать из-за нестандартной цветовой схемы или из-за искажений. То заказчик хочет распознавать все изображения без каких-либо ограничений, а это далеко не всегда возможно. Проблемы разные, и решить их сходу не всегда удается. В этом посте мы дадим несколько полезных советов, исходя из опыта разруливания реальных ситуаций у заказчиков.
Читать дальше →

Строим систему распознавания лиц на основе Golang и OpenCV

Время на прочтение4 мин
Охват и читатели21K

OpenCV — библиотека, разработанная для проектов по компьютерному зрению. Ей уже около 20 лет. Я использовал ее еще в колледже и до сих пор применяю для своих проектов на C++ и Python, поскольку она имеет неплохую поддержку этих языков.

Но когда я начал изучать и использовать Go, мне стало интересно, можно ли применить OpenCV для работы с этим языком. В то время уже существовали примеры и туториалы по интеграции, но мне показалось, что они слишком сложные. Чуть позже мне в руки попался враппер, созданный командой The Hybrid Group. В этой статье я покажу, как начать с GoCV, разработав простую систему распознавания лиц с каскадами Хаара (Haar Cascades).
Читать дальше →

Доступное объяснение алгоритма коллапса волновой функции

Время на прочтение9 мин
Охват и читатели48K
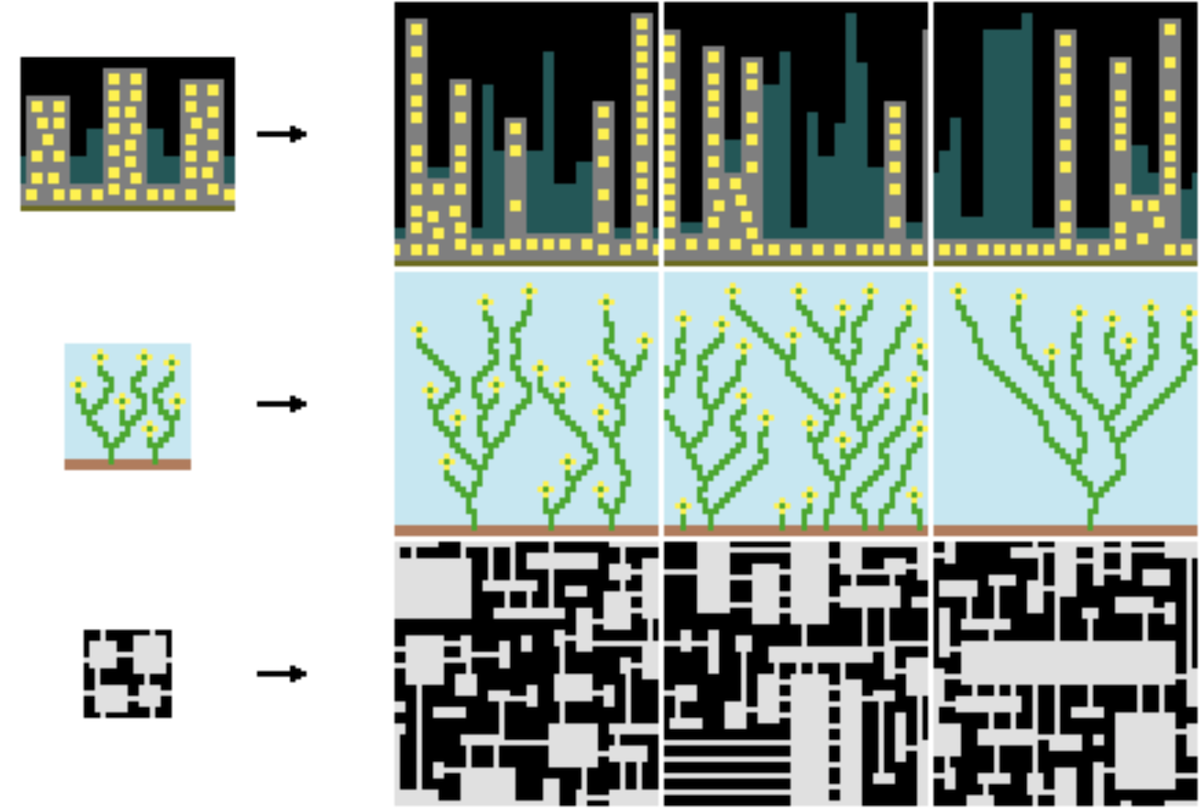
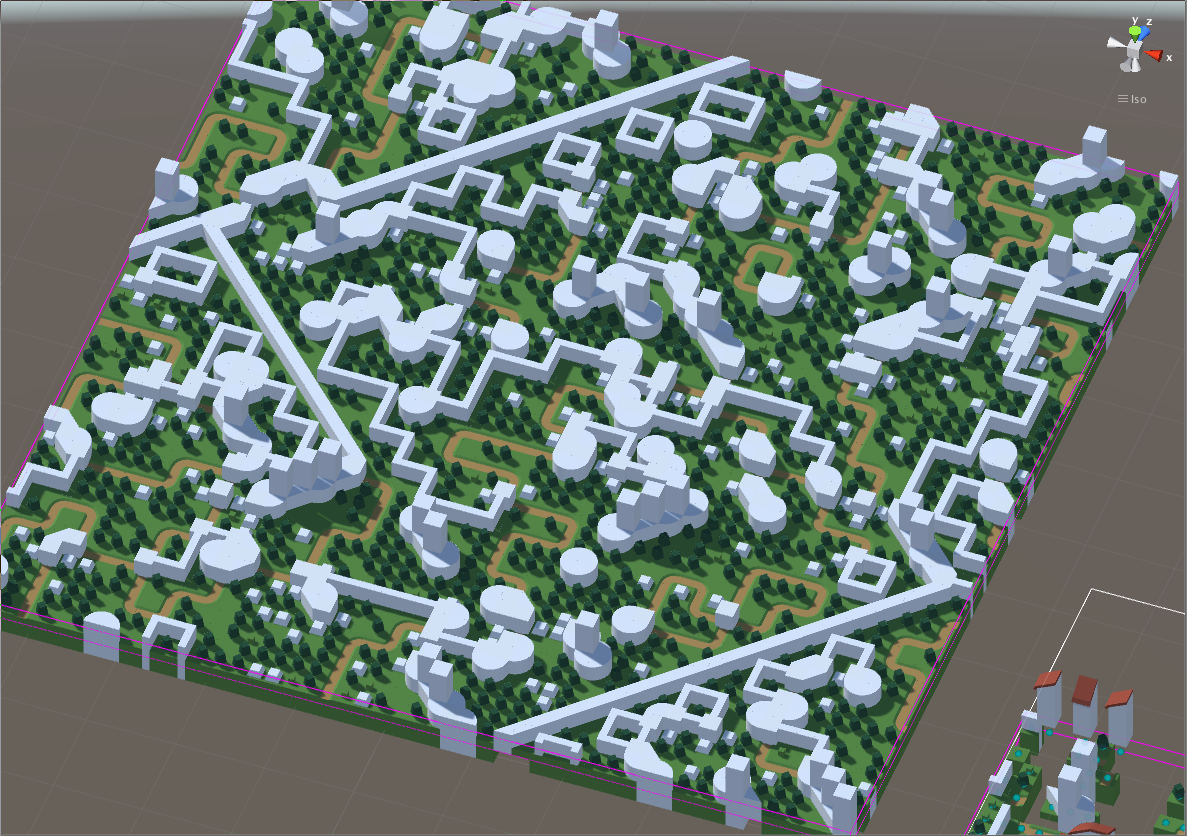
Алгоритм коллапса волновой функции (Wavefunction Collapse Algorithm) учит компьютер импровизировать. На входе он получает архетипичные данные и создаёт процедурно генерируемые данные, похожие на исходные.


(Источник)

Чаще всего он используется для создания изображений, но может также строить города, скейтпарки и писать ужасные стихи.


(Источник)

Коллапс волновой функции — это очень независимо мыслящий алгоритм, не требующий практически никакой помощи или инструкций извне. Вам нужен только пример стиля, которого нужно достичь, а всё остальное он сделает сам. Несмотря на свою самодостаточность, он на удивление прост. Он не использует никаких нейронных сетей, случайных лесов или чего-то другого, похожего на машинное обучение. Если разобраться с идеей, он станет для вас очень понятным и интуитивным.

Большинство реализаций и объяснений коллапса волновой функции — это полная, оптимизированная по скорости версия алгоритма. Разумеется, все они важны и необходимы, но в них сложно разобраться с нуля. В этом посте я буду объяснять всё понятным я простым языком, сосредоточившись на версии Wavefunction с ограничениями, которую я назвал Even Simpler Tiled Model. Кроме того, я выложил пример реализации ESTM на Github. Код в нём неэффективный и медленный, но очень хорошо читаемый и подробно прокомментирован. Как только вы разберётесь в технологии, лежащей в основе ESTM, то станете ближе к пониманию более сложных версий алгоритма. Если хотите понять алгоритм коллапса волновой функции, то эта статья будет хорошим началом.
Читать дальше →

Трагедия не приходит одна

Время на прочтение5 мин
Охват и читатели9.2K

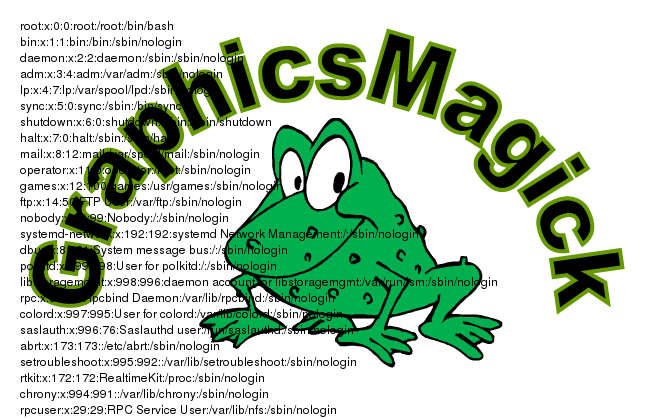
В 2016 году уязвимость ImageTragick в библиотеке ImageMagick наделала много шума. Как способ снижения риска предлагалось использовать GraphicsMagick — форк библиотеки ImageMagick, нацеленный на более стабильный и производительный API. Оригинальная уязвимость CVE-2016-3717, обнаруженная stewie, позволяла злоумышленнику прочитать произвольный файл на файловой системе при помощи специально созданного изображения. Сегодня я рассмотрю аналогичную уязвимость в GraphicsMagick, обнаруженную мной в ходе анализа исходного кода библиотеки.

Читать дальше →

Туристы помогают ученым оценить численность крупных хищников

Время на прочтение3 мин
Охват и читатели1.8K


Гражданско-добровольный мониторинг животных с помощью выданных путешественникам GPS-трекеров и анализа их фотографий оказался намного дешевле, чем использование фото- и аудио- ловушек.
Читать дальше →

Безумный конвертер GIF'ок в анимированные стикеры для Telegram

Время на прочтение5 мин
Охват и читатели59K
Вместо тысячи слов...


xZibit тоже рад, ведь здесь GIF вставлены в стикеры, чтобы быть вставлеными в GIF для КДПВ!

А теперь о подробностях реализации.
Читать дальше →

Опыт моделеварения от команды Computer Vision Mail.ru

Время на прочтение15 мин
Охват и читатели12K


Меня зовут Эдуард Тянтов, я руковожу командой Computer Vision в Mail.ru Group. За несколько лет существования наша команда решила десятки задач компьютерного зрения, и сегодня расскажу вам о том, какие методики мы используем для успешного создания моделей машинного обучения, которые работают на широком спектре задач. Поделюсь трюками, которые могут ускорить получение модели на всех этапах: постановка задачи, подготовка данных, обучение и развертывание в продакшен.
Читать дальше →

Издевательски точный, быстрый и легковесный поиск баркодов через семантическую сегментацию

Время на прочтение10 мин
Охват и читатели12K

Поиск объектов на изображениях? Имея обучающую выборку и минимальный набор знаний о нейросетях, любой студент сегодня может получить решение определенной точности. Однако большинство нейросетей, использующихся для решения этой задачи, достаточно глубокие, а соответственно, требуют много данных для обучения, сравнительно медленно работают на этапе inference (особенно если на устройстве отсутствует GPU), много весят и достаточно энергозатратны. Все вышеперечисленное может быть весьма критично в определенных случаях, в первую очередь, для мобильных приложений.

Баркоды — объекты с достаточно простой структурой. В ходе исследований у нас получилось с помощью сравнительно оригинального подхода искать такие простые объекты весьма точно (мы побили state-of-the-art) и достаточно быстро (real-time на среднем CPU). Плюс наш детектор очень легкий, имеющий всего 30к весов. О результатах нашего исследования мы и расскажем в этой статье.

Читать дальше →

Ближайшие события

Нейросеть в стекле. Не требует электропитания, распознаёт цифры

Время на прочтение2 мин
Охват и читатели40K
image

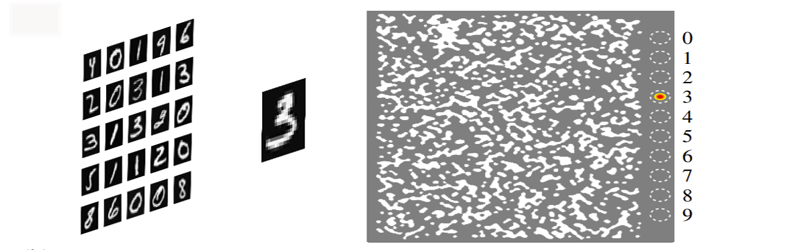
Все мы знакомы с такой способностью нейронных сетей, как распознавание рукописного текста. Основы этой технологии существуют уже много лет, но, лишь относительно недавно, скачок в области компьютерных мощностей и параллельной обработки данных позволили сделать из этой технологии очень практичное решение. Тем не менее, это практичное решение, в основе своей, будет представлено в виде цифрового компьютера многократно изменяющего биты, точно так же, как и при выполнении любой другой программы. Но в случае с нейронной сетью, разработанной исследователями из университетов Wisconsin, MIT, и Columbia, дело обстоит по-другому. Они создали стеклянную панель, не требующую собственного электропитания, но при этом способную распознавать рукописные цифры.
Читать дальше →

Как мы обучили нейронную сеть классифицировать шурупы

Время на прочтение10 мин
Охват и читатели29K
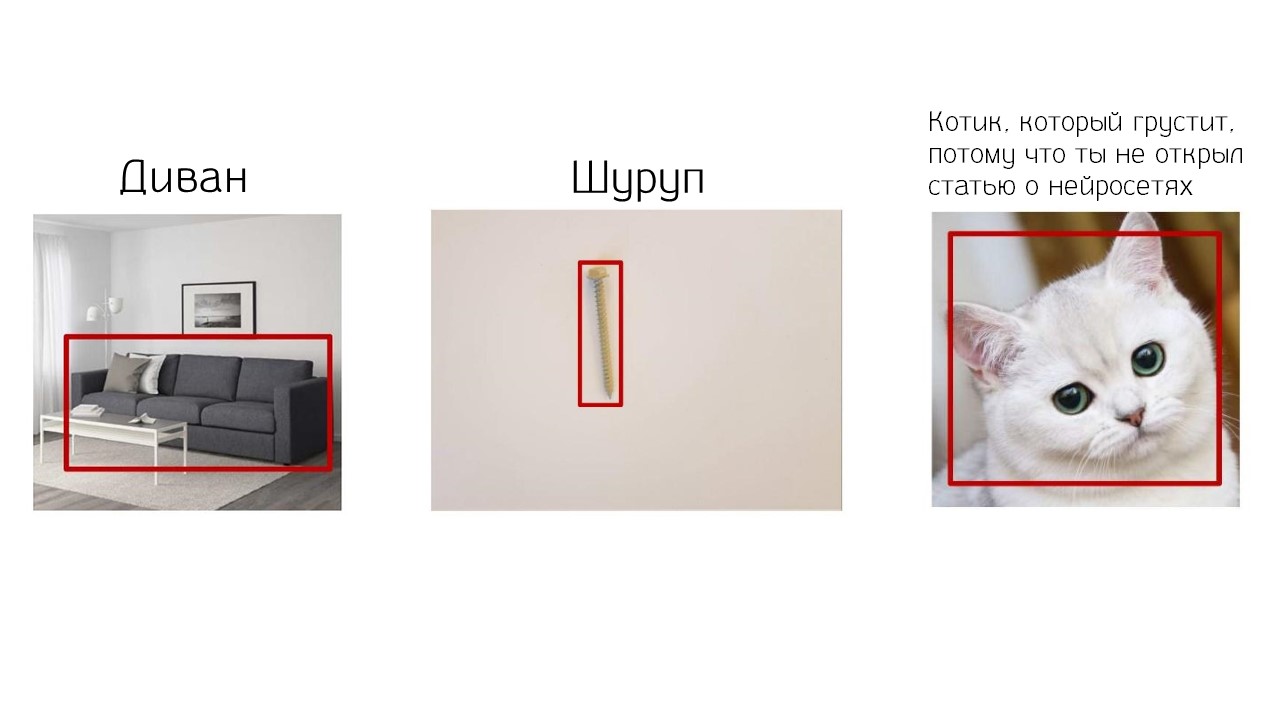
Нейронная сеть может опознать котика на фотографии, найти диван, улучшить видеозапись, нарисовать картинку из щенят или простого наброска. К этому мы уже привыкли. Новости о нейросетях появляются почти каждый день и стали обыденными. Компании Grid Dynamics поставили задачу не обыденную, а сложную — научить нейросеть находить специфический шуруп или болт в огромном каталоге интернет-магазина по одной фотографии. Задачка сложнее, чем найти котика.


Проблема интернет-магазина шурупов — в ассортименте. Тысячи или десятки тысяч моделей. У каждого шурупа свое описание и характеристики, поэтому на фильтры нет надежды. Что делать? Искать вручную или искать в гипермаркете на полках? В обоих случаях это потеря времени. В итоге клиент устанет и пойдет забивать гвоздь. Чтобы помочь ему, воспользуемся нейросетью. Если она может находить котиков или диваны, то пусть занимается чем-то полезным — подбирает шурупы и болты. Как научить нейросеть подбирать для пользователя шурупы быстро и точно, расскажем в расшифровке доклада Марии Мацкевичус, которая в компании Grid Dynamics занимается анализом данных и машинным обучением.

Как распознать текст с фото: новые возможности фреймворка Vision

Время на прочтение6 мин
Охват и читатели9.4K
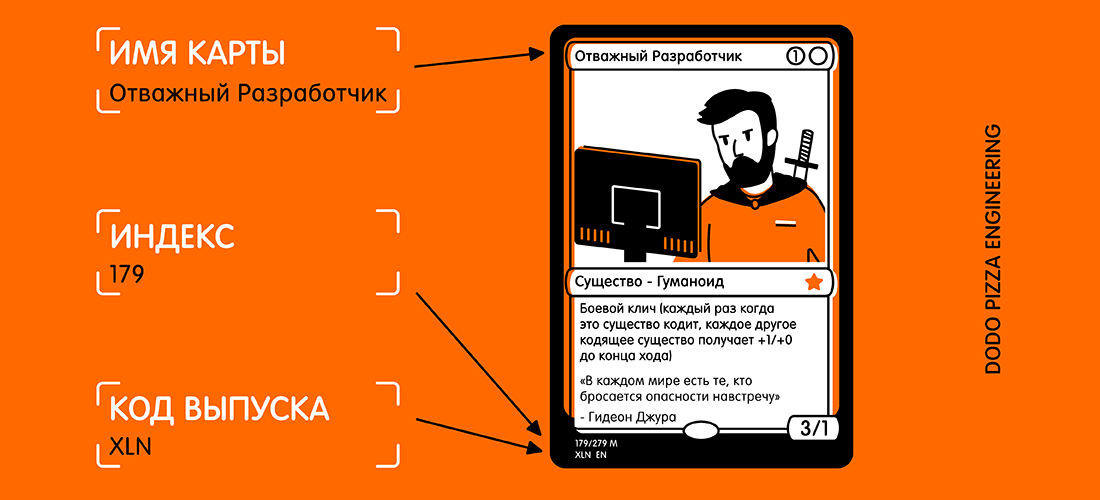
Теперь фреймворк Vision умеет распознавать текст по-настоящему, а не как раньше. С нетерпением ждём, когда сможем применить это в Dodo IS. А пока перевод статьи о распознавании карточек из настольной игры Magic The Gathering и извлечении из них текстовой информации.


Читать дальше →

Вижу, значит существую: обзор Deep Learning в Computer Vision (часть 2)

Время на прочтение18 мин
Охват и читатели47K
Продолжаем постигать современную магию (компьютерное зрение). Часть 2 не значит, что нужно сначала читать часть 1. Часть 2 значит, что теперь всё серьёзно — мы хотим понять всю мощь нейросетей в зрении. Детектирование, трекинг, сегментация, оценка позы, распознавание действий… Самые модные и крутые архитектуры, сотни слоёв и десятки гениальных идей уже ждут вас под катом!


Читать дальше →

Агро-робот с ИИ научился аккуратно собирать с грядки только созревший салат

Время на прочтение4 мин
Охват и читатели9.5K

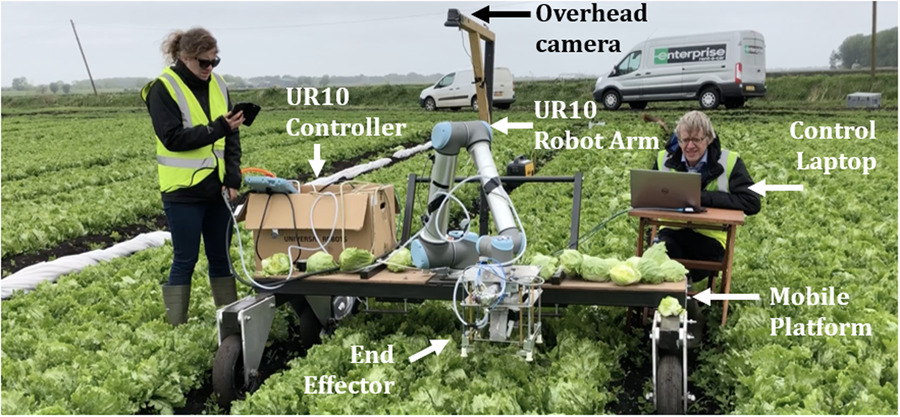
Многие виды растений и сельхозкультур до сих пор собираются только вручную.

Инженеры из Кембриджского университета (Великобритания) создали рабочий прототип роботизированного сборщика урожая, способного самостоятельно распознавать готовые к срезанию неповрежденные кочаны салата, а также аккуратно их обрабатывать и собирать.
Читать дальше →

Преобразуем изображение в звук — что можно услышать?

Время на прочтение5 мин
Охват и читатели36K
Привет Хабр.

В недавней публикации здесь на сайте описывалось устройство, позволяющее незрячим людям «видеть» изображение, преобразуя его с помощью звуковых волн. С технической точки зрения, в той статье не было никаких деталей вообще (а вдруг украдут идею за миллион), но сама концепция показалась интересной. Имея некоторый опыт обработки сигналов, я решил поэкспериментировать самостоятельно.


Что из этого получилось, подробности и примеры файлов под катом.
Читать дальше →

Распознавание источников освещения на картах окружения

Время на прочтение6 мин
Охват и читатели3.4K
image

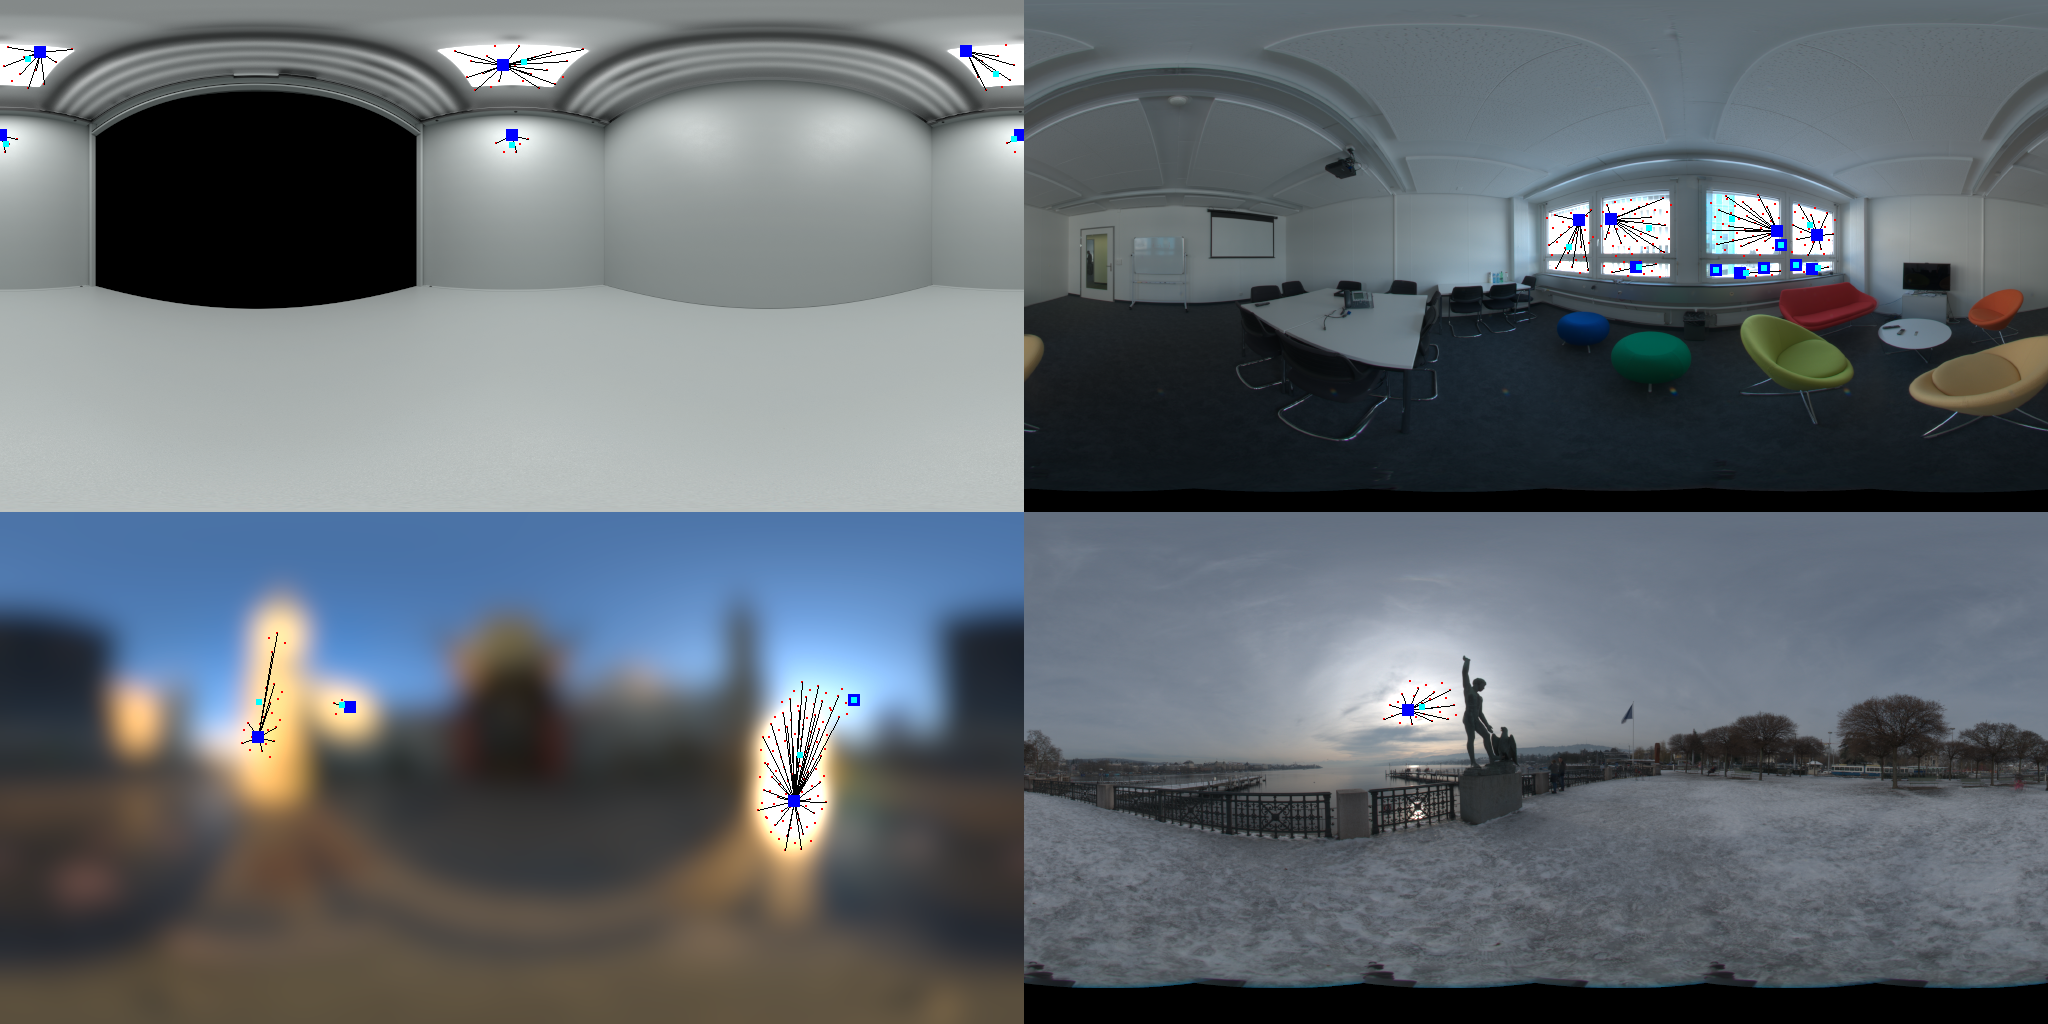
В этой статье представлена реализация на Python алгоритма распознавания источников освещения на картах окружения (LDR или HDR) при помощи равнопромежуточной проекции (equirectangular projection). Однако после внесения незначительных изменений её также можно использовать с простыми фоновыми изображениями или кубическими картами. Примеры возможного применения алгоритма: программы трассировки лучей, в которых требуется распознавать первичные источники освещения для испускания из них лучей; в растеризованных рендерерах он может применяться для отбрасывания теней, использующих карту окружения; кроме того, алгоритм также можно применять в программах устранения засветов, например в AR.

Алгоритм состоит из следующих этапов:

  1. Снижение разрешения исходного изображения, например, до 1024.
  2. Преобразование изображения в яркость (luminance), при необходимости с размытием изображения.
  3. Применение метода квази-Монте-Карло.
  4. Преобразование из сферических координат в равнопромежуточные.
  5. Фильтрация сэмплов на основании яркости соседа.
  6. Сортировка сэмплов на основании их яркости.
  7. Фильтрация сэмплов на основании евклидовой метрики.
  8. Слияние сэмплов при помощи алгоритма Брезенхэма.
  9. Вычисление позиции кластера освещения на основании его яркости.

Существует множество алгоритмов снижения разрешения изображений. Билинейная фильтрация — самый быстрый или простой в реализации, к тому же он лучше всего подходит в большинстве случаев. Для преобразования яркости и в LDR-, и HDR-изображениях можно использовать стандартную формулу:

  lum = img[:, :, 0] * 0.2126 + img[:, :, 1] * 0.7152 + img[:, :, 2] * 0.0722

Дополнительно можно применить к изображению яркости небольшое размытие, например, в 1-2 пикселя для изображения разрешением 1024, для устранения всех высокочастотных деталей (в частности, вызванных снижением разрешения).
Читать дальше →