Обновить
512K+

Python *

Высокоуровневый язык программирования

303,58
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Разработка real-time приложений с Python и WebSocket

Уровень сложностиПростой
Время на прочтение15 мин
Охват и читатели93K

Real-time приложения, как следует из названия, предоставляют мгновенный обмен данных и информации между сервером и клиентом. Они встречаются повсеместно в различных сферах, начиная от социальных сетей и мессенджеров, и заканчивая финансовыми торговыми платформами, мониторингом систем, онлайн-играми и многими другими областями. Подобные приложения обеспечивают пользовательский опыт, который чрезвычайно близок к реальному времени.

Читать далее

Как в 180 000 раз ускорить анализ данных с помощью Rust

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели20K

В этой статье я опишу одно из последних своих дерзновений в сфере оптимизации производительности с помощью Rust. Надеюсь, что в ней вы откроете для себя какие-то новые приёмы для написания быстрого кода на Rust.
Читать дальше →

Как мы заинжектили кнопку на Behance

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели3K

Дело было год назад, не помню что я там забыл, но мне определенно хотелось скачать какую‑то картинку с behance.net, но как вы знаете — опции скачать там нет. Зная, как работает веб — я без проблем забрал нужное изображение найдя ссылку в HTML коде, но не все готовы так заморачиваться, поэтому я решил автоматизировать этот процесс.

Так появился python‑модуль behance‑py, который, если верить статистике с pepy.tech, имеет более 5 тысяч установок и расширение для Chrome, о котором более подробно в статье.

Читать далее

“Ну и долго мне ещё до магазина?” Или пара слов о геоинформационном анализе с помощью Python

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели7.7K

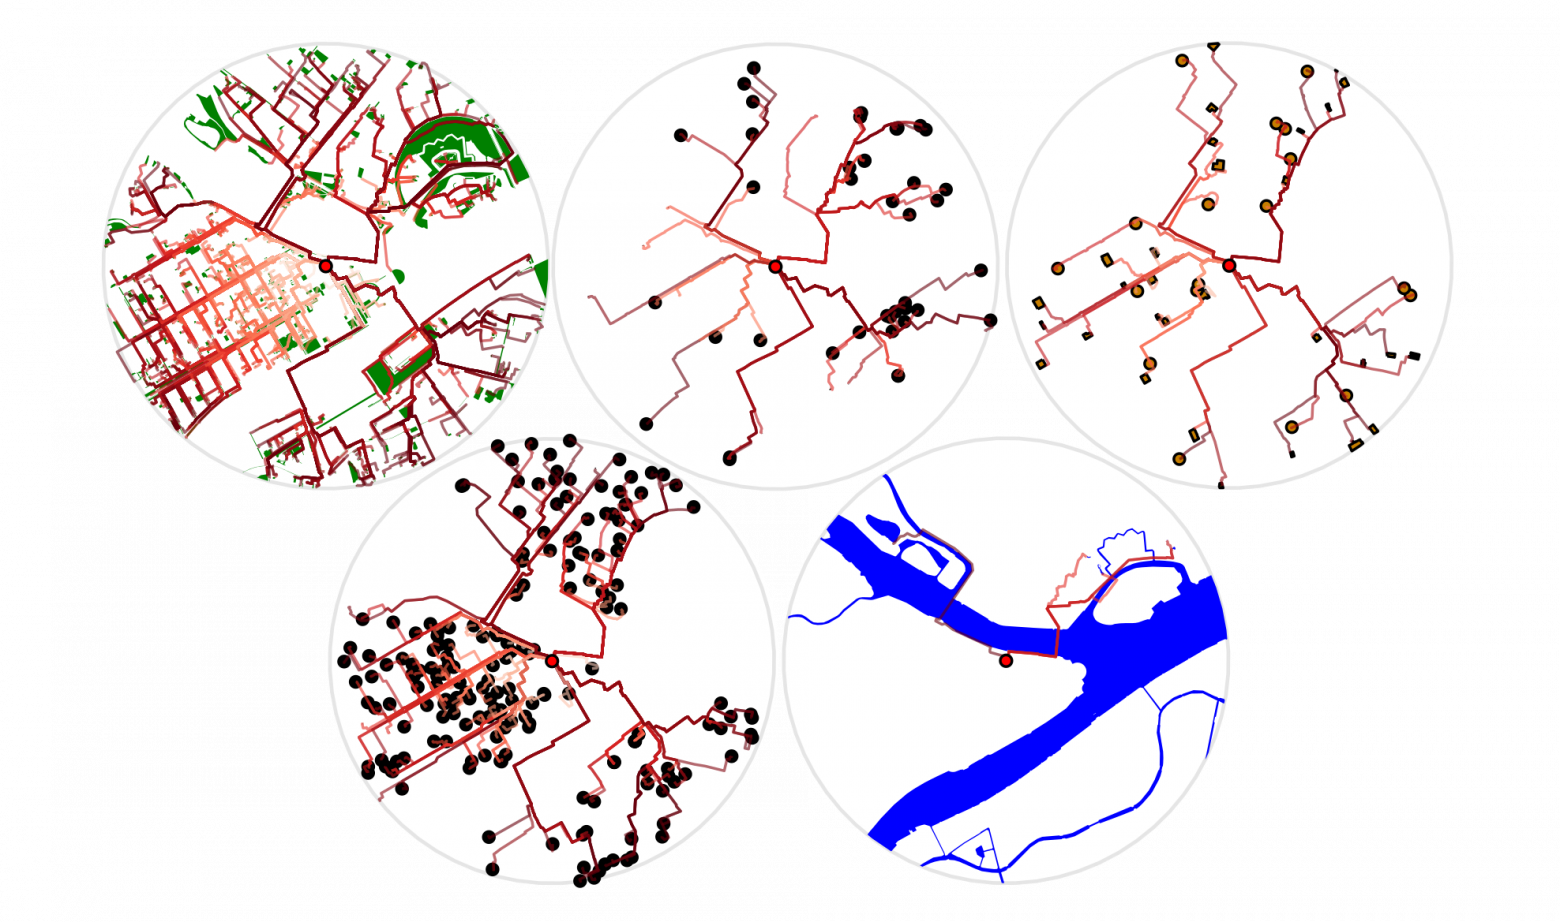
Привет, хабр! Сегодня мы хотели бы продолжить тему обработки пространственных данных средствами Python библиотеки estaty. Мы уже рассказывали о том как можно Объединять открытые данные Open Street Map и Landsat для уточнения площадей зеленых зон вокруг объектов недвижимости.

Теперь же поговорим о более сложном анализе

Ну правда, долго?

Борьба с несбалансированными данными

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели37K

Привет,Хабр!

Почему несбалансированные данные - это такая большая проблема? Все начинается с того, что в реальном мире классы могут быть не равномерно представлены в наших данных. Например, в задаче обнаружения мошенничества с кредитными картами, обычные транзакции будут составлять большую часть данных, в то время как мошеннические операции будут редкими. Если модель обучается на таких данных, она склонна к смещению в сторону более представленного класса, и это может привести к плохим результатам в реальном мире.

Борьба с несбалансированными данными - это не просто задача улучшения производительности моделей, это вопрос надежности и безопасности.

Что же делает борьбу с несбалансированными данными такой сложной задачей?

Читать далее

Головоломки на Python: Увлекательный Путь к Мастерству в Программировании

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели23K

Головоломки на Python: Увлекательный Путь к Мастерству в Программировании

В этой статье я представляю серию увлекательных головоломок, разработанных для развития навыков программирования на Python. Читатели решат задачи, используя различные аспекты языка, от криптографии до рекурсии. Каждая головоломка сопровождается подробным объяснением и примерами кода, сделав обучение интересным и практичным.

Читать далее

Celery: изучаем на реальных примерах ч.1

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели52K

Лучший способ что-то понять - попробовать на практике, а лучшая практика - это реальные примеры. В этой статье мы узнаем шесть основных сценариев использования Celery. Разберем основные методы и аргументы, которые точно пригодятся. От асинхронной обработки задач до управления временем выполнения и обработки ошибок - вы получите цельное представление о том, как Celery может решать ваши задачи.

Читать далее

Реализация консенсусного алгоритма Raft

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели7.3K

Привет, Хабр!

Когда речь идет о распределенных системах и сетевых приложениях, консенсусный алгоритм становится must have. Эти алгоритмы играют ключевую роль в обеспечении надежности, согласованности и целостности данных в условиях, когда у нас есть несколько участников (узлов), работающих в сети. Например, множество современных распределенных баз данных, файловых систем и кластеров используют консенсусные алгоритмы для координации операций между разными узлами.

В сценариях, где имеются несколько серверов, подразумевается, что они должны приходить к единому решению относительно каких-либо операций, таких как запись данных, выбор лидера или другие важные решения. Консенсусный алгоритм служит мостом между параллельным выполнением и сохранением согласованности.

К примеру, у вас есть распределенный кластер серверов, которые отвечают за хранение критически важных данных. Если один из серверов хранит информацию о балансе банковского счета пользователя и другой сервер отвечает за транзакции, нам нужно обеспечить согласованность данных между ними. Консенсусный алгоритм помогает решить вопросы вроде "Что произойдет, если сервер с балансом откажет?"

В этой статье, мы рассмотрим один из наиболее популярных консенсусных алгоритмов - Raft. Рассмотрим его ключевые компоненты, алгоритм выбора лидера, обеспечение целостности данных и оптимизации для улучшения производительности.

Читать далее

Как написать новостной Телеграм-канал если ты не программист. Часть первая

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели16K

Всем привет! Попробую написать трилогию покорения основ Python, отражающую мой путь любителя с “паяльником”. Тут не будет основ, чистого кода, отсылок к требованиям PEP-8, практически не будет ООП.

Всех суровых Senior’ов, читающих данный материал, прошу понять и простить. Я не работаю и никогда не работал разработчиком (по крайней мере пока, но открыт к предложениям:)), не учил алгоритмов (кроме пузырька) и многого не знаю. Мне просто интересно, как мне кажется, “программировать”, а иногда даже хочется поделиться своим опытом.

Итак, что же мы будем делать. Это будет новостной ТГ-канал - новости в него будут попадать с новостного сайта с RSS-лентой. Администратор сможет модерировать новости, прежде чем они попадут в канал через ТГ-бот. Также возможна реализация автоматического рерайта/перевода новостей при помощи Chat-GPT или иной текстовой AI.

В процессе работы мы “пощупаем” работу с внешними библиотеками (их будет достаточно много) и виртуальным окружением venv, спарсим RSS-ленту и страницу новостей, заглянем в мир асинхронного Python, коснемся основ работы с SQLite и даже попробуем задеплоить нашего бота на VSD-сервер через Docker-контейнер.. если у меня хватит на описание всего этого времени и сил:)

В текущем и будущих постах на Хабр в рамках этого цикла я буду давать ссылки на полезный и нужный, на мой взгляд, тематический материал которым пользовался сам как для изучения основ Python, так и непосредственно для создания этого проекта.

Для хорошего старта всем начинающим и слабо ориентирующимся в синтаксисе Python рекомендую посмотреть вводный курс CS-50. Тут ссылка на свежую версию на-английском, на просторах YouTube есть более древняя, но переведенная на русский версия.

Читать далее

Как получить полезную информацию из своих категориальных признаков?

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели19K

В этой статье я выскажу свою точку зрения о том, что из себя представляют категориальные признаки. Расскажу про способы работы с ними, которыми пользуюсь сам как антифрод-аналитик в Каруне.

Читать далее

Что выбрать новичку: Python или Java?

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели52K

Волна цифровизации неумолимо нарастает, равно как и количество начинающих программистов. Стоит ли поддаться общей тенденции сегодня, и если да, то с какого языка лучше начать своё погружение в мир кода?

Читать далее

Работа с временными рядами в Python. Часть 2

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели22K


Добро пожаловать во вторую часть нашей серии статей "Работа с временными рядами в Python." В первой части, мы ознакомились с основами работы с временными рядами и научились анализировать и визуализировать их. Теперь мы переходим к более продвинутым аспектам этой увлекательной темы.
Читать дальше →

У нас в Excel поселился замечательный Python

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели50K

На Хабре уже была новость об этом знаменательном событии. Правда, она похожа на пересказ официального пресс-релиза Microsoft, но такой и должна быть "новость".

Читать далее

Ближайшие события

Как устроен GIL (Global Interpreter Lock) в Python: влияние на многозадачность и производительность

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели45K

Привет, уважаемые читатели!

GIL, или Global Interpreter Lock десятилетиями оставался темой обсуждения и дебатов среди питонистов.

Что такое GIL? GIL, сокращение от Global Interpreter Lock, представляет собой важную концепцию в Python. Он представляет собой мьютекс, который блокирует доступ к объекту Python interpreter в многопоточных средах, разрешая выполнять лишь одну инструкцию за раз. Этот механизм, хоть и заботится о безопасности и целостности данных, одновременно становится камнем преткновения для тех, кто стремится максимально задействовать многозадачность и использовать полностью потенциал многоядерных процессоров.

Читать далее

Выявление схожести между произведением искусства из коллекции музея и работами автора методами ML

Уровень сложностиПростой
Время на прочтение13 мин
Охват и читатели1.8K

Идею работы: «Похоже ли произведение искусства из коллекции музея на работы автора?» я придумала под датасет Музея MoMa. Конечно, хотелось бы установить: оригинал или подделка? Но для ответа на такой категоричный вопрос данных оказалось недостаточно.

У проекта было несколько целей. Разработка модели машинного обучения, способной оценить схожесть произведения искусства из коллекции музея на основе анализа её характеристик и работ автора, её создавшего. Исследование различных моделей машинного обучения для выявления схожести работ, таких как Logistic Regression, Decision Tree, Random Forest, LightGBM, CatBoost. Оценка точности и эффективности моделей, выбор лучшей. Выработка рекомендаций для дальнейшего улучшения системы выявления схожести, чтобы сделать её более точной и полезной для анализа произведений искусства.

Читать далее

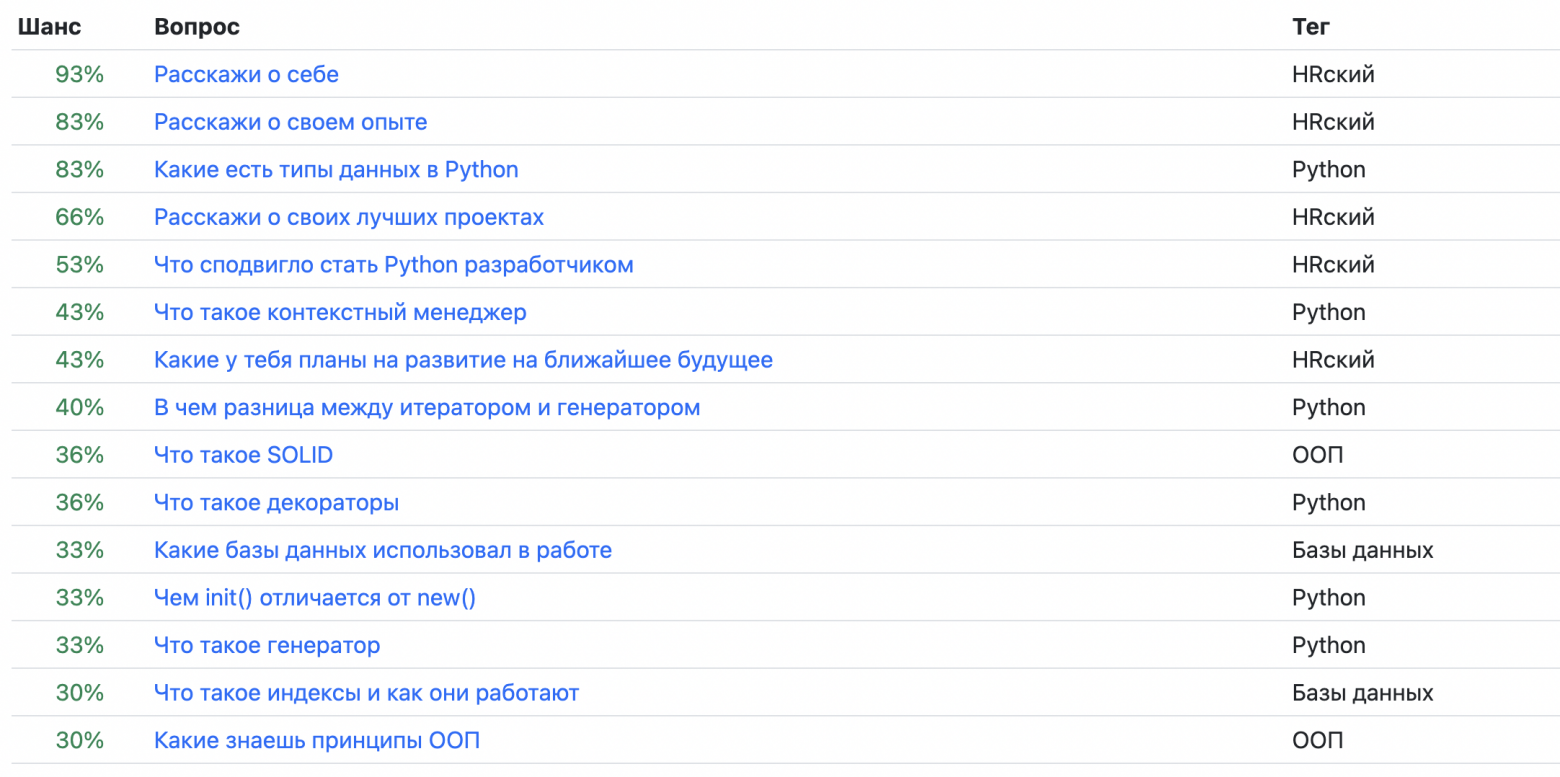
Анализ 10 000 вопросов с технических интервью: частотность и вероятность встречи

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели43K

Привет, Хабр! Я проанализировал 600 публичных мок-интервью с YouTube и собрал из них 10 000 уникальных вопросов. Затем посчитал, как часто они встречаются, и определил вероятность появления каждого вопроса. У меня есть данные по 20 профессиям, включая frontend, python, java-разработчика, специалиста по тестированию и многих других.

Читать далее

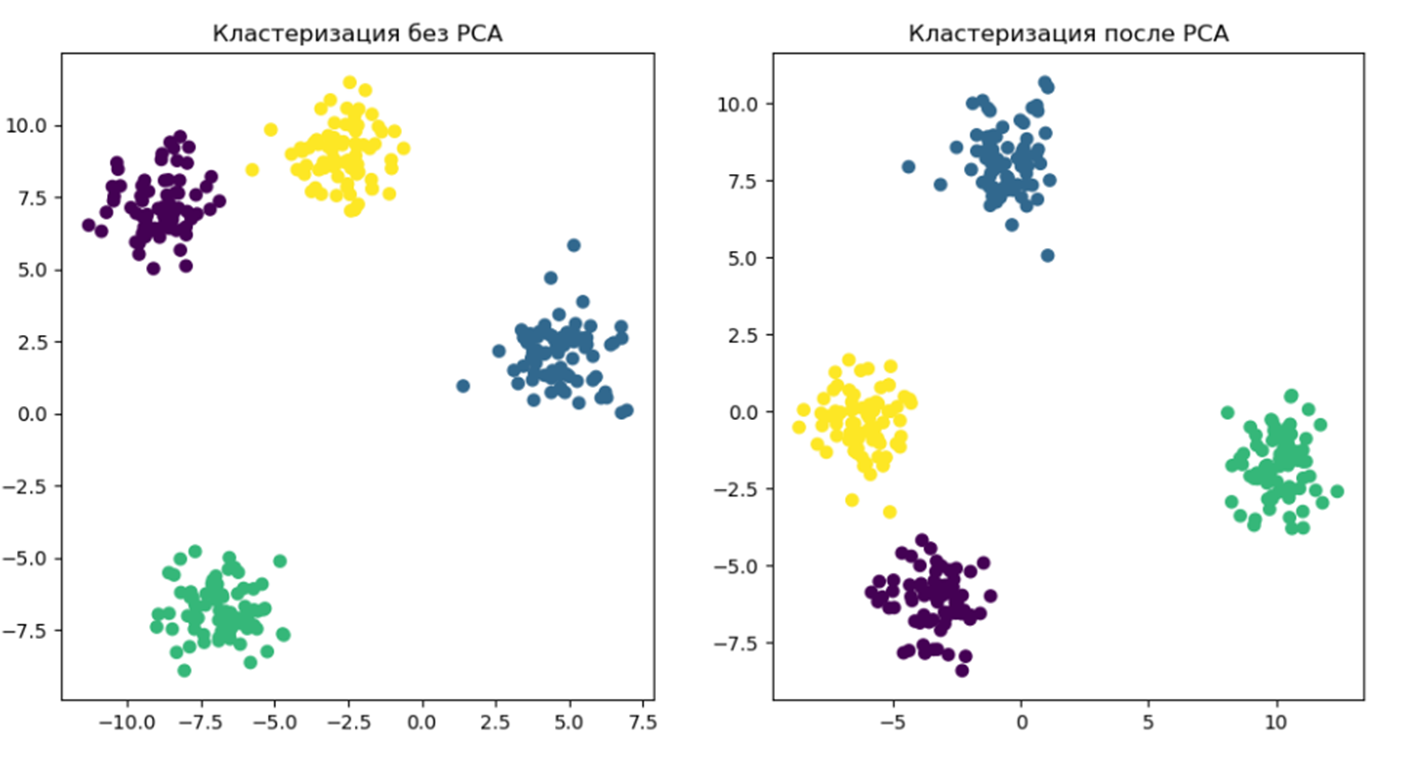
Как применять метод PCA для уменьшения размерности данных

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели35K

Одной из ключевых задач при работе с данными является уменьшение размерности данных, чтобы улучшить их интерпретируемость, ускорить алгоритмы обучения машин и, в конечном итоге, повысить качество решений. Сегодня мы поговорим о методе, который считается одним из наиболее мощных инструментов в арсенале данных разработчиков — методе главных компонент, или PCA (Principal Component Analysis).

Читать далее

Малоизвестные библиотеки Python для анализа данных, которые сделают вашу жизнь проще

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели35K

Привет Хабр! В этой статье мы рассмотрим некоторые полезные библиотеки Python для задач обработки данных, с которыми, возможно, вы еще не знакомы. Хотя для задач машинного обучения на ум приходят такие библиотеки, как pandas, numpy, scikit-learn, keras, tensorflow, matplotlib и т.д., но всегда полезно знать о других предложениях Python, особенно если это поможет улучшить ваши проекты.

Читать далее

Как провести анализ рекламных креативов с помощью генеративных сетей

Время на прочтение13 мин
Охват и читатели2.3K

Привет, Хабр!

На связи Сергей и Григорий - Data Scientist'ы.

Сегодня расскажем, как заняли 2 место в общем зачете AI Generative Product Hackathon, инициированного Napoleon IT,  и 1 место в кейсе по анализу рекламных креативов для крупной российской фармацевтической компании.

Читать далее

Как реализовать систему рекомендаций на сайте просмотра кино

Уровень сложностиПростой
Время на прочтение13 мин
Охват и читатели5.3K

Привет, Хабр!

Когда вы открываете ваш любимый стриминговый сервис, и перед вами развертывается каталог фильмов и сериалов, точно соответствующих вашим вкусам - это великолепное ощущение, когда ваш сервис знает, что именно вас интересует, и предлагает именно то, что вы искали.

Рекомендательные системы не только облегчают жизнь пользователям, но и повышают уровень удовлетворенности клиентов, а также помогают увеличивать доходы компаний.

Читать далее