Обновить
512K+

Python *

Высокоуровневый язык программирования

302,98
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Русский LLM-помощник (saiga) с кэшем, используя RAG (Retrieval-Augmented Generation)

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели38K

Используя технику Retrieval-Augmented Generation ("Поисковая расширенная генерация"), мы настроим русскоязычного бота, который будет отвечать на вопросы потенциальных работников для выдуманного свечного завода в городе Градск.

Читать далее

Работа с временными рядами в Python. Часть 1

Уровень сложностиПростой
Время на прочтение13 мин
Охват и читатели67K


Аналитика данных стала неотъемлемой частью современного бизнеса и научных исследований. И одним из ключевых аспектов анализа данных являются временные ряды. Эффективная работа с временными рядами играет критическую роль в прогнозировании, стратегическом планировании и принятии решений в различных отраслях.

Временные ряды — это наборы данных, где каждая точка данных связана с определенным моментом времени. Это может быть что угодно, от ежедневных финансовых показателей до ежечасных кликов на веб-сайте или даже месячных показателей погоды. Зачем нам это нужно? Потому что временные ряды предоставляют нам ценную информацию о том, как меняются данные со временем.
Читать дальше →

Python-разработчик: из новичка в профессионалы. Как начать свой путь в освоении языка?

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели40K

В статье рассказали:

 Почему многие крупные компании до сих выбирают Python

 Какие знания нужны разработчику на каждой из ступени грейдов

 Где эти знания получить.

Читать далее

Airflow в Kubernetes. Часть 1

Уровень сложностиСредний
Время на прочтение10 мин
Охват и читатели16K

Приветствую!

На пути инженера данных часто встречаются задачи связанные с DevOps. Одна из таких - развернуть Airflow в Kubernetes кластере. Если до этого похожего опыта работы не было, то эта задача может показаться нетривиальной. Конечно, можно выполнить несколько команд из официального гайда, но если нужно будет что-то поправить, то без понимания, что происходит внутри, обойтись будет сложно.

Эта статья призвана  облегчить данную задачу. Она поможет тем, кто уже работал с Airflow, но еще не касался технологии Kubernetes. 

Читать далее

Взлетаем на backend: наш путь к победе в номинации «Лучший backend-разработчик» на хакатоне от ООО «Лента» и ЯП

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели6.3K

«Недоджун» решил проверить свои силы и поучаствовать в хакатоне, который организовали Яндекс Практикум и ООО «Лента».

Читать далее

Создание искусственного интеллекта для игры Баше без нейронных сетей

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели3.6K

В статье речь пойдёт про машинное обучение. Приведу одно из определений этого понятия: использование математических моделей данных, помогающих компьютеру обучаться без непосредственных инструкций. Машинное обучение является одним из направлений искусственного интеллекта.

Выполняется обучение модели на множестве данных, сохранение весов (параметров) модели и использование сохранённых параметров для быстрого принятия решений. Обучение может длиться долго и требовать больших вычислительных мощностей и множества данных; обученная модель работает быстро и на слабых компьютерах. С помощью такого подхода выявляются закономерности в данных, качество результатов напрямую зависит от объёма данных для обучения.

В данной статье я хочу раскрыть суть машинного обучения на примере создания искусственного интеллекта для математической игры Баше (названа в честь французского поэта и математика Баше де Мезириака).

Читать далее

Как создать API в облаке менее чем в 200 строках кода

Уровень сложностиСложный
Время на прочтение13 мин
Охват и читатели14K
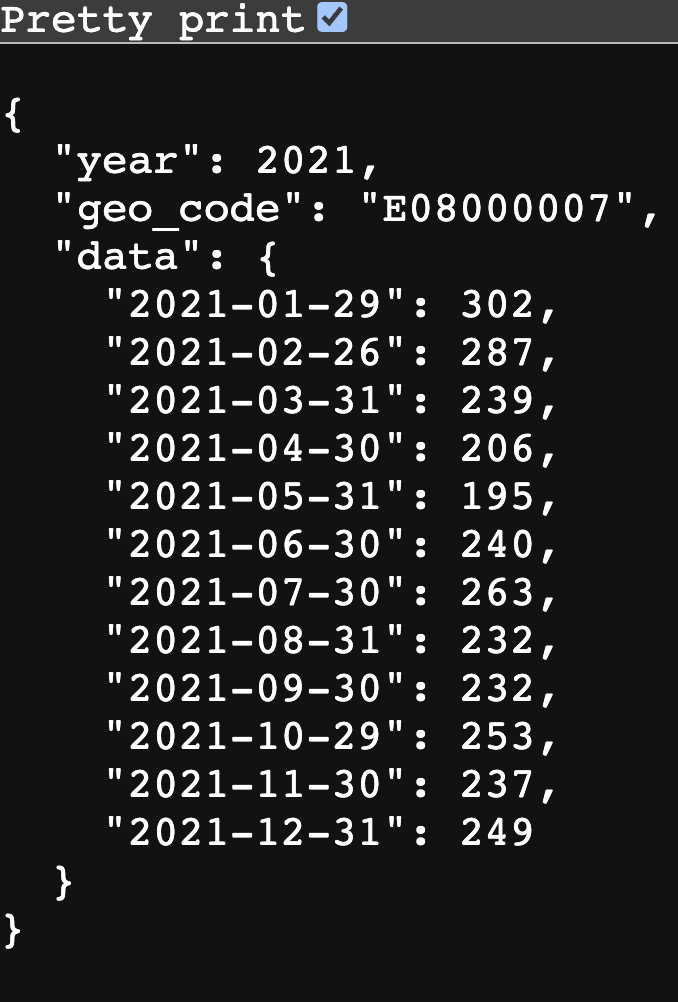
Современные облачные инструменты и пакеты Python стали настолько мощными, что с их помощью можно создать (масштабируемый) облачный API менее чем в 200 строках кода. В этом посте будет рассмотрено, как при помощи lines Google Cloud, Terraform и FastAPI развернуть в облаке полноценный API, через который можно отвечать на запросы.

Репозиторий к этому проекту находится здесь, пользуйтесь им, если захотите опробовать весь код сами.

image

Пример API, возвращающего данные. О том, как его создать, рассказано в этом посте.
Читать дальше →

Событийное логирование для аналитики и мониторинга работы телеграм-бота

Время на прочтение10 мин
Охват и читатели11K

Привет, Хабр! Меня зовут Артем.

По мере роста различной работы с телеграм ботом нашего корпоративного телеграм-бота, оптимизация и поддержание его стало более сложной задачей. В какой-то момент я осознал, что нужен надежный способ отслеживания происходящих событий в приложении. Это важно не только для решения проблем и багов, но и для оптимизации производительности и повышения общей эффективности работы.

В этой статье мы рассмотрим как реализовать событийное логирование для телеграм-бота.

Читать далее

Что расскажут на PiterPy 2023: много питонов и немного ржавчины

Время на прочтение11 мин
Охват и читатели3.2K

Python применяется для совсем разных задач, от ML до бэкенда. О каких темах тогда говорить на конференции по Python? Обо всех главных сразу. На приближающемся PiterPy 2023 среди докладов будут и «В Python есть готовый фронтенд для вашего компилятора», и «Django + Keycloak: доверьте аутентификацию профессионалам», и «Мастер-класс по взлому».

Более того: будут даже доклады со словом «Rust» в названии, при чём оно тут? А ещё есть тема «ChatGPT как раб разработчика», что под ней скрывается? А закрывать онлайн-часть и вовсе будет биоинформатик Михаил Гельфанд, что он расскажет? И, наконец, будет даже доклад о настоящих питонах!

В этом хабрапосте мы собрали описания всех докладов, так что можете узнать, чего именно ожидать от конференции.

Программа PiterPy 2023

Классификация текстов в spaCy: пошаговая инструкция

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели9.4K

Вы узнаете, как реализовать классификатор текстов при помощи библиотеки spaCy, а также несколько полезных лайфхаков, которые помогут ускорить обработку данных.

Читать далее

Как создать черный список для токенов JWT в Django

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели5.3K

Привет! Недавно нам в одном из проектов было необходимо обеспечить пользователю смену пароля, чтобы при этом происходил выход со всех остальных устройств. Т.к. аутентификация была сделана на JWT токенах, то проблемой стало то, что невозможно вручную истечь токен после создания, он не имеет состояния и храниться на стороне клиента. В этой статье мы разберем генерацию JWT токена с возможностью занесения его в черный список на примере пустого проекта, а также протестируем, полученный результат с помощью Postman.

Читать далее

API от А до Я (теория и практика)

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели175K

Я работаю с совершенно разными проектами и встречаюсь с разными технологиями: графы, пространственные данные, риалтайм обработка, ML и NER сервисы и т.п., но есть классические основы, которые должен знать каждый в ИТ от аналитиков до руководителей, так называемый фундамент без которого построить хорошую карьеру специалиста сложно. Так как я долго занимал различные аналитические должности, то прошу не обижаться, так как буду часто говорить о том для чего это аналитику.

Читать далее

Распознавание речи (транскрибация) по аудиозаписям диалогов. Whisper. Личный опыт

Время на прочтение5 мин
Охват и читатели39K

Распознаем речь по аудиозаписям диалогов сотрудников и клиентов.
Сохраняем по разным дорожкам, в тексте и с таймингом.
Модель Whisper, работаем в Colab.
Личный опыт.

Читать далее

Ближайшие события

Решение школьных задач по химии в Python

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели17K

Изображение от rawpixel.com на Freepik

Я попробовал решить несколько простых школьных задач по химии в Python с помощью библиотек mendeleev, chemlib и chempy, в том числе несколько заданий из ОГЭ и ЕГЭ.

к задачам

Как Guidance выводит ИИ на новый уровень: инструмент для эффективного управления моделями

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели3.9K

В последнее время наблюдается стремительный прогресс в сфере обработки естественного языка. Появление мощных языковых моделей вроде GPT и Bard действительно открыло новые возможности для создания интеллектуальных приложений. Однако вместе с тем мы столкнулись с необходимостью более совершенных инструментов для эффективной интеграции и управления такими моделями.

И вот недавно компания Microsoft представила Guidance - язык управления, предназначенный для контроля над большими языковыми моделями. По нашему мнению, этот инструмент может существенно изменить процесс разработки приложений на основе возможностей AI. 

В данной статье мы хотели бы поближе познакомиться с его особенностями и разобраться, что же это за "зверь". Надеемся, эта информация будет полезна для разработчиков, исследователей и организаций, которые активно работают над совершенствованием контроля поведения LLM.

Приглашаем к прочтению!

Читать далее

Упрощаем подключение линтеров в пайплайны Gitlab CI

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели12K

Всем привет! Меня зовут Юра, я Python-разработчик в Точке. В статье я покажу, как написать шаблон с линтером для Gitlab CI, чтобы при старте нового проекта (или уже запущенного) было легко добавить линтер в пайплайны.

А ну-ка

Разработка высокопроизводительного кеш-слоя на основе Redis в телеграм-боте

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели11K

Мгновенность процессов стала золотым стандартом. Пользователи требуют мгновенных результатов, и телеграм-боты не являются исключением. Без кеширования данных, боты могут столкнуться с серьезными задержками при обработке запросов. Кеш-слои в теботах - это ключевой инструмент, который позволяет значительно ускорить обработку запросов, сохраняя часто запрашиваемые данные в памяти для быстрого доступа.

Кеширование становится особенно важным, когда бот имеет множество пользователей и обрабатывает запросы, требующие доступ к внешним ресурсам, таким как базы данных или внешние API.

Redis - это молниеносная, высокопроизводительная система управления данными в памяти, которая идеально подходит для кеширования в телеграм-ботах. Эта in-memory база данных спроектирована с учетом скорости и эффективности, позволяя разработчикам хранить и получать данные практически мгновенно. С Redis, вы можете сохранять разнообразные данные, такие как текстовые ответы, изображения, аудиофайлы, и даже более сложные структуры данных, все это с невероятной скоростью доступа.

Redis также предоставляет богатый набор функций, включая поддержку транзакций, публикации/подписки, управление исключениями и автоматическое удаление данных, что делает его превосходным выбором для создания надежного и масштабируемого кеш-слоя.

Читать далее

NumPy: шпаргалка для начинающих

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели136K

What's up guys!

В этой статье мы поговорим про NumPy. Это статья-шпаргалка для начинающих пользователей NumPy, надеюсь она будет вам полезна.

Читать далее

Простой ORM для sqlite3

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели19K

ORM, или объектно-реляционное отображение — это программная технология, которая позволяет взаимодействовать с базами данных с использованием объектно-ориентированной парадигмы. Вместо того чтобы писать SQL-запросы напрямую для работы с данными в базе данных, можно использовать ORM, чтобы взаимодействовать с данными, как если бы они были объектами в вашем коде.

Не бывало ли вам интересно, как работает изнутри такая идейно простая концепция? Благодаря чему достигается удобство работы? Сегодня мы напишем ORM самостоятельно и узнаем, какие инструменты python нам для этого понадобятся.
Читать дальше →

Алгоритм поиска ключевых словосочетаний «на пальцах». Анализируем новости

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели9.9K

В современном мире объем данных в интернете постоянно растет с огромной скоростью. Возникает логичный вопрос: как ориентироваться в этом информационном потоке? 

Чтобы упростить себе задачу поиска и обобщения информации IT-энтузиасты применяют технологии генеративно обученных чат-ботов. Наиболее широкое распространение получил  ChatGPT. Яндекс, в свою очередь, добавил в браузер YandexGPT, который позволяет тезисно ознакомиться с содержанием страницы. Всё чаще вакансия Prompt-инженера начинает встречаться на hh и Хабр Карьере. Специалисты и чат-боты помогают конечному пользователю экономить время для поиска необходимой информации. 

Но что делать, если возможности обратиться за помощью к подобным технологиям нет? Указанные выше языковые модели нельзя интегрировать в собственные проекты, сценариев их использования много, но они всё равно ограничены. 

В статье мы расскажем, как (не без нейронных сетей) можно создать простой алгоритм на Python, который поможет извлекать ключевые слова из любого текста, тем самым избавляться от ненужной информации и автоматизировать процесс анализа материалов. Мы будем работать с русским текстом, а именно — с новостными постами. Поэтому в частном случае используются пакеты для обработки, поддерживающие именно русский язык. В том числе используются модели, обученные на корпусах текстов с новостной семантикой. 

Читать далее