Обновить
512K+

Python *

Высокоуровневый язык программирования

303,58
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Молниеносный инкрементальный линтинг Python-кода

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели19K

Линтинг кода бывает очень долгим, а в ситуациях наличия большого legacy‑проекта, который решили «причесать», линтинг может причинять боль и страдания разработчикам. В этой статье мы найдем решение, которое позволит без проблем линтить код с любого этапа разработки и делать это супер быстро и инкрементально!

Читать далее

Примитивы синхронизации в Python Asyncio: Исчерпывающее руководство

Уровень сложностиСложный
Время на прочтение14 мин
Охват и читатели32K

При написании многопоточного приложения нужно помнить о возможности состояния гонки при использовании неатомарных операций. Даже простая задача по увеличению целого числа на единицу в конкурентной программе может вызвать ошибки, с трудом поддающиеся воспроизведению. Но при использовании asyncio мы всегда работаем в одном потоке, а значит можно не беспокоиться о гонках, правда? На самом деле не всё так просто...

Что было дальше?

Архитектурный паттерн для обработки больших данных: Lambda

Уровень сложностиСложный
Время на прочтение13 мин
Охват и читатели17K

Привет, Хабр!

Мы сталкиваемся с огромными объемами информации, высокой нагрузкой, и постоянно меняющимися требованиями. Все это требует от нас не только навыков программирования, но и грамотного проектирования архитектуры, которая способна справиться с этими вызовами.

Именно здесь на сцену выходит архитектурный паттерн, о котором мы сегодня поговорим - Lambda-архитектуре. Если вы уже имеете опыт в области обработки больших данных, то, возможно, слышали о ней. Lambda-архитектура - это эффективный способ структурирования и организации процессов сбора, обработки и анализа данных, обеспечивая надежность, масштабируемость и гарантированную консистентность.

Читать далее

Сквозное наблюдение (observability) в микросервисах

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели9K

Привет, Хабр!

Сегодня мы поговорим о чем-то, что является неотъемлемой частью современной микросервисной архитектуры, что-то, без чего трудно представить себе успешное и надежное приложение в мире распределенных систем. Да, вы правильно догадались, мы говорим о сквозном наблюдении, или, как его еще называют, "observability."

Если вы читаете эту статью, то, вероятно, уже являетесь опытным разработчиком и хорошо знакомы с микросервисами. Вы, возможно, создали и поддерживаете множество микросервисов, и, скорее всего, столкнулись с ситуацией, когда отладка и мониторинг становятся настоящей головной болью.

Именно здесь на сцену выходит сквозное наблюдение. Это не просто новомодное словечко или набор инструментов, это фундаментальный компонент, который позволяет нам видеть и понимать, что происходит в наших микросервисах в реальном времени. С его помощью мы можем следить за запросами, анализировать производительность, идентифицировать проблемы и, конечно же, обеспечивать бесперебойную работу наших приложений.

Разберемся подробнее с первым из ключевых компонентов сквозного наблюдения - трассировкой.

Читать далее

Улучшаем модель RandomForestClassifier

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели6.1K

Статья взята из источника Daily Dose of Data Science.

Оговорюсь сразу: Я новичок в Data Scince и в оформлении статей. Пишу лишь сюда для своих заметок ну и может быть будет кому-то полезно. Прошу сильно не судить!)

Случайный лес - это довольно мощная и надежная модель, представляющая собой комбинацию множества различных деревьев принятия решений.

Читать далее

От теории к практике: создаём веб-приложение для решения задачи коммивояжёра

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели8.6K

В таких сферах, как исследование операций (Operations Research) и наука о данных (Data Science) чрезвычайно актуально сближение теории и её практического применения в виде программных проектов. Теоретические выкладки формируют базу программ для оптимизации чего‑либо, так как теория даёт средства для решения разнообразных задач. Но очень важно помнить и о том, что подобные программы должны быть доступны конечному пользователю, что с ними должно быть удобно работать.

Задача коммивояжёра (Traveling Salesman Problem, TSP) — это, без сомнения, та самая задача комбинаторной оптимизации, которая изучена лучше всего (Rego, C., Gamboa, D., Glover, F., & Osterman, C., 2011. Traveling salesman problem heuristics: Leading methods, implementations and latest advances. European Journal of Operational Research, 211(3), 427–441). Её легко описать (по крайней мере — на словах), её можно использовать для того чтобы продемонстрировать некоторые из возможных компонентов API современной программы по построению маршрутов. В результате я просто не мог подобрать ничего лучше этой задачи в качестве основы для примера, который разобран в этой статье.

Здесь вы узнаете о том, как использовать Python‑библиотеку Streamlit для создания веб‑приложения, которое позволяет решать задачу коммивояжёра с использованием входных данных, предоставленных пользователем. Так как нас интересует создание приложения, пригодного для решения реальных задач, мы, анализируя пути перемещения между некими географическими точками, будем интересоваться не только евклидовым расстоянием между ними, но и другими характеристиками путей. В частности, наша программа, используя координаты точек, должна уметь получать данные о том, какое расстояние по автомобильным дорогам нужно преодолеть для перемещения между ними. Эти данные должны учитываться при выполнении оптимизации. Для этого мы воспользуемся API OpenStreetMap.

Если вы хотите лучше разобраться в теоретических аспектах числовой оптимизации — вам, возможно, интересно будет почитать мои статьи о линейном программировании и о задаче маршрутизации транспорта (это — обобщение задачи коммивояжёра).

Готовы поработать? Взгляните на то, что у нас должно в итоге получиться…

Читать далее

Паттерн производитель-потребитель и очередь с приоритетом asyncio.PriorityQueue в Python

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели10K

В предыдущей статье вы могли узнать что такое очередь в целом и как работает FIFO-очередь asyncio.Queue. Давайте продолжим и посмотрим на примере библиотеки aiohttp как работают очереди с приоритетом asyncio.PriorityQueue.

Читать далее

Делаем играющего онлайн шахматного бота при помощи Lichess API

Время на прочтение2 мин
Охват и читатели14K

Возможно, некоторые или даже многие из читателей писали шахматного бота, который мог играть с пользователем. Сегодня я расскажу вам, как сделать так, чтобы наш бот был доступен на известном шахматном веб-сайте lichess.org.

Читать дальше →

Kornia — библиотека компьютерного зрения

Уровень сложностиСредний
Время на прочтение15 мин
Охват и читатели16K

Kornia это open source библиотека для решения задач компьютерного зрения. Она использует PyTorch в качестве основного бэкенда и состоит из набора дифференцируемых процедур и модулей. Создатели библиотеки вдохновлялись OpenCV, и поэтому Kornia является его аналогом, но при этом в некоторых моментах превосходит. Главным преимуществом Kornia по сравнению с тем же OpenCV, scikit-image или с Albumentations является возможность обрабатывать изображения батчами, а не по одному изображению и возможность обрабатывать данные на GPU.

Читать далее

Как я проектирую и разрабатываю расширения Python на Rust

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели7.7K

В этой статье я хочу рассказать о том, как я проектирую комплексные расширения для Python на Rust с использованием PyO3 и почему я принимаю те или иные проектные решения.

Читать далее

Построение ML-пайплайна для рекомендательной системы с помощью Google Cloud Platform

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели3.3K

Построение ML-пайплайна для рекомендательной системы с помощью Google Cloud Platform

Данный материал будет описывать опыт нашей команды по построению end-to-end рекомендательной ML-системы визуального поиска похожих товаров с помощью инструментов, предоставляемых облачной платформой Google Cloud Platform (далее –  GCP) и структурно будет состоять из трех частей, описывающих три этапа разработки: от простой реализации задачи к более сложной, или точнее – из двух с половиной, так как второй этап оказался не жизнеспособным, но обо всем по порядку.

Читать далее

Как PaaS решил проблемы стандартизации разработки сервиса одной утилитой

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели4K

Привет ? На связи команда PaaS СберМаркета. Меня зовут Роман, и уже больше 2-х лет моя группа занимается разработкой инструментов для разработчиков, в том числе утилитой sbm-cli, о которой хочу рассказать сегодня.

Вероятно вы каждый день пользуетесь консольными утилитами, такими как git, homebrew, ssh, grep, find, etc. Мы сделали command line interface приложение, запуск которого на локальной машине разработчика может превышать количество запусков команды git (спойлер: статистика в конце статьи).

О том как так получилось, почему этот инструмент так важен для разработчика и что он умеет, а что нет, расскажем в этой статье.

Читать далее

Введение в библиотеку Diffusers и диффузионные модели

Уровень сложностиПростой
Время на прочтение16 мин
Охват и читатели23K

Diffusers — это библиотека от Hugging Face, которая позволяет работать с сотнями предобученных моделей класса Stable Diffusion для создания изображений и аудио.

Всегда хотели стать художником, но у вас лапки? :) Тогда Diffusers этот то, что вам нужно!

В этой статье рассмотрим основные возможности библиотеки, ее компонентов, а также моделей Stable Diffusion в целом.

Мои курсы: Разработка LLM с нуля | Алгоритмы Машинного обучения с нуля | Геопространственный анализ данных на Python

Читать далее

Ближайшие события

«Консервируем» данные: сравниваем модуль pickle и альтернативные способы сериализации

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели9K

Привет, Хабр!

Сегодня с вами участник профессионального сообщества NTA Милованов Максим.

В процессе работы периодически возникает необходимость выгрузить обрабатываемую в программе информацию, для её хранения или дальнейшей передачи. При этом важно не утратить информацию или её часть, и быть уверенным, что тот, кому файл будет передаваться, сможет с ним работать. И тогда на помощь приходит сериализация данных.

В Python есть разнообразные способы сделать это, некоторые их которых рассмотрю и сравню в этом посте.

Узнать больше

Сбер. Как некрасиво поступить на конкурсе красоты

Время на прочтение13 мин
Охват и читатели60K

Хабр - не жалобная книга, я знаю. Но тут история про код, с примерами, разбором антипаттернов и всё такое, поэтому я рискну.

Всё началось, когда я узнал про конкурс красоты кода от Сбера. Я как раз хотел поучаствовать в каком-нибудь эпичным конкурсе, а тут как раз он мне и подвернулся, тем более что я - тот человек, которому есть что рассказать про красивый код. Я даже целую статью запилил о том, как писать красивый и понятный код. Так что что я решил, что в данном случае мои шансы на победу - в отличие от остальных конкурсов - всё же больше 0%. Кроме того, я хотел выступить на конференции PiterPy (спойлер: хрен мне), чтобы рассказать там про красивый код и всё такое, поэтому участие в конкурсе и сравнение результатов было бы классным подспорьем.

Что же пошло не так?

Что я понял на первой работе программистом / Мои советы Junior-разработчикам

Время на прочтение8 мин
Охват и читатели75K

Всем привет! Меня зовут Максим. Я backend-разработчик, который не так давно устроился на свою первую работу. В этой статье хочу поделиться своими наблюдениями/советами/рекомендациями для начинающих программистов. Ведь, как известно, если опыт не превращён в текст, он даже не становится прошлым.

Материал будет полезен тем, кто ищет первую работу или не так давно её нашёл. Примеры будут из области Python Backend, но наблюдения универсальны и спокойно перекладываются на другую область. Поехали!

Читать далее

Swirl для анализа корпоративных данных: как мы использовали ИИ-поиск и что из этого вышло

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели2.3K

При решении задачи поиска мы столкнулись с проблемой интеграции разнородных источников данных и обеспечения максимальной релевантности результатов. У нас накопилось много разрозненной информации в разных форматах и системах, что сильно осложняло поиск.

В итоге мы решили попробовать Swirl - поисковую платформу с открытым исходным кодом, созданную на Python и Django, позволяющую объединить поиск в базах данных (SQL и NoSQL), облачных сервисах, поисковых провайдерах, хранилищах данных и таких инструментах, как Miro, Jira, GitHub и т.д., а на выходе получить результаты с аналитикой от ChatGPT.

Для разработчиков и компаний, которые также хотят оптимизировать и упростить поиск, эта информация может быть полезна. Приглашаем познакомиться!

Читать далее

MLOps на примере прогноза движений акций с помощью MLRun

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели4.7K

MLOps: структурирование пути от концепции модели к ее реальному воздействию

В современном мире, основанном на данных, машинное обучение является символом инноваций. Однако преобразование модели из теоретической конструкции в готовый к использованию инструмент — сложная задача. Откройте для себя MLOps — гармоничное сочетание «машинного обучения» и «операций», созданное для решения этой сложной задачи.

Черпая вдохновение из DevOps в разработке программного обеспечения, MLOps объединяется вокруг основных задач, предлагая структурированный путь для проектов ML на протяжении всего их жизненного цикла.

Теперь давайте углубимся в мир MLOps с помощью MLRun.

Читать далее

Airflow vs NiFi: исследуем оркестратор для формирования витрин данных

Уровень сложностиСредний
Время на прочтение19 мин
Охват и читатели17K

Сегодня концепция витрин данных является стандартом и используется повсеместно. Поэтому даже небольшим компаниям важно определиться с помощью каких инструментов они будут решать проблему оркестрации процессов построения витрин. Какой инструмент в условиях относительно небольшого бюджета позволит достигать поставленных целей? Этот вопрос мы и постараемся раскрыть в статье. Для этого рассмотрим два известных инструмента: Airflow и NiFi, а также постараемся выявить их сильные и слабые стороны.

Читать далее

Эксперименты с цифровым КИХ фильтром в плате FPGA MCY316

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели4.5K

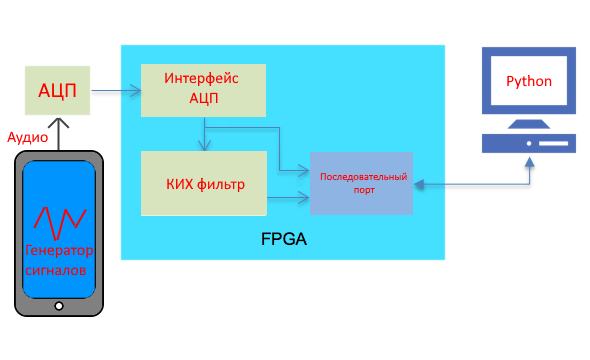
В своей предыдущей статье я написал, как произвести оцифровку звукового сигнала FPGA платой MCY316. В том проекте данные полученные из АЦП просто передавались в компьютер через последовательный порт. Уже на компьютере данные принимались из последовательного порта программой на питоне и отрисовывались в окне.

А сейчас я хочу модифицировать этот проект и добавить в FPGA еще цифровой фильтр, чтобы разобраться, как он работает.

Рисунок выше показывает схему моего эксперимента.

Читать далее