Обновить
128K+

Серверная оптимизация *

Разгружаем сервер

66
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как WhatsApp справлялся с 50 миллиардами сообщений в день, имея всего 32 инженера

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели29K

Январь 2008 года — Калифорния, США.

Инженер Ян Кум нанимается на работу в Facebook* — получает отказ.

Это был не конец — он продолжил двигаться дальше.

В следующем году он покупает iPhone и сразу же понимает огромный потенциал нового App Store.

С несколькими бывшими коллегами из Yahoo он решает создать программу мгновенного обмена сообщениями. Программе дают имя WhatsApp. Предназначение WhatsApp — стать заменой дорогостоящим SMS.

Рост популярности WhatsApp поражает воображение — каждый день в него заходит один миллион людей.

WhatsApp мог справляться с 50 миллиардами сообщений в день от 450 миллионов активных пользователей, имея в штате всего 32 инженера.

Хотя взрывной рост продукта — это приятная проблема, для её решения Яну Куму и команде разработчиков WhatsApp пришлось применить самые передовые технологии проектирования.
Читать дальше →

Опыт адаптации Firecracker под FreeBSD

Время на прочтение15 мин
Охват и читатели3.7K

Сколько родилось отличных проектов open source, потому что у кого‑то руки чесались что‑то попробовать! Именно так было и в случае с Firecracker. В 2014 году компания Amazon запустила AWS Lambda, которую позиционировала как «бессерверную» вычислительную платформу. В AWS Lambda пользователь может задать функцию — скажем, десять строк кода на Python — а Lambda в ответ достроит всю требуемую инфраструктуру, чтобы сработала цепочка: прибывает HTTP‑запрос, вызывается функция, запрос обрабатывается, и, наконец, генерируется ответ.

Чтобы этот сервис работал безопасно и эффективно, Amazon нужно было разработать механизм, который позволял бы с минимальными издержками запускать виртуальные машины. Так появился Firecracker. Это монитор виртуальных машин (VMM), работающий совместно с Linux KVM. Он запросто создаёт «микро-VM» и управляет ими.

Читать далее

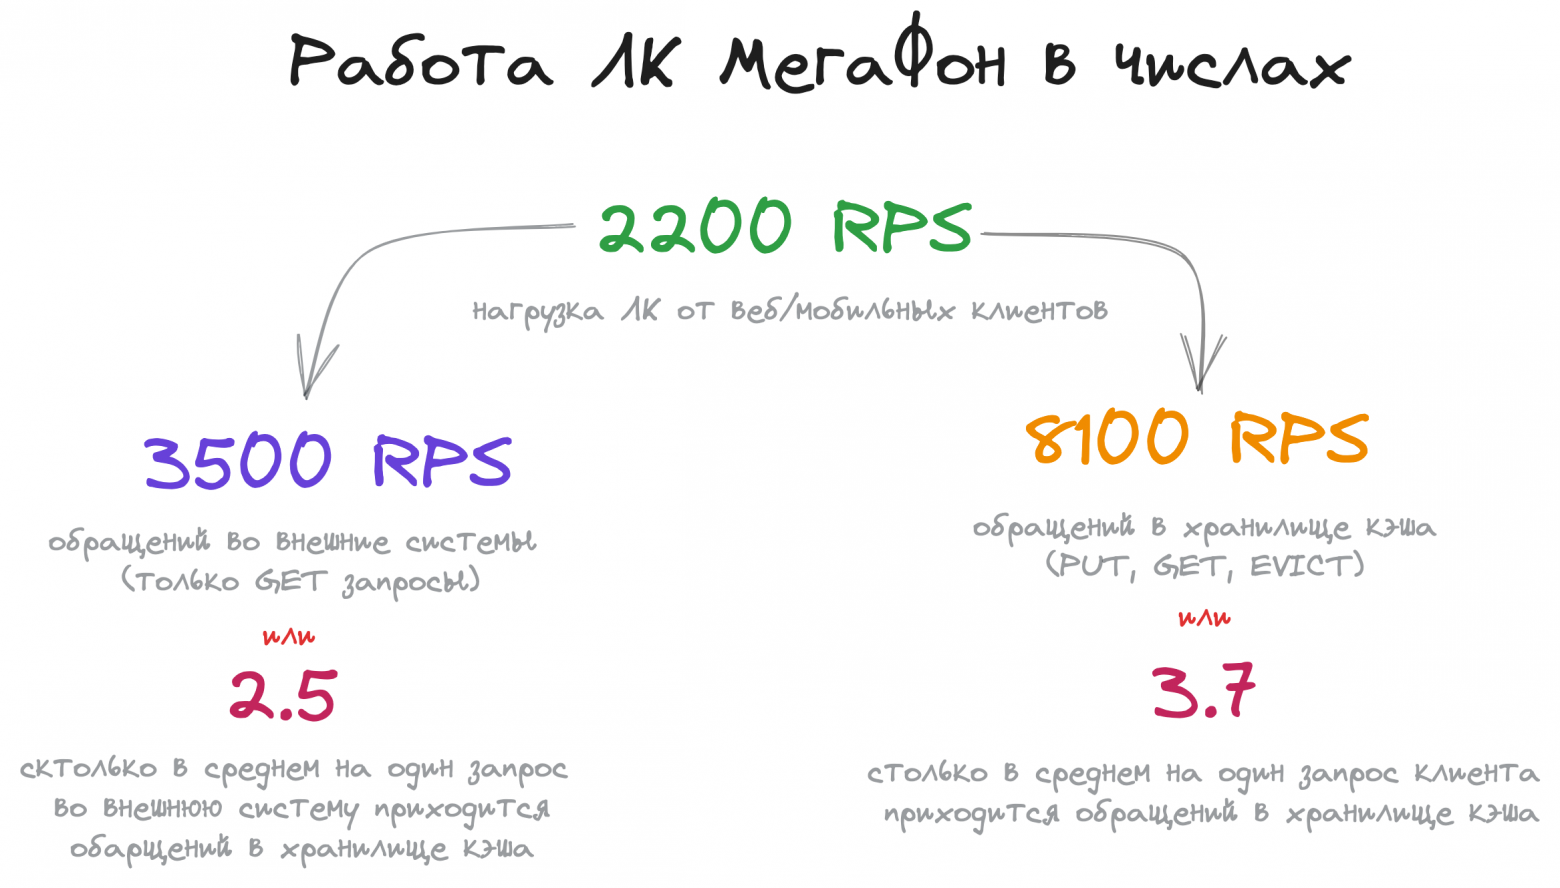
Анализ эффективности кэширования на бэкенде ЛК МегаФон

Уровень сложностиСложный
Время на прочтение8 мин
Охват и читатели4.2K

По мере расширения функциональности сервиса и роста его аудитории мы неизбежно сталкиваемся с узкими местами в производительности. Прежде чем масштабировать ресурсы для эксплуатации, следует понять, насколько эффективно эксплуатируется текущая конфигурация.

Одним из таких узких мест может стать ваше распределенное хранилище для кэша. Все мы привыкли к тому, что оно нас спасает от тяжелых запросов в БД или обращенийк внешним системам с большой задержкой. Но рано или поздно может возникнуть ситуация, когда конфигурация этого хранилища будет на грани своей оптимальной производительности и в случае высоких нагрузок (аварий, спровоцированных наплывом пользователей или рекламными кампаниями) хранилище может подвести нас.

Как определить, что утилизация ресурсов кэширования происходит оптимально? Что если довольно большая часть нагрузки не приносит реальной пользы, и от нее с легкостью можно избавиться, тем самым разгрузив хранилище? В рамках этой статьи мы оценим эффективность кэширования бэкeнда ЛК МегаФон и расскажем о результатах проведенных мероприятий для оптимизации.

Читать далее

Монтируем шары для юзеров

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели48K

Всем привет. Монтируете ли вы шары, как их монтирую я? Вероятно, нет, т. к. очень крутой опции multiuser на просторах интернета уделено слишком мало внимания, а man mount.cifs в её отношении весьма немногословен и скуп на наглядные примеры. Именно это и сподвигло меня поделиться с вами парой «рецептов», которые могут облегчить вам и вашим пользователям движение в сторону отечественных десктопов и ИТ-инфраструктур.
Читать дальше →

Мониторинг и алертинг серверов Supermicro (sensor metrics) через Prometheus

Время на прочтение7 мин
Охват и читатели11K

Рассказываем о процессе настройки сбора метрик серверов Supermicro с помощью утилиты IPMItool и Prometheus. 

Инфраструктура нашей компании поддерживается на высоком уровне SLA, что требует от нас измерения, наблюдения и отправки отчетов, фиксирующих метрики производительности систем, в том числе серверов, которые мы предоставляем в аренду.

У нас возникла необходимость внедрения централизованного механизма опроса IPMI/iDRAC/TP-IPMI для обнаружения перегрева, проблем с системой охлаждения и т. д. и повышения качества предоставляемого оборудования в целом. Проще говоря, мы планируем внедрить систему опроса датчиков с портов управления материнских плат, чтобы оперативно обнаруживать перегрев, неработающие или частично работающие вентиляторы и другие проблемы с охлаждением (например, проверять обороты кулеров или физическое наличие вентилятора в разъеме).

Читать далее

Радикальная оптимизация расходов на AWS в пять шагов (мы сэкономили 80%)

Время на прочтение7 мин
Охват и читатели5.9K

Это история о том, как мы сократили расходы на AWS на 80% всего за две недели.

Для разработчиков AWS — это Клондайк возможностей

Начнем с того, что с 2018 года мы полностью перешли на AWS для всех наших проектов, и это действительно стало настоящим спасением. Наша команда полностью удаленная, поэтому владение собственным датацентром в какой-либо точке мира вызывало бы немало сложностей. Гораздо проще и экономичнее арендовать ресурсы у AWS, избегая при этом крупных капиталовложений.

Читать далее

Управление памятью в PHP. Сборка мусора, слабые ссылки и прочая челядь

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели22K

1. Введенние.
2. Zval.
3. Циклические ссылки.
4. Сборщик мусора.
5. Алгоритм работы сборщика мусора.
6. Смотрим глазами.
7. Слабые ссылки.
8. Бонус-трэк: WeakMap.
9. Заключение.

Читать далее

«Здравствуйте, как пройти в FinOps?» Краткая история адаптации фреймворка в Леруа Мерлен

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели2.7K

Облачные сервисы — это отлично, но, если ими начинают пользоваться разные команды в компании, вопрос управления затратами превращается в «черный ящик». Когда мы только начинали нашу историю с FinOps, то даже не представляли, насколько эффективнее можно раскрутить историю с арендой облачных мощностей. Но оказалось, что расширение практик управления затратами помогает получить от облаков еще больше отдачи и не допустить необдуманных трат (а то один стартап решил как-то вечером расшифровывать ДНК на арендованных мощностях, а утром закрыл компанию, потому что потратил все деньги). О том, как это было, какие грабли мы собрали по пути, как нам помогла команда ИБ и за счет чего мы теперь экономим до 20% на облачных счетах, читайте под катом.

Читать далее

PHP. Как увеличить потребление памяти в 3 и более раз при работе с массивами

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели22K

1. Общие сведения.
2. Увеличиваем потребление памяти вдвое.
3. Увеличиваем потребление памяти втрое.
4. Ещё раз увеличиваем потребление памяти на ровном месте.
5. Заключение.

Читать далее

Балансировка нагрузки: простыми словами о всей мощи двух случайных вариантов

Время на прочтение7 мин
Охват и читатели7.7K
image

В мире динамического выделения ресурсов и балансировки нагрузки есть много интересных алгоритмов, но один из самых известных и занимательных – так называемый «метод двух случайных выборов». Он привносит очень простое изменение в процедуру случайного выделения ресурсов, а качество результатов от этого улучшается экспоненциально. Мне посчастливилось реализовать именно эту технику в гигантском масштабе, чтобы оптимизировать использование ресурсов в AWS Lambda, но мне всё равно долго не удавалось «прочувствовать» этот метод интуитивно. В этом посте хочу познакомить вас с той метафорической картиной этого алгоритма, которую я для себя составил, и которая очень удобна для понимания других продвинутых техник в этой области.
Читать дальше →

Оптимизация Apollo-client

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели3.4K

Что описывается: Apollo-client — популярная библиотека для работы с GraphQL. Библиотека призвана ускорить разработку и оптимизировать приложение.

Задача статьи: Описать возможные решения и проблемы оптимизации приложения в части apollo-client.

Читать далее

Неудачное внедрение Redis Cluster в монолит на PHP 7.2.X

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели11K

Исповедь о том как принес в проект проблему, которую так и не устранил в течение долгого времени.

Осторожно! Статья может вызвать обострение профессиональных заболеваний вплоть до боли ниже поясницы.

Читать далее

Тотально виртуально, гиперконвергентно

Время на прочтение5 мин
Охват и читатели1.3K

По прогнозам MarketsandMarkets, глобальный рынок гиперконвергентных систем к 2025 году достигнет объёма в 17,1 млрд долларов США. Среди факторов, стимулирующих рост рынка гиперконвергентной архитектуры, можно выделить повышенный интерес к облачным вычислениям, виртуализации, стремление сократить расходы на инфраструктуру и упростить управление.

Гиперконвергентной называют программно определяемую инфраструктуру, в которой вычислительные и сетевые ресурсы, а также хранилища составляются из унифицированных компонентов без заранее выделенных ролей. Такая архитектура обеспечивает простоту, скорость и наглядность, а также единообразие вместо дискретности.

В этой статье мы рассмотрим сервер Altos BrainSphere R380 F5, который отлично подходит для использования в качестве унифицированного компонента гиперконвергентной архитектуры. 

Читать далее

Ближайшие события

Как позволить PHP использовать весь CPU/RAM некоторыми [не]хитрыми манипуляциями

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.9K

Рекомендую присмотреться к списку, если ваш проект вырос или планирует рост, написанный на любом интерпретируемом языке (php/ruby/python) на нескольких серверах с обычным стеком (веб-сервер/сервер приложений, субд, redis/memcahed, rabbitmq, ...).

В качестве подопытного для оптимизации был взят PHP backend - все нижеперечисленные приёмы были опробованы и применены. Наш проект почему-то задыхался на казалось бы неплохом железе и к тому же не утилизировал выданные ему аппаратные ресурсы.

Читать далее

Трассировка распределенных IoT приложений на EMQX

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели4.7K

В этой статье мы создадим простое приложений на основе MQTT с использованием брокера сообщений EMQX и настроим наблюдение через встроенные механизмы трассировки.

Читать далее

Сервак с мезонином  (почти по Чехову)

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели6.7K

Производители серверов во все времена придумывали всякие нестандартные разъемы для подключения внешних адаптеров, которые называли обобщенно «Mezzanine card». Будучи проприетарными по физическому исполнению, в большинстве случаев они были просто другой распиновкой шины PCI Express. Причиной такого инженерного творчества была необходимость не занимать под адаптеры ценные малочисленные штатные разъемы той же шины, которых дефицит в особенно популярных серверах высотой 1U.

В отличие от десктопных систем малого форм-фактора (все эти Slim,Tiny PC), которые один американский обозреватель едко назвал «Системы, необходимые в условиях низколетающих самолетов», в серверах подобная минимизация высоты корпуса влечет прямую выгоду при размещении их в провайдерских стойках, до 42 штук в один шкаф.

Другая причина - возможность выпускать в этом «нестандартном стандарте» свои адаптеры, которые нечем заменить.

Что там у сервера под крышкой?

Алгоритмы балансировки нагрузок

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели73K

Рано или поздно веб-приложения перерастают среду одного сервера. Компаниям требуется увеличить или их доступность, или масштабируемость, или и то, и другое. Чтобы сделать это, они развёртывают своё приложение на нескольких серверах и ставят перед ним балансировщик нагрузок для распределения входящих запросов. Чтобы справляться с нагрузками, большим компаниям могут потребоваться тысячи серверов, на которых запущено веб-приложение.

В этом посте мы рассмотрим способы, которыми один балансировщик нагрузок может распределять HTTP-запросы на множество серверов. Мы начнём снизу и проделаем весь путь вверх до современных алгоритмов балансировки нагрузок.
Читать дальше →

Готов для ML, VDI и остального: обзор сервера Altos BrainSphere R360F5

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели1.3K

Информация давно стала новой нефтью, поэтому потребности в её обработке растут бешеными темпами. Заинтересованные в преимуществах от владения массивами данных компании запасаются серверными ресурсами и даже строят свои ЦОДы, чтобы не зависеть от доброй воли крупных игроков и не участвовать в трансграничной передаче данных. 

Наиболее востребованные сегодня задачи — высокопроизводительные вычисления, машинное обучение и искусственный интеллект, виртуализация и облачные сервисы, — чрезвычайно требовательны к аппаратным ресурсам. Их просто невозможно решить, имея в распоряжении серверы начального или даже среднего уровня. 

В этом посте мы расскажем о сервере Altos BrainSphere R360 F5, который подойдёт для самых ресурсоёмких задач. Как, к примеру, насчёт 4 ТБ RAM в 1U корпусе? Но давайте обо всём по порядку. 

Читать далее

Строка на 1,5 гигабайта

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели38K

На своей предыдущей работе я занимался поддержкой Java-сервиса, обеспечивавшего удалённую функциональность UI подобно RDP или Citrix. Этот сервис был устроен на основе сессий, состоявших из взаимосвязанных объектов Java, которые должны были очищаться или после выхода пользователя, или после истечения заданного таймаута.

На этапе планирования нагрузок мы обнаружили существенные траты памяти, о причинах которых я бы хотел рассказать в этой статье.
Читать дальше →

Перенос в Docker монолитного SAAS-сервиса

Время на прочтение18 мин
Охват и читатели4.2K

В этой статье мы расскажем о переносе одного из компонентов монолитного SAAS-сервиса, а именно тестового интернет-магазина, в контейнеры. Статья будет полезна тем, кто только приступил к изучению Docker.

Читать далее