
50 кейсов и советов по продвижению игр — Часть 1
Сложный
21 мин
Кейс

Делюсь личным опытом, который получил за последнее время разработки и продвижения своих игр и проектов.

Администратор windows умеющий в программирование
Делюсь личным опытом, который получил за последнее время разработки и продвижения своих игр и проектов.


Все, кто занимается разработкой программного обеспечения, так или иначе слышали про Kanban или применяли его в работе. Это — инструмент методологии Agile, который подходит для своего круга задач.
Но Kanban придумали совсем не разработчики: еще 60 лет назад его внедрила компания Toyota на своем производстве. И он стал частью общей философии компании, которая получила название Lean Manufacturing — «бережливое производство». Успехи Toyota и ее подхода очевидны: на 2022 год компания занимает первое место в мире по числу проданных автомобилей — 10,48 млн, опережая Volkswagen AG на 2,22 млн штук.
И между производством автомобилей и разработкой ПО напрашивается параллель. Давайте попробуем разобраться, в чем же особенности TPS (Toyota Production System), откуда все это появилось и как применяется в современной разработке.


За последние десять лет масса технологий, имеющих хоть какое-либо отношение к информационным, претерпела массу изменений. Более того, многие сферы жизни, изначально не имеющие к IT никакого отношения, также преобразились до неузнаваемости и приобрели некий IT-шный бэкграунд. Немаловажную роль в этих процессах информатизации сыграла концепция Интернета вещей (IoT). С самого появления этой концепции было понятно, что она серьёзно повлияет на все сферы деятельности человека, экономические и социальные процессы, а спустя несколько лет после её появления технология оказалась на карандаше Национального разведывательного совета США и была занесена в список «подрывных инноваций».
По мере развития технологии IoT, ставшей устойчивой тенденцией на протяжении последних десяти лет, она наполнялась технологическим содержанием и практическими стандартами. При этом до некоторого времени комплексная информационная безопасность этой технологии вообще никого не интересовала. Если внедрялись какие-то меры безопасности, то по крайне остаточному принципу. Учитывая, что изначально никто никаких специальных стандартов для устройств IoT не разрабатывал, в основном использовали то, что было. Понятно, что «взрослые» варианты стандартов подходят для IoT не в полной мере. Требуются технологии, обладающие высокой производительностью в ограниченных средах. Устройства IoT связаны достаточно жёсткими ограничениями по питанию, памяти и вычислительным ресурсам.
Если добавить к этому ненадёжные каналы связи, каналы с потерями, сильно ограниченные полосы пропускания и крайне динамичную сетевую топологию, то становится совсем кисло.

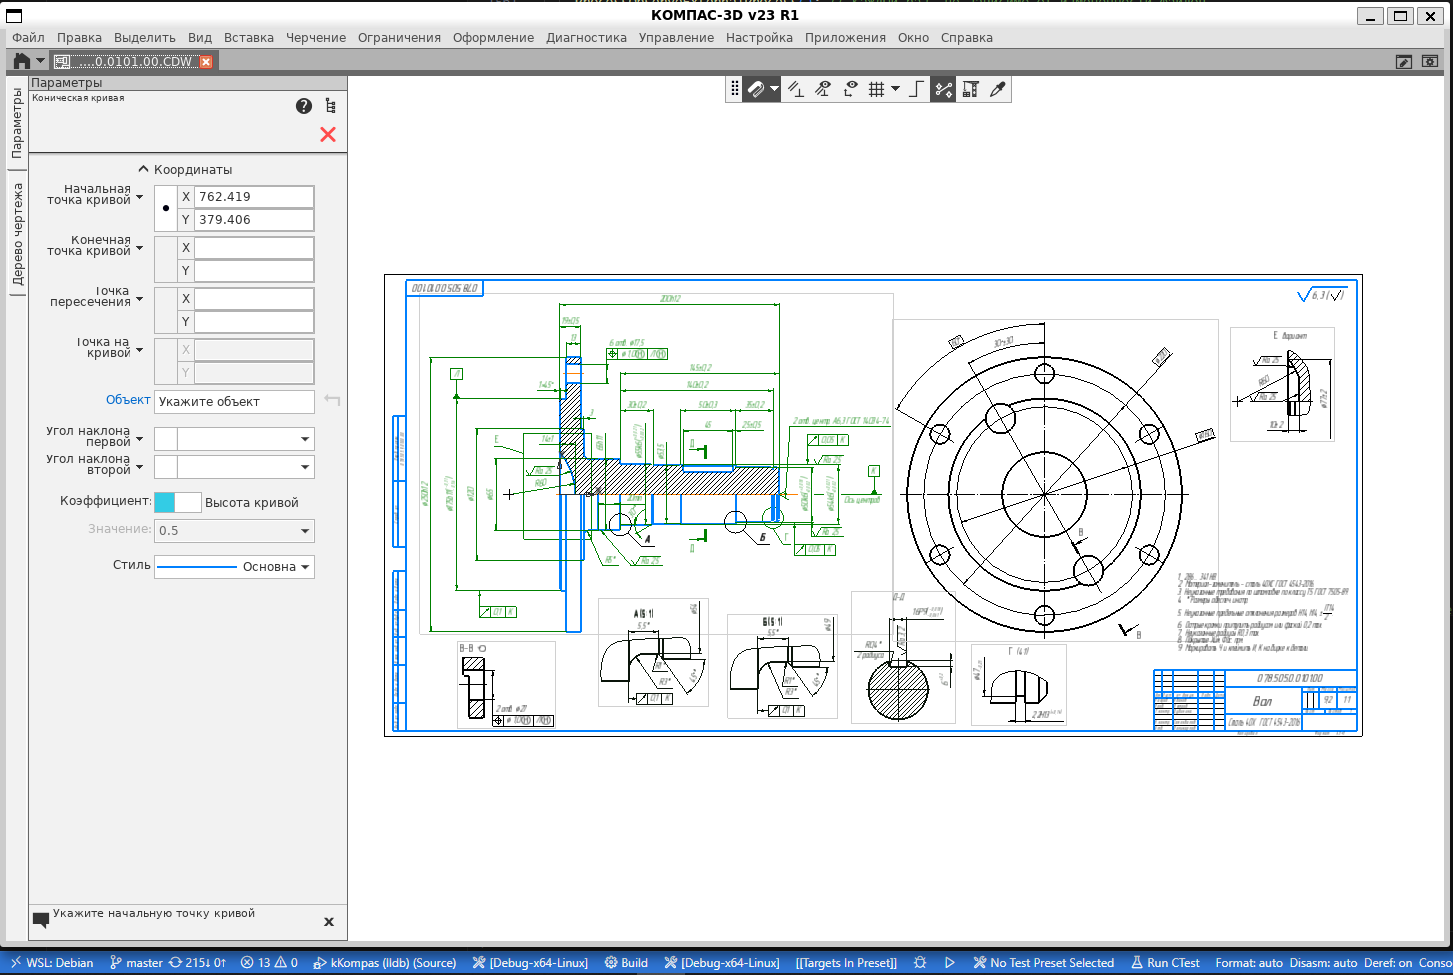
Мы много рассказывали на Хабре, как запустить САПР КОМПАС на Linux с разными вариантами Wine (ссылка 1, ссылка 2). Сегодня впервые публикуем пост о разработке нативной Linux-версии. На связи Андрей Пилюгин, ведущий инженер-программист.
Наша команда отвечает за портирование бизнес-логики, а работы по интерфейсу и по API делают другие команды. Эти процессы идут параллельно.
Работы по портированию КОМПАСа велись не один год, над этим начинала работать совсем небольшая группа программистов, и за этот период вышло две версии под Windows. По этой причине мы не могли разломать весь каркас приложения и написать его заново, приходилось аккуратно трансформировать приложение, постепенно заменяя его составляющие на кроссплатформенные и поддерживая в работоспособном состоянии все остальные. В этом нас сильно выручала система автотестов.
Мы решили не пытаться переписать всё сразу, а разделили портирование на этапы. На первом этапе хотели получить некую заготовку, в которой будет только сильно урезанное 2D с возможностью открытия нескольких документов, их масштабирования и переключения вкладок: по сути viewer.

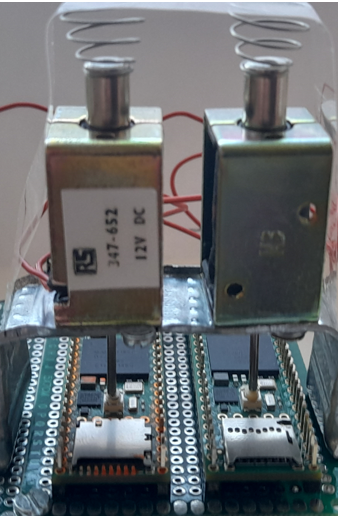
Загрузка контроллера Teensy, подключенного к компьютеру через СОМ порт при отсутствии других Teensy, не вызывает затруднений. Однако, загрузка одновременно-подключенной группы контроллеров Teensy может оказаться проблематичной [1,2,3,4]. Варианты решения этой проблемы обсуждаются ниже.

Изучение текстовых данных является одной из фундаментальных задач в области анализа данных и машинного обучения. Однако тексты представляют собой сложные и многомерные структуры, которые не могут быть напрямую обработаны алгоритмами машинного обучения. В этом контексте извлечение признаков — это процесс преобразования текстовых данных в числовые векторы, которые могут быть использованы для обучения моделей и анализа. Этот шаг играет ключевую роль в предварительной обработке данных перед применением алгоритмов.
Term Frequency-Inverse Document Frequency (TF-IDF) — это один из наиболее распространенных и мощных методов для извлечения признаков из текстовых данных. TF-IDF вычисляет важность каждого слова в документе относительно количества его употреблений в данном документе и во всей коллекции текстов. Этот метод позволяет выделить ключевые слова и понять, какие слова имеют больший вес для определенного документа в контексте всей коллекции.

Привет, Хабр!
Сегодня с Вами Илья Абрамчук и Дарья Ульянова, участники профессионального сообщества NTA.
Нередко на практике, когда работаешь с алгоритмами машинного обучения, а в особенности с нейронными сетями, сталкиваешься с проблемой нехватки данных для нормального обучения модели или хотя бы получения более-менее стабильного результата. Вот и мы оказались в подобной ситуации и перед нами возникла задача генерации синтетического датасета, состоящего из изображений, похожих на те, что имеются в распоряжении.

Давным, давно ... искал средство организации видео-файлов.
Чтобы можно было каждой киношке назначить какие-то маркеры, тэги. Выбирать файлы по наличию тэгов. Или наоборот - по отсутствию тэгов. Например: детектив, фантастика, не-ужасы.
Чтобы всё работало в обычном проигрывателе: кликнул "Открыть файл..."; выбрал Детектив, Фантастика, не-Ужасы; получил список фильмов и выбрал нужный. Без специальных файловых менеджеров и браузеров.
И тогда такое средство мне не нашлось. А сейчас ... сейчас решил сделать его сам.
Что в результате получилось можно увидеть по ссылкам: демо-видео, код.
Часть 1: Описание задачи, Модуль ядра
Часть 2: Модуль ядра, Регистрация файловой системы

Как не повесить три телевизора на восемь зубочисток, спроектировать четыре кронштейна и один очередной симулятор пультов, победить переходники и подключить это всё так, чтобы оно работало.


Поднимите руки те, кто никогда в жизни не косячил. Лес рук. Вот именно. Каждый из нас хоть раз делал что-то не так, в том числе и мы с агентством: неправильный договор, работа с доисторической книгой, неучтенки…и это лишь малая часть. А потому мы не стесняемся об этом открыто говорить. Подробнее о каждом факапе ‒ внутри.
Привет, Хабр!
На связи участник профессионального сообщества NTA Максим Алёшин.
Сегодня создание интерактивной карты на python не составляет большого труда: стоит подключить библиотеку (например, Folium или Bokeh), указать картографический сервер, и после выполнения нескольких «магических» строк кода ваши данные как на ладони!
Но что делать, если данные есть, визуализировать их хочется, а в сети, в которой вы работаете, нет доступа к картографическим серверам? В этом случае помогут Plotly и GeoPandas. Но придётся провести ряд подготовительных работ. В этом посте шаг за шагом я покажу, как построить интерактивную карту России по регионам с помощью Plotly, которая будет работать без интернета, регистрации и смс.

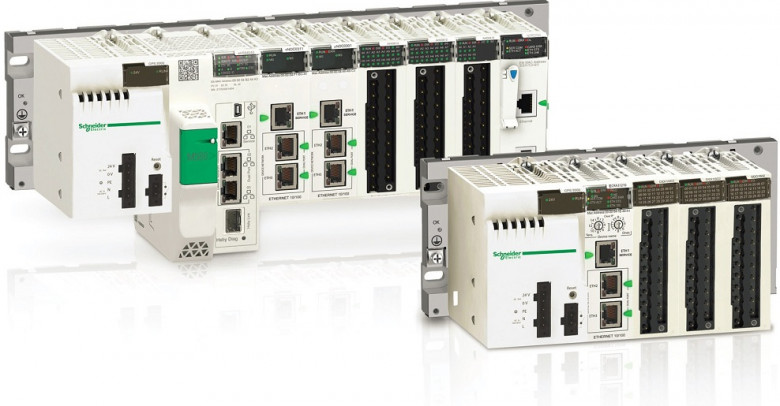
Промышленные контроллеры играют большую роль в промышленности любой страны - транспортировка энергоресурсов, производственные линии на заводах, множество локальных систем управления (водоснабжение, вентиляция и т.д.). А не возникал у вас вопрос - а на чем всё это работает: какие процессоры, ОС, технологии применяются производителями? Основная проблема в том, что даже на сайте производителя чаще всего нет никакой информации, из-за чего приходится лезть в прошивки.
На Хабре, да и в целом русском сегменте интернета, очень мало уделяется внимания данной теме, поэтому постараюсь на сколько мне хватило знаний поведать, что я выяснил за эту неделю отпуска. Производитель выбран исходя из популярности и частого упоминания в списках CVE.


Привет! Меня зовут Виталий Чесноков. Я генеральный директор QSOFT и сооснователь TEAMLY — платформы для совместной работы и управления знаниями.
В прошлой статье я рассказывал, как мы пытались фиксировать тайные знания с помощью блогов сотрудников. Настало время попробовать организовать единую базу знаний.

Желание одного студента не сдавать выпускной экзамен привело к появлению вездесущего алгоритма, который сжимает данные, не жертвуя при этом информацией.

В прошлой части мы рассмотрели базовые понятия в квантовых вычислениях: кубиты, вероятности состояний, измерения.
Квантовые гейты
Итак мы подошли к той части, где программа должна не только хранить состояние в регистрах, но и как-то преобразовывать эти данные. В классическом компьютере все операции с регистрами памяти состоят из элементарных логических преобразований с битами. Например бит AND, принимает на вход два бита и выдает в качестве результата один бит, согласно таблице логической операции AND.


Разведочный анализ данных, или EDA, – это как археологические раскопки в мире информации. Это первый шаг, когда мы берем на себя роль исследователя данных и начинаем расследовать, как устроены наши данные, как они взаимосвязаны и что они нам могут рассказать. EDA – это не просто скучная предварительная обработка, это настоящее приключение, в ходе которого мы обнаруживаем неожиданные моменты, паттерны и закономерности, которые часто прячутся на первый взгляд.
Представь, что ты археолог, который обнаружил древний город. Первое, что ты делаешь, – это изучаешь артефакты, учишься понимать их значение и связи между ними, прежде чем начнешь рассказывать историю этого города. Точно так же и EDA позволяет нам раскрывать истории, заложенные в данных. Мы открываем для себя ключевые факторы, влияющие на наши переменные, выявляем паттерны поведения и взаимосвязи, которые нередко оказывают решающее влияние на стратегии и принимаемые бизнес-решения.

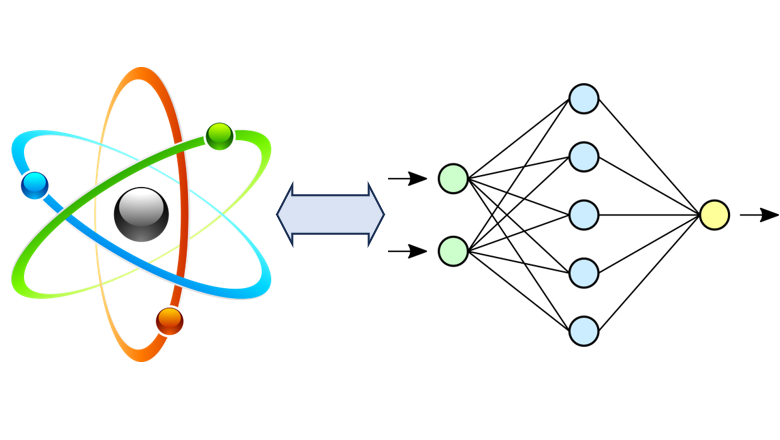
Привет, Хабр. Меня зовут Марат Хамадеев. Я — физик-теоретик, хотя кто-то, возможно, знает меня как научного журналиста, писавшего про физику для N + 1. Профессионально я рос в провинциальной академической среде, представители которой довольно скептически относились к применениям машинного обучения и, в частности нейронных сетей, для решения рутинных научных задач. Мне передался этот консерватизм — пока я писал новости про физику, я старался избегать исследований, построенных вокруг этого подхода.
Но жизнь не стоит на месте, и на новой работе я столкнулся с необходимостью поближе познакомиться с искусственным интеллектом и машинным обучением. Мне выпала замечательная возможность послушать лекции на Летней школе Искусственного интеллекта, организованной AIRI, и среди них была серия докладов, посвященных применению машинного обучения для физического моделирования. Они полностью развеяли мои страхи и побудили меня кратко рассказать вам о том, как связаны две эти области.

Все чаще бизнесу приходится резервировать текущую инфраструктуру, чтобы повысить свою отказоустойчивость и качество предоставляемых услуг. Как правило, резервируется целая машина с нужным сервисом или кластер по схеме N+N. Но, что, если серверов много, а данные, которые нужны для полного восстановления сервиса, весят меньше мегабайта?
В этой статье мы рассмотрим базовую механику резервирования хостов по схеме N+k, где N — количество основных серверов, k — резервных.