Обновить
128K+

Алгоритмы *

Все об алгоритмах

124,99
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Быстрое деление 64-битных чисел с округлением вниз
Уровень сложностиСредний
Время чтения37 мин
Охват и читатели2

Что такое деление целых чисел со знаком с округлением вниз?
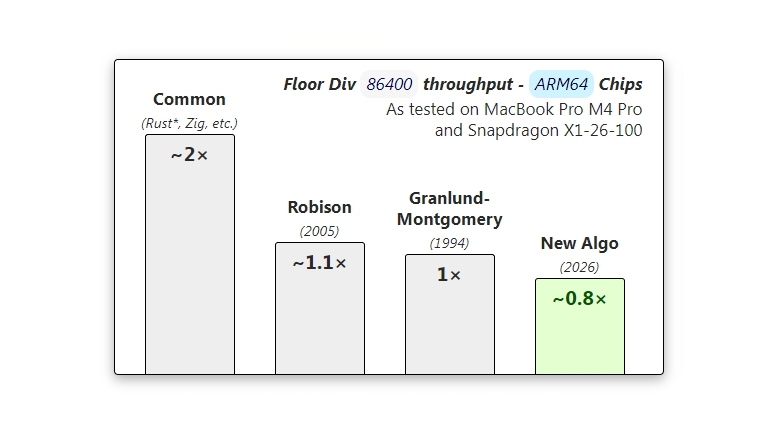
Деление целых чисел со знаком с округлением вниз — это когда мы выполняем a/b и получаем результат, округлённый в сторону −∞, в то время как стандартное деление (с усечением) чисел со знаком округляется в сторону 0. Как сказано в книге Hacker's Delight, «[Я подозреваю, что] деление с округлением вниз чаще даёт нужные нам результаты.»

Эта статья посвящена делению с округлением вниз чисел во всём диапазоне, когда делитель известен во время компиляции.

Несмотря на полезность этой функции, мир деления целых чисел с округлением вниз находится в полном хаосе:

• В популярных компиляторах и многих языках нет нативной реализации такого деления (например, в C/C++/Go/Swift).

• Языки и программные библиотеки, которые всё же реализуют его, почти не никогда не применяют самые быстрые алгоритмы.

• По крайней мере в одной крайне распространённой программной библиотеке уже более четырёх лет присутствует забагованная реализация такого деления с переполнением! (подробности ниже)

• При онлайн-запросах и промптах к LLM обычно выдаются только самые медленные алгоритмы

• И, наконец, в Hacker's Delight (по сути, Библии низкоуровневой компьютерной математики) почти ничего о нём не говорится!

В этом посте я не только расскажу о быстрых алгоритмах, но и приведу новый быстрый алгоритм.

Читать далее

Почему дорожают авиабилеты: считаем защиту тарифных классов на Python

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели3.6K

Вчера билет стоил 6 тысяч рублей, а сегодня на тот же рейс самый дешёвый вариант есть только за 10 тысяч. При этом в самолёте ещё десятки свободных мест. Зачем авиакомпании закрывать дешёвый тариф, если кресла пока не проданы?

В этой статье разберём на примере одного рейсе, откуда появляются лимиты бронирования, рассчитаем их, а затем переведём это на Python.

Читать далее

Бот в лабиринте: финал Кубка СЭРПАС 2026 на Эльбрусе. Часть 3

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели3.8K

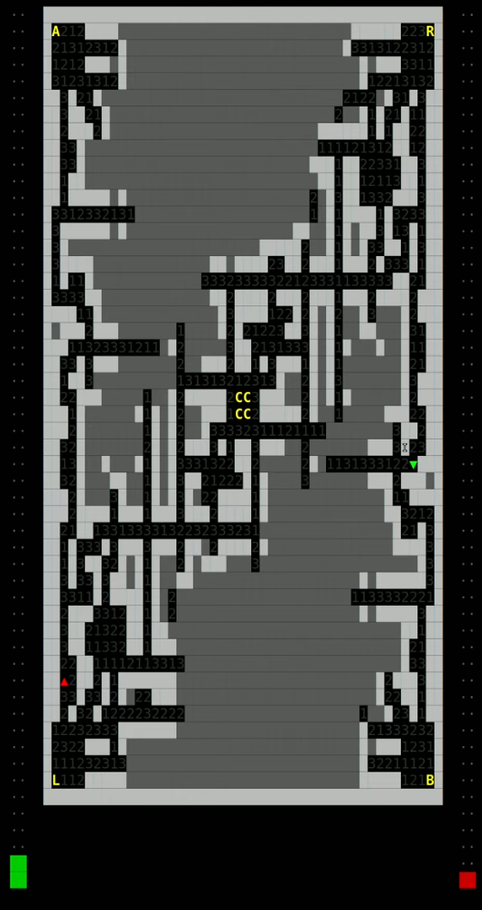
На финале Кубка СЭРПАС каждая клетка лабиринта была отдельной задачей, соперник бежал навстречу, а каждый лишний мегабайт памяти превращался в секунды, которые мой бот стоял на месте. Рассказываю, как он искал путь в тумане, почему двенадцать потоков оказались быстрее тридцати и чем закончилась серия.

Как бот прошёл лабиринт

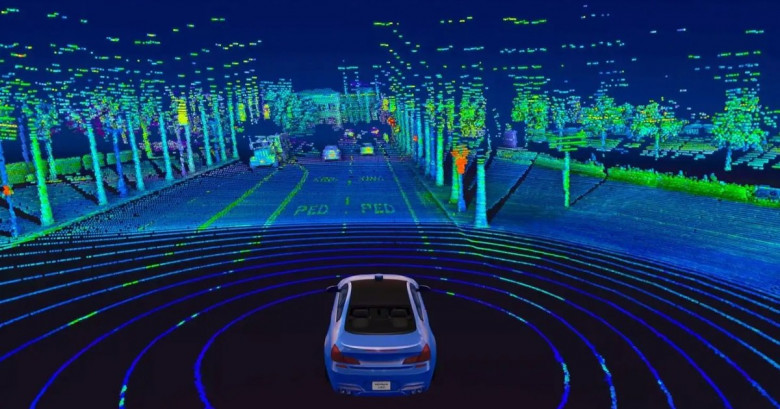
Как наземный LiDAR видит дрон и что нужно для трекинга

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели3.8K

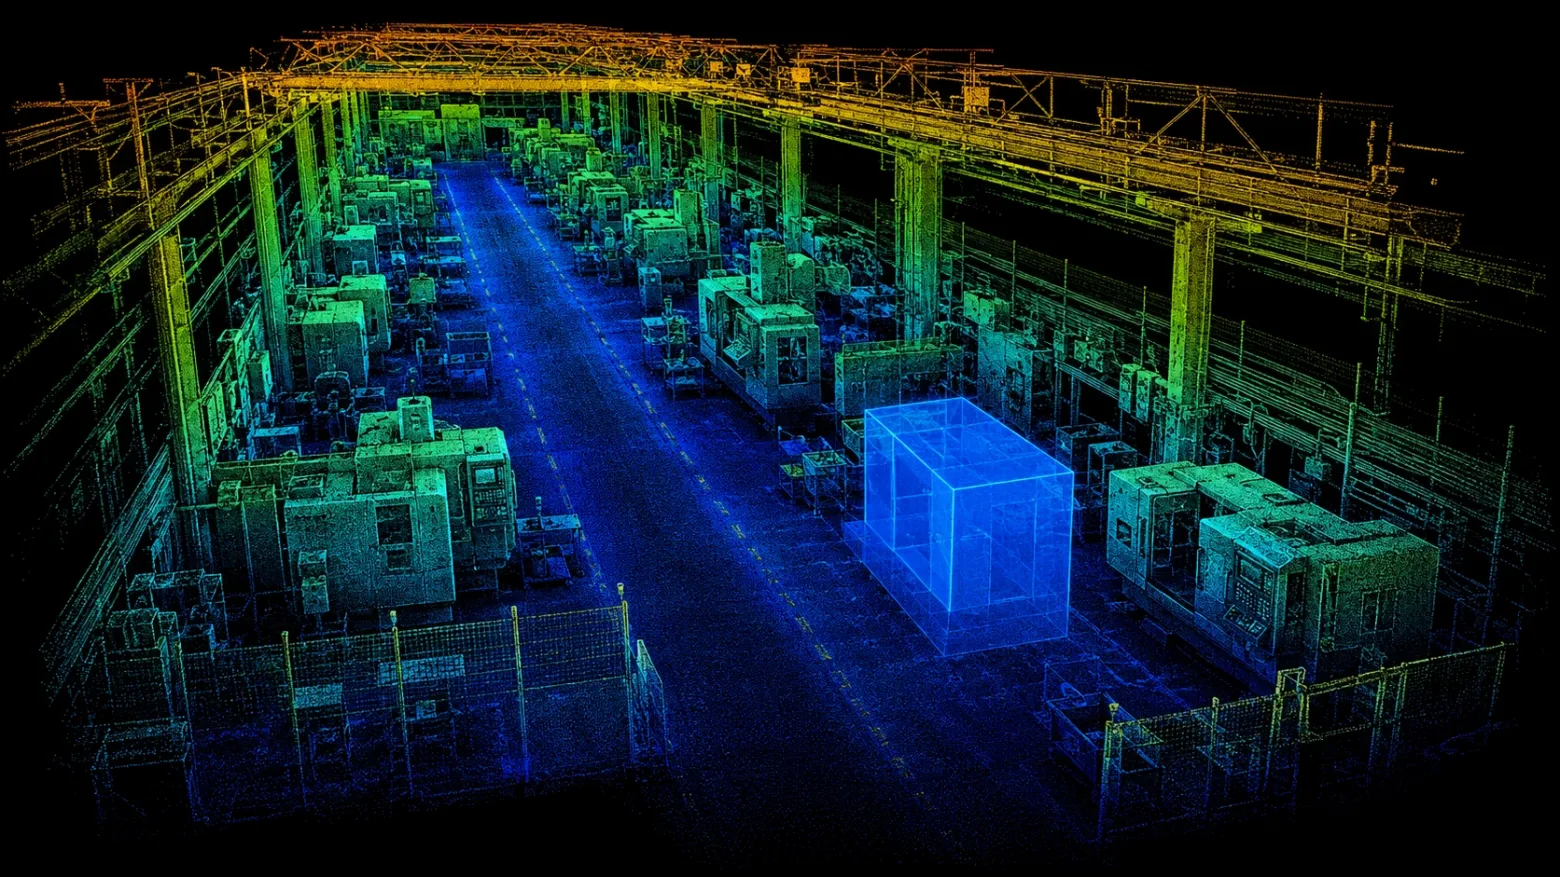
Можно ли отслеживать полёт дрона с земли в условиях, когда спутниковая навигация недоступна, а камера теряет цель? На складе инвентаризационный дрон летит вдоль стеллажей и считывает маркировку. Чтобы проверить, где он отклонился от маршрута, нужны координаты вдоль всего пролёта, а внутри здания GPS ловит плохо. На открытой площадке за дроном можно следить по видео, но в дождь или туман детектор может начать пропускать его на отдельных кадрах.

Я решил проверить, можно ли наблюдать за дроном с помощью неподвижного наземного лидара. Он даёт трёхмерные координаты отражений без бортовой телеметрии и при слабом освещении.

Работу я начал с двух задач: сначала требуется отделить поверхность земли, а затем выделить компактные группы точек, среди которых можно искать дрон.

Читать далее

Как мы собираем и склеиваем объявления из 200+ Telegram-каналов Ташкента

Время чтения7 мин
Охват и читатели3.8K

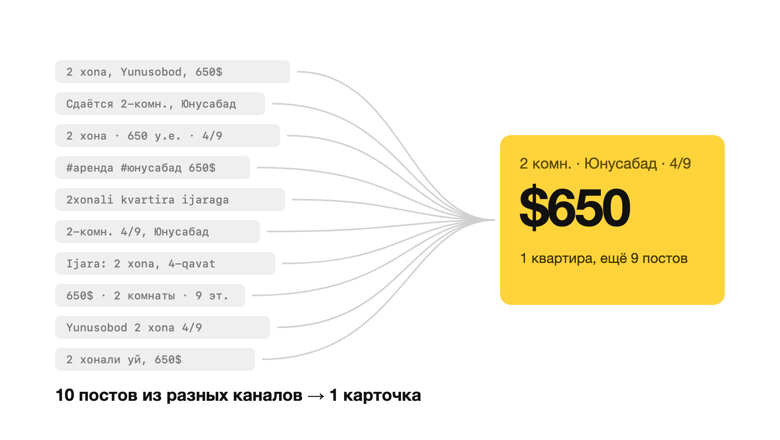
В Ташкенте квартиру в аренду ищут не на большом сайте объявлений, а в Telegram. Каналов с объявлениями — сотни: у каждого агентства свой, плюс районные, студенческие, «без посредников». Одну и ту же квартиру выкладывают в пяти-десяти из них, с разными фото, ценой в долларах или сумах, на русском, узбекском латиницей и узбекском кириллицей — часто в одном посте.

Мы делаем kvadro² — сервис поиска квартир: сайт kvadro.app, Telegram-бот и приложение внутри Telegram (Mini App). Он собирает объявления из 215 открытых каналов Ташкента, Ташкентской области, Андижана, Намангана, Коканда и Ферганы в одну ленту. Ниже — как это устроено: от чтения каналов до склейки дублей и подсчёта «цены к рынку». Без секретов и без маркетинга, с цифрами из нашей рабочей базы.

Читать далее

Как я написал 2 языка программирования и решил отказаться от разработки ЯП вовсе…

Уровень сложностиПростой
Время чтения6 мин
Охват и читатели4K

Как-то я занялся решением алгоритмических LeetCode-задачек. Так как я больше привык к реальным, прикладным задачам, для меня это было достаточно дико поначалу. Затем втянулся: это как решать головоломки. Я люблю разгадывать судоку, например, и в шахматы играть — это из той же оперы, развлекуха.

Так вот, решая задачки, я переосмыслил программирование в принципе и задался вопросом — почему такие простые задачки нужно решать так сложно? Ведь некоторые вещи достаточно очевидно решаются на уровне понимания, но становятся сложными на уровне написания кода.

И это касается не только разработки. Так же обстоит дело и в математических вычислениях — наверное, потому что у них общие корни. Я периодически размышлял над этим, когда делал рабочие проекты и свои pet project-ы. И пришел к выводу, что основная причина — это закрытость. Многое делается под капотом, и разработчику (читай — пользователю языка) нужно многое додумывать, многое держать в голове, о многом догадываться, многое проверять.

Отсюда растет сложность, отсюда множатся ошибки, отсюда разработчики частенько выгорают. Забавно, что наши боли породили целую индустрию решателей таких болей — и даже не одну: тестирование, продуктивность, мотивация, лечение от выгорания, курсы программирования… (И все потому, что мы простые вещи делаем сложными способами.)

Тогда я задался вопросом, а как бы я сделал? Как можно сделать по-другому? Наглядно и удобно, очевидно и просто? И пришел к очевидному выводу: надо сделать модель того, что происходит под капотом, когда исполняется код. И тогда я смоделировал обход списка с выполнением действия — по сути, foreach. У меня получился странник, который идет по 1D-карте. Если добавить вложенный for, то странник уже идет по 2D-карте и так далее…

Но мой подход был реализован теми же закрытыми средствами, и поэтому наглядности не получилось: да, метафорично, но не видно ни карты, по которой идет путник, ни самого путника. Тогда я остановился на этом и перешел к написанию ЯП — правда, цель у меня была другая :)

Читать далее

Почему нельзя просто соединить точки: как сгенерировать синтетический IMU, которому поверит VIO

Уровень сложностиСложный
Время чтения16 мин
Охват и читатели9.6K

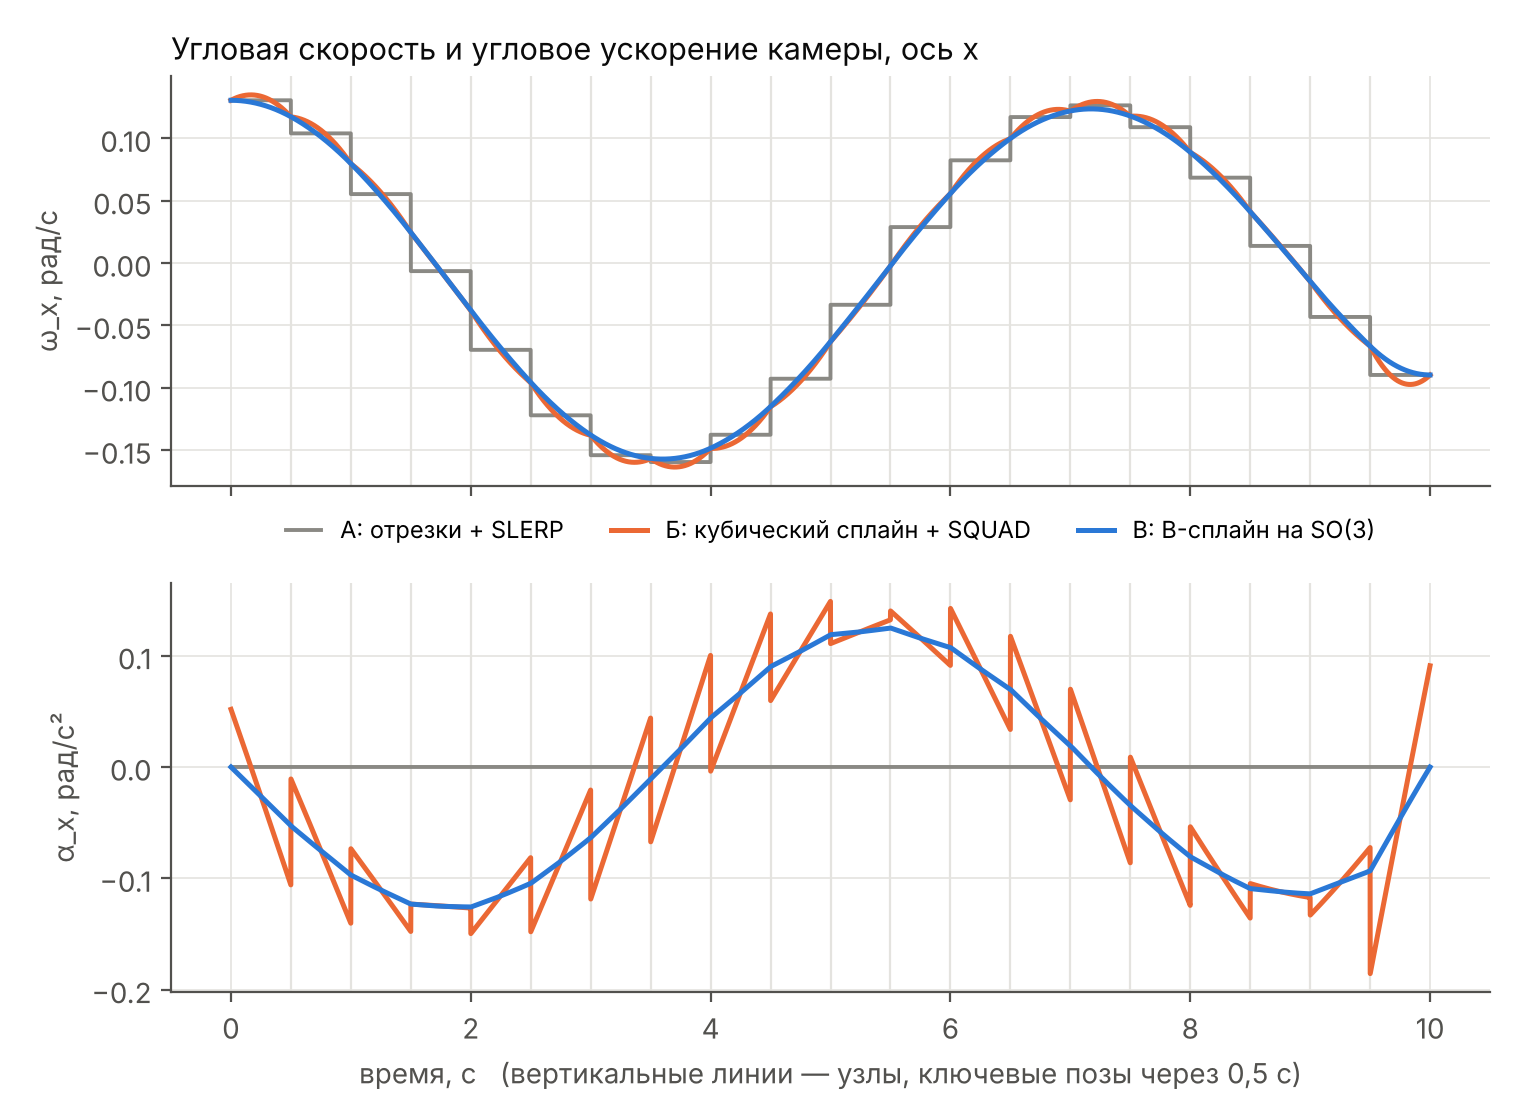
Я сгенерировала показания идеального IMU — без шума и дрейфа — по траектории, заданной ключевыми позами и сферической интерполяцией, и проинтегрировала их обратно. Среднеквадратичная ошибка положения за 10 секунд получилась около 8 метров. Повышение частоты датчика с 50 до 1600 Гц её не уменьшило.

С другой моделью траектории та же проверка при 200 Гц даёт от 10 см до 10⁻¹¹ м — в зависимости от схемы интегрирования. Главное даже не сами числа, а то, что ошибка уменьшается с шагом так, как положено данной схеме. Эта статья о том, откуда такая разница.

Алгоритмы визуально-инерциальной одометрии (VIO) и SLAM — VINS-Mono [1], ORB-SLAM3 [2], OpenVINS [3] — оценивают движение камеры по изображениям и показаниям инерциального блока: акселерометра и гироскопа. Чтобы их сравнивать и отлаживать, нужны данные с точно известной истинной траекторией.

В реальных наборах вроде EuRoC [4] и TUM VI [5] эталон снят внешней системой: захвата движения или, в части серий EuRoC, лазерным трекером, который измеряет только положение. Эталон доступен только в зоне действия этой системы и сам содержит погрешность. К тому же условия записи зафиксированы: нельзя взять ту же запись и отдельно поменять шум датчика или расстояние между камерой и IMU. В синтетических данных траектория задаётся программно, и все параметры меняются независимо.

Синтетика полезна, только если показания датчиков согласованы с заданным движением, а это зависит от того, как именно задана траектория. Это часть моей дипломной работы в НИТУ «МИСИС»: там по той же траектории рендерятся кадры сцены, восстановленной гауссовым сплаттингом. Здесь только инерциальная часть.

Читать далее

Мир Кузи: ИИ, который не разговаривает, а принимает решения

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели7K

Decision Models — новый класс моделей искусственного интеллекта

Это статья из серии «Мир Кузи». Decision Models — новый класс моделей искусственного интеллекта. Они не разговаривают с человеком, а принимают решения: выбирают вариант, проверяют условие или ставят оценку. Разбираю, чем они отличаются от классических классификаторов и LLM, какие модели уже есть — Jev, Liquid d1, Gemini Decision, Kev — и где их применять. В конце — бонус.

Читать далее

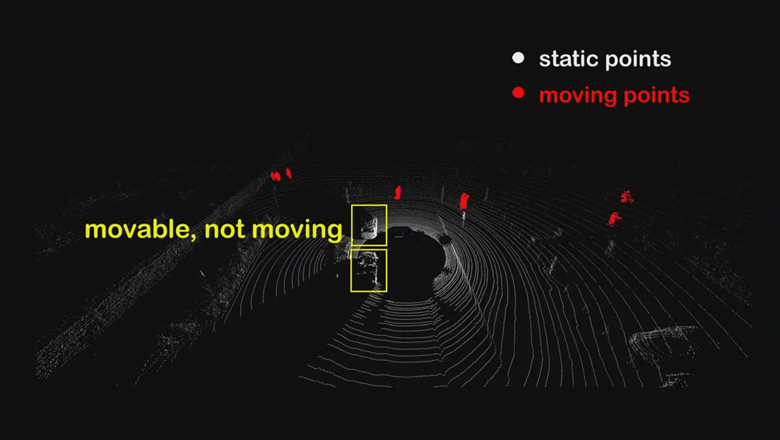
Детектор движения работающий в движении

Время чтения4 мин
Охват и читатели9.5K

M-detector обещал чистить карту проходимости от движущихся объектов, но вместо этого положил 20-ядерный i7 и уронил всё приложение. Рассказываю, как пакет ведёт себя в паре с DLIO на лидаре mid360.

Читать далее

Плоское зеркало для лидара: от двумерной комнаты к трёхмерной сцене

Уровень сложностиСредний
Время чтения11 мин
Охват и читатели7.6K

Лидар видит только то, куда доходит луч. Поле зрения конечно, а стена закрывает пространство за собой. Второй сенсор закрывает часть таких зон, но занимает место, питание и отдельный канал. Плоское зеркало лучей не добавляет: оно разворачивает уже испущенные.

На плоской сцене один лидар и одно зеркало-отрезок. Свободны три числа: две координаты центра и угол. Подбор ставит зеркало так, что часть лучей уходит в половину комнаты вне поля зрения. Та же задача в трёх измерениях — треугольный меш, несколько лидаров и прямоугольных зеркал, часть приборов едет вместе с носителем. Ниже числа плоского расчёта и схема объёмного: поверхностные воксели, Intel Embree на процессоре, Vulkan на видеокарте.

Читать далее

Как ускорить A* в пробках в 10 раз

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели12K

В три часа ночи A* ищет маршрут по Москве в 11 раз экономнее алгоритма Дейкстры: перебирает в 11 раз меньше перекрёстков. В половине девятого утра на тех же самых запросах от этого выигрыша остаётся 2,5 раза. Алгоритм тот же, просто на дорогах пробки.

Мне давно интересно, как навигаторы успевают за доли секунды проложить маршрут через огромный город, да ещё с учётом пробок. Чтобы разобраться, я собрал свой простой вариант на настоящей карте Москвы и упёрся ровно в эту проблему. Тогда захотелось проверить, можно ли вернуть A* в час пик его ночную форму. Попробовал две поправки: таблицу из 96 чисел и крошечную нейросеть на 169 параметров. Обе поднимают выигрыш в час пик до 10–12 раз, а маршрут выходит в среднем на 1–2% дольше идеального. Дальше расскажу, как это устроено, и покажу цифры по 1800 запросам.

Смотреть цифры и карты

Почему The AI Scientist сбоит в 41% случаев: анатомия галлюцинаций в Autonomous AI и физическая истина в DeepTech

Уровень сложностиСложный
Время чтения17 мин
Охват и читатели8.2K

Почему автономный ИИ The AI Scientist сбоит в 41% экспериментов и генерирует антинаучные галлюцинации? Системный аудит архитектур современных DeepTech-систем (DeepMind, Sakana AI, Periodic Labs, FutureHouse, EvoNova Labs) и математическое решение проблемы физической истины на базе П-теоремы Бэкингема, фазовых инвариантов Гамильтона и Do-исчисления Перла.

Читать далее

Нейросеть сделала 3D‑модель по фото. Почему принтер с ней совсем не согласен

Уровень сложностиСредний
Время чтения11 мин
Охват и читатели12K

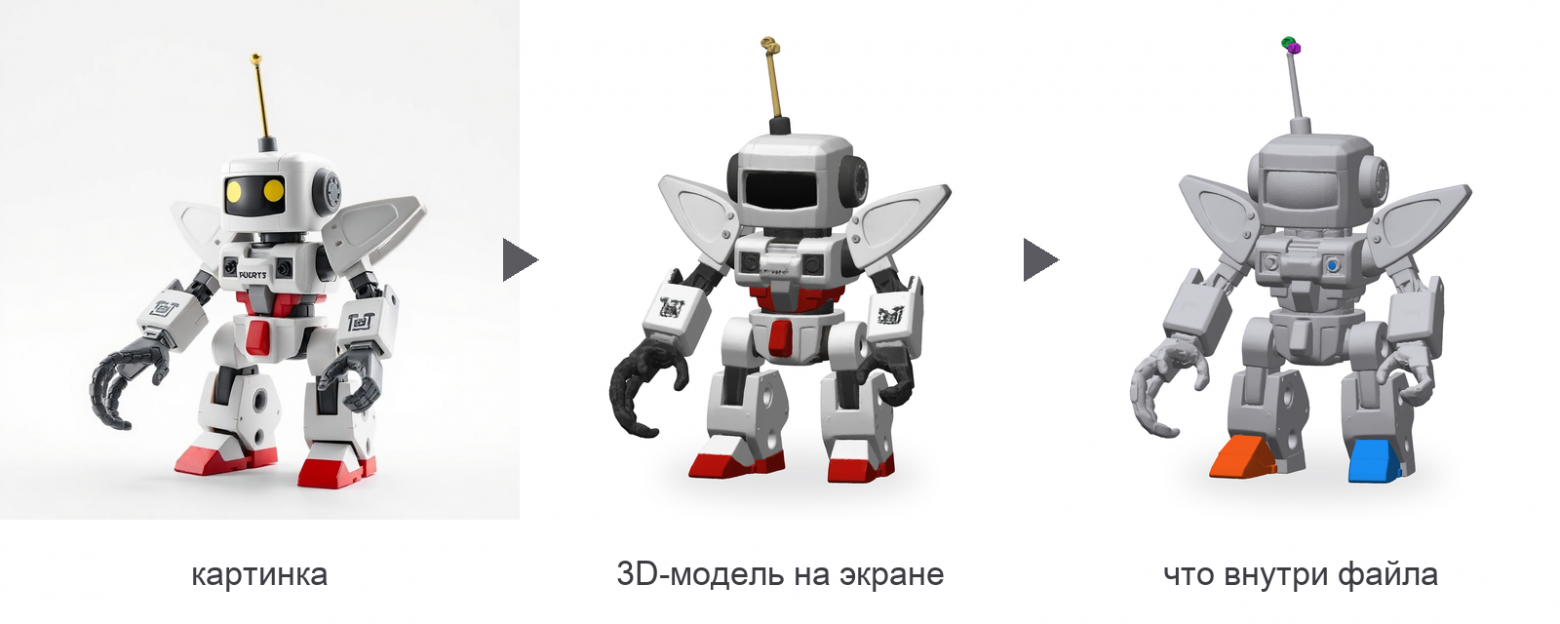
Вы скармливаете нейросети снимок фигурки, и через несколько минут на экране уже крутится аккуратная 3D‑модель. Всё на месте, даже надпись на груди. Скачиваете файл, открываете слайсер, а он первым делом интересуется, не в метрах ли вы случайно сделали эту красоту. А в файле она размером с маковое зерно.

И это самый безобидный дефект. Почти у каждой второй модели слайсер показывает значок предупреждения. А о некоторых дефектах он прямо не говорит: на превью всё выглядит идеально, а в файле ступни робота висят в воздухе отдельно от ног.

Меня зовут Артём Кузнецов, я AI/ML‑инженер и CTO стартапа, который занимается AI‑технологиями в области 3D‑печати.

Ниже — откуда берутся эти дефекты, если заглянуть под капот генераторов, и как их определять за пару минут, пока стол принтера нагревается. Разбор идёт на уровне сетки и с кодом, так что может пригодиться и тем, кто встраивает генерацию 3D в свой софт.

Читать далее

Ближайшие события

Компьютеры из желудей и спичек

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели8.6K

Верёвка есть вервие простое, а компьютер — это «такая вот штука». Обязательно ли нужен процессор, чтобы некая штука называлась компьютером? А всё, что с процессором — это обязательно компьютер? И где, вообще, граница?

Компьютеры из карт, игр, curl и хабракомментов.

Читать далее

Теорема Байеса в реальной жизни — это не про формулу

Уровень сложностиСложный
Время чтения12 мин
Охват и читатели9.9K

Сразу к делу. Если вы открыли эту статью, потому что искали гайд “Теорема Байеса за 5 минут”, шпаргалку для прохождения собеседования или надеетесь увидеть очередной стерильный пример про “редкую болезнь и тест с точностью 99%” — вам не сюда. Закрывайте вкладку, берегите глаза, время и карму. Материал плотный, требует включения головы и не предполагает легкого чтения.

Если вы остались, значит, вы уже сталкивались с тем, что в реальной аналитике и бизнесе знание формулы наизусть не стоит ничего.

В интернете 90% обучающих материалов по Байесу сводятся к двум крайностям. Первая - сухая академическая нудятина с вероятностными пространствами, которую невозможно применить на практике. Вторая - крайнее упрощение, где автор дает готовые проценты “из вакуума”, а от вас требуется лишь механически разделить числитель на знаменатель.

Оба подхода формируют опасную иллюзию: кажется, что Байес - это просто калькулятор. Но в реальной работе, когда вы сталкиваетесь с живыми, зашумленными данными, никто не выдает вам готовые “Правдоподобия” на блюдечке. Главная сложность заключается не в арифметике, а в методологии: как сформулировать гипотезу, откуда брать цифры и, самое главное, как правильно “нарезать” выборку.

В этой статье мы не будем зубрить формулу. Вместо этого мы разберем:

Почему если у вас есть SQL таблица со статистикой - теорема Байеса вам, скорее всего, не нужна.

Как смена базовой выборки меняет управленческое решение с минуса на плюс (разберем на примерах покупки подержанного авто, контроля качества на производстве и фильтрации B2B-лидов).

Где аналитики фатально путают P(E\mid H) и P(H\mid E) и как не стать жертвой “эффекта маскировки” в реальных данных.
Жесткий чек-лист из трех пунктов, который нужно прогнать в голове, прежде чем подставлять первые цифры в формулу.

Статья написана для тех, кто хочет научиться принимать решения на основе данных, а не просто красиво цитировать учебники. Если вы готовы копнуть глубже механического подсчета дробей - добро пожаловать под кат.

Читать далее

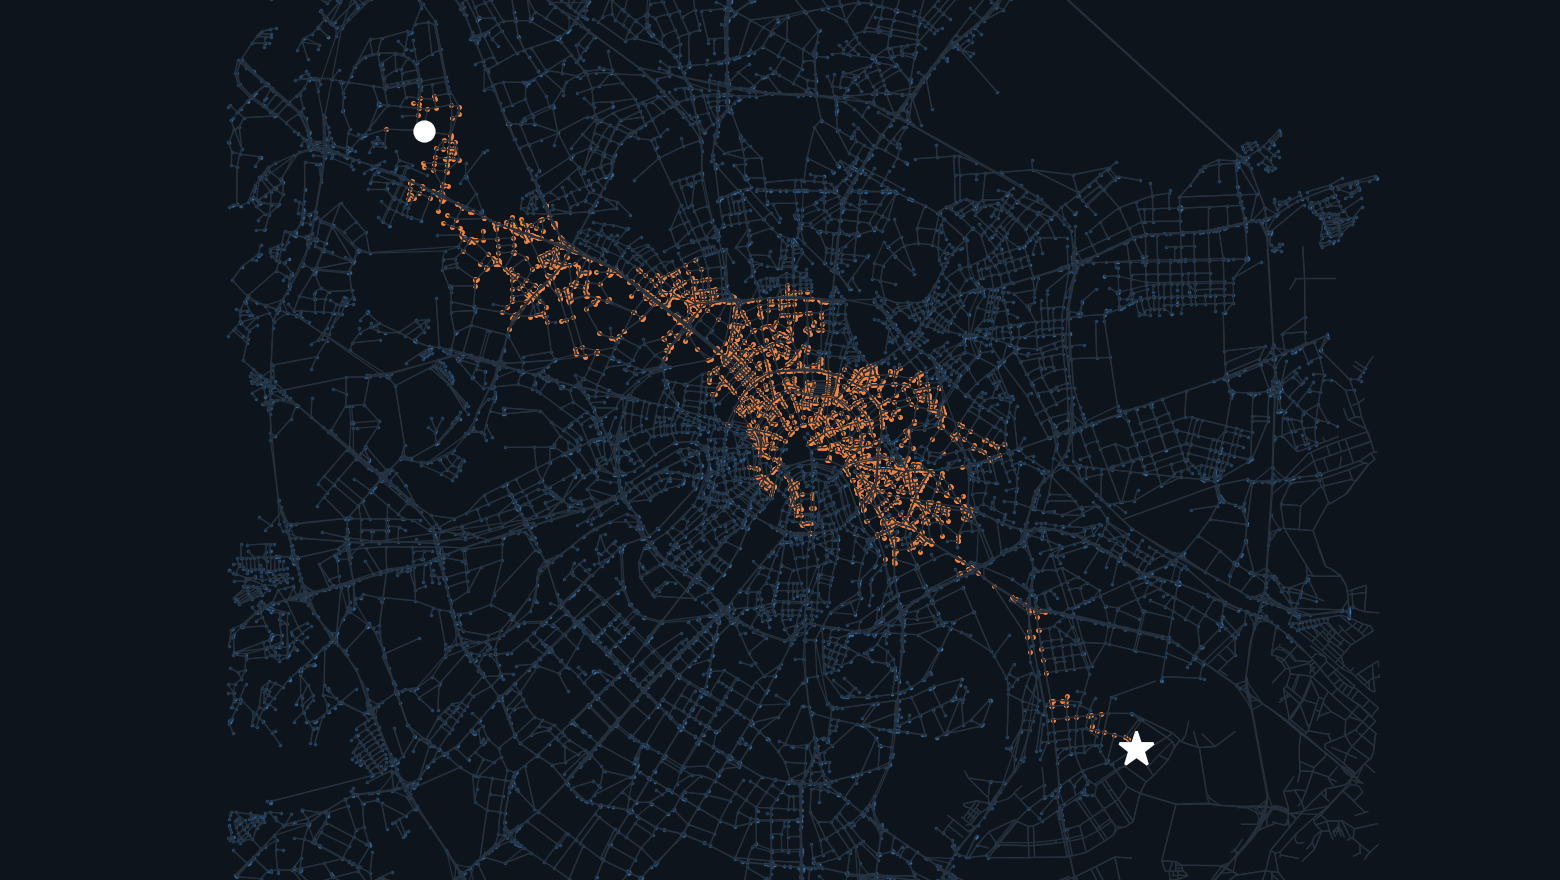
Карта на 78 млн клеток, которую я так и не построил: Кубок СЭРПАС 2026 на Эльбрусе. Часть 2

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели7.5K

Карта города на 78 миллионов клеток, и для каждой нужно расстояние до ближайшего пункта выдачи. Я посчитал все суммы и максимумы, так ни разу и не построив саму карту, а время упало с 444 до 70 мс.

Это вторая часть рассказа о том, как я выиграл Кубок СЭРПАС 2026 на Эльбрусе. В ней точные свёртки через NTT вместо FFT, параболы, ячейки Вороного и четыре строки в одном регистре.

Как обойтись без карты

От быстрых скипов до полных досмотров: как мы предсказываем распределение времени просмотра

Уровень сложностиСложный
Время чтения10 мин
Охват и читатели6.8K

Привет, Хабр! Мы — команда AI VK: Софья Гулевская, Михаил Трапезников, Александр Пославский и Александр Дьяконов. В этой статье расскажем, почему привычные методы прогнозирования времени просмотра не всегда справляются с короткими видео, какие проблемы возникают при обучении вероятностных моделей и как мы решили их с помощью HEGM — Hierarchical Exponential-Gaussian Mixture.

Покажем архитектуру, результаты экспериментов на открытых и промышленных данных, а также расскажем, что изменилось после A/B-тестирования на реальном трафике. Исследование принято в основной трек конференции IEEE ICDM 2026, а код и модели мы выложили в открытый доступ.

Подробности под катом

Построение карты проходимости на GPU по данным RGB-D камеры & лидара

Время чтения5 мин
Охват и читатели11K

Как я переносил CUDA-ядра Elevation Mapping на своего ровера и почему для качественной карты проходимости всё-таки нужны лидары и пакеты SLAM с очисткой облаков точек в реальном времени.

Читать далее

Алгоритм поиска областей по точкам в 2D-пространстве

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели6.8K

Изначальной задачей являлось определение конкретной области 2-х мерного пространства, которой принадлежит произвольная заданная точка, при условии наличия некоторой коллекции таких областей. Каждая область определяется двумя точками: начальной – P0, и конечной – P1 (рисунок 1). Вопрос заключался в том, каким образом организовать хранение и навигацию по данной коллекции для минимизации издержек и повышения производительности. Дополнительным условием, немного упрощающим реализацию алгоритма, являлась однозначность соответствия точек и областей, иными словами – области не пересекаются.

Наивная реализация предполагает создание массива, по которому можно осуществить поиск через простой перебор областей до момента нахождения искомой. Более продвинутая реализация, позволяющая сэкономить вычислительные ресурсы, в свою очередь, может базироваться на концепции KD-деревьев, о чем и будет рассказано в данной статье.

Читать далее

Клеточный автомат на микросхемах мелкой логики. Часть 1 — Изобретаем велосипед

Уровень сложностиПростой
Время чтения9 мин
Охват и читатели17K

Я давно хотел реализовать клеточный автомат «в железе» — то есть без программ, процессоров, микроконтроллеров, — на жёсткой логике. Например, широко известную игру «Жизнь». Однако каждый раз, когда я пытался представить себе реализацию, получалось нечто ужасное: сотни и сотни логических элементов ради того, чтобы собрать крошечное поле, на которое не влезет ничего, кроме одного глайдера. Поэтому я решил начать с чего-то более простого, — например, взять не двумерный клеточный автомат, а одномерный. Скажем, «Правило 110». В этой серии статей я расскажу, как мне удалось решить эту задачу.

Читать далее
1
23 ...