Обновить
64K+

Big Data *

Большие данные и всё о них

37,65
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Что делать с данными, которые не прошли проверку качества: история 500 миллионов возвращенных строк
Уровень сложностиСредний
Время чтения12 мин
Охват и читатели7K

Привет, Хабр! Меня зовут Илья Лысенко, я работаю в команде платформы данных Lamoda и занимаюсь пайплайнами продуктовой аналитики и качеством данных.

Полтора года назад мы открыли дашборд и увидели график отклоненных строк, идущий отвесно вверх: больше миллиона событий в день перестали проходить валидацию.

Источник событий молча поменял формат критического поля, а downstream-потребители, аналитики и дата-сайентисты, об этом даже не подозревали.

Вариантов действий в такой ситуации обычно два. Остановить пайплайн и разбираться – значит терять данные, пока чиним. Ехать дальше – значит отдавать потребителям некачественные данные. Оба ведут к просадкам в качестве анализа и моделей, которые зависят от данных источника. К счастью, нам выбирать не пришлось: третий вариант мы к тому моменту строили уже несколько лет.

Если у вашего пайплайна есть DLQ (Dead Letter Queue, очередь недоставленных сообщений), вспомните, когда вы в последний раз оттуда что-то доставали. Часто записи падают в DLQ, и на этом их история заканчивается. У нас процесс устроен по-другому. Запись, не прошедшая проверку качества, не удаляется: она паркуется в отдельном хранилище, откуда ее можно вернуть – целиком и без дублей.

Расскажу, как такой пайплайн устроен, и разберу тот самый кейс: с февраля 2025 года в reject ушло порядка 500 миллионов строк, и каждая в итоге доехала до потребителей.

Читать далее

Золото, бриллианты и BigData: ювелирный рынок на данных

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели5.7K

Перед тем, как совершить покупку, человек проходит большой путь от выбора магазина до выбора самого ювелирного изделия.

Представим человека, который выбирает украшение в подарок – он может посмотреть ассортимент нескольких ювелирных магазинов, сравнить цены, вернуться к понравившемуся варианту, и только потом совершить покупку, возможно вообще в офлайне. Для бизнеса в целом - это одна продажа, но для аналитика это целая цепочка интересов сразу к нескольким брендам.

Поэтому мы решили заглянуть во внутрь этой цепочки, опираясь не только на финансовые показатели рынка, но и на результаты отдельных игроков, поисковые запросы, покупательскую активность.

Читать далее

DataFusion — не только для аналитики: как ускорить точечные запросы почти в 8 раз

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели10K

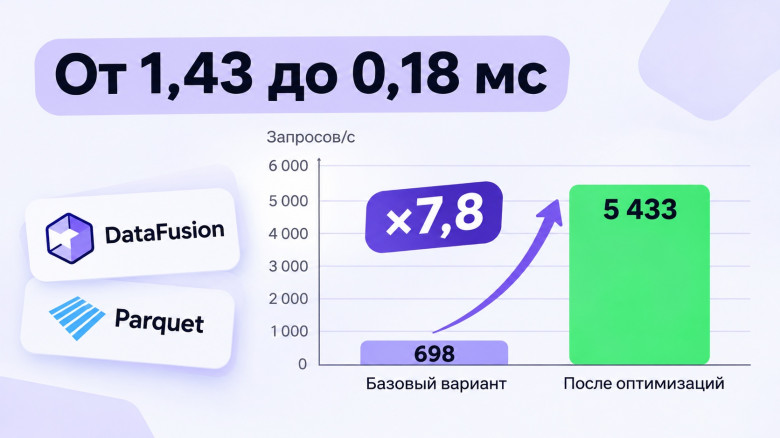
DataFusion умеет обрабатывать большие объёмы данных, но насколько хорошо он справляется с поиском одной строки среди миллионов? При точечных запросах даже небольшие накладные расходы могут заметно снижать пропускную способность. Разберём, как настройки Parquet и оптимизация выполнения запросов помогли ускорить точечное чтение почти в 8 раз и сократить время отклика до 0,2 мс.

Разобрать оптимизации

Не набрасывайся на ROC AUC или как обучать промышленные ML‑модели

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели6.3K

Привет! Меня зовут Владислав Суханов. Я руководитель направления Риски в Центре развития искусственного интеллекта в Ингосстрахе. Сегодня расскажу, чем промышленный ML отличается от учебного и как строить модели со стабильно высокими метриками качества.

В данной статье я НЕ буду рассматривать обработку пропусков, работу с категориальными переменными, константами в признаках и тд, так как по данным темам уже написано много работ и в целом проблемы являются решёнными.

Здесь рассмотрим, как работать с Data Drift и Concept Drift при обучении моделей.

Читать далее

Можно ли найти выходные, если удалить все даты? 150 чисел и Python

Уровень сложностиСредний
Время чтения15 мин
Охват и читатели6.8K

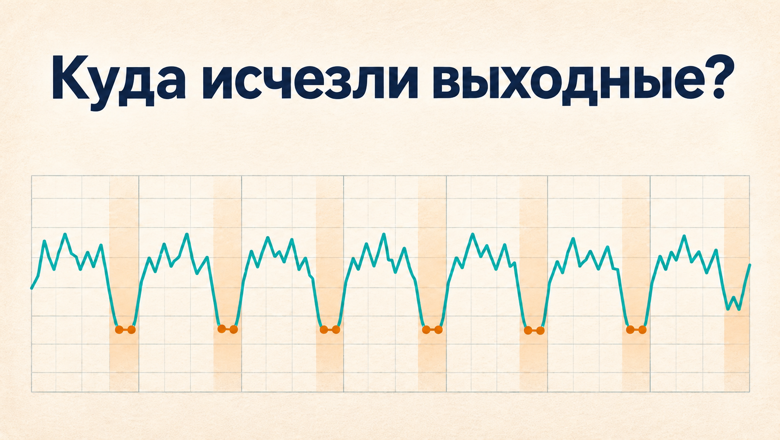
Даты потерялись, остались только 150 чисел — количество визитов за сутки. Можно ли по ним понять, где были выходные?

Читать далее

«Селдон»: как я учила модель предсказывать войны и девальвации и не подглядывать в будущее

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели11K

У Айзека Азимова в «Основании» математик Гэри Селдон строит психоисторию — науку, которая не знает, что сделает отдельный человек, но считает вероятности больших исторических сдвигов.

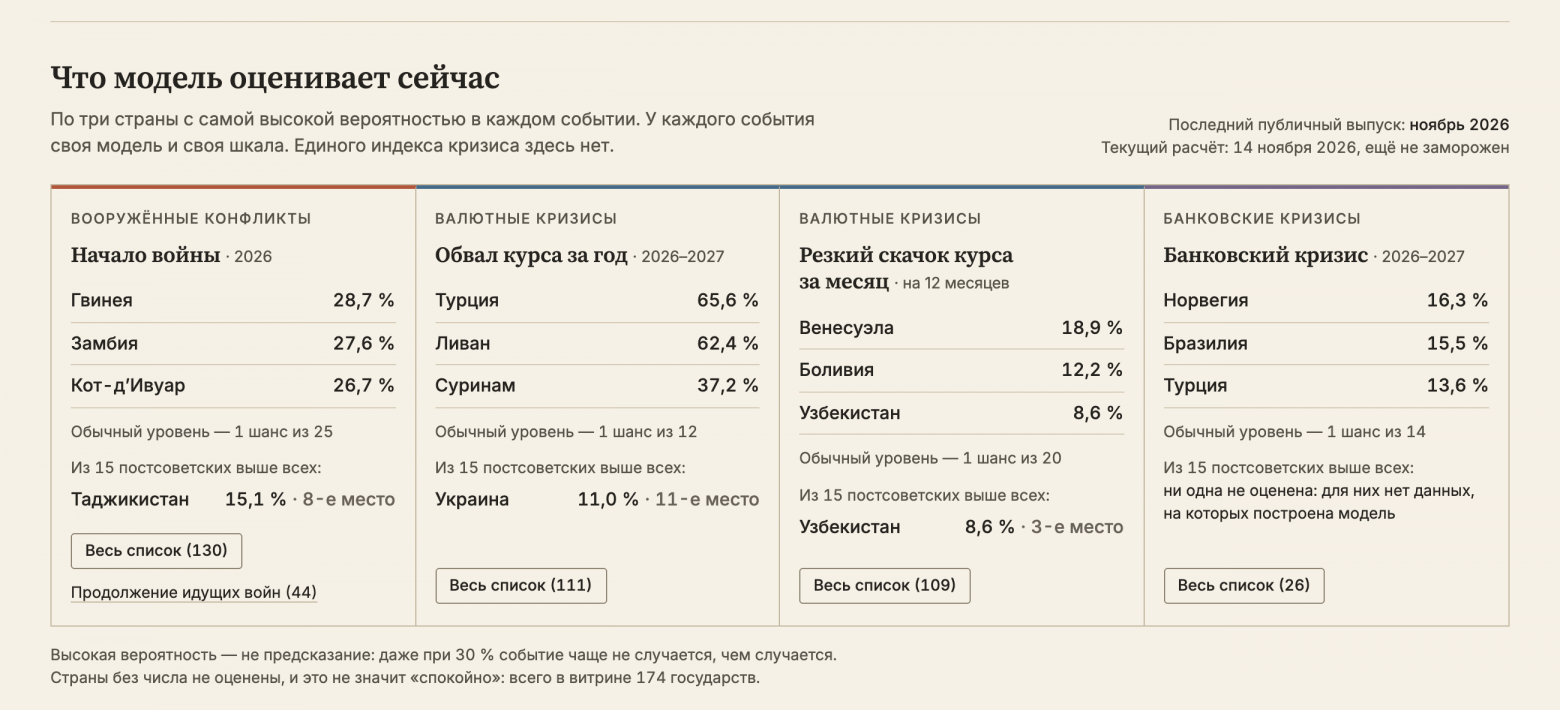
По образованию я физик, по работе — продакт-менеджер. Мне захотелось проверить приземлённую версию этого вопроса на открытых данных: насколько честно можно оценить вероятность начала войны, обвала валюты или банковского кризиса для 174 стран мира, с отдельным вниманием к 15 постсоветским.

Не задним числом («на выборке 1990–2020 коэффициент значим»), а так, как это выглядит в жизни: сегодня 1 января года TT, часть статистики за прошлый год ещё не вышла, будущее неизвестно.

Так появился открытый исследовательский проект «Селдон» (Seldon). Сейчас в нём четыре публикуемых прогноза (начало войны, девальвация за год, скачок курса за месяц, банковский кризис), 111 автотестов, из которых 65 проверяют утечки будущего, первый замороженный снимок прогнозов (forecasts/2026-11/, дальше раз в месяц) и статическая веб-витрина.

Ниже — что работает, какие гипотезы не подтвердились при проверке вслепую (индексы демократии, идеология правящих партий, «критическое замедление» из физики фазовых переходов) и где мне нужны идеи и критика.

Что из этого вышло

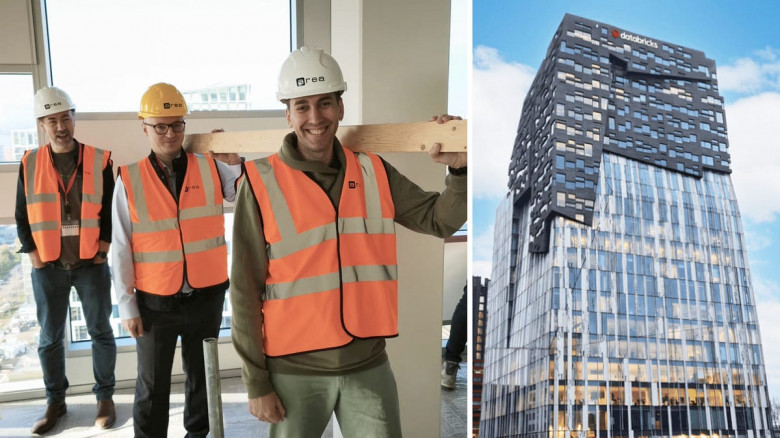
Как выглядит новый офис Databricks в Амстердаме: фоторепортаж 2026

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели13K

Побывал на открытии нового офиса Databricks в Амстердаме, что интересного и необычного в нём и какие преимущества даёт статус Databricks MVP при посещении. Небольшой фоторепортаж.

Читать далее

Научить AI понимать строительный объект

Уровень сложностиСредний
Время чтения42 мин
Охват и читатели11K

Строительная отрасль уже давно активно цифровизируется в проектах применяются информационные модели, цифровые документы, ведомости, сметы, системы управления замечаниями, планированием, согласованиями и так далее. 

Данных становится всё больше!

Но вместе с ними не исчезает одна из главных проблем строительного проекта — полноценная автоматизация процесса перевода данных в осмысленную информацию до сих пор не достигнута. Сегодня этот перевод выполняется преимущественно вручную. Специалистам приходится самостоятельно разбираться в массивах данных, интерпретировать их и компилировать в проектные артефакты — ведомости и сметы. В ходе такой кустарной обработки связи между блоками данных всё же формируются, но они намертво замыкаются на авторе‑исполнителе. Без сквозных цифровых алгоритмов эта информация становится непрозрачной для остальной команды, а понимание того, «что делать с ней дальше», теряется. В масштабах всего проекта это неизбежно ведет к информационному хаосу«. »

Чтобы не было информационного хаоса, приходится вручную его обслуживать, даже при том что используем цифровые инструменты, но как правило они все исповедуют детерминированный подход, а все отклонения от выстроенного алгоритма обслуживаются специалистами, экспертами. 

По сути, человек в этой схеме выполняет роль «хранителя контекста» для зоопарка не умеющих гибко адаптироваться программ. Цифровизация автоматизирует порядок, но бессильна перед энтропией. До тех пор, пока системы не научатся оперировать контекстом, вероятностями и нечеткой логикой так, как это делает человеческий мозг, эксперты будут оставаться заложниками детерминизма — живыми процессорами, сглаживающими углы несовершенных алгоритмов. 

Читать далее

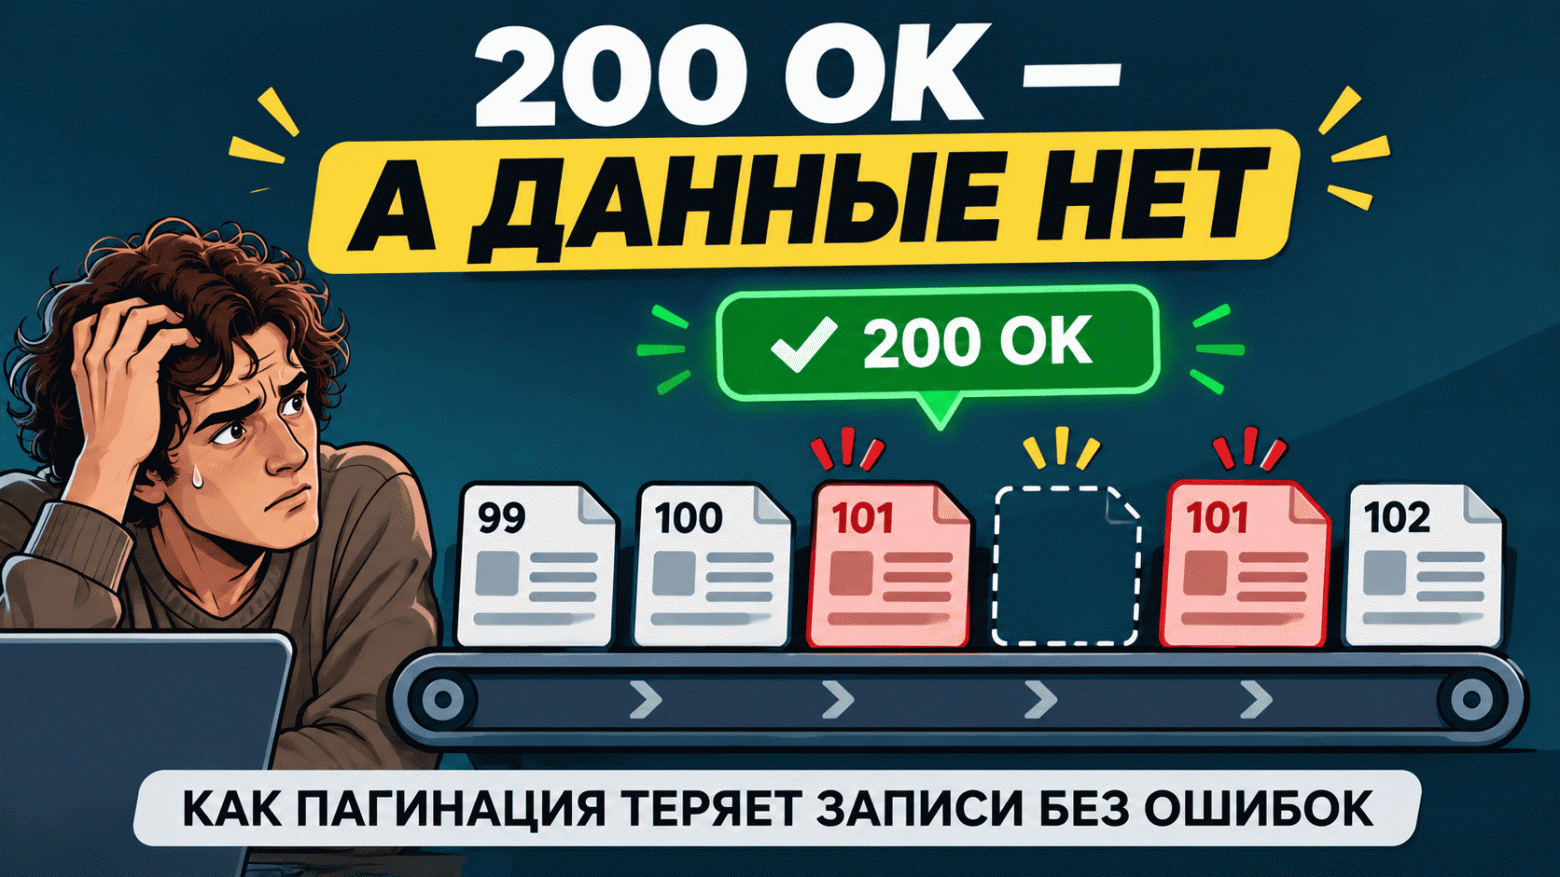
Все запросы вернули 200 OK, а записи пропали. Как пагинация незаметно теряет данные

Уровень сложностиПростой
Время чтения7 мин
Охват и читатели6.4K

API отвечает 200 OK, скрипт завершается без ошибок, а часть данных так и не попадает в базу. Разберём, как обычная пагинация может незаметно терять и дублировать записи, воспроизведём проблему на Python и посмотрим, как её обнаружить.

Читать далее

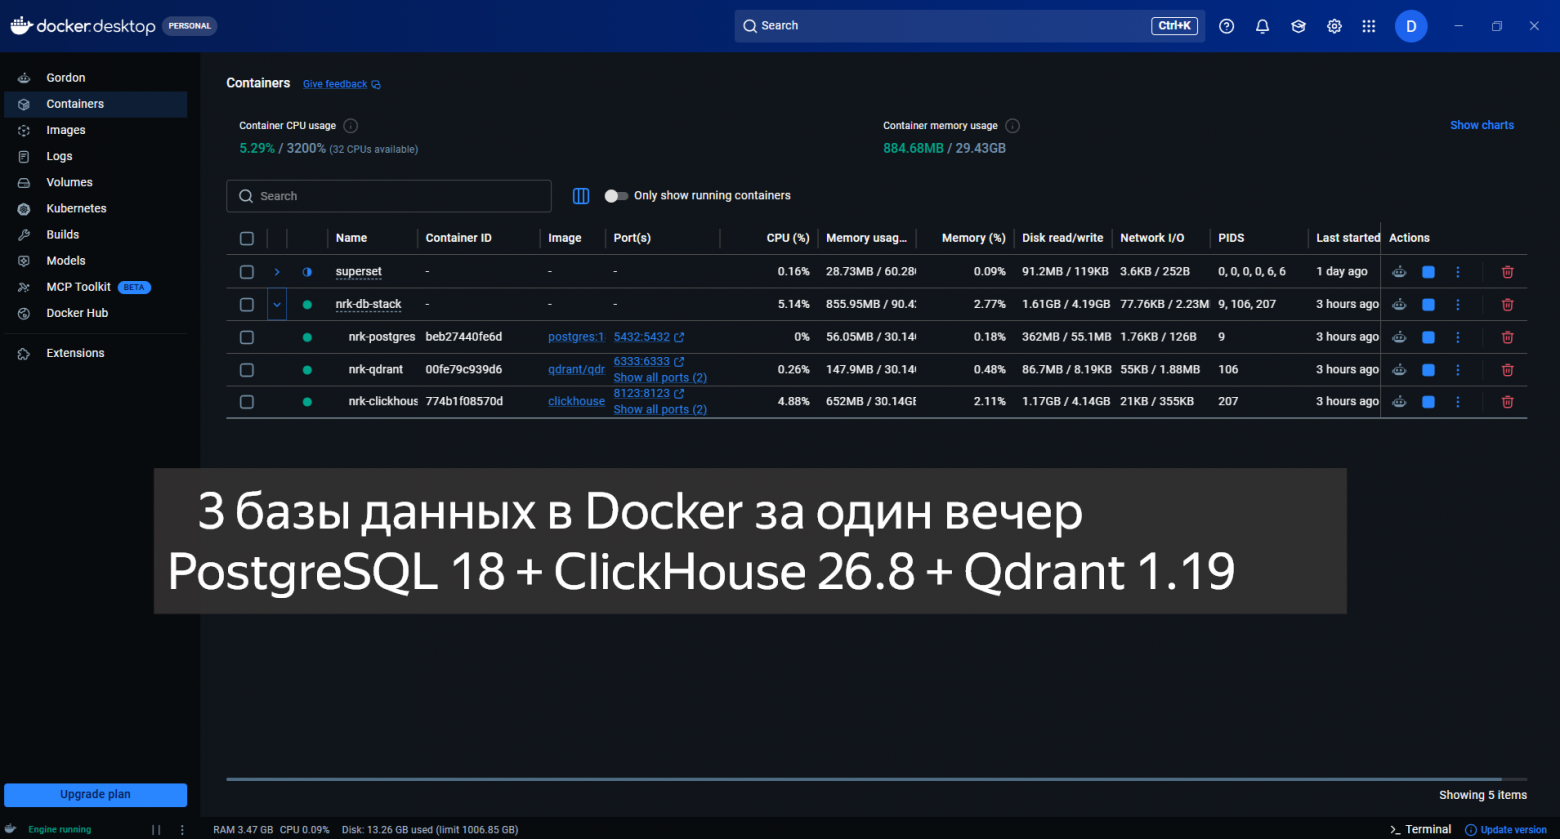
3 базы данных в Docker за один вечер: PostgreSQL 18 + ClickHouse 26.8 + Qdrant 1.19

Уровень сложностиПростой
Время чтения6 мин
Охват и читатели11K

TL;DR: Поднял локально полный аналитический стек - реляционная БД, OLAP-аналитика и векторный поиск для RAG. Всё в одном compose-файле, данные - на томах WSL, ноль облачных счетов. Под катом - установка за три шага и три ловушки, о которых молчат гайды.

Читать далее

Значимый A/B‑тест завышает рост. Считаем, во сколько раз

Уровень сложностиСредний
Время чтения11 мин
Охват и читатели7.5K

A/B‑тест показал +6% к конверсии при p‑value 0,03, и команда закладывает результат в бизнес‑прогноз. Но при низкой мощности эксперимента случайный шум может существенно завышать оценку эффекта. В статье разбираем, как работает проклятие победителя, насколько сильно оно искажает результаты и какие методы помогают получить более реалистичную оценку.

Разбираем A/B-тесты

Теорема Байеса в реальной жизни — это не про формулу

Уровень сложностиСложный
Время чтения12 мин
Охват и читатели9.8K

Сразу к делу. Если вы открыли эту статью, потому что искали гайд “Теорема Байеса за 5 минут”, шпаргалку для прохождения собеседования или надеетесь увидеть очередной стерильный пример про “редкую болезнь и тест с точностью 99%” — вам не сюда. Закрывайте вкладку, берегите глаза, время и карму. Материал плотный, требует включения головы и не предполагает легкого чтения.

Если вы остались, значит, вы уже сталкивались с тем, что в реальной аналитике и бизнесе знание формулы наизусть не стоит ничего.

В интернете 90% обучающих материалов по Байесу сводятся к двум крайностям. Первая - сухая академическая нудятина с вероятностными пространствами, которую невозможно применить на практике. Вторая - крайнее упрощение, где автор дает готовые проценты “из вакуума”, а от вас требуется лишь механически разделить числитель на знаменатель.

Оба подхода формируют опасную иллюзию: кажется, что Байес - это просто калькулятор. Но в реальной работе, когда вы сталкиваетесь с живыми, зашумленными данными, никто не выдает вам готовые “Правдоподобия” на блюдечке. Главная сложность заключается не в арифметике, а в методологии: как сформулировать гипотезу, откуда брать цифры и, самое главное, как правильно “нарезать” выборку.

В этой статье мы не будем зубрить формулу. Вместо этого мы разберем:

Почему если у вас есть SQL таблица со статистикой - теорема Байеса вам, скорее всего, не нужна.

Как смена базовой выборки меняет управленческое решение с минуса на плюс (разберем на примерах покупки подержанного авто, контроля качества на производстве и фильтрации B2B-лидов).

Где аналитики фатально путают P(E\mid H) и P(H\mid E) и как не стать жертвой “эффекта маскировки” в реальных данных.

Жесткий чек-лист из трех пунктов, который нужно прогнать в голове, прежде чем подставлять первые цифры в формулу.

Статья написана для тех, кто хочет научиться принимать решения на основе данных, а не просто красиво цитировать учебники. Если вы готовы копнуть глубже механического подсчета дробей - добро пожаловать под кат.

Читать далее

Спекулятивный декодинг в проде: сравнение методов в ИИ-ассистенте покупателя на Wildberries

Уровень сложностиСложный
Время чтения21 мин
Охват и читатели6.9K

ИИ-ассистент покупателя на Wildberries работает на модели из нашего собственного семейства языковых моделей BerryLM, дообученной под сценарии ассистента. На одно сообщение пользователя он делает много вызовов LLM, в нашем тестовом наборе в среднем около 26: разбирает контекст, извлекает предпочтения, генерирует поисковые запросы, подбирает фильтры, пишет ответ. Часть вызовов идёт параллельно. А пользователь всё это время ждёт, так что от скорости генерации напрямую зависит, как быстро ответит ассистент.

Мы перевели ассистента на спекулятивный декодинг. Но сначала прогнали на одном стенде, одной нагрузке и одних данных семь методов: от n-gram без обучения до свежих DFlash 2 и DSpark. Это рассказ о том, что из этого вышло, какие грабли нашлись по дороге и почему в проде в итоге DFlash 2.

Читать далее

Ближайшие события

От DWH на Greenplum к Data Lakehouse: опыт миграции дата-платформы от Лемана Тех

Уровень сложностиСредний
Время чтения12 мин
Охват и читатели6.5K

Когда команды конкурируют за ресурсы Greenplum, а масштабирование упирается в закупку оборудования, начинаешь искать другую архитектуру. Я Артемий Наумов, инженер данных в Лемана Тех. Расскажу, как мы переносим сборку витрин на Data Lakehouse, сохраняем привычную работу с SQL и Airflow и сокращаем путь изменений до production с недели до нескольких часов.

Читать далее

feature_importances_ дал случайному шуму столько же веса, сколько скидке. Почему график важности признаков врёт

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели6.5K

График feature_importances_ может убедительно показать, что случайный шум важнее реального бизнес‑фактора, а коррелированные признаки — оказаться бесполезными по отдельности, хотя вместе они определяют качество модели. Разберём на синтетических данных, почему MDI, Permutation Importance и SHAP дают искажённую картину, как выявлять шумовые признаки и учитывать корреляции, чтобы не принимать решения об отборе признаков на основании обманчивого графика.

Разобраться в теме

Когда Hadoop начал тормозить бизнес: как мы перестроили платформу данных в Lenta Tech

Уровень сложностиПростой
Время чтения12 мин
Охват и читатели5.4K

Привет, Хабр! На связи Владимир Бибичев, инженер больших данных, и Илья Кисляков, старший инженер больших данных Lenta Tech. Мы занимаемся развитием и сопровождением корпоративной платформы больших данных.

На старой платформе Hadoop ETL-процессы могли часами ждать свободных ресурсов, аналитики не успевали выполнять запросы, а бизнес — вовремя получать данные. С ростом нагрузки ситуация становилась всё сложнее, и в какой-то момент мы поняли: простым расширением кластера проблему не решить.

Пришлось серьезно пересмотреть подход к работе с платформой данных. Что именно мы изменили, с какими трудностями столкнулись и к каким результатам пришли — рассказываем в статье.

Читать далее

Приглашаем на ML-митап hh.ru

Уровень сложностиПростой
Время чтения2 мин
Охват и читатели6K

Если вы ML-разработчик или дата-сайентист и работаете с поиском и рекомендациями — приходите обсудить, как LLM и агенты помогают искать вакансии, кандидатов и недвижимость: от понимания запросов на естественном языке до оценки качества и работы в проде. После докладов продолжим общение за вкусной едой и напитками!

Регистрируйтесь по ссылке и присоединяйтесь к митапу 19 ноября в 19:00 мск в офисе hh.ru или онлайн.

Читать далее

Как устроена Data Platform в Атоме

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели5.5K

Привет, Хабр!

Меня зовут Александр Ершов, в Атоме я отвечаю за направление данных. В этой статье расскажу, как мы с командой строили дата-платформу с нуля: какую архитектуру выбрали и почему остановились именно на этом стеке.

Если попытаться сформулировать определение что такое дата-платформа, то будет выглядеть так. Дата-платформа - это комплекс технологий, который объединяет разрозненные данные компании, обеспечивает их качество и делает их доступными для анализа. Она помогает бизнесу отслеживать ключевые показатели, находить причины их изменений и принимать решения на основе данных.

Стек, на котором все работает: Flink, Spark, Airflow, S3(managed), Iceberg, Paimon, Nessie, ClickHouse(managed), PostgreSQL(managed), FastAPI, OPA/OPAL, OpenMetadata, Trino. Инфраструктура живет в Яндекс Облаке, поэтому часть решений — managed. Сервисы в K8s, используем Terraform/Terragrunt, частично Ansible, Helm чарты, k8s операторы для Flink и Vault.

Читать далее

ETL на базе Apache Spark. Конфигурации преобразования в формате YAML. Сборка решения из «кубиков»

Уровень сложностиСредний
Время чтения3 мин
Охват и читатели5.3K

В данной статье описываются технологии, использованные для построения полнофункционального ETL на базе Apache Spark. Статья планируется как первая в цикле статей о решении бизнес проблем с помощью созданного ETL с использованием существующих Open-Source решений.

Читать далее

Apache Iceberg: как устроен табличный формат для озера данных

Уровень сложностиСредний
Время чтения18 мин
Охват и читатели6.7K

Интересно наблюдать за тем, как порой разные подходы и парадигмы обмениваются своими лучшими качествами в процессе развития. Одно из таких событий в области хранения и обработки данных — противостояние и сближение DWH и Data Lake.

Как известно, DWH (Data Warehouse или хранилище данных) появился раньше, чем Data Lake (озеро данных). С ростом количества данных появилась необходимость создания и развития новой парадигмы, которая в будущем привела к созданию озера данных. С течением времени классический DWH никуда не пропал — он просто твёрдо занял свою нишу.

Читать далее
1
23 ...