Обновить
256K+

Python *

Высокоуровневый язык программирования

374,01
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

В логе было «не удалось получить данные:» и дальше пустота. Это и была вся ошибка

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели5.6K

В логе моего сборщика данных годами появлялась строка «не удалось получить данные:» и дальше ничего. Я считал это багом форматирования, пока не посмотрел: код написан правильно, просто у asyncio.TimeoutError пустой str(). Дальше выяснилось интереснее. Рядом лежит хелпер с тремя попытками и паузой в пять секунд, написанный ровно под сетевые сбои, а ловит он except aiohttp.ClientError. Начиная с Python 3.11 asyncio.TimeoutError это встроенный TimeoutError, наследник OSError, и к иерархии aiohttp он отношения не имеет. То есть единственная ошибка, ради которой ретраи существовали, пролетала мимо них. Причём у aiohttp есть и свои таймаутные исключения, которые как раз ClientError, и именно это сбивает с толку. Заодно разбираю, как я на основе этих пустых ошибок записал в заметки несуществующее «сетевое ограничение VPS» и построил вокруг него архитектурное решение.

Читать далее

Объединяй и властвуй: как перенести ML-эксперимент из лабораторного кластера в промышленный за 60 секунд

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели6.3K

Всем привет! Мы команда ML-платформы Ozon. Мы строим инфраструктуру, которой ежедневно пользуются дата-сайентисты и ML-инженеры — от первых экспериментов в Jupyter до обучения моделей на больших GPU-кластерах. Наша задача заключается в предоставлении доступа к современным вычислительным технологиям через привычные инструменты и единый интерфейс платформы. 

Со стороны может показаться, что формула счастья наших пользователей предельно проста: «GPU для всех, даром, и пусть никто не уйдёт обиженным». В реальности всё, конечно же, сложнее. Вычислительные ресурсы должны использоваться эффективно. При этом разные этапы рабочего процесса требуют разного оборудования и инструментов. Поэтому выполнять весь процесс на одном, пусть и сверхмощном, кластере не всегда рационально. Если же распределить этапы между несколькими кластерами, нужно обеспечить их взаимодействие, чтобы рабочий процесс выполнялся бесшовно.

Значит, нам необходим механизм, обеспечивающий эту связь. Решение, позволяющее взять пользовательский эксперимент, собрать его код и зависимости в одном кластере и воспроизвести в другом, — чтоб переход между стадиями рабочего процесса происходил в одно действие, быстро и удобно для пользователя. Как мы решили эту задачу и какие выводы сделали — в этой статье.

Читать далее

Скрипт работает в терминале, а под systemd не находит файл. Почему? Представим: app.py и config.json лежат в...

Охват и читатели3.6K

Скрипт работает в терминале, а под systemd не находит файл. Почему?

Представим: app.py и config.json лежат в /opt/mybot. При запуске из этого каталога всё работает, а системный сервис падает с FileNotFoundError.

Причина может быть в такой строке:

Читать дальше →

Глобус в терминале: Земля из символов Брайля и реальная смена дня и ночи

Уровень сложностиПростой
Время чтения5 мин
Охват и читатели7.5K

Представьте, что в уголке вашего терминала висит глобус Земли, и ночь на нём наступает там же, где за окном. Я написал такую программу за два дня. Она загружает карту мира, обтягивает ею сферу и отображает её символами: точками шрифта Брайля, значками Юникода либо буквами. Шар вращается мышью и раскрашивается одной из десяти палитр. Помимо Земли утилита показывает Солнце, Луну, все планеты и Цереру. Ставится одной командой, без Python и зависимостей.

Читать далее

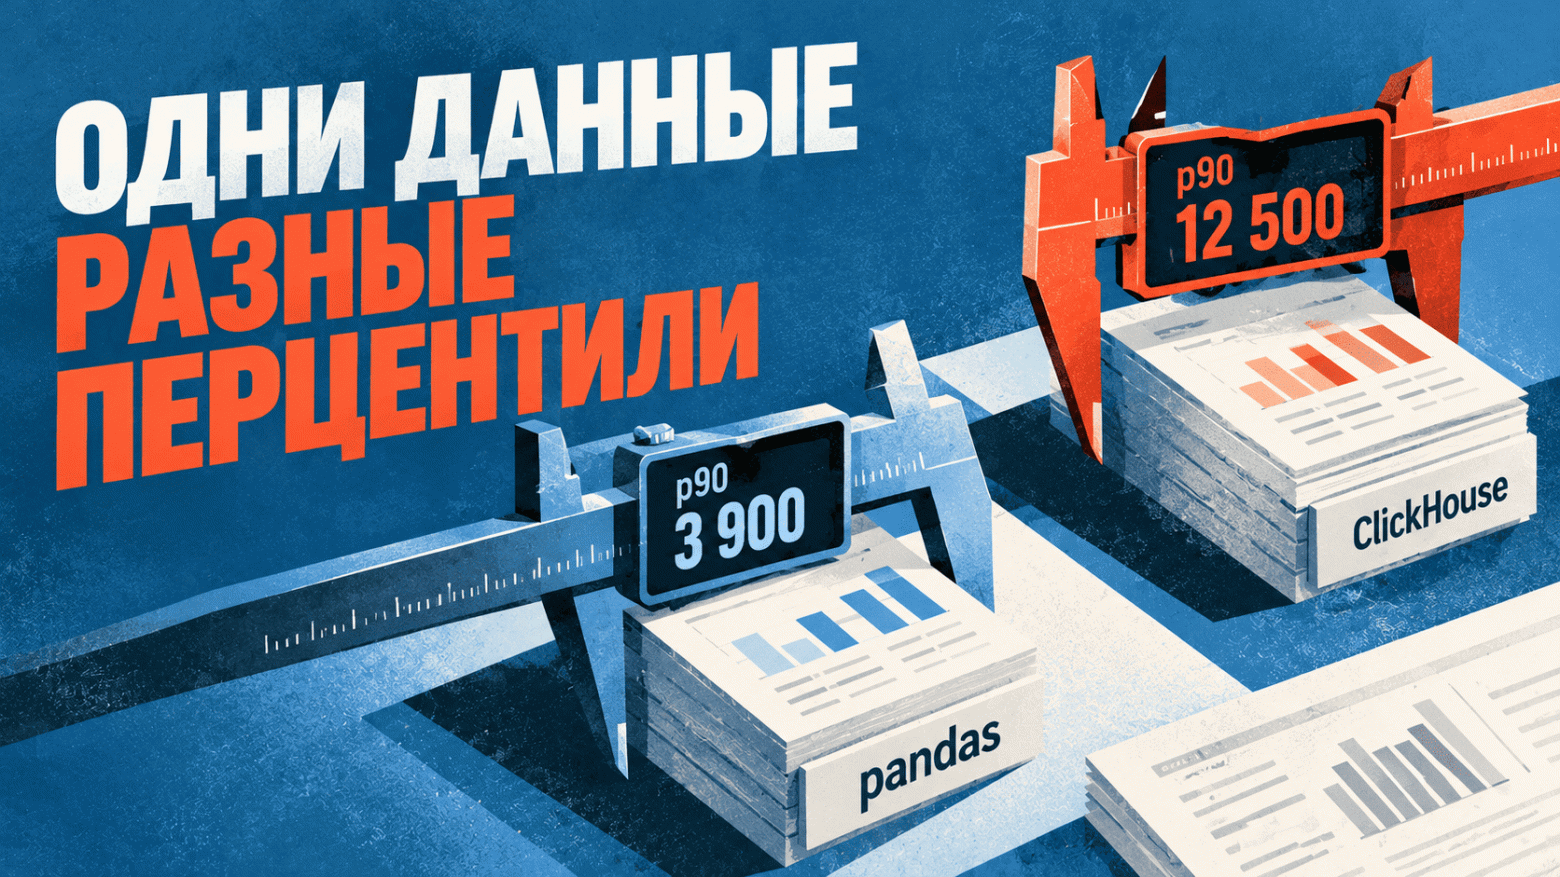
Почему pandas и ClickHouse считают разные перцентили на одних данных и как добиться совпадения

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели9.8K

Один и тот же набор из десяти заказов, а p90 получается от 3900 до 12 500 рублей. В ноутбуке аналитика одна цифра, на дашборде другая, и даже повторный запуск запроса иногда меняет результат. Причина может скрываться в самой функции расчёта перцентиля — разберёмся, как разные инструменты выбирают значения и какой метод использовать, чтобы метрики можно было сравнивать.

Разобраться в перцентилях

Старый трейдер поделился секретом заработка. Я проверил с помощью кода. Удалось заработать?

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели8.6K

Есть в трейдинге фраза, после которой мне хочется открыть не терминал, а Python:
«Эта стратегия работает десятилетиями»

Хорошо. Десятилетия прошли. А прибыль-то осталась?

Читать далее

Чистый контур — агентская прачечная для вашего грязного легаси

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели9K

Два из трех API-вызовов возвращали HTTP 500. Агенты поколениями лепили заплатки поверх заплаток, пока код не превратился в клубок нейросоплей.

Вместо очередного исправления я перенес систему в чистый контур, где агент пишет новую реализацию, не видя старой.

В статье механизм переноса, 15 правил защиты от новых костылей и эксперимент на 36 запусках DeepSeek: насколько поведение агента зависит от того, какой код и какие правила ему показывают.

Войти в чистый контур

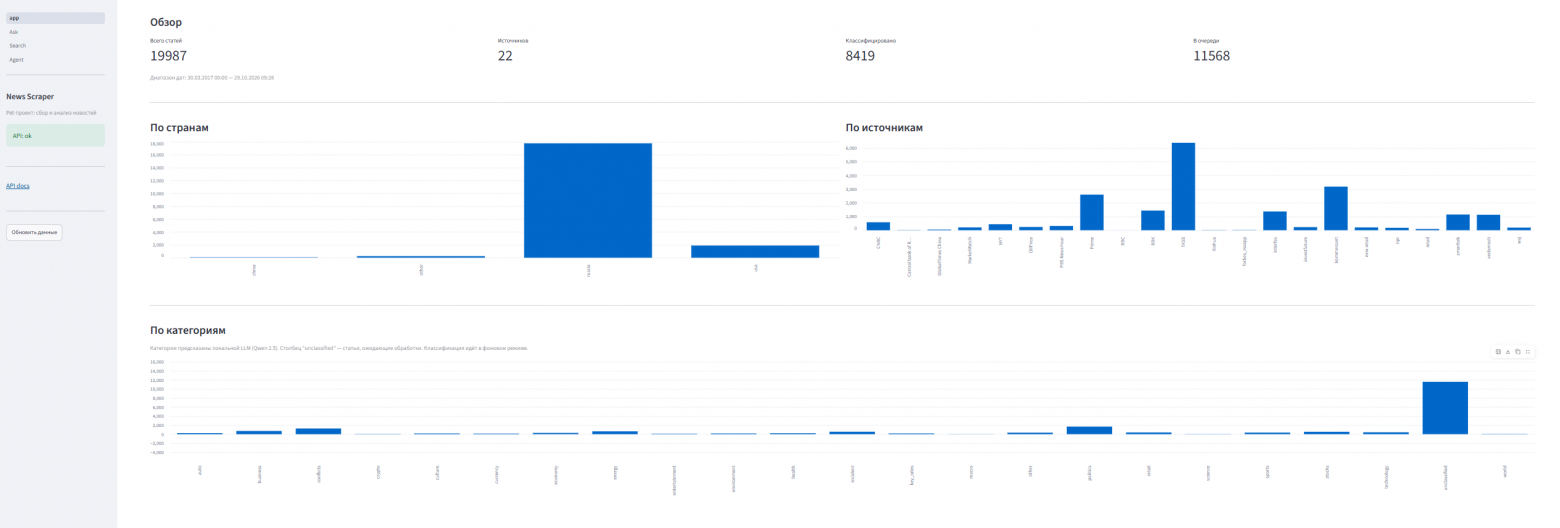
Как построить self‑hosted RAG‑систему с LangGraph‑агентом на локальных LLM

Уровень сложностиСредний
Время чтения4 мин
Охват и читатели7.8K

Обычно стек для RAG‑систем и AI‑агентов строится вокруг облачных API (OpenAI, Anthropic) и управляемых векторных баз. Но для ряда задач критически важна полная автономность: устойчивость к санкциям и независимость от внешних провайдеров.

В этой статье я расскажу, как спроектировал и собрал аналитическую систему, которая за две недели работы агрегировала более 12 000 новостей: от сбора RSS‑лент до умного агента, который сам вызывает инструменты. Мы пройдем путь от архитектуры до граблей, на которые я наступил.

Стек: Python 3.12, FastAPI, PostgreSQL + pgvector, Celery, LangGraph, Ollama (Qwen 2.5 14B, BGE‑M3), Streamlit, Langfuse, Docker.

Читать далее

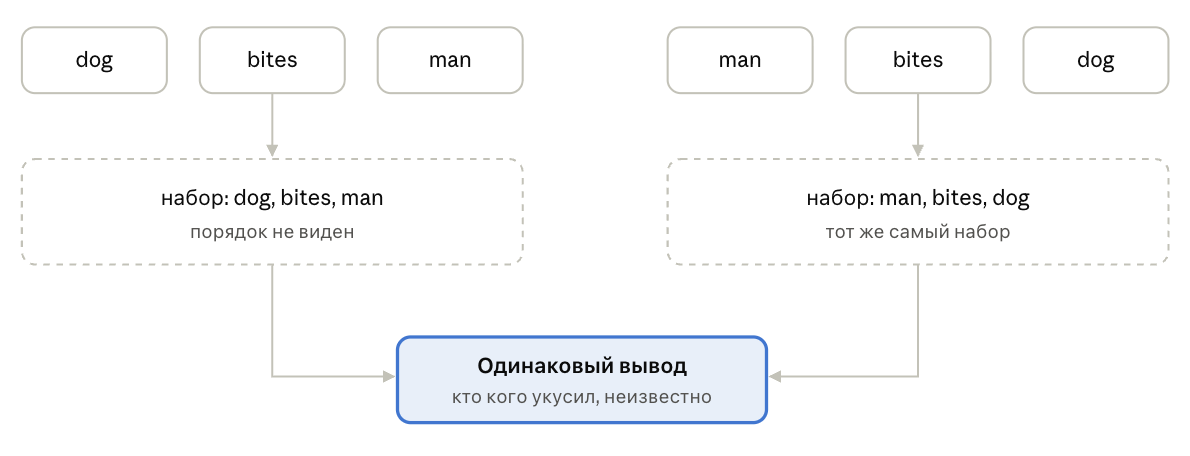
Позиционные эмбеддинги, или Почему 3 + 5 не всегда 8

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели7.1K

Меня зовут Настя, я Data Scientist и TeamLead. Сегодня хочу рассказать про вредную занозу, которая засела у меня в голове и далее я не могла это игнорировать.

Сейчас я читаю книгу Себастьяна Рашки «Строим LLM с нуля». Читаю по-взрослому: глава за главой, с открытым Jupyter рядом и кружкой кофе (не первой). И на разделе 2.8 про позиционные эмбеддинги я встала. Прямо как вкопанная.

Причём там не сложно! В книге это буквально три строчки кода: есть таблица эмбеддингов слов, есть таблица эмбеддингов позиций, складываем — и вперёд, к attention. В других учебниках и статьях то же самое: «просто прибавим вектор позиции той же размерности». Ну понятно же? Понятно. Только в голове вместо ясности почему-то остался список вопросов:

Изнать подробности

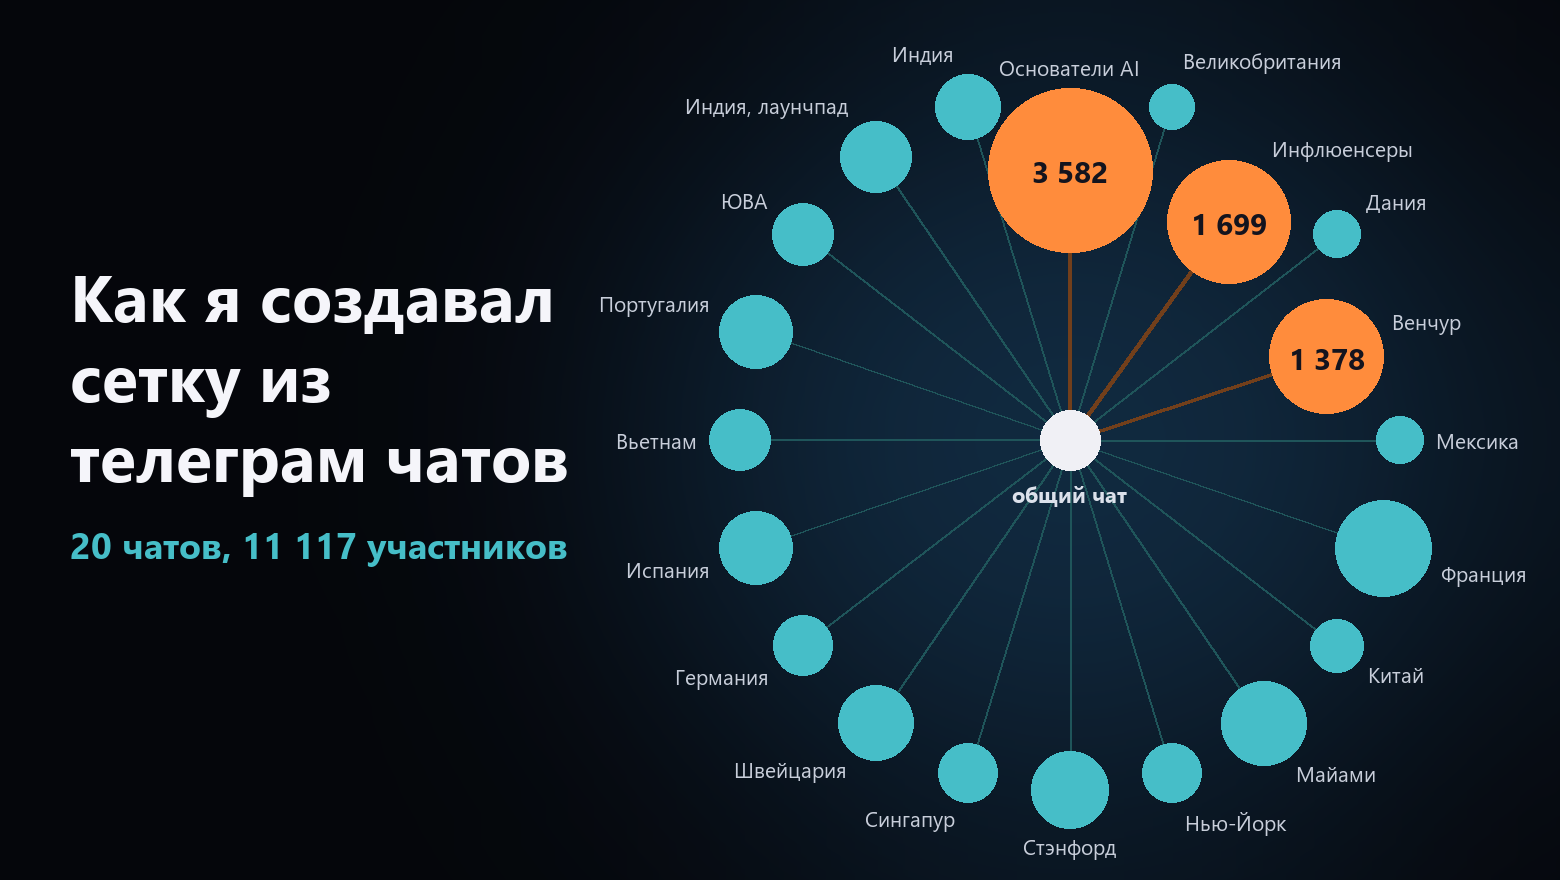
Как я создавал сетку из 20 региональных телеграмм-каналов

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели5.9K

Я много ездил по конференциям и митапам и для каждого события создавал свой чат. Так за несколько лет у меня собралась сетка из 20 Telegram-чатов, в которых 11 117 участников. В статье рассказываю, зачем дробить аудиторию по странам, как я автоматизировал рассылку через Claude Code и как делать это дешевле

Читать далее

Когда Python становится слишком медленным: пишем C‑расширение с нуля и сравниваем с pybind11 (бонус JIT‑компилятор)

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели6.4K

Недавно я прочел статью про pyrusmorph — python обёртку над 30-летним с++ ядром libmorph/rus. Бенчмарки удивили: в 30 раз быстрее PyMorphy3 при обработке текста. После я задумался. Как это вообще работает? Почему мы пишем import pyrusmorph и получаем доступ к нативному с++ коду и функциям прямо внутри python.

В статье я предлагаю пройти этот путь с нуля. Разобраться, как устроен Python «под капотом», написать своё расширение на чистом C‑API, а потом посмотреть, как эту боль лечит pybind11. В конце — бенчмарки и практические советы, когда вообще стоит лезть в c++ для оптимизации. Бонус — немного о компиляторе python кода (JIT‑компилятор)

Читать далее

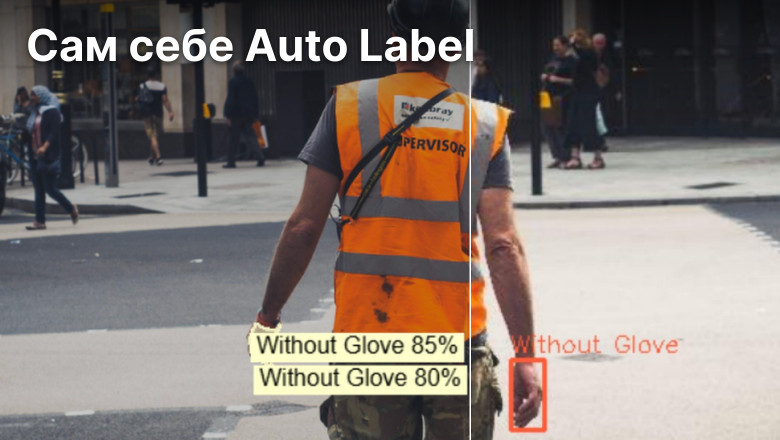
Бесплатный аналог Auto Label от Roboflow: как я разметил 12 576 кадров за ночь

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели4.6K

Под диплом мне нужен был датасет по средствам индивидуальной защиты. Шесть классов, и хуже всех в открытых наборах представлена сварочная маска: после удаления дублей около двух тысяч кадров. Я нарезал видео, получил в пять-шесть раз больше кадров, чем попало в итог, и упёрся в разметку.

Auto Label у Roboflow задачу решал, но на бесплатном тарифе это полгода ожидания, а платный прогон по всему массиву обошёлся бы примерно в двести долларов. Поэтому я написал автоаннотатор на SAM3: пятнадцать файлов на PyQt6, текстовые промпты вместо обучения, пороги по классам.

Главный трюк — конфликты классов. SAM3 находит «руку» и «перчатку», а нарушение приходится вычислять вычитанием: если бокс руки перекрыт перчаткой больше чем на четверть, он уходит в нарушение. На этом держится вся разметка шести классов.

Итог: 12 576 кадров, 104 726 боксов, одна ночь на RTX 4060 Ti, ноль рублей. Модель на датасете даёт mAP50 = 0.825. В статье есть код и разбор того, где SAM3 врёт.

Читать далее

Как я рисовал NFT-подарки Telegram в 60 fps, не имея API: бот для эмодзи, стикеров и подарков

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели4.1K

В Telegram есть премиум-эмодзи, паки стикеров и NFT-подарки. Всё это красиво выглядит, но достать оттуда что-то для своей работы неудобно. Скачать пак целиком нельзя. Чтобы узнать custom_emoji_id, нужен отдельный бот или отладчик. А анимацию подарка вне Telegram можно разве что записать с экрана.

Я написал бота Emoji Studio, который всё это делает. В статье — не столько про сами функции, сколько про несколько интересных задач, которые пришлось решить по дороге:

Читать далее

Ближайшие события

Дедупликация фото без нейросетей. Часть 1: измеряем перцептивные хеши

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели6.3K

Недавно у нашей команды появилась необходимость отвечать на вопрос: А такое фото у нас уже есть?». Не «такой же файл» — его можно было бы легко проверить по SHA-256, — а именно такое же фото: пережатое, уменьшенное, с чужим логотипом поперёк кадра, подрезанное по краям.

Про перцептивные хеши на Хабре написано много, почти везде разбирают устройство алгоритма. Мне же хотелось понять, что он выдерживает. Поэтому я взял двадцать фотографий, изменил каждую двадцатью шестью способами из тех, что реально случаются при перезаливе, и посчитал расстояния.

Это первая часть из двух. Она про то, что хеши умеют и где ошибаются: водяные знаки, геометрия кадра, выбор метода, длина хеша, порог. Во второй части я расскажу, как из этого сделать работающую систему: предобработка, зеркало и поиск в PostgreSQL с бенчмарком на десяти миллионах строк.

Читать далее

Представлен открытый проект Zero Breach Toolkit для поиска на смартфонах шпионских программ. Проект использует 12,4...

Охват и читатели3.4K

Представлен открытый проект Zero Breach Toolkit для поиска на смартфонах шпионских программ. Проект использует 12,4 тыс. индикаторов слежки из 29 источников. С таким набором инструмент способен отыскать Pegasus, Predator, Graphite и Candiru — это самый известный хакерский софт во всём мире.

Решение не просто выдаёт «угроза обнаружена», а показывает подозрительные следы в коде и программах, оценивает достоверность находок и объясняет, что именно удалось проверить. Причём сам смартфон взламывать не нужно. Для Android понадобится подключение к компьютеру по USB, для iPhone — создание локальной резервной копии.

Читать дальше →

Скрипт обновил JSON, а читатель получил половину файла Рассмотрим домашний сервер: один скрипт собирает показания...

Охват и читатели3K

Скрипт обновил JSON, а читатель получил половину файла

Рассмотрим домашний сервер: один скрипт собирает показания датчиков в status.json, другой читает этот файл для страницы состояния.

Обновление выглядит привычно:

Читать дальше →

Байты приходят, события нет: проверяем кадры SSE и gzip

Время чтения4 мин
Охват и читатели6.2K

Сервер отправляет по SSE три сообщения с паузой 250 мс, а клиент видит события только через 750 мс. Собрал стенд на стандартной библиотеке Python и поставил три отметки времени: байты тела ответа, текст после декодера gzip, готовое событие. Незавершённый кадр и сжатие без промежуточного сброса дают одинаковый симптом, но задержка появляется в разных точках.

Читать далее

Данные для языка, которого почти нет в интернете: текстовые слои, турецкие подмены и псевдоразметка двумя моделями

Уровень сложностиПростой
Время чтения16 мин
Охват и читатели7.4K

В первой статье серии я писал, что у крымскотатарского не было ни одного датасета, пригодного для серьёзной работы, и что начинал я с существующего речевого набора, который пришлось чистить. Во второй распознавалка научилась слышать нашу речь, в третьей синтезированный голос прочитал целый роман. Отсюда вопрос, который мне задавали чаще всего: если данных нет, на чём всё это училось?

Эта статья про данные. Оговорка та же, что и раньше, только строже: я не называю источники, архивы, издания, каналы, людей и организации, которые нам что-то передали, и не рассказываю о договорённостях с ними. Нет здесь и названий моделей, порогов фильтров и внутренних скриптов. Объёмы даю порядками величин. Зато будут метрики, методика проверки и грабли, на которые я наступил, и все цифры взяты из отчётов экспериментов, а не по памяти.

Читать далее

Мне давно не хватало простого gui пингера, на подобии Netmap под виндой, который бы работал из коробки и без танцев с...

Охват и читатели4.7K

Мне давно не хватало простого gui пингера, на подобии Netmap под виндой, который бы работал из коробки и без танцев с бубном в wine. Приложение, которое можно было бы свернуть в трей, не требовало тонну зависимостей, и не имело не нужного функционала, типа веб интерфейса (это уже другой уровень мониторинга)

QPing — написан на Python с использованием библиотеки PyQt6. Для мониторинга доступности сетевых хостов по ICMP или TCP-портов. Предоставляет визуальное отображение статуса хостов в виде графиков с latency и министатистикой. Поддерживает группировку хостов для удобства, и всплывающие уведомления через системный трей.

Основные возможности:

Читать дальше →

Маршрутизатор языковых моделей изнутри. От вектора задачи до судьи и обучения на отзывах

Уровень сложностиСложный
Время чтения25 мин
Охват и читатели6.4K

Раннее мы описывали библиотеку FAIRouter для маршрутизации запроса к оптимальному исполнителю. В текущей редакции поддерживаются только LLM, но класс исполнителей планируем расширять также на инструменты и агентов. Но тема того какая математика стоит за всем этим осталась не до конца раскрыта.

Читать далее