Обновить
256K+

Python *

Высокоуровневый язык программирования

373,17
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Скрипт обновил JSON, а читатель получил половину файла Рассмотрим домашний сервер: один скрипт собирает показания...

Охват и читатели3K

Скрипт обновил JSON, а читатель получил половину файла

Рассмотрим домашний сервер: один скрипт собирает показания датчиков в status.json, другой читает этот файл для страницы состояния.

Обновление выглядит привычно:

Читать дальше →

Байты приходят, события нет: проверяем кадры SSE и gzip

Время чтения4 мин
Охват и читатели6.2K

Сервер отправляет по SSE три сообщения с паузой 250 мс, а клиент видит события только через 750 мс. Собрал стенд на стандартной библиотеке Python и поставил три отметки времени: байты тела ответа, текст после декодера gzip, готовое событие. Незавершённый кадр и сжатие без промежуточного сброса дают одинаковый симптом, но задержка появляется в разных точках.

Читать далее

Данные для языка, которого почти нет в интернете: текстовые слои, турецкие подмены и псевдоразметка двумя моделями

Уровень сложностиПростой
Время чтения16 мин
Охват и читатели7.4K

В первой статье серии я писал, что у крымскотатарского не было ни одного датасета, пригодного для серьёзной работы, и что начинал я с существующего речевого набора, который пришлось чистить. Во второй распознавалка научилась слышать нашу речь, в третьей синтезированный голос прочитал целый роман. Отсюда вопрос, который мне задавали чаще всего: если данных нет, на чём всё это училось?

Эта статья про данные. Оговорка та же, что и раньше, только строже: я не называю источники, архивы, издания, каналы, людей и организации, которые нам что-то передали, и не рассказываю о договорённостях с ними. Нет здесь и названий моделей, порогов фильтров и внутренних скриптов. Объёмы даю порядками величин. Зато будут метрики, методика проверки и грабли, на которые я наступил, и все цифры взяты из отчётов экспериментов, а не по памяти.

Читать далее

Мне давно не хватало простого gui пингера, на подобии Netmap под виндой, который бы работал из коробки и без танцев с...

Охват и читатели4.7K

Мне давно не хватало простого gui пингера, на подобии Netmap под виндой, который бы работал из коробки и без танцев с бубном в wine. Приложение, которое можно было бы свернуть в трей, не требовало тонну зависимостей, и не имело не нужного функционала, типа веб интерфейса (это уже другой уровень мониторинга)

QPing — написан на Python с использованием библиотеки PyQt6. Для мониторинга доступности сетевых хостов по ICMP или TCP-портов. Предоставляет визуальное отображение статуса хостов в виде графиков с latency и министатистикой. Поддерживает группировку хостов для удобства, и всплывающие уведомления через системный трей.

Основные возможности:

Читать дальше →

Маршрутизатор языковых моделей изнутри. От вектора задачи до судьи и обучения на отзывах

Уровень сложностиСложный
Время чтения25 мин
Охват и читатели6.4K

Раннее мы описывали библиотеку FAIRouter для маршрутизации запроса к оптимальному исполнителю. В текущей редакции поддерживаются только LLM, но класс исполнителей планируем расширять также на инструменты и агентов. Но тема того какая математика стоит за всем этим осталась не до конца раскрыта.

Читать далее

Попросил Claude починить прокрутку в Linux под UTM — получил демон, окно настроек и находку в libinput

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели6.5K

Работаю в VS Code в Linux-виртуалке UTM на маке, и прокрутка там всегда прыгала по три строки и очень чувствительна к движениям пальца, вместо прокрутки приходилось пользоваться обычными стрелками на клаве. Ранее я уже просил Claude это исправить: поставили замедлитель и imwheel, не помогло, на этом и остановились. В этот раз Claude Opus 5.5 за один чат и пару моих правок разобрался до конца. Выяснилось, что причин три, и одна сидит в самом libinput (уж очень клод акцентирует внимание на этой причине): он придерживает первые пол-щелчка каждого жеста и выдаёт их рывком. Claude написал прогу с интерфейсом и настройками, залил всё на GitHub. До идеала macOS не дотягивает - первое движение нужно делать чуть длиннее, чем на маке. В остальном прокрутка плавная и привычная, результатом доволен. В статье - технический разбор, как это получилось. Картинка, вся работа и статья от клода опус 5.5.

Читать далее

Флоу — это не число слогов: как я учил языковую модель писать рэп в такт бита

Время чтения5 мин
Охват и читатели5.6K

Я сделал страницу, на которую загружаешь бит и пишешь, о чём трек, а получаешь куплеты и припев, разложенные по тактам этого бита: строка на такт. Первая версия выдавала школьные стихи под музыку. Ниже о том, почему так вышло, где языковая модель надёжна, а где нет, и что пришлось посчитать самому. Всё это на сервере с двумя ядрами и без видеокарты.

Читать далее

«Лучше пять раз переспросить, чем один раз выдумать» — я посадил ИИ‑ассистента отвечать коллегам в рабочем мессенджере

Уровень сложностиСредний
Время чтения8 мин
Охват и читатели6.2K

Всем привет! Меня зовут Александр, я руковожу направлением аналитики страховой вертикали в Банки.ру. Наша вертикаль живёт в отчётах и данных: продажи ОСАГО и КАСКО, ипотечное страхование, кроссы, пролонгация, воронки, кэшбэк и сверки с партнёрами.

И каждый день в рабочем мессенджере на меня прилетает поток одного и того же жанра: «где посмотреть КВ по ОСАГО за сентябрь?», «почему упало одобрение у страховой?», «сделай выгрузку по регионам», «это у нас баг или так и задумано?». КВ здесь комиссионное вознаграждение.

Постепенно аналитик превращается в справочное бюро. Ответы есть, но живут они в голове, в SQL-запросах и в вики, а вопросы приходят в личку и в каналы в любой момент, в том числе пока ты на встрече. Я решил посадить на эту очередь ИИ-ассистента. Условие одно и жёсткое: ассистент не выдумывает. В аналитике выдуманная цифра хуже отсутствия ответа, потому что по ней примут решение.

В статье рассказал, как бот устроен, какие правила не дают ему врать и как он им учится.

Читать далее

Квантование RWKV-7: что ломается в моделях разного размера

Уровень сложностиСложный
Время чтения35 мин
Охват и читатели5.2K

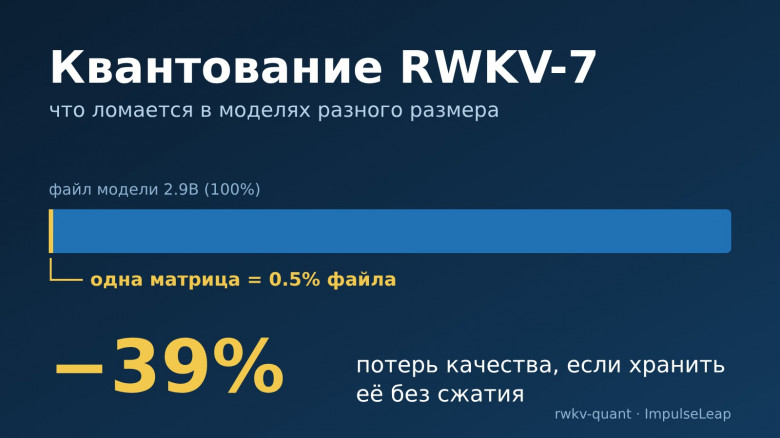
Я изучаю посттренировочное квантование семейства RWKV-7 (от 0.1B до 13.3B параметров) двумя пресетами: REDUCTION (сжатие около 2.1x, почти без потерь) и COMPRESSION (около 3.1x, 4 бита на проекции). Исходный вопрос работы: почему 4-битный пресет на модели 2.9B деградирует сильнее, чем на 1.5B (+4.04% против +2.85% по перплексии), хотя ожидается обратное.

Оказалось, что до 86% вклада всей группы o_proj на 2.9B приходится на одну матрицу: выходную проекцию нулевого блока. Её вход несёт «массивный канал» (98% энергии входа в восьми каналах из 2560). Хранение этой одной матрицы в bf16 (0.5% файла) снижает KL к эталону на 39% и возвращает 2.9B в монотонную линейку; перевод эмбеддинга с 5 на 6 бит добавляет ещё −22% KL за 1.1% файла. Три естественные локальные метрики ошибки не предсказывают вред от квантования матрицы; предсказывает ошибка, внесённая в остаточный поток и умноженная на усиление ниже по глубине. На этом основании я строю автоподбор битности по правилу «снятый вред на байт» (−16…−39% KL при приросте файла не более 0.5%) и переношу GPTQ на ту же сетку (−29…−43% KL при тех же байтах).

Вместе методы дают потерю по перплексии от +2.76% (0.1B) до +0.70% (13.3B) на файле размером 31.6–35.2% от bf16, монотонно убывающую с размером модели. Пресет REDUCTION с GPTQ даёт +0.46…+0.07% при 46–50% от bf16. При равном размере файла KL моего 6-битного файла с GPTQ в 2.0–3.3 раза ниже, чем у GGUF Q6_K с imatrix, и в 3.5–7.4 раза ниже, чем у MLX int6; 4-битный файл в 2.1 раза точнее Q4_K_M на 1.5B, а Q4_K_M на 2.9B ломается. Отдельно описываю утечку калибровочного корпуса в мой первый оценочный набор и измеренный масштаб её влияния, а также разброс GPTQ между численно эквивалентными реализациями (около ±1.5% KL).
Читать далее

Эмулятор Game Boy Color на MicroPython: Pokémon Crystal на конференц-бейдже с RP2350

Время чтения12 мин
Охват и читатели5.6K

Стив Франсиа, автор Hugo и Cobra, после эмулятора NES запустил на конференц-бейдже GitHub Universe с RP2350 эмулятор Game Boy Color — на MicroPython с генератором кода Viper. Процессор SM83 с его восемью регистрами и 512 опкодами не влез в четыре быстрые локальные переменные Viper, и декодер пришлось строить на восьмеричной раскладке опкода. Ветвления по адресу заменила таблица из 16 страниц по 4 КБ, двухмегабайтные картриджи подгружаются по банку при первом обращении, а разгон до 300 МГц вешал общую шину QSPI. Плюс три бага из реальных игр: окно диалога в Oracle of Ages, «вывернутый» Линк в режиме двойной скорости и указатель стека, который Pokémon Crystal направляет прямо в ROM.

Читать далее

Я подсвечивал нейроны крохотного ИИ, чтобы понять, когда тот врет

Время чтения12 мин
Охват и читатели13K

В 2023 году адвокат из Нью-Йорка принес в суд записку со ссылками на прецеденты, которые ему «добросовестно» подобрал ChatGPT. Судья не нашел ни одного из этих дел. И не случайно: дел, на которые ссылался ИИ, не существовало вовсе. А через год Air Canada проиграла спор с пассажиром, которому чат-бот авиакомпании пообещал возврат денег по правилу, которое придумал ее же бот. Языковые модели ошибаются вполне уверенно, и по тексту ответа невозможно понять, путается ли модель искренне или привирает, прекрасно зная правильный ответ. Для людей эту задачу давно пытаются решать полиграфом, но он измеряет пульс и дыхание, то есть пытается замерить волнение, а с враньем оно связано очень косвенно.

Но у нейросети есть одно преимущество для исследователей: в отличие от человека, ее внутренности можно читать целиком. Буквально каждый нейрон. И все это без манжеты на руке и проводов на пальцах. Я решил проверить, получится ли собрать такой полиграф для языковой модели на домашней видеокарте. 

Первый же результат оказался интереснее, чем я рассчитывал изначально. Я попросил локальную модель соврать про цвет банана, и она уверенно ответила «Red», хотя на 25-м слое из 28 еще на 46% собиралась сказать «yellow». То есть правильный ответ у нее внутри был, а переписали его только последние слои. Но обо всем по порядку.

Читать далее

Почему softmax теряет градиенты — и как школьная алгебра 7-го класса помогает их сохранить

Уровень сложностиПростой
Время чтения14 мин
Охват и читатели6.5K

Модель почти идеально выучила ответ, а градиент правильного класса уже стал машинным нулём. При дистилляции возможна обратная ситуация: ученик повторяет учителя, но вычисление всё ещё выдаёт сигнал ошибки. Разбираю исправления DeepMind на школьной алгебре, проверенных примерах NumPy и четырёх графиках: где теряются маленькие числа, как это влияет на обучение и что стоит проверить в своей среде.

В статье есть практические рекомендации, как понять, нужно ли это учесть в ваших программах и нейросетях, и если нужно — как исправить в своем коде ошибку из стандартных библиотек.

Самое удивительное тут то, что, казалось бы, подобная тема должна быть исследована вдоль и поперек еще на заре развития машинного обучения, а в реальности важнейший научный препринт от DeepMind об этом вышел 22 октября, то есть меньше недели назад.

Кроме того, рекомендую включать этот материал в базовые учебные курсы.

Читать далее

AI-менеджер для WB, Ozon и Маркета: отдали решения агенту и сразу его ограничили

Уровень сложностиСредний
Время чтения5 мин
Охват и читатели4.1K

Первую версию AI-менеджера маркетплейсов мы собрали на регулярках: фраза → операция из закрытого списка → API площадки. Первые владельцы быстро показали, где это ломается: люди пишут не по списку, а цифры без выводов селлеру не нужны.

Мы переделали менеджера в агента: модель сама выбирает инструменты и порядок. И сразу же его ограничили: 8 шагов и 150 секунд на ход, узкие инструменты, запись в кабинет — только после «да» владельца. Рассказываем, как это устроено, с кодом, и что дали агенту вместо сценариев.

Читать далее

Ближайшие события

PyLab — 2 года: как пользователи превращают пет-проект в продукт

Уровень сложностиПростой
Время чтения3 мин
Охват и читатели5.5K

28 октября моему пет-проекту PyLab, приложению для изучения Python и написания кода прямо на смартфоне, исполнилось два года. В прошлой статье я рассказывал, что умеет приложение, а сегодня расскажу о решениях: почему горячие правки обходятся дороже, чем кажется, чем окупился полный редизайн в версии 4, как одна идея пользователя стала любимой функцией и почему модерация в сторах превращает каждую ошибку в проблему на неделю.

Читать далее

CVE-2026-111497: критическая уязвимость в декодере Google Brotli Опубликована критическая уязвимость CVE-2026-111497 —...

Охват и читатели7K

Опубликована критическая уязвимость CVE-2026-111497 — out-of-bounds write в C-декодере Google Brotli (c/dec/decode.c). Уязвимы версии 1.0.3–1.2.0: специально сформированный Brotli-поток может вызвать повреждение памяти, утечку данных, отказ в обслуживании и потенциально удалённое выполнение кода. security.paloaltonetworks

Риск существует для сервисов, распаковывающих Brotli-данные из недоверенных источников: HTTP-прокси, API-шлюзов, Node.js- и Python-приложений, а также систем с встроенными копиями libbrotlidec. rapid7

Компонент Уязвимые версии Исправленные версии Google Brotli / libbrotlidec 1.0.3–1.2.0 1.0.10, 1.1.1, 1.2.1 security.paloaltonetworks Node.js 22.x / 24.x / 26.x до 22.23.4 / 24.22.1 / 26.12.1 22.23.4 / 24.22.1 / 26.12.1 rapid7 Debian 12 brotli до 1.0.9-2+deb12u1 1.0.9-2+deb12u1 Debian 13 brotli до 1.1.0-2+deb13u1 1.1.0-2+deb13u1 Ubuntu 24.04 LTS brotli до 1.1.0-2ubuntu0.1 1.1.0-2ubuntu0.1

Читать дальше →

Пишем свой масс-сканер и OSINT-комбайн на Python: от скрипта «в лоб» до асинхронности и SQLite

Уровень сложностиСредний
Время чтения6 мин
Охват и читатели7.7K

В процессе изучения сетевой безопасности и автоматизации OSINT на базе Linux передо мной встала задача — создать быстрый и отказоустойчивый инструмент для первоначального сбора данных и фиксации сетевых инцидентов. В данной статье я поделюсь каждым этапом разработки первых версий моего инструмента Web-Recon. Мы пройдем путь от простейшего скрипта, спотыкающегося о первые блокировки и ошибки 403, до создания асинхронного пула потоков на ThreadPoolExecutor и проектирования базы данных на SQLite3 с решением проблемы параллельной записи (database is locked).

Читать далее

Ипотека или аренда в Петербурге: я посчитал на Python и вот что вышло

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели17K

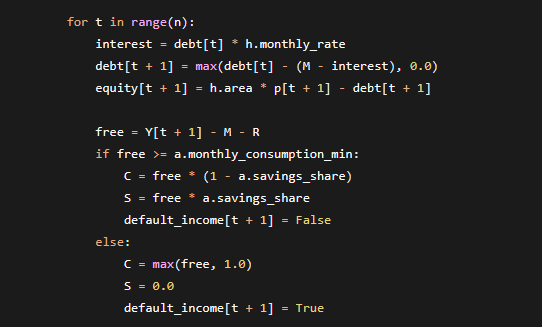
Привет, Хабр! Я построил простую экономико‑математическую модель жилищного бюджета домохозяйства, подставил в неё данные по Санкт‑Петербургу на 2026 год и прогнал несколько сценариев. Код выложил на GitHub, а здесь — результаты, графики и все входные данные, чтобы можно было воспроизвести.

GitHub: https://github.com/CheesePunk/Housing-Budget-Model

Читать далее

Как я, новичок в Python, с помощью ИИ сделал редактор, который прячет код от ИИ

Уровень сложностиСредний
Время чтения4 мин
Охват и читатели7.3K

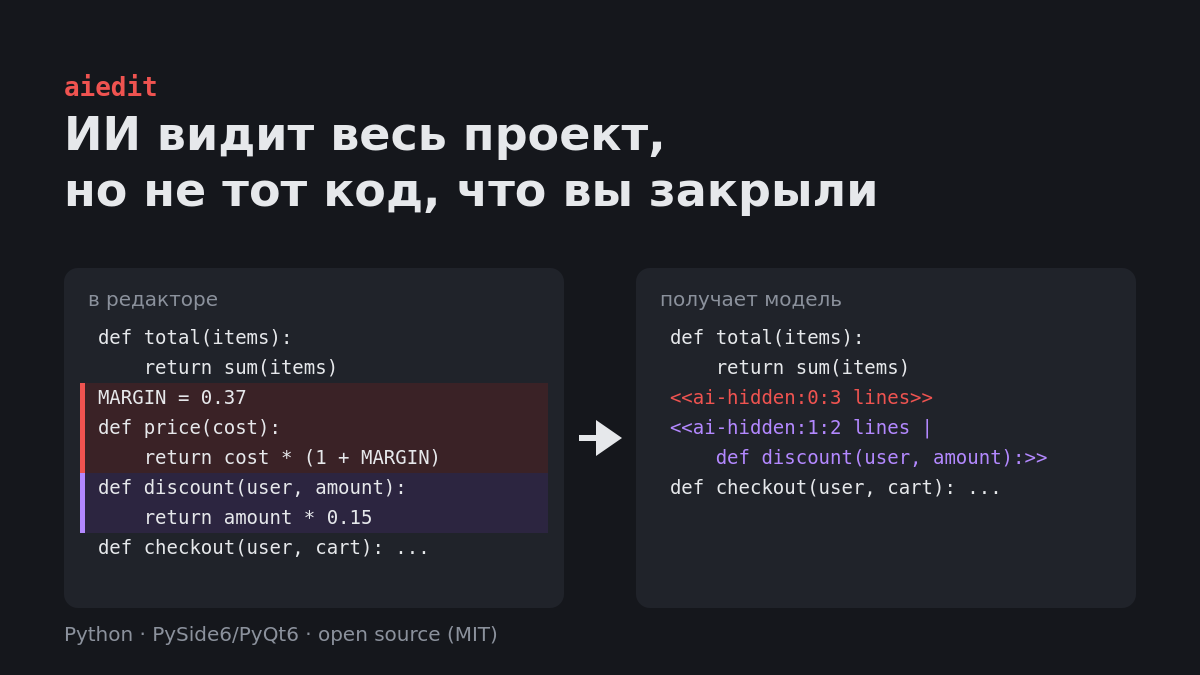
aiedit — настольный редактор кода на Python (PySide6 и PyQt6), в котором ИИ-модели работают со всем проектом, но не видят закрытые части. Закрыть можно не только файл, но и отдельные строки. Проверку делает код редактора, а не просьба в промпте: закрытое просто не попадает в запрос к модели. Код открыт под лицензией MIT. Честно сразу: по качеству кода он пока уступает Claude Code на той же модели, ниже разбираю почему.

Читать далее

Как голосовой робот принимает заявки на ремонт и передаёт их мастеру в Битрикс24

Уровень сложностиСредний
Время чтения14 мин
Охват и читатели5.4K

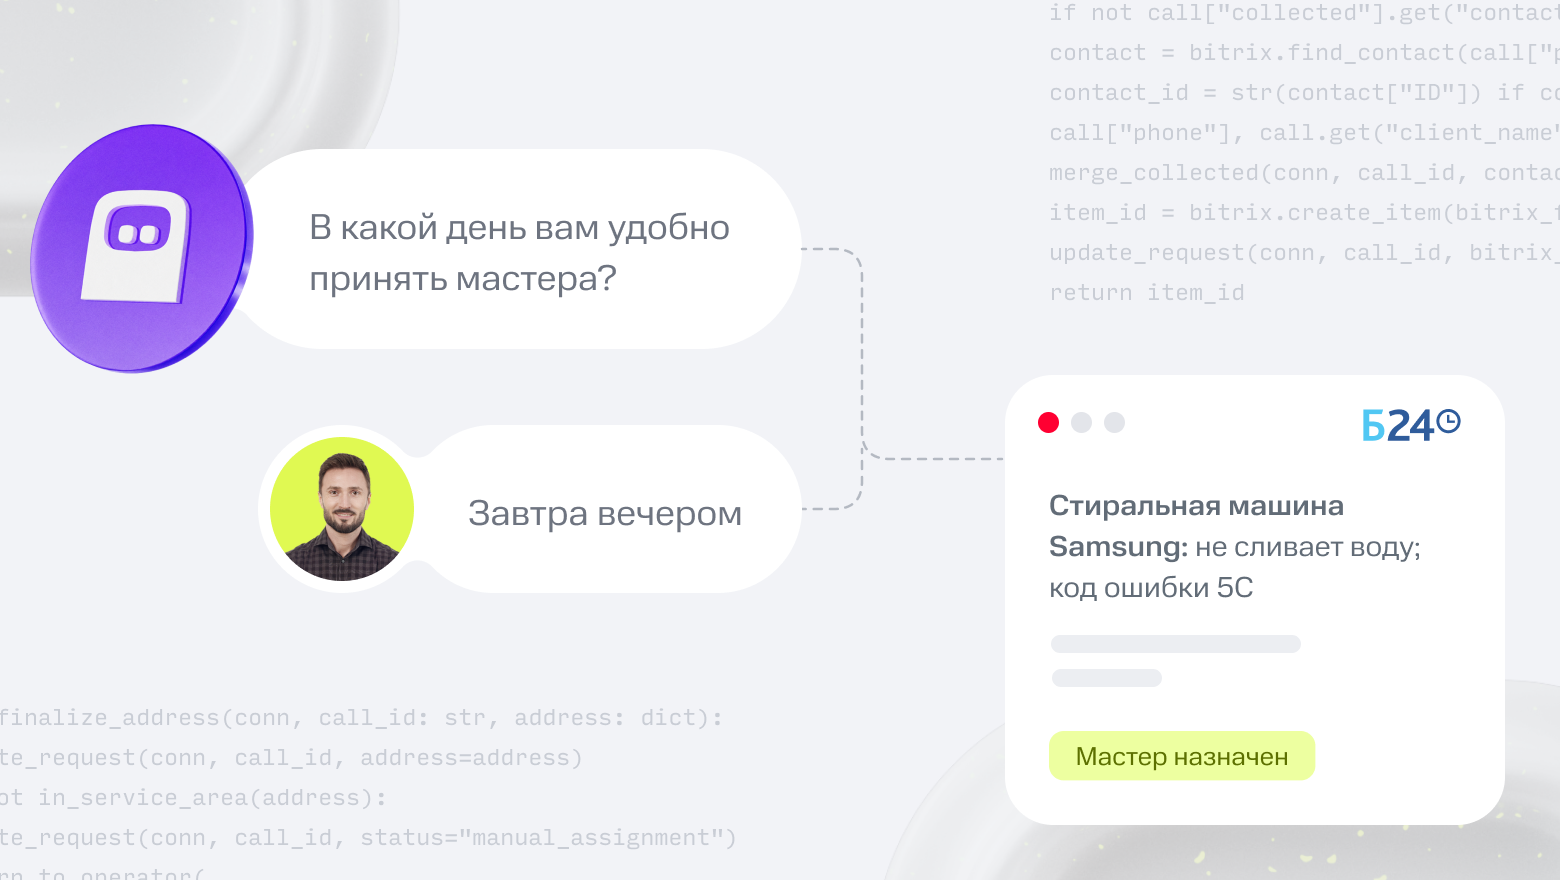
Привет, Хабр! В этом материале сделаем сервис, который разгрузит диспетчера сервисного центра по ремонту бытовой техники. Голосовой робот будет принимать входящий звонок и собирать детали обращения. На каждое обращение в Битрикс24 будет создаваться карточка с назначенным мастером.

Стек проекта: Python 3.10+, FastAPI, Pydantic, SQLite, HTTPX, Битрикс24, Яндекс Геокодер, голосовой робот и SMS API от МТС Exolve.

Читать далее

Как я подключил рабочие чаты Telegram к ИИ-ассистенту через MCP

Уровень сложностиПростой
Время чтения8 мин
Охват и читатели5.9K

В рабочих чатах Telegram рядом живут сообщения о релизах, вопросы подрядчиков, согласования и короткие «посмотри, пожалуйста». Чтобы понять, что требует внимания, приходится открывать несколько чатов и восстанавливать контекст из отдельных реплик.

Я сделал TelegramMCP — открытый сервер, который подключает личный аккаунт Telegram к ИИ-приложению с поддержкой MCP. Ассистент получает инструменты для чтения папок и чатов, поиска бесед и отправки текстовых сообщений. Уже поверх этих инструментов его можно попросить собрать главное из выбранной переписки или подготовить ответ.

В статье расскажу, как устроено подключение через TDLib, зачем понадобилась поддержка папок, как запустить проект и какие проблемы ещё остаются.

Читать далее