Всё, что вам нужно — это внимание (часть 1)
Сложный
13 мин
Перевод
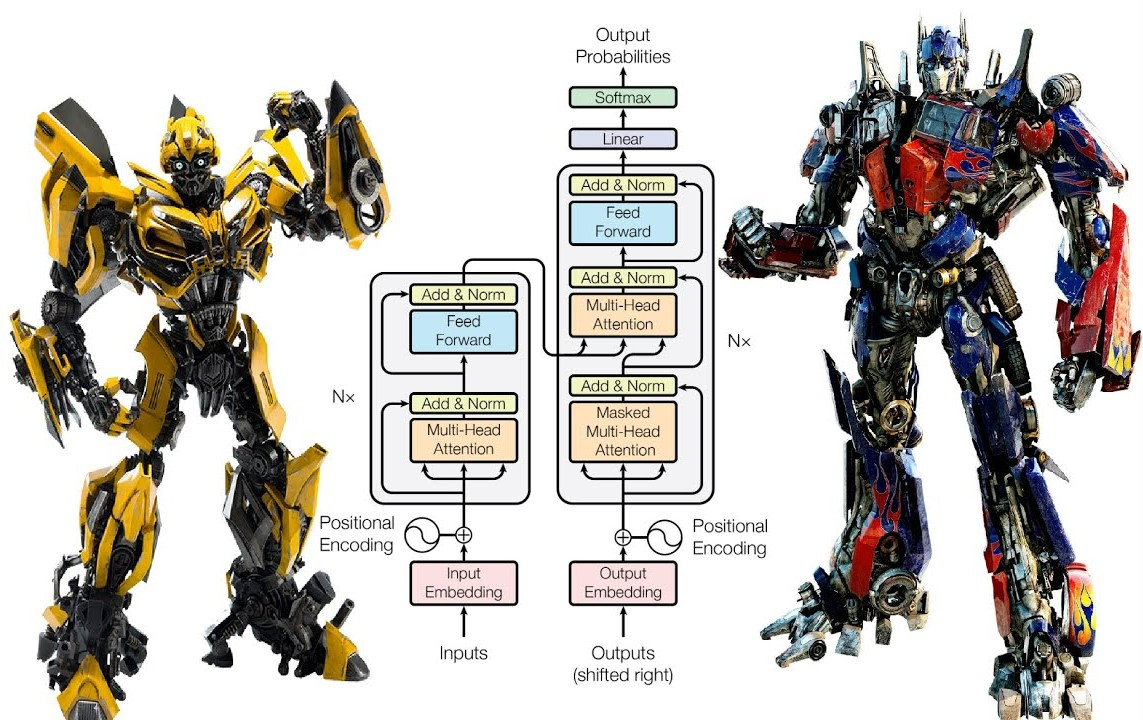
Примечание переводчика: Недавно на Хабре мы рассказывали о статьях, которые нужно прочитать, если вы хотите заниматься искусственным интеллектом. Среди них была культовая статья Attention is all you need, выпущенная в 2017 году. С неё началось развитие больших языковых моделей, в том числе всем известного чат-бота ChatGPT. Оказалось, что у такой важной статьи нет перевода на русский язык. Мы решили исправить это. Ниже вы найдёте перевод первой части статьи, вторая часть доступна по ссылке.
Краткое содержание
Наиболее распространённые модели преобразования последовательностей основаны на сложных рекуррентных или свёрточных нейронных сетях, которые включают энкодер и декодер. В самых успешных моделях энкодер и декодер соединяются с помощью механизма внимания. В статье авторы предлагают новую простую архитектуру нейронных сетей — Трансформер. Он основан исключительно на механизмах внимания, без рекуррентности или свёрток. Эксперименты на двух задачах машинного перевода показали лучшее качество, а также больше возможностей к распараллеливанию и меньшие временные затраты на обучение. Модель достигает 28.4 по метрике BLEU на задаче перевода с английского на немецкий на данных WMT 2014, что превосходит предыдущий лучший результат на 2 пункта. На задаче перевода с английского на французский на данных WMT 2014 модель достигла наилучшего результата для решения, основанного на одной модели — 41.8 по метрике BLEU — после всего 3.5 дней обучения на 8 GPU, что составляет совсем небольшую часть тех вычислительных мощностей, которые были затрачены на обучение лучшей модели, известной из имеющихся публикаций. Авторы показывают, что Трансформер может также успешно применяться и в других задачах, таких как, например, синтаксический разбор предложений на английском языке с использованием как больших, так и весьма ограниченных наборов данных для обучения.