Обновить
-6
Алексей@java3000

Администратор windows умеющий в программирование

Отправить сообщение

Создание высокодетальных 3D моделей сложного технологического оборудования в проектах Bimeister

Уровень сложностиПростой
Время на прочтение6 мин
Охват и читатели5.8K


Всем привет! Меня зовут Марат и я занимаюсь разработкой высокодетальных 3D-моделей оборудования в компании Bimeister.

Расскажу про то, как мы создаем огромную базу 3D-моделей для промышленных предприятий и какие инструменты при этом используем.

Итак, сейчас у нас стоит задача разработать без малого 5000 детальных 3D-моделей оборудования, функционирующего в составе действующего нефтехимического промышленного комплекса. В дальнейшем, эти цифровые модели будут использоваться в нашей системе Bimeister, в составе эксплуатационной информационной модели предприятия.

Мы выбрали не самый легкий путь.

Читать далее

Расчет транспортного потока на основе YOLOv5 и DeepSORT на базе Deepstream

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели13K

Хотим сохранить ваше время и нервы с задачей по подсчету трафика на перекрестках.

Ярослав и Никита – наши CV-инженеры, поделились решением, которое всего за 4 шага поможет подойти к релизу с минимальной потерей времени и денег.

Статья будет полезна начинающим CV-инженерам, продуктологам, владельцам IT-продукта, маркетологам и проджект-менеджерам.

Читать далее

ML-пайплайн классических банковских моделей классификации

Время на прочтение10 мин
Охват и читатели8.3K

Всем привет! С вами на связи дата-сайентисты банка "Открытие" Иван Кондраков и Константин Грушин. В прошлой статье мы рассказывали про решение, которое позволило повысить эффективность в проверке гипотез для моделей. Если вы успели с ней ознакомиться, то уже знаете, что наша команда занимается разработкой и развитием пула моделей принятия решений о выдаче кредитных продуктов и банковских гарантий для малого и среднего бизнеса. Сегодня настало время поговорить с вами про пайплайн, который используется для разработки таких моделей. Мы построили достаточно много моделей, так что нам точно есть чем поделиться. К тому же существенный вклад в развитие такого универсального алгоритма внес каждый член команды.

Читать далее

Консистентность в конкуретной среде: как не захлебнуться в потоках данных

Уровень сложностиПростой
Время на прочтение21 мин
Охват и читатели9.1K

В прошлой статье я рассказал о конкурентной среде в Точке и типовых проблемах, с которыми сталкиваются разработчики. В этот раз речь пойдёт о том, как же можно эту консистентность реализовать и какие злые силы нам могут помешать это сделать. Решил больше не делить статьи на части, поэтому продолжение вот в этой большой статье, всё в одном месте.

Напомню, что текст рассчитан в первую очередь на разработчиков, которые имеют мало практического опыта работы в конкурентной и/или микросервисной среде, поэтому многие вещи я объясню на пальцах. Для тех, кто захочет ознакомиться с более строгими формулировками, сразу скажу, что здесь будут затронуты упрощённые идеи паттернов Transactional Outbox и Saga.

Читать дальше

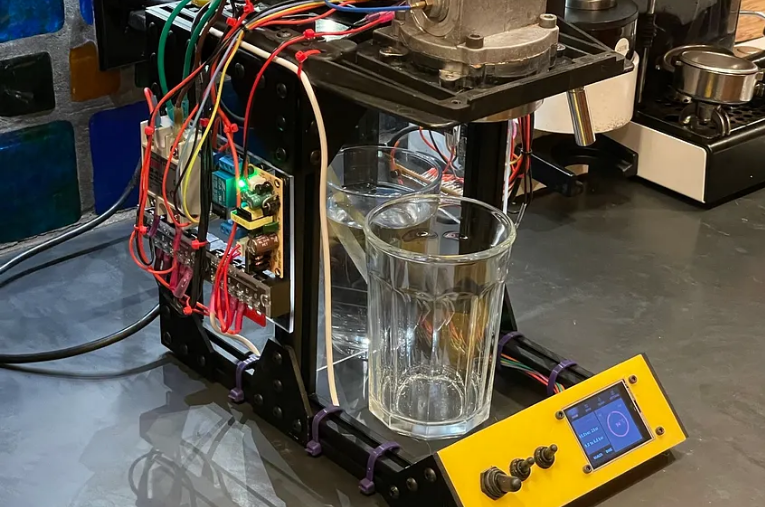
Кофемашина с открытым исходным кодом — как сделать (почти) с нуля

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели24K

Эспрессо‑машины — это сложные, загадочные штуки, которые тяжело обслуживать. А ещё они очень дорогие. Но для тех, кто не может жить без кофе, нет никаких преград. Например, можно сделать вот такую эспрессо‑машину...

Читать далее

Выражение Hibernate запросов в виде типо‑безопасных Java-потоков

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели5.6K

В этой статье вы узнаете, как расширение JPAstreamer Quarkus упрощает выполнение типо‑безопасных запросов Hibernate без излишней многословности и сложности.

Читать далее

Как разрабатывали StarCraft

Уровень сложностиПростой
Время на прочтение23 мин
Охват и читатели42K
image

Хотите себе «Дарк Соулса» от стратегий — добро пожаловать в «СтарКрафт».

Сегодня мы вспомним культовую стратегию в реальном времени, созданную корпорацией Blizzard в самом конце 90-х, когда они ещё были эталоном качества, делали только хорошие игры и никогда не проваливались.

Ту игру, которая была настолько популярной, что даже стала официальной религией национальным кибер-спортом одной азиатской страны. Бородатые легенды гласят, что отцы этого государства отдавали дочерей только за женихов, способных обыграть их в мультиплеере один на один.

Эта игра запала в сердечко всем любителям годных RTS, ведь в ней нужно просчитывать каждый шаг, как в шахматах.

В общем, в это надо играть, про это приятно вспомнить и поговорить.

Тем более, если я правильно подсчитал, игре сегодня стукнуло 25 лет. Одним словом, праздник!
Читать дальше →

Ассоциативная память без нейросетей + генерация текста

Время на прочтение9 мин
Охват и читатели2.9K

Когда‑то давно ко мне пришла идея реализовать алгоритм основанный на цепочках символов. Этот алгоритм выделяет в тексте несколько последовательностей символов, и таким образом производит его анализ. Этот алгоритм в какой‑то мере похож на метод построения N‑грамной модели, разница лишь в том, что он строит последовательности символов переменной длины. Как это делается я расскажу немного ниже. В результате алгоритм мог сравнивать тексты друг с другом и находить степень похожести между ними. Я приспособил его для того, чтобы отсеивать ранее известные тексты, и выбирать только те, которые обладают наибольшей уникальностью на момент анализа. Результат работы алгоритма можно посмотреть здесь: http://luksian.ru

Расскажу вкратце суть идеи. Например, у нас есть текст ABCABD. Из этого текста можно выделить следующие последовательности из двух символов: AB, BC, CA, AB, BD. Здесь видно что последовательность AB встречается два раза, а за этой последовательностью в каждом случае следуют разные символы. Такая ситуация считается конфликтом который необходимо разрешить. Для этого создаются новые последовательности символов: ABC и ABD. Последовательности из этих трех символов в тексте встречаются по одному разу, поэтому конфликт считается разрешенным, больше неоднозначностей в тексте не наблюдается. Разумеется, в обычном тексте написанном на простом человеческом языке для разрешения конфликтов иногда может потребоваться построить гораздо более длинные цепочки символов чтобы можно было найти между ними разницу. И вот недавно я вспомнил об этом алгоритме и попробовал его исследовать поподробнее.

Читать далее

Autobinary: библиотека для простого обучения «деревяшек» — Part 1

Уровень сложностиСредний
Время на прочтение4 мин
Охват и читатели2.5K

Рождение autobinary, как и многих других фреймворков, началось с автоматизации рутинных задач. На тот момент мы создавали много look-alike моделей (в основе - модель бинарной классификации) по разным продуктам банка. Одни и те же скрипты писать было скучно. Более того – накопилось много разрозненных скриптов, которые хотелось привести к единому формату.

Что из этого получилось

Автоматизируем тестирование микросервисов с REST-assured и Kotlin + Allure

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели10K

Всё началось с того, что перед нами поставили задачу покрыть тестами наши сервисы для микросервисной платформы TOT Pyramid, которую мы развиваем последние два года. Мы были вправе выбрать стек технологий самостоятельно. Данные тесты должны запускаться в CI каждый раз при создании мердж-реквеста и проверять, что изменения ничего не сломали. Выбор пал на Rest-assured, тем более хотелось писать тесты на модном, молодёжном Kotlin.

В данной статье хочу поделиться опытом написания автотестов на Rest-assured + Kotlin. Статья не претендует на Rocket Science - в ней я приведу простые примеры и основные принципы тестирования API, которые применяются у нас в TOT Systems.

Поэтому, если вы ищете инструмент для покрытия API автотестами и при этом хотите писать на Kotlin, то эта статья для вас.

Читать далее

Причина агонии студентов во время интервью, или популярно о моделях интерфейсов шины

Время на прочтение7 мин
Охват и читатели8.7K

Сейчас я интервьирую кандидатов которые приходят на позиции в RTL design / проектировщики микросхем на уровне регистровых передач. Но 5 лет назад я интервьировал студентов и других инженеров на позиции в DV / Design Verification / верификаторы блоков микросхем.

Моим стандартным вопросом было написать маркером на доске псевдокод для упрощенного драйвера модели шины (Bus Functional Model - BFM) для протокола AXI. На этом вопросе у ~80% кандидатов наступала агония - они как ужи на сковородке пытались натянуть сову на глобус - приспособить решение для последовательной шины а-ля APB, которое они прочитали в каком-нибудь тьюториале - к шине AXI, которая во-первых конвейерная, а во-вторых, допускает внеочередные ответы на запросы чтения с разными идентификаторами.

Аналогия из другой области: представьте, что кто-то пытается обходить дерево или решить "ханойские башни" - не зная концепций рекурсии и стека. Или написать GUI интерфейс, не зная концепции cобытийно-ориентированной архитектуры.

Это не потому что кандидаты глупые

Что такое менеджер пакетов, и в чем разница YARN, NPM, PNPM?

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели58K

Очень хочется пошутить про пакет с пакетами. Но нет. Статья про другое. Для начала давайте разберемся, почему я ее написал, и кому она может быть полезна:

Читать далее

ML-подходы по поиску похожих изображений

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели17K

Привет, Хабр!

Меня зовут Паймеров Владимир, я Data Scientist и участник профессионального сообщества NTA.

Компьютерное зрение (computer vision, CV) — активно развивающаяся научная область,
связанная с анализом изображений и видео. В последнее время данному направлению
уделяется большое внимание, так как CV позволяет решать множество задач, таких как
детекцию объектов, классификацию изображений, распознавание лиц и т. д., которые
в свою очередь применяются в разных сферах жизни от мобильных приложений для
наложения масок на лицо во время звонка до построения систем безопасности,
поиска преступников и мошенников. Сейчас есть инструменты, позволяющие
хранить большой объем данных и обрабатывать изображения, поэтому появилось
множество инструментов для решения различных задач. Об одной из таких задач
будет рассказано в данном посте.

Читать далее

Личный кабинет и все, все, все. Тестируем, анализируем и занимаемся всяким. Часть 1

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели7.8K

Собственно говоря, в интернете присутствуют чек‑листы для тестирования личного кабинета, но мы(почему «мы»? я, ж один) здесь постараемся подойти к проблеме более комплексно. Посмотрим что получится.

Сразу без долгих подготовок определимся для чего нужОн этот самый личный кабинет(сокращенно ЛК).

Личный кабинет — это организация какого‑либо процесса компании, который раньше был настроен в офлайне. Но из‑за оптимизации ресурсов и автоматизации рутины компания перевела его в онлайн.

Зачем сайту личный кабинет клиента

Личный кабинет пользователя на сайте решает три важных задачи.

Читать далее

Kotlin Multiplatform Mobile: как усложнить жизнь себе и упростить её потомкам

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели5.4K

На внутреннем проекте red_mad_robot не хватало iOS-разработчиков, и Head of Android red_mad_robot Central Asia Влад Бауэр задумался о том, как можно ускорить процесс. И в итоге решил пошарить часть кода и перенести его в Kotlin Multiplatform Mobile. Спойлер: у него получилось, и теперь он рассказывает о нюансах, с которыми пришлось столкнуться.

Читать далее

От RoboCop до RoboAssist: современное состояние индустрии экзоскелетов

Время на прочтение10 мин
Охват и читатели7.6K

В статье «Люди-киборги: самые сумасшедшие и высокотехнологические механизации человека» мы затронули тему экзоскелетов. В частности, рассказали про российский стартап ExoAtlet, который в 2016 году один из первых в мире выпустил медицинский экзоскелет. Целью основателей стартапа было ускорение процесса реабилитации и улучшение качества жизни пациентов с инсультом, травмами спинного мозга, ДЦП, рассеянным склерозом и прочими болезнями. Но к моменту выпуска прототипа выяснилось, что рынка экзоскелетов в России нет. Компании пришлось строить его с нуля, привлекая инвестиции, меняя на ходу бизнес-модели и не прекращая исследования.

А что вообще происходит на мировом рынке экзоскелетов? Несмотря на всю шумиху, прогресс в этой области медленный, и обещанные прорывы ещё не осуществились. В этой статье рассмотрим текущее состояние разработки экзоскелетов и проблемы, которые необходимо преодолеть, чтобы полностью реализовать их потенциал.

Читать далее

NudeCrawler: Голый ползун по женщинам на телеграфе

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели106K

Nudecrawler - паук для поиска голых женщин.

Читать далее

Личный кабинет и все, все, все. Часть 1.2. Анализ конкурентов

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели1.9K

Начало здесь.

Русский свет

https://rs24.ru/customer_person_register

1) Форма регистрации.

Нет возможности просмотра введённого пароля.

а) Отсутствие возможности просмотра введенного пароля может привести к ошибкам при наборе и повторному вводу пароля, что может вызвать раздражение и затраты времени.

Что хорошо:

Есть кнопка повтора заказа.

1. Кнопка повтора упрощает процесс оформления заказа для пользователя, поскольку все данные, введенные при предыдущем оформлении заказа, будут автоматически заполнены. Таким образом, не нужно тратить время на повторное ввод данных.

2. Кнопка повтора помогает ускорить процесс обработки заказа со стороны компании. Это связано с тем, что повторный заказ содержит все необходимые данные, что упрощает его обработку компанией.

Читать далее

Замеряй и ускоряй: как мы сократили время вызова метода в Java-коде в 16 раз

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели8.4K

Привет, Хабр! Замер производительности кода — не самое простое упражнение для разработчика. Приходится решать кучу сложностей: разбираться с методом, создавать правильные условия. И всё равно можно получить результат с погрешностью, потому что любой метод «не бесплатный» и требует ресурсов процессора.

Меня зовут Александр Певненко, я Java-разработчик в СберТехе. Вместе с командой мы развиваем Platform V DataSpace. Это облачный сервис, который упрощает и ускоряет разработку приложений, используя концепцию Backend-as-a-Service (BaaS) для хранения и управления данными. Я расскажу про наш способ замера производительности кода с помощью бенчмарков. Рассматривать метод будем на примере оптимизации кода в Platform V Dataspace, которая помогла сократить время вызова метода в 16 раз.

В статье я буду пользоваться языком Java, Python для построения графиков и набором библиотек JMH — они также адаптированы для Kotlin, Scala и т.д. 

Читать далее

Часть 2. Перевод нейронной сети на базе Keras LSTM на работу с матричными операциями

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели7.7K

В первой части части я перевел обученную модель полносвязной сети на базе Keras на работу с матричными вычислениями. Модель разработана для новостного агрегатора с целью фильтрации нежелательных новостей.

Но если посмотреть статью-руководство от tensorflow, можно увидеть, что одной из рекомендаций по классификации теста является использование сетей долгой краткосрочной памяти (LSTM).

Забегая вперед скажу, что мне не совсем подошла данная сеть, но это, вероятно, особенность моего датасета. Полносвязная сеть с эмбеддином обладает хорошим качеством, предсказуемостью и стабильностью результатов (объяснимое переобучение, влияние архитектуры сети на качество и т.д.). Ну и немаловажно - быстро обучается, в отличие от LSTM.

Но ради "академического" интереса обучим сеть c LSTM для бинароной классификации текста и переведем её также на работу только с матрицами. Это также наглядно покажет, как устроены ячейки LSTM.

Читать далее

Информация

В рейтинге
Не участвует
Откуда
Москва, Москва и Московская обл., Россия
Дата рождения
Зарегистрирован
Активность

Специализация

Десктоп разработчик, Администратор серверов
Младший
От 110 000 ₽
Java
Java Spring Framework
RESTful WebServices.
PostgreSQL
SQL
Hibernate
Linux
Базы данных
Microsoft SQL Server
Разработка программного обеспечения